流量翻倍,但成本降低86%!「芝麻街」制作方PBS的俭约架构实践

K8s镜像拉取失败:5步定位与修复 K8s 镜像拉取失败时,反复删除 Pod 往往只会重新触发同一个错误。表示容器镜像未能拉取,kubelet 正在退避重试;这与应用启动后反复退出的不同。本文面向运行在 Linux 节点上的 Deployment,整理一条通用排查路径,不编造事故日志,也不把某个环境的结论当成所有集群的默认行为。检查命令默认只读;先确认集群、命名空间和 Pod。<...>表示读者需要替换的参数,不是真实资源名或凭证。标明“变更”的命令只能在获批后执行,不能把整篇文章当脚本一次运行。 阅读详情

01/前言

1969 年,弗雷德·罗杰斯(Mr. Rogers)在美国参议院商务委员会作证,申请资金以支持公共广播的发展。他那番感人至深的发言被认为是美国电视史上的关键时刻,强调了教育类节目对公众福祉的重要性。

时至今日,这一使命仍在延续, 美国公共广播公司 PBS 的 Mike 和他的团队也以自己的方式践行着这一承诺——将每一分公共资金都用到极致。

在资源有限但对高质量、易获取内容的需求不断增长的时代,这些工程师在幕后努力提高效率,利用创新性技术,确保每一分钱都物超所值。

在 PBS,我们的使命是教育、启发并娱乐观众。这一愿景始终指引着我们的每一个决策,甚至影响到我们的技术投资策略。我们并不追求成为下一个 Amazon Prime 或 Netflix,而是希望以最具成本效益的方式,为公众提供优质的内容和服务。

因此,解决方案并不总是“直接扩容更大的实例”或“增加几个只读副本”,有时,答案恰恰在于我们可以缩减或优化哪些内容,而不是简单地添加更多资源。

毕竟,我们使用的是公共资金—— PBS 的每一位成员都深知这一点,并将其融入到我们的思考与决策之中。

02/从被动救火到主动防患

我在 PBS 的旅程始于 2009 年,当时我以外包合同的形式加入公司,担任技术负责人,来负责支持团队维护和优化现有系统。一年后,我转向了其他项目。但到了 2014 年,曾经的上司联系到我,问我是否有兴趣担任技术运维总监一职。

由于要时刻关注系统运行状况,确保一切正常运转,让观众能够顺利观看最新节目,我个人其实很少有机会实时观看我们的节目。

经过几年这样的高压工作后,我在 2017 年做出了一个艰难的决定——离开 PBS。我想尝试一些新的挑战,也收到了来自一家盈利性公司的工作邀请,据说在那里我将拥有更大的团队,也能推动更多的变革。

然而,我很快意识到自己离开 PBS 是个错误的决定。

我怀念 PBS 以使命为导向的工作氛围,甚至怀念在非营利组织有限预算下工作的挑战。因此,我开始和前上司讨论回归的可能性,尽管当时我的职位已经有人接替。他给了我思考的选择,看看是否有我认为组织中缺失但又值得投入精力去改进的方向。

于是,我回到了 PBS,担任云架构师这一新角色,不再只是“救火”,而是专注于“防火”——让我们的系统更具弹性、可扩展性,并进一步优化成本。

关键的变化在于,我们不再只是被动应对突发问题,而是主动调整和优化基础设施,使其更加稳健和高效。这不仅是我个人思维模式的转变,也需要跨团队的紧密协作。

我们需要确保技术投资符合 PBS 的使命——在有限资源的约束下,为观众提供优质内容,同时确保资金的合理运用。

03/重新设计弹性架构

我们早期遇到的一个反复出现的挑战,就是如何应对重大事件带来的流量激增,比如新纪录片的首播,或者热门剧集的新一季开播。这些重磅节目总是会为我们流媒体平台带来巨大的流量激增,而我们最初基于 EC2 的架构年复一年地难以应对。

在许多情况下,我们会遇到“惊群效应”,比如当一封营销邮件发出,或观众在节目结束时看到屏幕上的“访问 pbs.org/masterpiece 了解更多”时,会有大量用户瞬间涌入网站。

同时,我们还要适应新内容发布模式的不断变化(比如首播当天上线、次日上线,或者一次性放出整季内容)。

为了应对这种情况,我们经常不得不紧急“救火”,迅速扩容服务器以应对流量激增,但等流量回落后,又会留下大量闲置容量。这种被动的扩缩容方式不仅成本高昂,还令人压力山大。

一个典型案例就是肯·伯恩斯(Ken Burns)执导的纪录片《越南战争》首播。当时,我们知道流量会上涨,但没有预料到峰值会如此之高。

当时,我们使用 Chef 和 OpsWorks 来配置和部署实例以支撑流量,但性能却十分不理想。我们花了很长时间才找到问题所在。

当时,我们的监控数据显示 CPU 使用率、内存、网络都处于正常水平,所以一开始并不明白系统为何会出现卡顿,唯一的应对方式就是不断增加服务器。

然而,最终我们发现问题并不在硬件资源,而是系统内部存在一些限制,比如打开的文件处理程序、进程和线程数量等。一旦我们发现并调整了这些限制,服务器的处理能力显著提升,能够在使用更少实例的情况下承载更大的流量,从而更高效地管理负载。

在这次纪录片首播过程中,我们经历了扩容方面的挑战,不得不熬夜处理各种问题。这让我们意识到,我们需要一个更具弹性和效率的架构方案。

于是,我们开始探索弹性容器技术。将平台容器化,并利用 Fargate 快速扩展和缩减基础设施,使我们能够在满足需求的同时,避免因服务器长期运行但未充分利用而导致的资源浪费。

举例来说,去年,即便计算资源的使用量和流媒体流量翻倍,我们仍然成功将计算成本削减了 86%。

从“救火”到“防火”:文化转变的挑战

虽然容器化和无服务器架构带来了显著优势,但转型过程却需要整个组织的文化变革。

我需要与产品团队密切合作,帮助他们理解 “性能和高可用性本身就是一项功能”,而不仅仅是交付某个看起来很酷的新功能按钮。

要实现从“救火”到“防火”的思维转变,我们必须保持持续的沟通和协作。

我不能简单地强制推行技术变革,而是要带领团队一起完成这次转型,向他们解释其中的好处,并帮助他们认识到这些变化将如何在长期内让工作变得更加轻松。

这需要一定的平衡,我既希望赋予团队足够的灵活性和创新空间,又要确保他们在做决策时能从整个系统的角度出发。

其中一个关键策略,就是设定一套清晰的边界,在界线范围的所有变更都被允许,而不是制定过于严格的规则。

我不希望成为“审批警察”,对每一次更改都要审核批准。因此,我建立了一个预生产环境(Pre-Prod environment),让工程师们可以在没有风险的情况下测试和试验新方案,同时创建了 Terraform 模块,用于展示符合 PBS 标准的基础设施管理方式。

我希望通过以身作则来推动变革,同时尽可能用自动化手段减少人为失误,让工程师们能够直观理解自己的决策带来的影响,并信任他们能做出负责任的选择。

投资可观测性,推动成本意识

要让这一切真正发挥作用,我们还需要加强可观测性(Observability),因为你无法监控看不见的东西。

我们构建了自定义的可视化面板和报告工具,使团队能够清晰地看到他们的云资源消耗情况、延迟指标和其他关键性能指标。

通过以易于访问的方式呈现这些信息,我们成功打造了一种关注成本、重视性能的文化。

最有效的优化,往往是渐进式的

在不断优化系统的过程中,我们认识到,仅仅关注技术是不够的,我们还需要考虑更广泛的环境影响。

这要求我们采取务实且迭代的优化方法。我们无法每隔几年就彻底更换整个基础设施,因此,我们必须精通渐进式优化。

无论是调整数据库实例规格,还是优化视频编码效率,又或是自动化数据清理流程,每一项改进最终都会累积成显著的成本节省和碳减排。

这不仅仅是为了节约开支——作为 PBS,我们要以负责任的方式管理资源,这样才能将节省下来的资金再投资于更优质的内容和服务,回馈观众。

优化《芝麻街》内容交付的案例
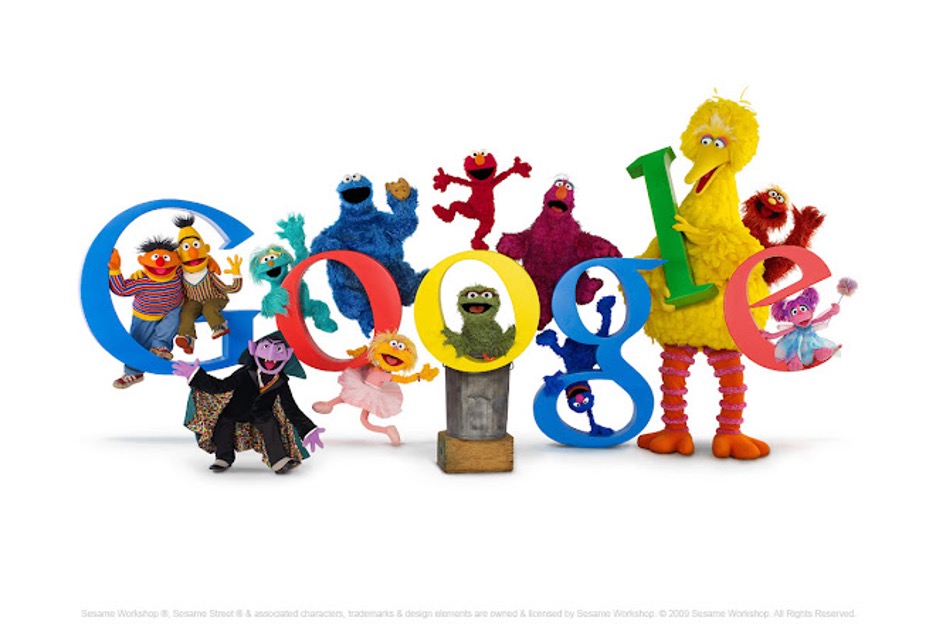

上述优化方法最具影响力的实践之一,是我们对《芝麻街》内容交付的优化工作。

早在 2009 年,当我们被邀请将《芝麻街》作为 Google Doodle 首页涂鸦展示时,我们就意识到,当时的本地部署基础设施根本无法承受预期的访问流量激增。

我们决定迅速将《芝麻街》网站迁移到 AWS,在这个过程中,我们不仅显著提升了内容交付系统的弹性和可扩展性,还积累了宝贵的云架构经验。

这次迁移成为 PBS 技术演进的一个关键转折点,证明了云架构能够让我们更加灵活地应对不断变化的需求。

04/打造俭约架构文化

这个故事并没有就此结束。

多年来,我们持续优化和完善内容交付系统,以支持日益增长的节目目录。其中,视频编码优化是我们重点关注的领域之一。

我们从传统的 AVC(H.264) 切换到 HEVC(H.265) 编解码格式,使得视频文件更小,从而减少存储占用、降低 CloudFront 的数据传输成本,同时也能够减少观众的流量消耗。

此外,我们启用了可变码率(Variable Bitrate Encoding,VBR),根据观众的网络状况来动态调整视频质量,在减少流量消耗的同时确保最佳观看体验。

对于不同类型的内容,我们采用了更具针对性的编码策略。

举个例子,对于占我们节目库很大一部分份额的儿童节目,我们通常选择较低的码率。许多孩子都是在低端设备或流量有限的网络上观看我们的内容,因此降低《芝麻街》等节目的流量消耗,能够直接帮助这些家庭减少月度流量费用。

我们认为,对于大多数儿童节目来说,观众几乎不会察觉 4K 和 720p 之间的显著差异,因此在这些场景下 720p 就足够了。

但对于画面质量要求更高的节目,我们仍然优先采用更高的码率和视频分辨率,以提供最佳观看体验。

部分优化由 AWS MediaConvert Automated ABR 提供支持,我们还借助 Mux Data 监测观众体验,确保我们的优化措施不会引发任何问题。

这些优化对我们的云成本产生了显著的影响。

在进行编解码切换和可变码率优化之前,我们需要人为地限制某个流媒体平台的最高画质为 720p 以降低成本。

然而,在 CloudFront 和 S3 账单大幅减少后,我们得以重新开放 1080p 高清流,让观众享受更高质量的视频体验。

通过主动优化和迭代的方法,我们在降低成本和减少环境影响的同时,依然能提供卓越的观众体验。

这些努力是我们在 PBS 培养俭约架构文化 的关键组成部分。

俭约架构文化的养成

培养俭约架构(Frugal Architecting)的文化并不容易,但它对我们的成功至关重要。我们必须打破团队壁垒、加强内部教育,并不断挑战各种可能性。

正是通过鼓励团队在成本和效率方面发挥创造性思维,我们才能在保持卓越观众体验的同时,始终践行 PBS 负责任管理的价值观。

为了达成这一目标,我们采取了一些关键措施:

  1. 定期分享成本与性能数据 —— 无论是某个新功能对云账单的影响,还是某项优化所带来的成本节约,我们都会公开展示这些成果,并以此强化团队的俭约意识。

  2. 打破工程师与产品团队的壁垒 —— 我们鼓励团队共同参与技术决策,而不是由工程师团队单方面制定架构策略。通过开放对话和相互理解,我们帮助产品团队认识到性能、安全性、可用性和成本优化也是产品特性的一部分,从而使我们的产品路线图更加一致,确保资源投入更有针对性。

当然,PBS 旅程仍在继续。

随着技术的演进和观众期望的变化,我们需要不断调整和优化系统。但我相信,俭约架构的理念将继续为我们提供坚实的基础,无论未来会遇到什么样的挑战,PBS 都能够始终专注于为观众创造有价值的内容。

每一分钱都至关重要

我在 PBS 的工作旅程中最难忘的时刻之一发生在几年前。

当时我们收到了一位名叫 Noah 的小观众的来信。Noah 寄来了一美元,并提出了一个简单的请求:“我希望你们制作一部名为《超级英雄来救援》的新节目。”

PBS 的儿童节目团队被这封信深深打动了,不到半个小时,他们就搭建了一个专属网页,向 Noah 表达感谢,并推荐了几部我们已有的超级英雄主题节目,希望他会喜欢。
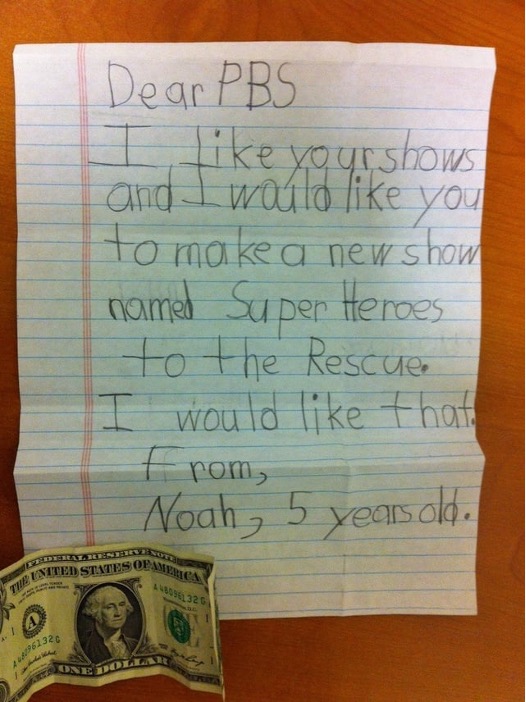
这封信不仅仅是一个孩子的请求,它提醒我们:“每一分钱都应当用在真正重要的地方。”

这一刻,完美诠释了 PBS 的使命——我们并不是为了技术而构建技术,而是为了更好地服务观众,激励和教育他们,并以负责任、可持续的方式实现这一目标。

无论是架构设计还是预算管理,我们所做的一切决策都围绕着这个核心目标展开。

这不仅仅是关于那些引人注目的成就,比如支持纪录片首映所做的弹性扩展或优化《芝麻街》的流媒体交付。

它还体现在那些微小但重要的优化——当我们能够在这里节省几美元,在那里减少一些浪费,再将这些节省重新投资于为观众创造更优质的内容和体验时,它同样意义非凡。

归根结底,这才是我们的初心。

我们并不是要构建全球最庞大、最强大的技术基础设施,而是要以符合我们俭约、可持续、使命驱动价值观的方式,来真正地改善更多像 Noah 这样的观众的生活。

因此,在未来的日子里,无论我们的系统如何演进和优化,我们始终会秉持这种精益求精、不断改进的精神。

我们会不断挑战自己、持续学习,并寻找新的方式,为观众提供卓越的价值,同时,始终做负责任的资源管理者。

毕竟,这正是作为一名俭约架构师,为观众服务的真正意义所在。

推荐阅读

美国版“大众点评”的 Karpenter 迁移实践:如何让每一分钱的效益提升25%?

kOps + Karpenter 集成实践:实现 K8s 集群的动态扩展

别再被忽悠啦!揭秘 AWS Savings Plans 的糖衣炮弹:省钱不成,反被“绑架”?

K8s HPA不扩容:5步排查与验收 K8s HPA 不扩容时,先别急着调高。HPA 负责调整工作负载的期望副本数,调度器负责把 Pod 放到节点,应用再经过启动和就绪检查。任何一层没有完成,业务都可能看不到新增容量。本文聚焦、Deployment 和 CPU 利用率型伸缩。自定义、外部指标会补充接口边界,但不假设所有集群都安装了同一种 adapter,也不把示例阈值当成容量建议。<...>是待替换参数,检查命令在同一个 Bash 会话里执行。只读取证不触发伸缩,不新增压测,不修改现有集群。修复模板需要读者的变更审批; 阅读详情

相关推荐

ISCC练习题MISC

解题技巧:看最后括号应该是IceCTF,先用了一键解码啥也没有啊,不对不对!好像是字符频率统计,转换网站:http://quipqiup.com/有人给你发了一串信息,你能解开吗?

m0_62737381的博客 1119

K8s弹性伸缩完整实战:HPA内置指标 + Prometheus自定义指标 + VPA垂直伸缩

Kubernetes弹性伸缩是生产环境保障服务稳定性、节约集群资源的核心能力。本文完整带你实操HPA基于CPU内存扩缩容、基于Prometheus QPS自定义指标实现伸缩,同时讲解VPA垂直Pod自动伸缩四种工作模式、部署踩坑与完整实验案例,理清水平扩容和垂直扩容适用业务场景。

Adhjhfes的博客 232

Keil MDK编译错误#541解决方案与ARM_Compiler包解析

在嵌入式开发中,编译器工具链的依赖管理是确保项目顺利构建的关键环节。以Keil MDK为例,其软件包依赖机制通过组件化设计实现功能解耦,其中ARM_Compiler包专门处理系统IO重定向等编译器扩展功能。这种架构既提升了模块复用性,也带来了版本兼容性挑战。当出现'Error #541: component missing'报错时,通常是由于中间件组件(如文件系统)在新版本中显式依赖了ARM_Compiler包。开发者需要通过Pack Installer安装该包,并在Run-Time Environment

weixin_32129187的博客 368

Jenkins -- gitee+docker+harbor+k8s 部署项目

一台是Jenkins服务器192.168..129.132 ,这台机器要有docker jdk环境。两台是k8s服务器,用来部署服务只需要关注主节点192.168..129.135。一台是harbor仓库服务器192.168..129.133。集群ip 10.244.0.113,用这个ip测试pod内部启动的服务是否正常。很多信息就图快,没有配置参数,凑合用,以后再考虑优化。返回hello kane666, 返回成功。需要配置k8s对harbor的链接。配置pipeline。

DGH2430284817的博客 52

Altium Designer操作技巧(1)——原理图中如何批量替换元器件?

《AltiumDesigner批量替换元器件技巧分享》摘要:本文介绍了两种在AltiumDesigner中批量替换元器件的实用方法。方法一通过“查找相似对象”功能,可精准匹配并批量修改器件参数;方法二利用ActiveBOM功能,在BOM表中直观操作器件替换,推荐使用第二种方法可使BOM管理更高效。这些技巧能有效减少物料种类、降低贴装成本,特别适用于电阻电容等常用器件的批量替换。关注公众号获取更多电子设计技巧。

u012526819的博客 2587

优化问题-半正定规划(Semi-Definite Program, SDP)

半正定规划(Semi-Definite Program, SDP)在MIMO无线通信相关的信号处理中具有广泛的应用,在某些场景可以分析证明SDP的得到的解释原问题的全局最优化或者次优解。

qq_33668008的博客 1万+

KubeSphere 容器云实践:从管理 K8s 到建设企业 PaaS,还需要哪些能力

安装KubeSphere后,怎样继续建设企业PaaS?结合RuoYi Office真实微服务环境,从工作负载管理、项目与权限、Jenkins发布、独立监控到运维目录,核对已经可用的能力和待补的交付契约,给出可复核的配置、权限检查与平台演进方法。

RuoYi Office是基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue3 + Vben Admin + Uniapp 构建的中小企业全业务办公一体化平台,涵盖OA 协同 367

Win11极速安装Tensorflow-gpu+CUDA+cudnn(含视频)

Win11极速安装Tensorflow-gpu+CUDA+cudnn(含视频链接)

weixin_46713695的博客 1万+

K8s 配置风险评审:从问题清单到修改对照

Kubernetes 工作负载配置检查完成后,整改评审还需要解决三件事:定位具体对象、解释风险是否适用、确认建议修改与当前配置的差异。只有风险清单,很难直接判断变更影响。

chrsh44e的博客 177

【Bug已解决】Codex App returns 401 Missing bearer/basic authentication after login on multiple Windows la

原始报错:Codex App returns 401 Missing bearer/basic authentication after login on multiple Windows laptops场景:用户在 Windows 笔记本上登录应用成功了,但随后每个业务请求都返回 401,提示"Missing bearer/basic authentication"。登录态像是"假的"——明明登了,请求却没带任何认证信息。多台 Windows 设备都能复现。

一键难忘的博客 596

《Python全栈系列教程》专栏介绍及文章汇总

《Python全栈系列教程》专栏介绍及文章汇总

孤寒者的博客 71万+

K8s 健康检查三大探针:存活、就绪、启动探针配置与排错实战

对于多副本应用, 当执行Scale Up操作时, 新副本会作为backend被添加到Service的负载均衡中, 与已有副本一起处理客户的请求。因为新副本本身没有异常退出, 默认的Health Check机制会认为容器已经就绪, 进而会逐步用新副本替换现有副本, 其结果就是: 当所有旧副本都被替换后, 整个应用将无法处理请求, 无法对外提供服务。例如,当存活探针可以探测到应用死锁(应用在运行,但是无法继续执行后面的步骤)情况,进而重启pod,有助于提高应用的可用性,即使其中存在缺陷。

weixin_63581562的博客 174

【LIN总线测试】——LIN主节点物理层测试

LIN总线是基于UART/SCI(通用异步收发器/串行接口)的低成本串行通讯协议。其目标定位于车身网络模块节点间的低端通信,主要用于智能传感器和执行器的串行通信,而这正是CAN总线的带宽和功能所不要求的部分。本章节主要介绍LIN主节点物理层如何测试?

测试领域技术分享 5532

K8s控制器揭秘:一键实现Pod自愈与自动扩缩

控制器是Kubernetes中实现Pod生命周期自动化管理的中间层,通过声明期望状态并持续比对实际状态,实现自愈、扩缩容与故障恢复。常用控制器包括:Deployment(无状态应用,支持滚动更新与回滚)、ReplicaSet(维持指定副本数)、DaemonSet(每节点运行一个Pod)、Job(一次性任务)、CronJob(定时任务)及StatefulSet(有状态应用,提供稳定标识、网络和存储)。其中,Deployment通过管理ReplicaSet实现版本迭代,而StatefulSet结合无头服务保障有

2301_80092853的博客 246

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

K8s Pod 反复重启 CrashLoopBackOff:从 exit code 到根因的 5 步排查

容器起来 37 秒就被杀、kubectl get pod 满屏 CrashLoopBackOff,而应用日志只有一行。本文给出一条从 exit code 反推根因的 5 步排查链,附 exit 137/143/1/2 与 OOMKilled 的对照表和最小复现。

2501_92769340的博客 266

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

容器化与 K8s 编排

容器化与K8s编排是云原生高可用的核心,但仅部署Docker+K8s仍难保障稳定性。真实场景中,扩容滞后、POD雪崩、发布故障、资源争抢等问题频发。需构建三层防御:通过QoS隔离、PDB防护、镜像预拉取保障POD稳定;基于多维度指标(CPU/QPS/RT)实现精准弹性扩缩容;结合可观测性与故障自愈机制,实现自动重启、驱逐与熔断。大促案例表明,唯有系统化治理才能避免连锁崩溃,真正实现高可用。

weixin_38805083的博客 158

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

K8s ConfigMap实战:配置解耦与动态更新

Kubernetes中ConfigMap用于存储配置数据,以键值对形式实现镜像与配置解耦,提升可移植性。支持通过命令行、文件、目录或YAML创建,最大1MB限制。可通过环境变量、envFrom或Volume方式注入Pod,适用于Nginx、MySQL等场景。企业级应用中,如phpMyAdmin+MySQL共用配置,确保参数统一管理,避免重复构建镜像,增强运维效率。

2301_80092853的博客 203

K8s的部署

名称IPsy-harbor。

2503_92709449的博客 179

K8s 动态存储供应:StorageClass 与 Local Path Provisioner 自动创建 PV 实战

之前创建存储卷(PV)都需要管理员手动操作,这类卷被称为静态卷。那么 Kubernetes 能不能 “智能” 管理卷呢?比如需要用卷时自动创建,不用时自动清理?答案是可以的 —— 这就是动态卷供应的能力。它彻底省去了集群管理员提前手动配置存储的工作,用户只要提出存储需求,系统就会自动创建对应的存储卷。

weixin_63581562的博客 314

docker run 的 6 个问题,K8s 逐个解决:从脚本部署到声明式发布

两个Ready,集群就绪。如果 node1 一直是NotReady,99% 是 Calico 的 Pod 没起来(),通常是因为拉不到镜像,或者防火墙没关。

weixin_45488455的博客 247

GPUWorks 免 K8s 交付:单二进制装起推理平台,异构加速卡统一纳管

面向受限机房的 GPUWorks 落地方法:单二进制免 K8s 交付推理服务,用适配层统一纳管多厂商加速卡,并给出路由、观测与分阶段上线步骤。

2301_78967866的博客 387

k8s -- 从harbor仓库拉取镜像

设计代码自动部署流水线,之前是使用doker,现在开始接入k8s参考文章k8s -- 切换docker镜像-优快云博客docker -- 上传镜像到harbor-优快云博客harbor -- 下载安装。

DGH2430284817的博客 95

k8s基础组件与创建资源

本文概述Kubernetes核心组件(Master/Worker节点及Add-ons)、使用kubeadm部署集群的流程,以及kubectl命令行工具的常用操作。涵盖节点管理、资源创建与删除、标签与选择器使用、Deployment控制器实现弹性扩缩容等关键内容,结合yaml配置实现声明式管理,提升集群运维效率。

我的梦想有多远,我就能走多远! 274

K8s Pod核心详解:从自主创建到控制器管理

Pod是Kubernetes最小部署单元,代表一个运行中的进程,共享网络与IPC命名空间。生产环境不推荐直接使用自主Pod,因其缺乏自愈、扩缩容和版本管理能力。应通过Deployment等控制器管理Pod,实现高可用、滚动更新、自动扩缩容及声明式配置。结合Service实现服务发现与负载均衡。推荐使用YAML清单定义资源,支持CI/CD、团队协作与版本控制。Pod内容器共享网络栈,可通过hostPort、nodeSelector、hostNetwork等策略精细调度与网络配置,合理设置资源限制可保障QoS。

2301_80092853的博客 368

Kubernetes与DevOps整合-Jenkins流水线自动部署到K8s集群

前文我们完成了 Jenkins Pipeline 从拉代码到推送 harbor 的全链路流水线,构建产物只是一个跑在 Docker 容器里的单实例应用。本篇把最后一公里补齐:流水线构建完成后,不再用 Publish Over SSH 在目标服务器上跑单容器,而是把 YAML 推送到 Kubernetes 集群,远程执行 kubectl 命令,以 Deployment + Service 的方式部署应用,真正实现容器编排级的自动化发布。

fb_12345的博客 387

k8s -- 切换docker镜像

现在高版本的k8s已经放弃使用docker,但是还是用docker比较顺手,所以还是配置镜像为docker。

DGH2430284817的博客 38
上一篇: 美国版“大众点评”的 Karpenter 迁移实践:如何让每一分钱的效益提升25%?
下一篇: 月活过亿的Canva如何在PB级数据存储上节省2700万?
CloudPilotAI
博客等级 码龄2年 519粉丝 58原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值