Scrapy之10行代码爬下电影天堂全站

python 电影天堂爬虫源文件 本文件是在python3下,编写的 一个简单的爬虫源码,大家可以交流一下。 本爬虫只适合于静态,通过分析 电影天堂网站,发现网站源码是静态的,固通过此方法将其下载地址进行抓取。 立即下载

前言

scrapy的强大相信大家已早有耳闻,之前用的时候只是感觉它爬取效率高,内部的异步封装很友好。殊不知我看到的知识冰山一角,它还有很多提高开发效率的功能,今天就以一个实例带大家窥探一二

工具环境

  • 语言:python3.6

  • 编辑器:Pycharm

  • 数据库:MongoDB

  • 框架:scrapy1.5.1

温馨提示:

阅读此文可能需要对scrapy框架有基本的了解,对xpath解析有一个基本的了解

爬取思路

爬取站点:dytt8.net/

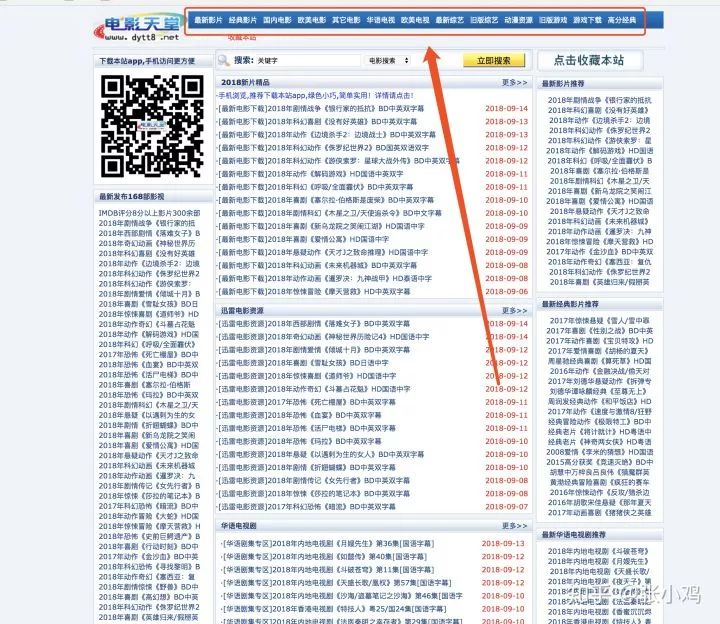
这样的站点我一眼望过去就想给站长打Q币,为什么啊?这站点简直是为爬虫而生啊?你看,一点花里胡哨的东西都没有,我们小眼一瞅便知,和我们不相关的就只是游戏部分的资源。我们需要如果要进入爬取更多的页面就只需要点击导航页
640?wx_fmt=jpeg

当我点开这些导航页,我都要惊喜的哭了,你们谁也别拦我,我要给站长打钱,对爬虫简直太友好了,我们其实只需要跟踪带有index页面的链接,然后深入下去爬取内页即可

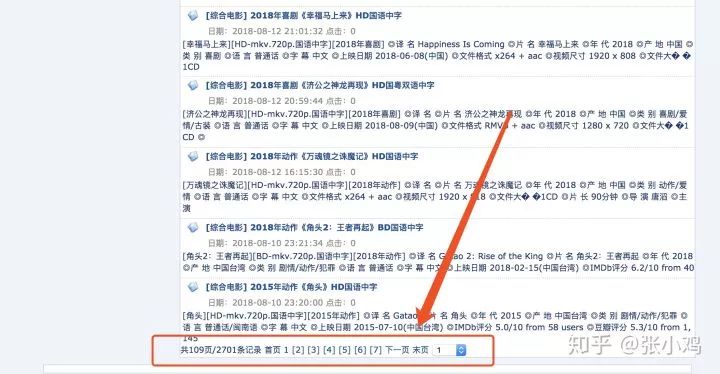
当我们到达内页,再看下哪里可以深入,这里其实也很简单,翻到最底下发现,只需要继续跟踪下一页链接即可
640?wx_fmt=jpeg

show me the code


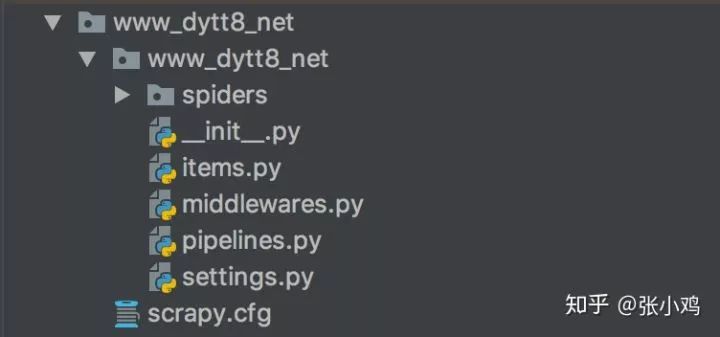
1. 新建项目文件

scrapy startproject www_dytt8_net 得到一个如下结构的文件目录 ?
640?wx_fmt=jpeg

2. 创建crawl模板样式的爬虫demo

先命令行进入到spiders目录下

cd www_dytt8_net/www_dytt8_net/spiders

然后创建爬虫模板

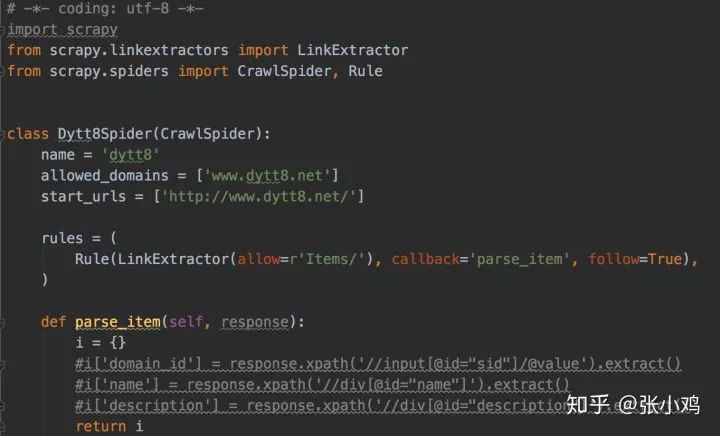
scrapy genspider -t crawl dytt8 www.dytt8.net


得到如下文件 ?
640?wx_fmt=jpeg

3. 配置跟踪页面规则

爬取思路中,我们已经介绍过了,只需要跟踪首页链接中,带有index的页面,进入到内页后,我们继续跟踪下一页即可遍历所有电影页面。简单了,我们配置一下rule,让爬爬开启追踪模式,黑喂狗→

这里的LinkExtractor的作用可以提取一些链接,通过对象提供的参数,方便我们进行追踪和过滤不需要的链接。如这里的deny表示我们不需要其中包含game字段的链接,而allow表示我们允许index的链接

其实内部还支持很多别的提取规则,小伙伴们可以去官方文档看看,全是爬虫的大杀器:

https://scrapy.readthedocs.io/en/latest/topics/link-extractors.html#module-scrapy.linkextractors.lxmlhtml


4. 导航页点击进去的下一页

Rule(LinkExtractor(restrict_xpaths=u'//a[text()="下一页"]'))

简直良心啊有木有?这要是平时,我们得写好几个代码段呐。这里就真的只需要一行,restrict_xpaths 支持xpath语法,提取标签页为下一页的所有a标签内的链接,这里其实我过滤掉了callback参数,表示这个页面跟踪后,交给谁处理下一步,还有一个参数是follow 可以设为True 或 False 表示接下来要不要对这个页面进行进一步的追踪

5. 提取文章页链接,交由解析函数处理

Rule(LinkExtractor(allow=r'.*/\d+/\d+\.html', deny=r".*game.*"), callback='parse_item', follow=True)

我们将页面中有这种形式的页面提取出来{数字}/{数字}.html 的页面提取出来其实就是详情文章页面,注意这里需要过滤掉是游戏的页面,所有增加拒绝跟踪链接的规则deny=r".*game.*",最后将提取到的链接回调给parse_item处理

6. 提取所需关键信息

在items.py内定义我们需要提取的字段

import scrapyclass WwwDytt8NetItem(scrapy.Item):
   # define the fields for your item here like:
   # name = scrapy.Field()
   title = scrapy.Field()
   publish_time = scrapy.Field()
   images = scrapy.Field()
   download_links = scrapy.Field()
   contents = scrapy.Field()

接着将spiders/dytt8.py中的回调函数中的提取规则写出来

    def parse_item(self, response):
       item = WwwDytt8NetItem()
       item['title'] = response.xpath('//div[@class="title_all"]/h1/font/text()').extract_first()
       item['publish_time'] = response.xpath('//div[@class="co_content8"]/ul/text()').extract_first().strip().replace('发布时间:', '')
       imgs_xpath = response.xpath('//div[@id="Zoom"]//img')
       item['images'] = [i.xpath('./@src').extract_first() for i in imgs_xpath if i.xpath('./@src')]
       item['download_links'] = re.compile('<a href="(ftp://.*?)">').findall(response.text)
       item['contents'] = [i.strip().replace('\n', '').replace('\r', '') for i in response.xpath('string(//div[@id="Zoom"])').extract()]
       yield item


7. 启动脚本看下运行状态

scrapy crawl dytt8

感受爬爬的力量吧?
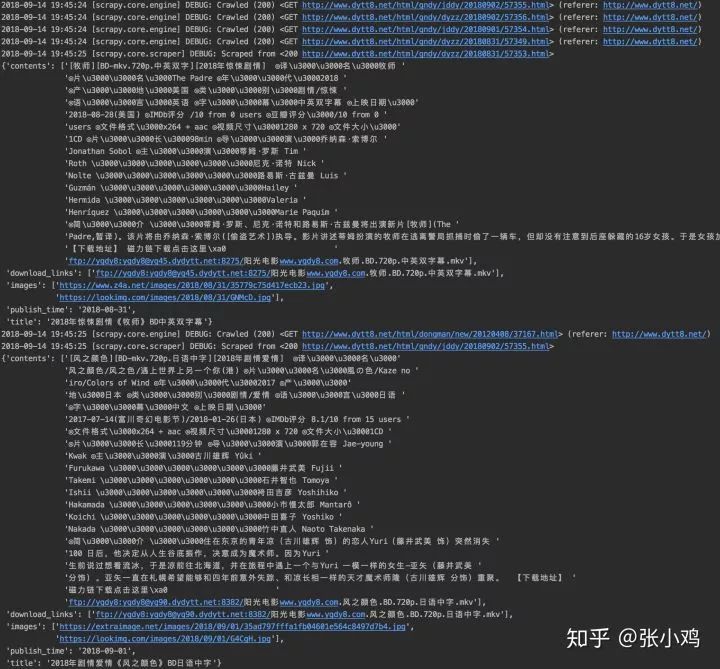
640?wx_fmt=jpeg


8. 数据库存储 这里介绍一下scrapy-mongodb,也是超级好用,省去了自己链接和配置的麻烦,没有下载的童鞋,可以pip安装下

我们只需要settings.py中,配置如下中间键

ITEM_PIPELINES = {
  # 'www_dytt8_net.pipelines.WwwDytt8NetPipeline': 300,
  'scrapy_mongodb.MongoDBPipeline': 300,
}

然后写入mongodb配置即可

MONGODB_URI = 'mongodb://localhost:27017'
MONGODB_DATABASE = 'spider_world'
MONGODB_COLLECTION = 'dytt8'

来,咱们状态全开run一波,最后得到2W+部片子

至此,我们便可以看到满满的电影种子链接,以后有什么想看的电影,自己直接在库里找找看,是不是很棒啊真正核心代码其实不到十行!!!以后不是很复杂的爬虫,还是用丝瓜皮吧,人生苦短,请用丝瓜皮

戳阅读原文,查看完整代码

Python-pythonscrapy爬取电影天堂所有电影 python scrapy爬取电影天堂所有电影 立即下载

相关推荐

状态机与RTOS的融合实践:如何避免‘状态爆炸’并提升系统响应

本文探讨了状态机与RTOS的融合实践,重点介绍了如何通过层次化状态机、表驱动设计等策略避免状态爆炸问题,并优化任务调度与事件处理机制,从而显著提升嵌入式系统的响应速度和可靠性。

net55的博客 107

Python爬取第一电影天堂最新电影(5000多部)代码实例(一)

1、实例代码: #!/usr/bin/env python #-*- coding: utf-8 -*- #@Time : 2020/4/7 16:28 #@Author : zhangliangliang #@File : crawlerDemo3.py #@Software: PyCharm from urllib import request from lxml import...

zll_1234的博客 1万+

全局子程序 参数调用

为什么要子程序: 为了实现程序结构化,我们尽量使用不同功能的功能块来实现一些特定的功能, 子程序接口: 使用过程的注意事项,尤其是数组使用时的注意事项 从一个主程序中可以将参数传递到局部或全局子程序和函数中。 怎样传递参数有 2 种方式: 作为 IN 参数 变量值在主程序中保持不变。 这种传递方式也称为“ 值传递 (Call by Value)”。 作为 OUT 参数 子程序读取并更改该值,然后将新值写回到主程序中。 这种传递方式也称为“Call by Reference”。 举例说明 1 DEF MY

Eric_Yang1024的博客 1095

python-电影天堂爬取

【代码】python-电影天堂爬取。

LeonTree09233的博客 6835

[零基础]用docker搭建Hadoop集群

[零基础]用docker搭建Hadoop集群,每一步都有详细的解释!

weixin_56114243的博客 2万+

在 Ansys Mechanical 中使用“螺栓工具”插件自动生成螺栓

在有限元分析 (FEA) 中,高效创建螺栓连接对于确保机械装配的结构完整性和性能至关重要。螺栓是连接组件不可或缺的一部分,它们在负载下的精确建模会影响整个系统。快速高效的螺栓建模使工程师能够快速优化设计,满足紧迫的期限,并通过为其他关键设计任务释放资源来提高整体生产力。此外,螺栓建模的精度可以最大限度地降低模型创建过程中出错的风险,这对于获得可靠和准确的分析结果至关重要。因此,在 FEA 中快速且无错误地创建螺栓连接对于高效、可靠和成功的工程结果至关重要。

jkh920184196的博客 3101

Python抓取电影天堂,零基础都可以学?源码&视频,大赞!

我知道,大家肯定是看到Python源码&视频教程才进来的。小编说到做到,此次利用Python爬取电影天堂包含视频教程、以及源码。所以说零基础的Python新手也能够轻松学会,真的一点都不过分。 ...

cudykf6382的博客 5720

六、大模型(LLMs)参数高效微调(PEFT) 面

链接: https://pan.baidu.com/s/1TYqdCK53tDFEYGtAvpnTbA 提取码: 6a9s。考核中的核心考点,并针对这些考点提供了详尽的解答。通过网盘分享的文件:06大模型(LLMs)参数高效微调(PEFT) 面。)有哪些方法,能不能稍微介绍一下它们间?这种微调方法和全参数比起来有什么劣势吗?能不能总结一下各种参数高效微调方法?高效参数微调,如何进行存储?多种不同的高效微调方法对比。模型显存占用的部分有哪些?微调方法为啥能加速训练?微调计算可训练参数的比例。

weixin_51988935的博客 534

python制作专属功能_大牛教你用Python打造一款属于自己的专属影院!再也不买电影票了...

2. 安装完Python以后,如果不出意外,应该是已经安装了pip。通过pip可以非常方便的管理Python第三方包。可以在CMD或者任何shell终端输入pip -V,如果提示了找不到pip命令,说明pip没有安装成功。那么可以通过easy_install install pip来进行安装。3. requests库。这个库是专门用来做网络请求的。他比Python自带的urllib库好用很多,在u...

weixin_39563827的博客 1280

DFIG风电场经LCC-HVDC外送系统SIMULINK建模与仿真

本文基于MATLAB/Simulink平台构建了DFIG风电场经LCC-HVDC外送系统的仿真模型。系统采用1000MW聚合DFIG模型与双极12脉动LCC-HVDC连接,详细阐述了参数设计、控制策略及接口协调方法。重点解决了风电场无功能力不足、功率波动影响换相等关键技术问题,为大规模风电基地外送提供了仿真研究框架。模型整合了官方DFIG和HVDC详细模块,通过参数缩放和控制系统优化,实现了完整系统的动态仿真分析。

huanghm88的专栏 120

vue支付项目-APP支付宝支付功能

如果用户已安装支付宝客户端,商家 App 唤起支付宝完成支付,支付完后跳回到商家 App 内,最后展示支付结果。如果用户没有安装支付宝客户端,商家 App 内会调起支付宝网页支付收银台,用户登录支付宝账号,支付完后展示支付结果。1.点击按钮开通或者续费,会验证是否选择会员商品以及对协议是否查看选中(这里根据项目需要自行验证,可忽略),验证通过打开选择支付方式弹窗页面,选择微信支付或者支付宝支付;4.可取消支付,放弃支付会返回会员页面,页面提示支付取消;1.判断支付方式,如果是2,则是支付宝支付方式。

总结前端开发中遇到的问题,分享前端知识 1万+

分享105个Python爬虫源代码总有一个是你想要的

python爬虫,网易云音乐歌曲爬取,B站视频爬取,知乎问答爬取,壁纸爬取,xvideos视频爬取,有声书爬取,微博爬虫,安居客信息爬取+数据可视化,哔哩哔哩视频封面提取器,ip代理池封装,知乎百万级用户爬虫+数据分析,github用户爬虫。基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容。支付宝爬虫(基于Scrapy)中国所有学校地理位置Json数据库(省市区地址,坐标)(分校区,大学,中学,小学等等)(Python爬虫)

zy0412326的专栏 904

FFDNet-pytorch版本代码训练教程

该文章为FFDNet-pytorch版本代码训练教程,抓紧订阅学习!尽早入门发论文哦!

假技术Po主 1507

qpython3可视图形界面_Python + PyQt5 实现美剧爬虫可视工具

美剧《权力的游戏》终于要开播最后一季了,作为马丁老爷子的忠实粉丝,为了能够看得懂第八季复杂庞大的剧情架构,本人想着将前几季再稳固一下,所以就上美剧天堂下载来看,可是每次都上去下载太麻烦了,于是干脆自己写个爬虫爬下来得了。话不多说,先上图片。本人才疏学浅,就写了个简单的可视化软件,关键是功能实现就行了嘛。实现语言:Python ,版本 3.7.1实现思路:首先运用 Python 工具爬取到数据再实现...

weixin_39656686的博客 364

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

爬虫 - 收藏集 - 掘金

爬虫修炼之道——从网页中提取结构化数据并保存(以爬取糗百文本板块所有糗事为例) - 后端 - 掘金欢迎大家关注我的专题:爬虫修炼之道 上篇 爬虫修炼之道——编写一个爬取多页面的网络爬虫主要讲解了如何使用python编写一个可以下载多页面的爬虫,如何将相对URL转为绝对URL,如何限速,如何设... 掌握 python 爬虫对数据处理有用吗...

weixin_34290000的博客 282

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

盘点60个Python爬虫源码Python爱好者不容错过

盘点60个Python爬虫源码Python爱好者不容错过

weixin_47730343的博客 1257

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Python40行代码爬取电影天堂的电影下载连接

Python40行代码爬取电影天堂的电影下载连接 比较基础的爬虫 import re import requests import csv o1 = re.compile(r'2021新片精品.*?<ul>(?P<ul>.*?)</ul>', re.S) o2 = re.compile(r"href='(?P<href>.*?)' title", re.S) o3 = re.compile(r'◎片  名 (?P<name>.*?)<br

Harris-H的博客 1万+

python找电影资源_python一键电影搜索与下载

# python一键电影搜索与下载## 概述使用python搜索并爬取豆瓣电影信息,包括评分,主演,导演,类型,上映时间,电影简介等信息,然后再从电影天堂搜索并爬取电影下载链接.![概述](https://raw.githubusercontent.com/WHJWNAVY/myImage/master/PicGo/20181023180750.png)## 准备工作### 安装python3.6...

weixin_39721924的博客 7366

新手python爬虫代码-Python爬虫实战之取电影天堂,,新手练手项目

前言:本文非常浅显易懂,可以说是零基础也可快速掌握。如有疑问,欢迎留言,笔者会第一时间回复。本文代码存于github一、爬虫的重要性:如果把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛。网络蜘蛛通过网页的链接地址来寻找网页,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,一直循环下去,直到把整个网站所有的网页都...

weixin_37988176的博客 2465

python下载电影_Python抓取电影天堂电影信息的代码

Python2.7Mac OS抓取的是电影天堂里面最新电影的页面。链接地址: http://www.dytt8.net/html/gndy/dyzz/index.html获取页面的中电影详情页链接import urllib2import osimport reimport string# 电影URL集合movieUrls = []# 获取电影列表def queryMovieList():url =...

weixin_39914825的博客 2877

Python爬虫框架:scrapy爬取迅雷电影天堂最新电影ed2k

项目开始 第一步仍然是创建scrapy项目与spider文件 切换到工作目录两条命令依次输入 scrapy startproject xunleidianying scrapy genspider xunleiBT https://www.xl720.com/thunder/years/2019 内容分析 打开目标网站(分类是2019年上映的电影),分析我们需要的数据 进入页面是列表的形式就像豆...

人生苦短, 还不用Python? 3084

Python爬虫(二)——爬取电影天堂,保存下载地址

首先我们开始要分析一下,下载种子我们需要哪几步: 获取所有电影页的访问地址 获取电影页源码 提取出下载地址 将下载地址保存 首先第一步,我们来分析一下电影天堂网站的结构,发现他跟我们的古诗文网还是非常类似的,全站静网结构,不需要登录,页面有全新的地址,这对于初学来讲是非常容易上手的;接下来我们以国内电影(https://www.ygdy8.net/html/gndy/china/index...

geeknuo的博客 1万+

python爬取电影天堂首页

用python写了个小爬虫,用来爬取电影天堂首页放置的几十部电影的名称,上映日期和下载链接,用到了beautifulsoup库和lxml库用来解析 代码如下: import requests import re from lxml import etree from bs4 import BeautifulSoup from pandas import DataFrame class dytt:...

SSSuperbeyond的博客 2386

Python 网络爬虫实战:采集《电影天堂》上万部动作片电影

不知不觉,玩爬虫玩了一个多月了。 我愈发觉得,爬虫其实并不是什么特别高深的技术,它的价值不在于你使用了什么特别牛的框架,用了多么了不起的技术,它不需要。它只是以一种自动化搜集数据的小工具,能够获取到想要的数据,就是它最大的价值。 很多人学习python,不知道从何学起。 很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手。 很多已经做案例的人,却不知道如何去学习更加高深的知识。 那么针对这三类人,我给大家提供一个好的学习平台,免费领取视频教程,电子书籍,以及课程的源代码!??¤QQ群:

Python_sn的博客 9656

python爬取电影天堂

import requests from lxml import etree ''' 想要学习Python?Python学习交流群:973783996满足你的需求,资料都已经上传群文件,可以自行下载! ''' BASE_DOMAIN = 'http://dytt8.net' HEADERS = { 'User-Agent':'Mozilla/5.0 (Windows NT 6.1; W...

人生苦短, 还不用Python? 3636
上一篇: 爬虫界又出神器|一款比selenium更高效的利器
下一篇: 10万+的短视频被批量生产了,Python表示不服
菜鸟学Python
博客等级 码龄9年 8062粉丝 571原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值