python爬取boss直聘岗位-写入excel(有图+有代码)

Boss直聘岗位数据爬取实战:从分析接口到生成Excel报表的全流程 本文详细介绍了Boss直聘岗位数据爬取的全流程,从分析接口到生成Excel报表。通过Python技术栈实现数据采集、清洗和分析,帮助用户掌握行业动态和薪资水平,优化求职策略。重点讲解了反爬机制应对策略、数据解析与存储技巧,以及如何利用Pandas进行数据可视化和报表生成。 阅读详情

效果

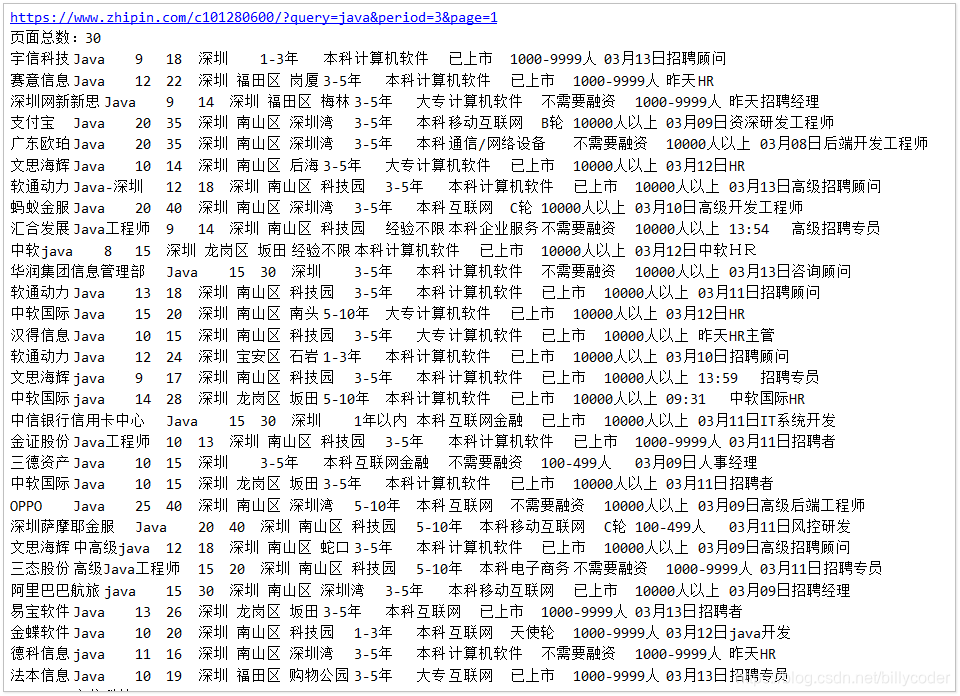
日志
在这里插入图片描述
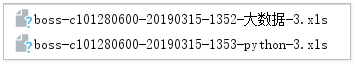
输出
在这里插入图片描述
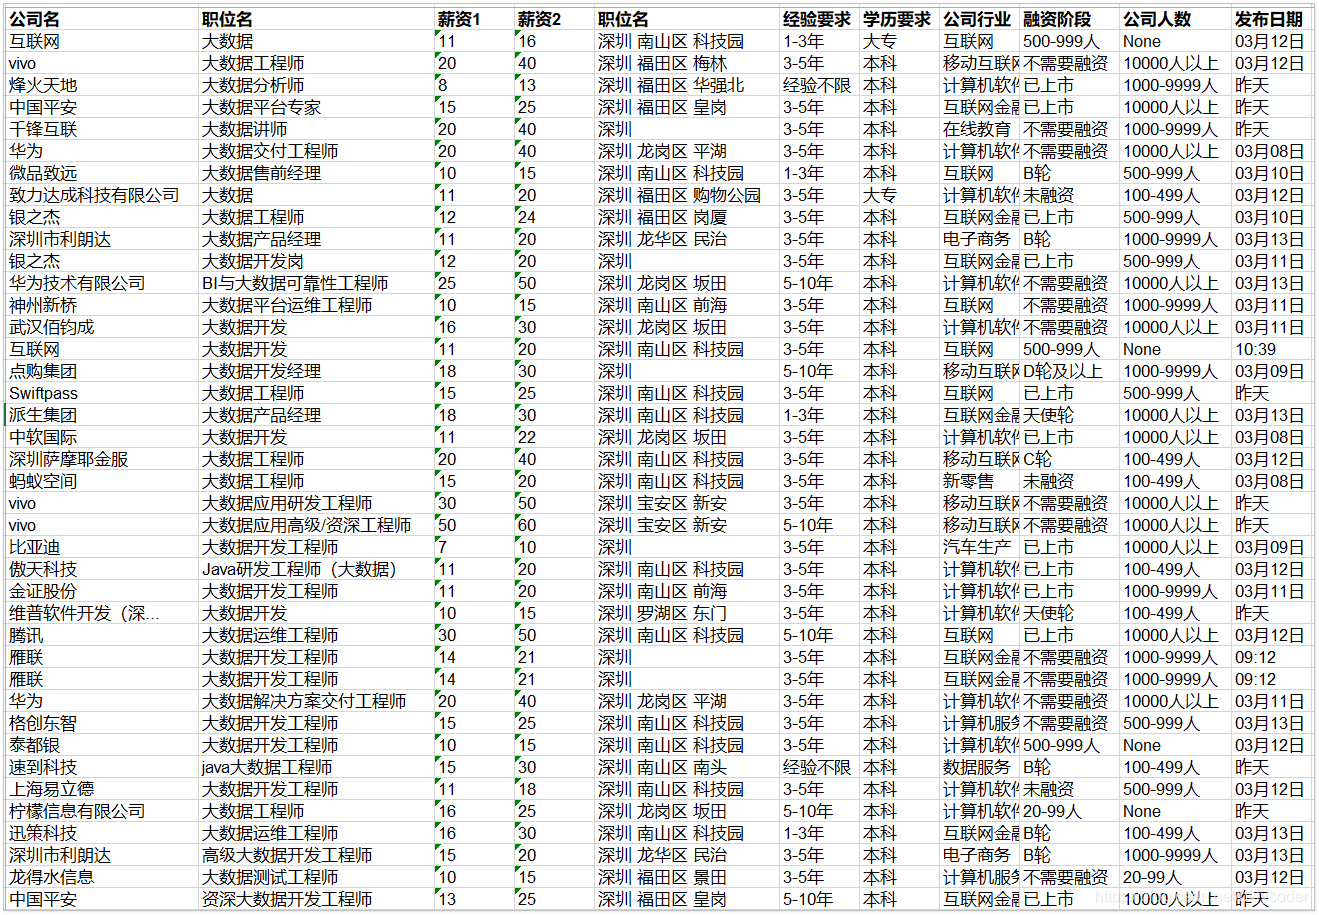
表格内容
在这里插入图片描述

代码

import requests
from bs4 import BeautifulSoup
import time
import xlwt  # 用来创建excel文档并写入数据


def initRequest():
    global url_pattern, headers
    url_pattern = 'https://www.zhipin.com/{}/?query={}&period={}&page='.format(city, key, period)
    headers = {
        'user-agent': 'Mozilla/5.0'
    }


def initExcel():
    global newTable, wb, ws, headData
    hud = ['职位名', '薪资1', '薪资2', '职位名', '地点', '经验', '学历', '公司行业', '融资阶段', '公司人数', '发布日期', '发布人']
    print('\t'.join(hud))

    import datetime
    nowTime = datetime.datetime.now().strftime('%Y%m%d-%H%M')  # 现在
    newTable = "boss-" + city + "-" + nowTime + "-" + key + "-" + period + ".xls"  # 表格名称

    print(newTable)

    wb = xlwt.Workbook(encoding='utf-8')  # 创建excel文件,声明编码
    ws = wb.add_sheet('sheet1')  # 创建表格
    headData = ['公司名', '职位名', '薪资1', '薪资2', '职位名', '经验要求', '学历要求', '公司行业', '融资阶段', '公司人数', '发布日期', '发布人']  # 表头部信息
    for colnum in range(0, len(headData) - 1):
        ws.write(0, colnum, headData[colnum], xlwt.easyxf('font: bold on'))  # 行,列


def excel_write(items, index):
    # 爬取到的内容写入excel表格
    for item in items:  # 职位信息
        for i in range(0, len(headData) - 1):
            # print item[i]
            ws.write(index, i, item[i])  # 行,列,数据
            print(str(index) + "\t" + str(i) + "\t" + item[i])
        index += 1


def start():
    try:
        page = 1
        pageSize = 0
        for n in range(1, 11):
            url = url_pattern + str(page)
            print(url)
            html = requests.get(url, headers=headers)
            page += 1
            soup = BeautifulSoup(html.text, 'html.parser')
            items = []
            jobPrimarys = soup.find_all('div', 'job-primary')
            if pageSize == 0:
                pageSize = len(jobPrimarys)
                print("页面总数:" + str(pageSize))
            for jobPrimary in jobPrimarys:
                item = []
                # print(gongsi)
                gongsi = jobPrimary.find('div', 'company-text').find('a').string
                item.append(gongsi)  # 公司名

                item.append(jobPrimary.find('div', 'job-title').string)  # 职位名

                xinzi = jobPrimary.find('span', 'red').string
                xinzi = xinzi.replace('k', '')
                xinzi = xinzi.split('-')
                item.append(xinzi[0])  # 薪资起始数
                item.append(xinzi[1])  # 薪资起始数

                yaoqiu = jobPrimary.find('p').contents
                item.append(yaoqiu[0].string if len(yaoqiu) > 0 else 'None')  # 地点
                item.append(yaoqiu[2].string if len(yaoqiu) > 2 else 'None')  # 经验
                item.append(yaoqiu[4].string if len(yaoqiu) > 4 else 'None')  # 学历

                gongsi = jobPrimary.find('div', 'info-company').find('p').contents
                item.append(gongsi[0].string if len(gongsi) > 0 else 'None')  # 公司行业
                item.append(gongsi[2].string if len(gongsi) > 2 else 'None')  # 融资阶段
                item.append(gongsi[4].string if len(gongsi) > 4 else 'None')  # 公司人数

                item.append(jobPrimary.find('div', 'info-publis').find('p').string.replace('发布于', ''))  # 发布日期
                item.append(jobPrimary.find('div', 'info-publis').find('h3').contents[3].string)  # 发布人

                print('\t'.join(item))

                _item = tuple(item)  # 转为元组
                items.append(_item)  # 转为数组
                time.sleep(1)

            # 写入excel
            index = (n - 1) * pageSize + 1
            excel_write(items, index)
    except:
        wb.save(newTable)
        pass
    # 保存
    wb.save(newTable)


print("----------初始化参数----------")
key = 'java'  # 搜索关键字
period = '3'  # 1天发布,1; 3天发布,2; 7天发布,3;
city = 'c101280600'  # c101280600 深圳

print("----------初始化请求----------")
initRequest()

print("----------初始化excel----------")
initExcel()

print("----------开始----------")
start()

数据分析师如何用爬虫搞定Boss直聘的“市场营销”岗位数据?一份实战指南 本文详细介绍了数据分析师如何利用Python爬虫技术高效获取Boss直聘上的市场营销岗位数据。从网站结构分析到爬虫构建,再到数据存储与分析,提供了一套完整的实战指南,帮助读者掌握爬取招聘数据的核心技能,为市场研究和职业分析提供数据支持。 阅读详情

相关推荐

python:实现爬取boss直聘并可视化(附完整源码)

python:实现爬取boss直聘并可视化(附完整源码)

希望我的博客,能帮上你解决学习中工作中所遇到的问题 2959

Scrapy 简易爬取Boss直聘 可设定city job 爬取工作到excel或mysql中

 2018-5-17一、 本篇讲述了如何编写利用Scrapy爬虫,把数据放入到MYSQL数据库中和写入到excel中,由于笔者之前爬取过拉勾网,但个人倾向与Boss直聘,所以再次爬取Boss直聘来作为知识梳理二、 Scrapy工作原理介绍,之前的总结中已经介绍过了,而且网上有data flow 流程图,这里主要说一下,Scrapy中先是将SPIDERS中的url放入调度器,通过引擎,再经过DOWN...

Tenderness4的博客 1193

Python 爬虫实战:爬取 BOSS 直聘岗位薪资数据

本文详细介绍了使用Python爬取BOSS直聘岗位薪资数据的技术方案。文章首先分析了BOSS直聘的页面结构和反爬机制,然后基于requests和BeautifulSoup库构建爬虫程序,实现岗位名称、薪资范围、公司信息等关键数据的抓取。代码采用模块化设计,包含请求发送、页面解析、数据存储等功能,并针对反爬措施设置了随机延迟和UA伪装。同时强调爬虫行为的合规性,要求控制请求频率、避免商业用途。文中还提供了常见问题解决方案及动态页面爬取、代理池集成等进阶优化方向,为招聘数据分析提供了可行的技术参考。

2503_91057718的博客 2054

PYTHON实现爬取boss直聘信息并添加注释

很高兴为您解答。爬取boss直聘信息并添加注释可以使用Python编写爬虫程序来实现,具体步骤如下: 使用requests库发送HTTP请求,获取要爬取的网页源代码; 使用BeautifulSoup库解析网页源代码,提取所需信息; 使用pandas库将提取的信息存储到DataFrame中; 使用openpyxl库将DataFrame中的信息存储到Excel中,并为每一条信息添加注释; 使...

weixin_42589700的博客 695

求职效率提升:BOSS直聘岗位爬虫(新手友好版),薪资/地点一键筛选

这款BOSS直聘爬虫的核心价值在于“精准筛选+省时省力”——无需手动翻页、无需逐个过滤不符合条件的岗位,爬虫自动完成“爬取→筛选→排序→导出”全流程,直接输出高优先级岗位列表。数据包含求职决策的所有核心字段,Excel格式支持二次个性化筛选,无论是校招应届生还是社招跳槽,都能快速找到符合薪资、地点、经验要求的优质岗位,避免错过机会。代码完全开源,新手可直接复用,进阶用户可根据需求添加更多功能(如岗位详情爬取、微信推送),轻松适配个性化求职需求。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 2522

Boss直聘Python岗位数据采集:基于DrissionPage的招聘信息爬取实战

本文介绍了一个基于DrissionPage库的Boss直聘Python岗位数据采集系统。该系统通过分析Boss直聘的动态加载机制和反爬策略,采用浏览器自动化技术模拟真实用户行为,结合数据包监听直接获取结构化JSON数据。详细解析了从环境配置、数据采集到解析存储的全流程实现,包括7个关键步骤:数据加载机制分析、反爬机制分析、技术选型决策、数据存储设计、多页批量采集、数据解析清洗和Excel存储。系统可获取招聘者信息、职位详情、企业信息等关键字段,为市场研究和职业规划提供数据支持。

那些看似不起波澜的日复一日,会在某天让你看到坚持的意义 1224

Python爬虫实战 - 抓取BOSS直聘职位描述 和 数据清洗

在详情页中,比较重要的就是职位描述和工作地址这两个 由于在页面代码中岗位职责和任职要求是在一个 div 中的,所以在抓的时候就不太好分,后续需要把这个连体婴儿,分开分析。

白帽阿叁的博客 3257

python爬虫Scrapy(一)-我爬了boss数据

Python,使用Scrapy爬取Boss直聘数据。 资源讲解地址:https://www.cnblogs.com/swarmbees/p/10011898.html

BOSS直聘岗位python爬取2(完整代码+详细介绍)

引用上篇对boss直聘每个岗位的源代码获取了之后,对字段的爬取前言:https://blog.youkuaiyun.com/weixin_52001949/article/details/135452969如有问题可私信关注博主。

麻辣清汤的博客 4084

通达信+大智慧数据同步存调DLL

数据同步存调DLL(通达信版+大智慧版)

guleba的博客 2060

HPE磁盘阵列管理04——MSA事件

本文介绍了HPE MSA存储系统的事件处理机制,重点分析了常见磁盘故障事件及其解决方案。文章首先定义了MSA事件的五个严重级别(严重、错误、警告、信息和解决),然后详细列举了多个典型事件案例(如事件1、3、6、8、172等),包括每种事件的触发条件、对系统的影响以及具体修复步骤。针对磁盘故障场景,文章提供了更换磁盘、重建磁盘组、取消隔离等操作建议,并强调应及时配置备用磁盘以降低数据风险。最后指出更详细的事件说明可参考《MSA事件描述参考指南》,并提供了HPE官方手册下载链接。全文为技术人员处理MSA存储故障

istrangeboy&begin zero的博客 1123

Python 实战:Boss 直聘职位信息爬虫开发全解析​

Boss直聘爬虫

m0_73690216的博客 8314

Linux-RGMII PHY 88E1512 驱动调试记录

1. 简介 1)开发板平台:创龙 AM5728 (tl5728-easy-evm) 2)PHY芯片:Marvell 88E1512 88E1512和88E1510都是一个系列的phy,采用marvell的通用phy驱动,驱动源码路径如下:drivers/net/phy/marvell.c 2. 应用场景 1)系统框图 AM5728连接两个PHY,PHY0的工作模式是 RGMII to Copper (RGMII到电口),PHY1的工作模式是 RGMII to SGMII。 两个PHY与处理器的连接方式都是

weixin_40407893的博客 2万+

Python3 + xpath + excel 实现对boss直聘网的爬取

一、项目简介 1.内容:抓取boss直聘网上广州地区的 python 相关工作的招聘信息,并且将招聘信息循环保存在excel表中 2.目标网站:https://www.zhipin.com/c101280100/?query=python&page= 3.使用软件:pycharm 4.使用版本:python3.7 5.涉及的python类库:requests、xlwt、lxml ...

only···的博客 3007

H5 获取手机GPS坐标

只要手机有GPS模块,可以用HTML5的Geolocation接口获取 在HTML5中,geolocation作为navigator的一个属性出现,它本身是一个对象,拥有三个方法: getCurrentPosition watchPosition clearWatch 1.简单 function getLocation(){ if(navigator.geolocation){ //判断是否有这个对象 navigator.geoloc

达拉崩巴斑得贝迪卜多比鲁翁_ 4670

OpenClaw 3.13 + Mac mini M4 集成 qmd 记忆存储:qmd embed 卡死 / 报错 sqlite-vec 不可用 终极解决教程

模型加速让 qmd 从国内镜像下载模型,避免网络超时;SQLite 扩展支持:修改 qmd 源码后,Bun 不再使用内置 SQLite,而是调用 Homebrew 安装的,该版本支持接口,可正常加载vec0.dylib向量扩展;OpenClaw 3.13 适配:核心逻辑与 OpenClaw 3.13 的 qmd 记忆调用逻辑完全兼容,无需额外调整;sqlite-vec 加载:qmd 自动通过sqlite-vec包获取vec0.dylib路径,调用完成向量扩展加载,实现高效向量搜索。

wuanxionglidui的博客 1305

python抓取boss直聘招聘信息

目前测试情况看只能抓取头3页,后续得重新换cookie抓取。 (https://zhuanlan.zhihu.com/p/62030238) #!/usr/bin/python # -*- coding:utf-8 -*- import requests from bs4 import BeautifulSoup import time import xlrd import xlwt impor...

Haikuotiankong11111的博客 2886

120、NPU的Mythic M1076:模拟存算一体NPU

这篇文章分享了作者调试Mythic M1076模拟存算一体NPU的实战经验,主要包含以下要点: 硬件设计陷阱:参考电压输入必须使用低ESR电容,普通贴片电容会导致模拟计算阵列工作异常。 核心技术原理: 采用真正的存算一体架构,将权重存储为模拟电压 使用浮栅晶体管存储权重,通过电流叠加实现乘法运算 包含108个计算单元阵列(Tile),每个256×256规模 使用注意事项: 编程模型特殊,需要依赖SDK自动映射网络层 存在6-8位有效精度限制,需用量化感知训练 功耗特性独特,静态偏置电流占主要功耗 调试手段有

m0_50546716的博客 124

boss直聘账号异常登不上_Python爬取Boss直聘上面的招聘信息

2019-5-5 更新:警告:使用ip代理并且不要带个人cookie!警告:使用ip代理并且不要带个人cookie!警告:使用ip代理并且不要带个人cookie!我个人已经无法登陆http://zhipin.com ,登陆刷新一次就是403被封ip,但是换ip后登陆刷新马上又被封。目测是ip+账号被网站拉黑了。提示信息是说24小时解封,但是这种情况从5月4号就已经出现。--------------...

weixin_39957835的博客 3694

YOLO26科研升级:OREPA在线重参数化,让模型精度在训练中持续跃升

在目录下,新建AddModules文件夹,将orepa.py放入其中。

LXY_LOVE36的博客 100

把 ABAP ALV 表头做成两层分组:用 TOP-OF-PAGE 手工绘制双行列标题

摘要:本文介绍了在SAP ALV List中实现双层表头的方法。通过关闭系统默认列标题(no_colhead='X'),在TOP_OF_PAGE事件中手动绘制表头,使用sy-uline和sy-vline绘制线条实现分组效果。关键点包括:1)关闭系统表头;2)在事件处理中分两行输出分组标题和字段名;3)利用系统自动拼接线条的特性绘制表格边框。文中还指出了常见问题如线条自动粘连、颜色不生效等,并提供了完整示例代码和详细解释。这种方法适用于需要对字段进行业务分组的报表场景。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 261

boss直聘python_使用python抓取boss直聘岗位信息

此文档,需要提前设置好google的webdriver。抓取的信息会保存为xls表可以替换url=参数来寻找不同岗位和地区:先打开boss直聘网站,然后根据自己想要查询的岗位进行搜索,再复制url连接#!/usr/bin/python3#-*-conding:utf8 -*-from time import sleepimport osfrom selenium import webdriveri...

weixin_39800971的博客 694

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

bs4爬取的时候有两个标签相同_Python 爬取 Boss 直聘上面的招聘信息

2019-5-5 更新:警告:使用 ip 代理并且不要带个人 cookie!警告:使用 ip 代理并且不要带个人 cookie!警告:使用 ip 代理并且不要带个人 cookie!我个人已经无法登陆 http://zhipin.com ,登陆刷新一次就是 403 被封 ip,但是换 ip 后登陆刷新马上又被封。目测是 ip +账号被网站拉黑了。提示信息是说 24 小时解封,但是这种情况从 5 月 ...

weixin_29310605的博客 216

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

通过python的selenium爬取boss直聘的岗位信息

(ps:不得不说,boss直聘的岗位筛选做得真的是拉得一批,几个月半年不在线的还放出来放在前面,搞个好点权重或者活跃筛选有那么难吗,在招聘领域占市场那么大的份额,一点上进心都没有,尸位素餐,简直混账。直接copy代码就能跑,但毕竟是demo,代码比较粗糙,需要的话请自行按需调整代码。

hunwanjie的博客 660

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

用Python爬Boss直聘岗位数据,手把手教你从分析到导出Excel(附完整源码)

本文详细介绍了如何使用Python爬取Boss直聘的岗位数据,从环境搭建、API分析到数据爬取与处理的全过程。通过实战代码示例,教你如何高效获取并分析市场营销类岗位信息,最终导出Excel报表,为求职者和HR提供数据支持。

weixin_32202001的博客 819

boss直聘python_简易python爬虫爬取boss直聘职位,并写入excel

#! -*-coding:utf-8 -*-from urllib import request, parsefrom bs4 import BeautifulSoupimport datetimeimport xlwtstarttime = datetime.datetime.now()url = r'https://www.zhipin.com/job_detail/?scity=101210...

weixin_39637589的博客 327
上一篇: python爬取五百丁word模板(有图+有代码)
下一篇: 分析137份大数据简历-统计技术名词词频
billycoder
博客等级 码龄17年 171粉丝 188原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值