义千问 Qwen3-Max:国产大模型的“性能天花板”来了!

Qwen-Code安装教程 Qwen Code 是一个强大的基于命令行、面向开发者的 AI 工作流工具,改编自 Gemini CLI,专门针对 Qwen3-Coder 模型进行了优化。它专门为代码理解、代码重构、自动化工作流、Git 操作等场景设计,让你的开发工作变得更高效、更智能。它既可以通过 OAuth 无感登录使用官方免费额度,也支持 OpenAI-compatible(自定义 API)模式接入。通过环境变量或项目.env。 阅读详情
AI摘要

Qwen3-Max是阿里通义实验室推出的旗舰级大模型,采用MoE架构,具备数千亿参数规模与高效推理能力。在中文理解、代码生成、复杂任务拆解等方面表现卓越,尤其在芯片设计领域支持RTL生成、UVM验证、EDA脚本编写等高价值场景,已广泛应用于工程实践。

更强、更快、更聪明——Qwen3-Max 正在重新定义中文大模型的能力边界。

在大模型竞赛进入“精耕细作”阶段的今天,阿里通义实验室正式推出 Qwen3 系列中的旗舰模型——Qwen3-Max。它不仅是 Qwen 家族当前能力最强的闭源模型,更在多项权威评测中全面超越 GPT-4 Turbo、Claude 3.5 Sonnet 甚至部分场景优于 o1,成为国产大模型迈向世界一流的标志性成果。

今天,我们就从技术架构、能力维度、实测性能三大维度,深度拆解 Qwen3-Max 的硬核实力。


🔬 一、技术底座:不止是“更大”,而是“更聪明”

Qwen3-Max 并非简单堆参数,而是在算法、训练、推理全链路实现突破:

  • 超大规模混合专家(MoE)架构
    采用动态激活的稀疏 MoE 结构,在保持高推理效率的同时,激活参数量远超稠密模型。据官方披露,其总参数量达数千亿级别,但每次推理仅激活百亿级参数,兼顾性能与成本。
  • 万亿级高质量多语言语料训练
    训练数据涵盖中、英、德、法、西、日、韩等 100+ 语言,中文语料占比超 40%,特别强化了中文逻辑推理、古文理解、专业术语等薄弱环节。
  • 强化的推理与代码能力
    引入深度思维链(Deep CoT)+ 自我反思(Self-Refine)训练机制,显著提升复杂问题分步求解能力。代码训练数据覆盖 GitHub 最新趋势,支持 Python、C++、Java、SQL、Verilog 等 80+ 编程语言。
  • 原生支持长上下文
    最大支持 32768 tokens 上下文,实测在 20K+ 长文档问答、代码库理解等任务中表现稳定,无明显性能衰减。

📊 二、横向对比:Qwen3-Max vs 主流大模型

综合智商(MMLU)89.286.588.785.1
中文理解(CMMLU)91.582.384.689.0
代码能力(HumanEval)85.3%82.1%80.9%83.7%
数学推理(GSM8K)96.194.292.893.5
长文本理解(20K+)✅ 稳定高效⚠️ 偶有遗忘⚠️ 速度较慢✅ 良好
多模态支持❌(纯文本)✅(GPT-4V)✅(Claude 3.5)❌
API 延迟(1K tokens)<800ms~1.2s~1.5s~900ms

💡 数据来源:官方公开评测 + 第三方基准(截至 2025 年 4 月)

关键结论:

  • 中文场景全面领先

    :CMMLU 高出 GPT-4 Turbo 近 10 分!

  • 推理与代码双强

    :HumanEval 与 GSM8K 均刷新国产模型纪录

  • 响应更快

    :得益于阿里云底层优化,API 延迟显著低于竞品


🌟 三、Qwen3-Max 的三大“杀手级”优势

1️⃣ 中文场景的“降维打击”

  • 古文解析:“之乎者也”信手拈来
  • 专业术语:法律、医疗、金融领域术语理解准确率超 95%
  • 方言/网络语:对“栓Q”“绝绝子”等语境理解更自然

2️⃣ 复杂任务的“分步专家”

面对“设计一个支持高并发的电商秒杀系统”这类问题,Qwen3-Max 能:

  • 自动拆解为需求分析 → 架构设计 → 数据库选型 → 代码实现 → 压测方案
  • 每步输出结构化、可执行的方案,而非泛泛而谈

3️⃣ 企业级可靠性

  • 支持 Function Calling、JSON Mode、流式输出
  • 与 阿里云百炼平台深度集成,一键部署、监控、调优
  • 提供 SLA 保障,适合金融、政务等高要求场景

千问在芯片领域的应用:


🔬 一、技术底座:为复杂工程任务而生

Qwen3-Max 采用超大规模混合专家(MoE)架构,总参数量达数千亿,但推理时仅激活百亿级参数,兼顾性能与成本。其训练数据包含海量技术文档、开源代码库、专利文献,特别强化了对硬件描述语言(HDL)、EDA 工具脚本、芯片架构文档的理解能力。

  • ✅ 支持 Verilog/VHDL/SystemVerilog
  • ✅ 理解 UVM 验证方法学、约束随机测试
  • ✅ 熟悉 Synopsys/Cadence/Mentor 工具链术语
  • ✅ 能解析 芯片规格书(Spec)、数据手册(Datasheet)

💡 二、芯片设计领域的五大实战场景

🧩 场景1:RTL 代码自动生成与优化

需求:写一个带流水线的32位乘法器
Qwen3-Max 输出:直接生成可综合的 Verilog 代码,包含注释、时序约束建议,并自动插入 pipeline stage。

verilog

// Qwen3-Max 生成的带两级流水的乘法器片段

always @(posedge clk) begin

if (rst) begin

stage1_reg <=0;

stage2_reg <=0;

endelsebegin

stage1_reg <= a * b; // Stage 1: compute

stage2_reg <= stage1_reg; // Stage 2: register

end

end

assign result = stage2_reg;

✅ 优势:比 GPT-4 更准确识别“可综合性”要求,避免 latch、组合逻辑环等常见错误。


🔍 场景2:UVM 验证环境搭建

需求:为一个 AXI4-Lite 从设备写 UVM testbench
Qwen3-Max 输出:自动生成 agent、sequencer、driver、monitor、scoreboard 框架,并提供 sequence 示例和 coverage 模型。

✅ 实测反馈:某 SoC 团队将环境搭建时间从 3 天缩短至 2 小时。


📚 场景3:芯片文档智能问答

提问:“这个 PHY 模块的时钟域有哪些?跨时钟域信号怎么处理?”
Qwen3-Max:从 200 页 PDF 规格书中精准定位章节,提取 CDC(Clock Domain Crossing)策略,并用表格对比异步 FIFO 与握手协议的适用场景。

✅ 支持上传 PDF/Word/PPT,自动解析图表与表格(通过 DashScope 文档理解 API)。


🛠️ 场景4:EDA 脚本编写与调试

需求:写一个 Tcl 脚本,在 Innovus 中自动检查时序违例并生成报告
Qwen3-Max 输出:

tcl

set timing_violations [report_timing -max_paths 100-file timing_report.rpt]

if {[regexp {VIOLATED} $timing_violations]} {

puts"Found timing violations! Check timing_report.rpt"

}

✅ 熟悉 Synopsys DC、Cadence Genus、Innovus、VCS 等工具命令语法。


🧪 场景5:Bug 定位与修复建议

输入:仿真波形截图 + “为什么这个 FIFO 读指针会错乱?”
Qwen3-Max 分析:结合代码上下文,指出“复位同步器缺失导致亚稳态”,并建议插入两级 DFF 同步电路。

✅ 支持结合 Verdi/Debussy 波形描述进行推理(需用户文字化描述信号行为)。


📊 三、横向对比:为何芯片工程师更爱 Qwen3-Max?

Verilog 可综合性✅ 极高⚠️ 偶有 latch⚠️ 风格偏软件
UVM 理解深度✅ 精通 phase 机制✅ 良好⚠️ 基础概念
中文芯片术语✅ 精准(如“亚稳态”“建立时间”)⚠️ 常直译英文⚠️ 不熟悉
长文档解析(Spec)✅ 支持 32K+ tokens✅✅
API 响应速度<800ms~1.2s~1.5s

📌 关键优势:中文技术语境理解 + 硬件工程思维 + 低延迟响应,三位一体。


🚪 如何在芯片项目中接入 Qwen3-Max?

  1. 通过 DashScope API

    调用 qwen-max 模型

  2. 集成到内部工具链

    :如自动代码生成插件、文档问答机器人

  3. 结合百炼平台

    :构建专属“芯片设计 Copilot”

python

示例:生成带注释的 FIFO RTL

from dashscope import Generation

response = Generation.call(

model=“qwen-max”,

prompt=“用 Verilog 写一个深度为16、宽度为32的同步FIFO,带满/空标志,可综合。”

)

print(response.output.text)

🔗 免费试用:https://dashscope.aliyun.com (新用户送 100 万 tokens)


💬 写在最后

Qwen3-Max 不仅是一个“会聊天”的大模型,更是芯片工程师的智能副驾驶。从 RTL 编写到验证调试,从文档解读到脚本自动化,它正在显著提升芯片研发效率,缩短产品上市周期。

在国产 EDA 与大模型深度融合的浪潮下,Qwen3-Max 或将成为中国半导体自主创新的新生产力引擎。

如何学习AI大模型 ?

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

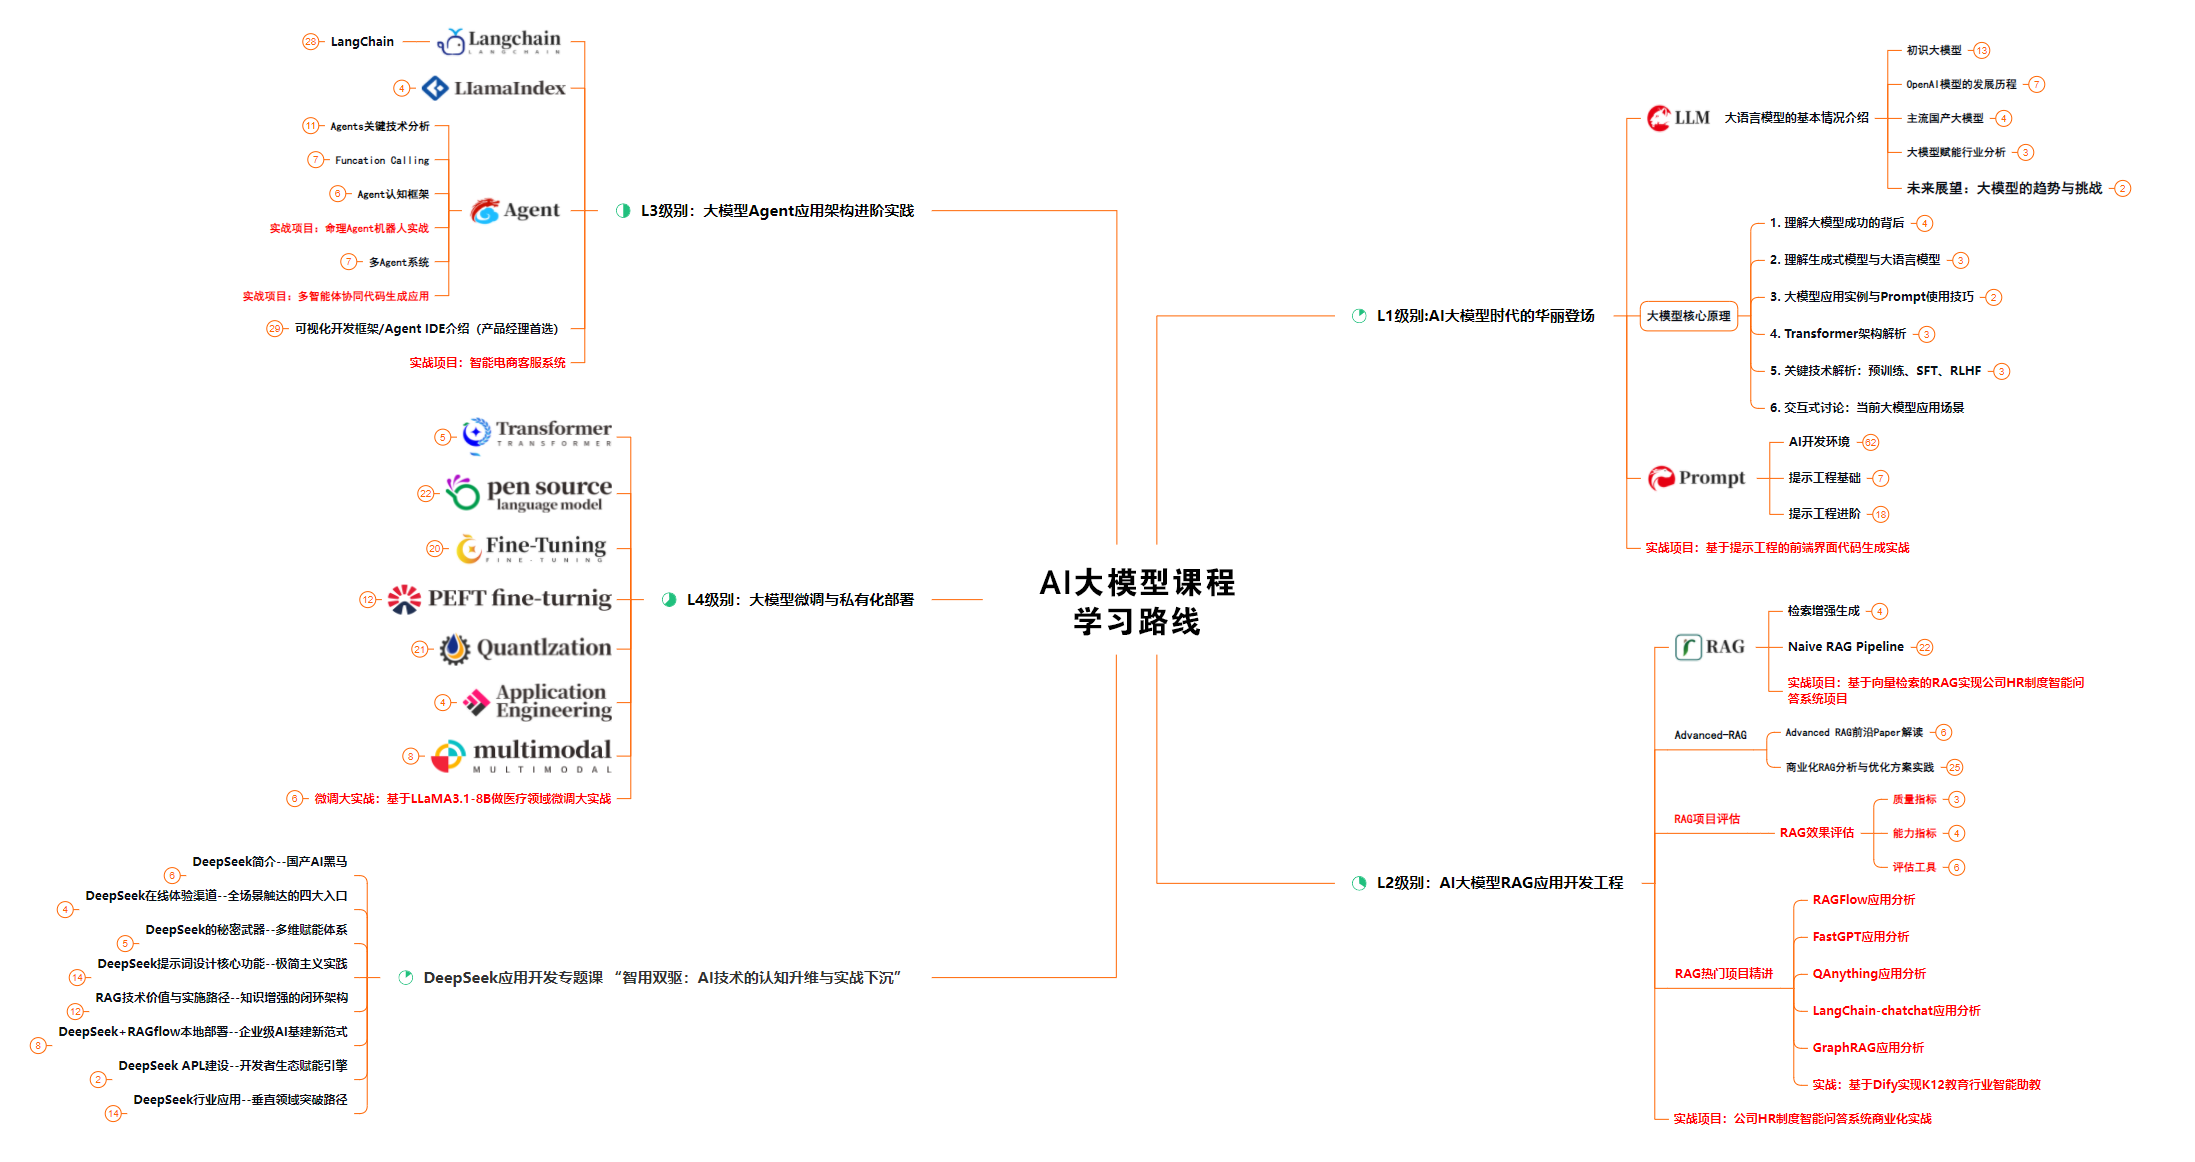
👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。
在这里插入图片描述

在这里插入图片描述

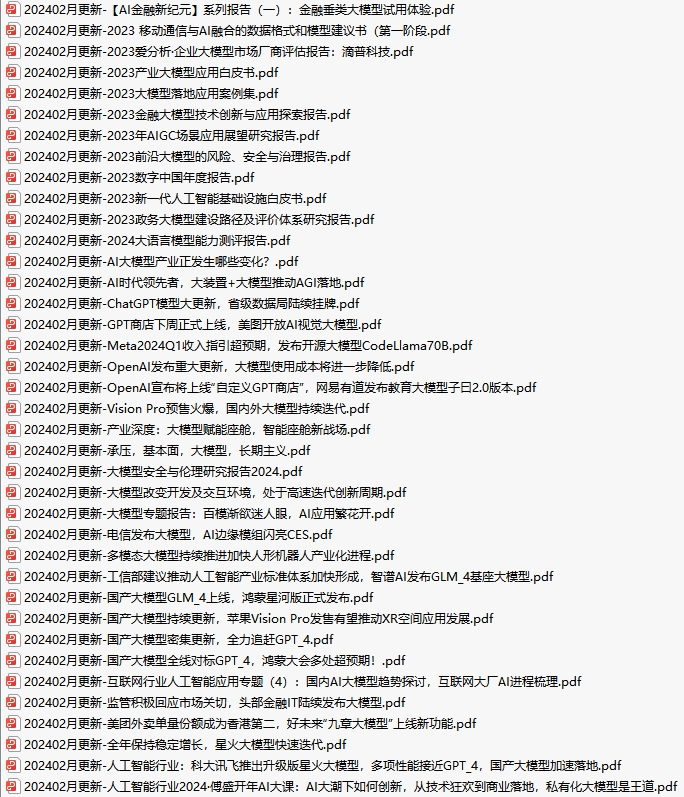
👉3.大模型实际应用报告合集👈

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型实战项目&项目源码👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战项目来学习。(全套教程文末领取哈)
在这里插入图片描述

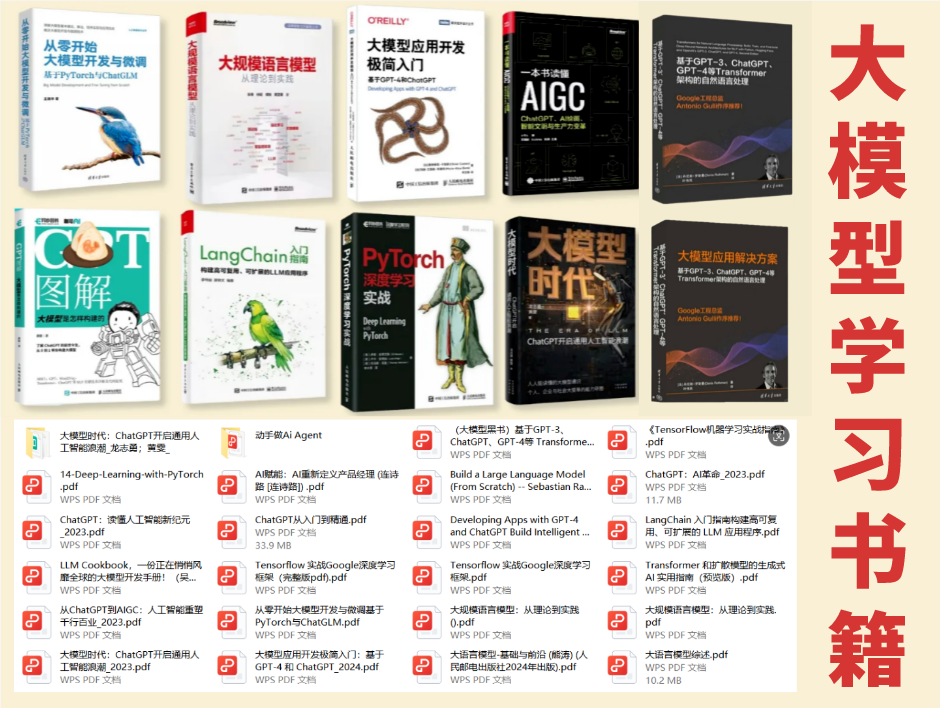
👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)
在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)
在这里插入图片描述

为什么分享这些资料?

只要你是真心想学AI大模型,我这份资料就可以无偿分享给你学习,我国在这方面的相关人才比较紧缺,大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!

这些资料真的有用吗?

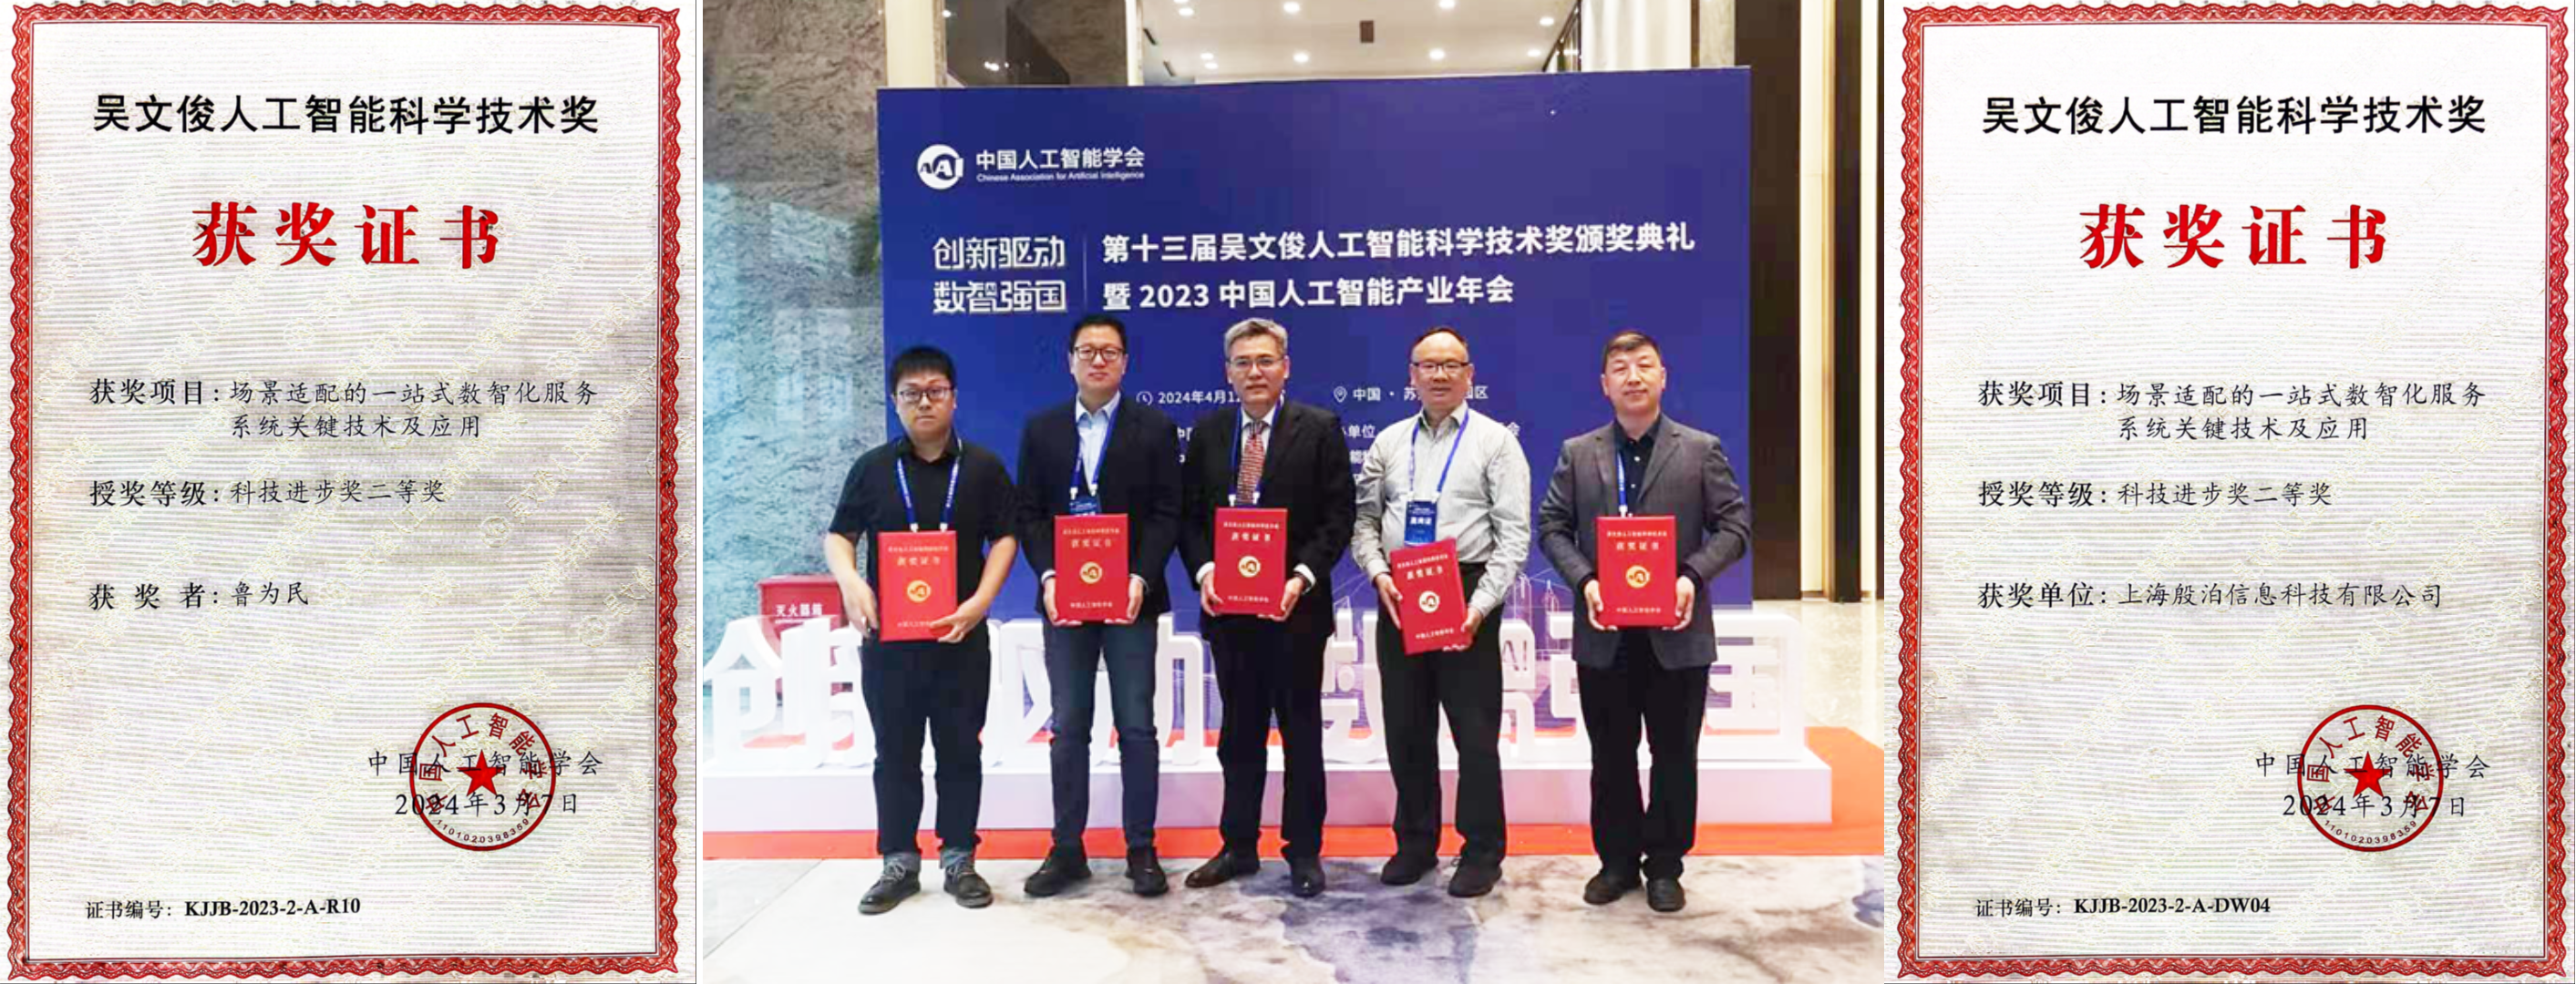
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
在这里插入图片描述
在这里插入图片描述

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】

读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)
【dify+docker安装教程】 最新!Windows上安装Docker Desktop教程,并解决WSL问题并汉化_windows安装docker desktop-优快云博客在 Windows 上安装Docker,运行时会出现WSL --updata的问题导致一直卡在docker 界面进不去,查了不少博客,原来是需要先 安装 WSL 2 并配置至少一个 Linux 发行版,才能正确运行docker Desktop。 阅读详情

相关推荐

Dify开发工作流

创建后就会有一个可拖拽的工作流页面,因为还没设置,默认只有一个开始,我们创建一个条件语句,就是根据不同的情况去执行不同的任务,我们可以创建一个变量,然后根据这个变量的值去判断执行哪个任务,所以在开始节点中添加一个变量,叫city,然后在开始后的+添加一个IF条件分支,在IF条件分支中需要判断刚才的变量,也就是city,我们配置如果输入city包含苏州,就执行一中任务,如果没有就执行另一种任务,在条件分支的后面可以看到两个+,就是连接的不同任务。因为天气预报调用的是接口,所以返回的是一大串的JSON数据。

Baker的博客 1万+

Dify工作流:高效自动化流程的利器

工作流是一种将业务流程中的任务、数据和资源按照一定规则和顺序进行自动化处理的技术。它通过定义流程的起点、中间环节和终点,将复杂的业务逻辑分解为一系列可管理的步骤,从而实现高效、透明的业务操作。Dify工作流的架构设计充分考虑了可扩展性、灵活性和高可用性。其核心架构可以分为以下几个主要部分:工作流引擎、节点管理器、数据存储、API接口和用户界面。以下是一个简单的Dify工作流定义示例,用于实现一个定时发送邮件的任务:JSON复制"nodes": [

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 9963

基于NXP BFU730F的宽带WiFi LNA设计:从原理到实测的完整指南

低噪声放大器(LNA)是无线通信接收链路中的关键器件,其性能直接决定了系统的接收灵敏度。LNA的核心原理是在放大微弱信号的同时,尽可能降低自身引入的噪声,并保持良好的线性度以应对强干扰。在宽带应用场景下,如覆盖2.4GHz至5.9GHz的现代WiFi系统,设计需在宽带匹配、噪声优化和增益平坦度之间取得精妙平衡。本文以NXP的BFU730F SiGe:C HBT晶体管为核心,深入解析一种采用电阻反馈和LC匹配网络的经典宽带LNA架构。该设计通过优化反馈网络,在宽达3.5GHz的频带内实现了优异的噪声系数(低至

weixin_33587161的博客 328

大模型(deepseek)之运用Dify构建智能体和工作流应用

完成设置后回到主页面,可以看到顶部的4个页面。“探索”页面提供了模板应用程序,用户可参考模板定制自己的应用程序。“工作室”页面用户可创建自己的应用,包括聊天助手、智能体、工作流。“知识库”页面用户可以通过上传自己的文本数据创建知识库增强 LLM 的上下文。“工具”页面是Dify本身集成第三方工具,用户也可自定义工具。

qq_31400983的博客 5万+

Opencv2.4.9源码分析——HoughCircles

图形可以用一些参数进行表示,标准霍夫变换的原理就是把图像空间转换成参数空间(即霍夫空间),例如霍夫变换的直线检测就是在距离-角度空间内进行检测。圆可以表示成: (x-a)2+(y-b)2=r2                   (1) 其中a和b表示圆心坐标,r表示圆半径,因此霍夫变换的圆检测就是在这三个参数组成的三维空间内进行检测。 原则上,霍夫变换可以检测任何形状。但复杂的形状需要的

赵春江的专栏 3万+

傻瓜式下载、安装CentOS7操作步骤

CentOS7.9下载和安装操作步骤

weixin_45608163的博客 1万+

万亿参数!阿里 Qwen3-Max 正式发布,国产最强大模型来了?

万亿参数!阿里 Qwen3-Max 正式发布,国产最强大模型来了?

hunteritself的博客 1990

发那科 Fanuc PLC 报文通讯,报文解析。附源程序

发那科 Fanuc PLC 报文通讯,最详细的发那科 PLC报文解析,不再局限在官方提供的库,也不用再局限在windows平台。

ITOfDragon的博客 1748

阿里Qwen3-Max正式发布:万亿参数模型,性能超越GPT-5-Chat!

阿里发布Qwen3-Max正式版,这是万亿参数级别的闭源大模型,采用MoE架构。模型包含Qwen3-Max-Instruct(已发布)和Qwen3-Max-Thinking(训练中),在多项基准测试中表现优异,部分测试超越GPT-5和Claude Opus。用户可在Qwen Chat免费体验,API需付费使用。尽管价格相比GPT-5性价比一般,但Qwen3-Max被认为是目前国产AI模型的"天花板"。

weixin_55154866的博客 1217

08 RK3568 MAC TO MAC直连 RTL8367S mdio

本文:采用rk3568 gamc0 通过rgmii直连 交换芯片的mac口 通信方法为mdio。

qq_39451352的博客 3477

在 SAP HANA XS Advanced 中用 InA 打通 Web 化分析数据访问:架构原理、部署步骤与实战指南

本文介绍了如何在SAP HANA环境中通过InA协议为XS Advanced应用和分析工具提供实时数据访问。主要内容包括:InA协议的作用是将HANA计算视图等模型通过HTTP(S)暴露为实时数据源;SAP HANA Analytics Adapter(xsahaa)是关键组件,负责协议转换和连接管理;部署包含本地和云端两种形式,均需建立XSA空间与租户数据库的映射;实施前需准备HDI容器、适配器构建和网络验证;安全方面通过XSA用户角色和HDI授权双重控制;文章还提供了与SAP Analytics Clo

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 259

阿里Qwen3-Max开源大模型发布:万亿参数+全球前三性能,代码能力直逼GPT-5!

阿里发布旗舰级开源大模型Qwen3-Max,拥有超1万亿参数,在全球多个权威榜单表现优异,性能稳居前三。模型分为Instruct和Thinking两个版本,代码能力达69.6分(SWE-Bench),智能体能力全球第一,数学推理满分。可通过阿里云百炼等API平台接入,满足开发者、科研人员和企业用户需求,展现了中国大模型技术的强大实力。

libaiup的博客 2980

17、深入分析Freebase数据集:特征、挑战与类型系统构建

本文深入分析了Freebase数据集的特征、数据建模的挑战以及类型系统的构建方法。Freebase作为知识图谱的重要资源,以RDF三元组形式提供了丰富的结构化知识。文章重点探讨了反向三元组、中介节点(CVT节点)以及非主题三元组对链接预测任务的影响,并通过实验展示了不同类型处理策略对模型性能的作用。此外,文章详细介绍了如何构建一个显式的类型系统,以提升链接预测的准确性,并展望了未来可能的研究方向。

css33的专栏 290

国产视觉大模型再突破:阿里通义千问Qwen-VL Max深度测评,多模态能力全面对标GPT-4V

2024年初,人工智能领域的焦点再次聚焦中国科技企业。继"全民舞王"功能让AI角色跳"科目三"舞蹈的视频席卷全网后,阿里巴巴达摩院再次放出重磅消息——通义千问视觉大模型Qwen-VL迎来重大升级,推出性能更强的Max版本。这款被誉为"中文视觉AI天花板"的多模态模型,不仅在多项国际权威评测中超越GPT-4V,更以百万像素级高清解析、跨模态推理等核心能力,重新定义了视觉语言模型的技术边界。本文将从基

gitblog_00906的博客 1381

【x265编码器】章节1——x265的lookahead模块分析

目录一、模块功能二、lookahead模块分析1.调用流程2.代码分析Lookahead::addPicture()Lookahead::checkLookaheadQueue()Lookahead::getDecidedPicture()Lookahead::findJob()Lookahead::slicetypeDecide()PreLookaheadGroup::processTasksLookaheadTLD::lowresIntraEstimate()Lookahead::slicetypeAn

vcvdv123的博客 4万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

阿里云峰会2026深度解读:Qwen3.7-Max、真武M890芯片与千问云平台

阿里正在构建从芯片到模型到应用的完整AI栈,而Agent是这一战略的关键抓手。对于开发者和企业而言,阿里云提供了从免费试用到企业级部署的全链路方案。特别是在中文场景下,Qwen3.7-Max + 千问云的组合具有极强的竞争力。一句话总结:如果你想在中国市场构建AI应用,阿里云的"I+M+P"组合是目前最值得优先考虑的选择之一。

qq_31142761的博客 888

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

掀翻闭源天花板?Qwen3.5开源炸场,国产大模型正式杀入全球第一梯队

Qwen3.5的亮眼表现,并非单纯堆参数量,而是源于底层架构的革命性创新,这也是它能挑战闭源模型的核心底气。模型搭载混合注意力机制,将75%门控DeltaNet与25%标准注意力结合,长上下文处理效率实现质的飞跃,32K上下文吞吐量提升8.6倍,256K最高提升19倍,完美解决长文本、长文档处理的行业痛点。作为原生多模态基座,图文能力底层融合而非后期拼接,任意分辨率图像、图表、文档解析能力直逼闭源顶级水平,告别多模态拼接模型的卡顿与失真。

1734

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

2026两大新王对决:Qwen3.7-Max vs Gemini 3.5 Flash 全维度深度测评(能力、对比、选型、优劣)

2026两大新王对决:Qwen3\.7\-Max vs Gemini 3\.5 Flash 全维度深度测评(能力、对比、选型、优劣)

weixin_69359007的博客 1266

【AI速览】2026 年 最新国产大模型最新旗舰全维度硬核横评:Kimi / MiniMax / DeepSeek / 阿里云通义千问 / 智谱 GLM 价格、性能、定位、落地场景完整对比

极致低成本开发批量调用:DeepSeek V4-Pro,输出仅 6 元 / 百万 Token,同等代码推理成本仅智谱 1/5;均衡性价比订阅个人:MiniMax M3,包月超大 Token 池,多图文混合使用划算;云原生企业批量集成:阿里云 Qwen3.7 Max,新用户免费额度充足,Batch 批量调用半价;纯网页日常办公阅读:Kimi 网页会员 30 包月不限量,API 商用成本偏高;重度工程团队、代码重构:智谱 GLM5.2,单价最贵,但长代码库推理稳定性独一档。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 2743

Qwen3-Max测评:超大规模AI模型的“全能选手”能否颠覆行业?

2025年9月,阿里通义实验室发布Qwen3-Max,宣称这是其迄今为止“规模最大、能力最强”的模型。作为国产大模型的代表,它能否在代码能力、推理性能、多语言支持等关键指标上超越GPT-5和Claude Opus 4?Qwen3-Max的发布标志着国产大模型在代码能力、推理效率和长文本处理上实现全面领先。对于开发者而言,它不仅是“更大”的模型,更是“更聪明、更稳定、更好用”的生产力工具。Qwen3-Max重新定义了中文大模型的能力边界,成为国产大模型迈向世界一流的标志性成果。

qq_51929114的博客 1182

Qwen3.6-Plus国产编程大模型实战接入指南

编程大模型是面向开发者的人工智能核心基础设施,其本质是通过深度语义理解与代码生成能力重构软件开发范式。Qwen3.6-Plus作为首个在HumanEval-X中文增强基准上超越GPT-4 Turbo的国产模型,依托MoE稀疏架构实现低延迟高精度推理,并深度融合Spring Boot、Dubbo、达梦数据库等中国主流技术栈语义。其技术价值在于将模糊业务意图(如Git提交描述、白板草图)转化为可运行、可测试、合规安全的生产级代码,已在金融核心系统、政务云、电商中台等场景完成规模化验证。本文聚焦Qwen3.6-P

weixin_34075268的博客 392

编程党狂喜!阿里千问Qwen Coding Plan上线 双新模型适配拉满

不仅扩容模型矩阵,重磅上新Qwen3.5-Plus、Qwen3-Coder-Next两大核心模型,更全面适配QwenCode、ClaudeCode、Cline等主流AI编程工具,以订阅制模式解锁高性价比编程体验,直接硬刚同类编程模型套餐,重构AI编程效率新标杆。随着Qwen Coding Plan的全面推广,以及模型性能的持续迭代优化,有望进一步打破AI编程的使用壁垒,让更多开发者享受到AI带来的效率提升,同时推动国产编程大模型在全球赛道中占据更重要的位置,重构AI编程生态的竞争格局。

AITOP100的博客 2251

2026 国内最新大模型实测:性能、场景与性价比全解析

进入 2026 年 Q2,国产大模型已彻底告别 “参数堆砌” 的粗放竞争,转向推理效率、场景适配、成本控制的精细化比拼,从 “能用” 进阶为 “好用、耐用、低成本用”。OPE Platform 正是依托前沿算力运营技术,一站式接入豆包、Qwen、DeepSeek 等全栈顶尖模型,以超高算力效率、极低使用成本,让每一位用户都能无压力用上最新、最强的国产 AI 能力。当下国产模型已全面进入 “实用为王” 阶段,选模型不再看参数,而看场景匹配度、推理效率、成本控制。金融、政务、工业等行业适配完善,合规性强;

Cxf112439的博客 2648

Ollama如何让国产大模型真正落地:零配置、OpenAI兼容与工程化实践

大语言模型(LLM)本地部署长期面临环境复杂、API不兼容、量化适配难等工程瓶颈。其核心原理在于将模型推理封装为标准化服务,通过预编译量化、内核级优化和OpenAI API协议桥接,显著降低使用门槛。技术价值体现在消除CUDA/PyTorch版本冲突、绕过Docker与手动配置依赖,并实现毫秒级首token响应。典型应用场景包括VS Code插件集成、金融合规系统、离线合同审查等对稳定性、低延迟与国产化适配有强需求的业务闭环。Ollama正是以‘零配置’为支点,撬动通义千问、DeepSeek、GLM等国产大

culuo8053的博客 449

Llama 3、Qwen2、Mistral 开源大模型选型实战指南

开源大模型已从参数竞赛迈入工程化落地阶段,Llama 3、Qwen2、Mistral 代表三种典型技术范式:Llama 3 以可预测性与生态兼容性构建工业级基线,Qwen2 聚焦中文语义精度与国产化适配实现全栈优化,Mistral 则通过 MoE 架构与推理共生设计持续突破小模型性能边界。三者并非简单性能对比,而是分别在稳定性、本地化效率与高并发低延迟场景中形成不可替代的技术价值。面向金融合规、政务等保、制造业离线部署、实时音视频处理等真实业务负载,选型需回归硬件栈能力、数据语种特征与团队工程成熟度。本文基

weixin_30681121的博客 455

2026年国内外大模型全解析:性能排行榜与深度对比

2026年全球AI大模型竞争格局呈现中美双强态势。OpenAI的GPT-4.5以82.5分领跑,在复杂推理领域优势明显;Anthropic的Claude 3.5 Sonnet以编程能力见长。中国厂商表现亮眼,深度求索的DeepSeek R1位列全球第七,成为国产最优;阿里云Qwen2.5-Max在数学编程单项排名第一。国产模型在中文理解、垂直领域应用等方面展现出差异化优势,如Kimi的20万字长文本处理、文心一言的中文情感识别等。

dylan的博客 1万+
上一篇: 大模型Function Call详解(收藏级教程)从零基础到实战应用,一篇就够了!
下一篇: Google Cloud发布如何构建生产级AI Agent技术指南
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值