一文揭秘!Transformer的多头自注意力机制详解

学习Transformer:自注意力与多头自注意力的原理及实现 自从Transformer[3]模型在NLP领域问世后,基于Transformer的深度学习模型性能逐渐在NLP和CV领域(Vision Transformer)取得了令人惊叹的提升。本文的主要目的是介绍经典Transformer模型和Vision Transformer的技术细节及基本原理,以方便读者在CV领域了解和使用Vision Transformer。...... 阅读详情
AI摘要

本文拆解了多头注意力机制,它是Transformer模型核心组件,能让模型关注序列不同部分,捕捉复杂关系,增强对序列数据的理解。还介绍了其在Transformer和GPT模型中的应用,对比了自注意力机制。此外,提供了AI大模型学习资料免费领取福利。

导读

昨天,我们介绍了自注意力机制,今天就来拆解下多头注意力机制,并看看它和自注意力机制有什么区别和优势?

多头自注意力机制(Multi-Head Self-Attention)是Transformer模型中的一个核心组件,它使得模型能够在处理序列数据时,同时关注序列的不同部分,从而捕捉序列内部的复杂关系。
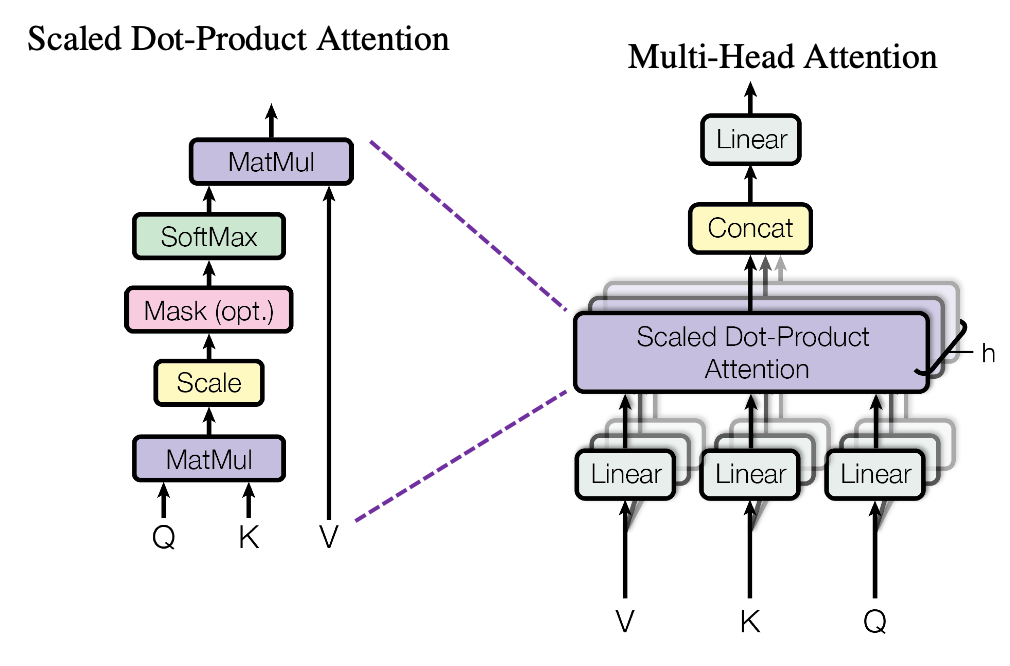
想象一下,你正在阅读一本书,你的大脑能够同时关注多个角色之间的对话、情感变化以及故事情节的发展。多头自注意力机制就像是这种能力在人工智能中的体现,它让模型能够同时“关注”输入序列中的多个位置,理解它们之间的相互关系。

具体来说,多头自注意力机制将输入序列映射到多个不同的表示空间中,然后分别计算这些表示之间的注意力权重。这样做的好处是,模型可以学习到序列中不同子空间下的信息,比如一个头可能专注于捕捉局部的语法结构,而另一个头可能专注于理解更广泛的语义信息。

通过这种方式,多头自注意力机制增强了模型对序列数据的理解能力,使其能够更好地处理自然语言处理(NLP)任务,如机器翻译、文本摘要和问答系统等。这种机制的核心优势在于其能够捕捉长距离依赖关系,即序列中相隔较远的元素之间的关系,这对于理解语言的复杂性至关重要。

总结来说,多头自注意力机制通过将注意力分配到序列的不同部分,使得模型能够更全面地理解输入数据,这是Transformer模型在处理序列任务时取得显著效果的关键因素之一。

多头注意力的计算可以表示为:
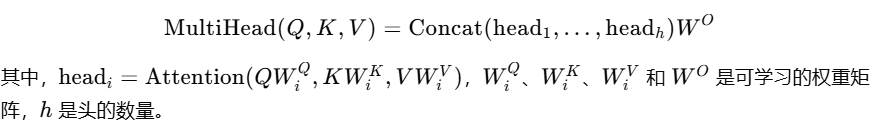
多头注意力机制原理
1.1 输入变换与线性投影

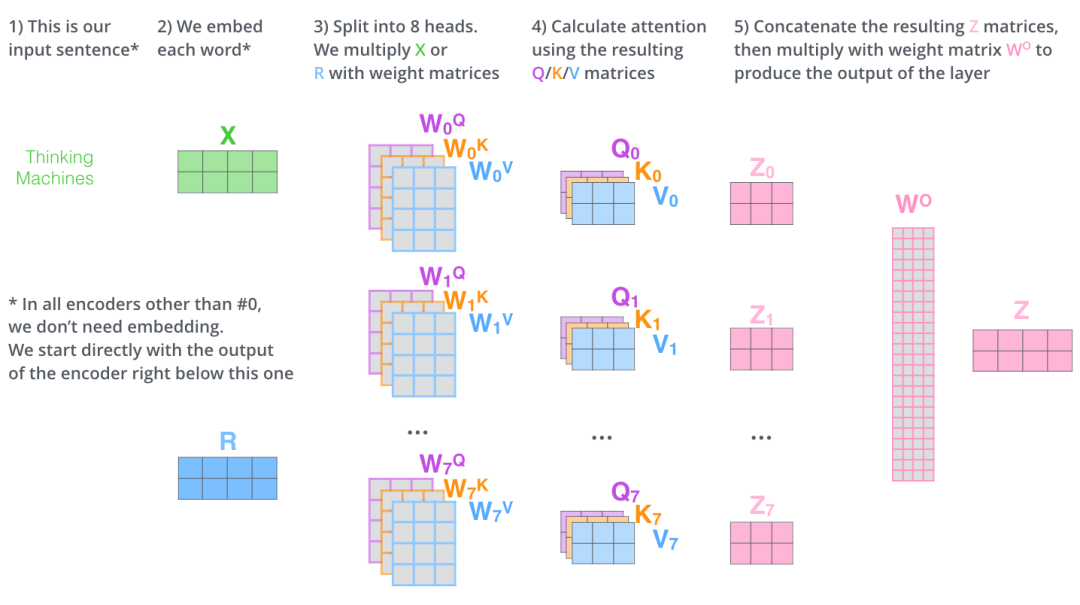
多头注意力机制的输入变换与线性投影是其核心步骤之一。给定输入序列,首先通过三个不同的线性变换层生成查询(Query)、键(Key)和值(Value)矩阵。这些变换通常是通过全连接层实现的,其目的是将输入数据映射到不同的表示子空间中,为后续的注意力计算提供基础。

**

  • 查询(Q)、键(K)和值(V)的生成

**

输入序列首先被映射到查询、键和值矩阵。这一步骤通过与权重矩阵WQ、WK和WV的矩阵乘法实现,其中每个矩阵都是模型中的可学习参数。数学上,这可以表示为:
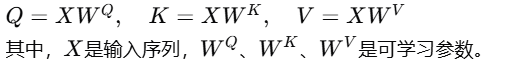
  • 线性投影的作用:线性投影不仅帮助模型将输入数据映射到不同的表示空间,而且还允许模型学习如何根据当前任务的需要动态地聚焦于输入数据的不同部分。这种动态聚焦是通过计算输入数据的加权表示来实现的,权重由模型学习得到。

1.2 分头计算与并行处理

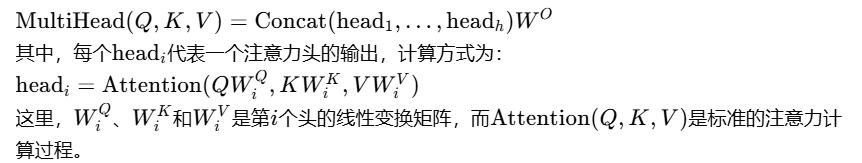
多头注意力机制将查询、键和值矩阵分成多个头(即多个子空间),每个头具有不同的线性变换参数。每个头独立地计算注意力得分,并生成一个注意力加权后的输出。这些输出随后被合并,形成一个最终的、更复杂的表示。

  • 分头计算:在多头注意力中,查询、键和值的线性变换实际上会进行多次,每个头都有自己的权重矩阵。这样,输入向量被分割到多个不同的子空间中,每个子空间执行自注意力操作。公式上表现为:
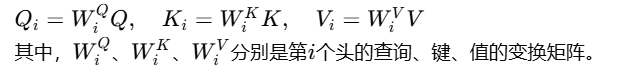
  • 并行处理:由于每个头的计算是独立的,这些计算可以并行进行,从而提高模型的计算效率。这种并行性使得多头注意力机制在处理长序列数据时更加高效。

1.3 注意力权重计算

在多头注意力机制中,每个头的注意力权重计算是通过缩放点积注意力(Scaled Dot-Product Attention)实现的。具体来说,计算查询和键的点积,经过缩放、加上偏置后,使用softmax函数得到注意力权重。

  • 缩放点积注意力:为了避免过大的点积导致梯度消失问题,通常会对点积结果进行缩放。缩放因子通常是键向量维度的倒数或平方根:
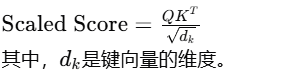
**

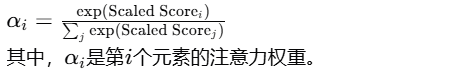
  • 归一化注意力权重:使用softmax函数对缩放后的得分进行归一化,得到每个元素的注意力权重,这些权重之和为1:

**
1.4 拼接与融合

多头注意力机制的最后步骤是将所有头的输出拼接在一起,然后通过一个最终的线性变换,以整合来自不同头的信息,得到最终的多头注意力输出。

  • 拼接:将所有头的输出拼接在一起,形成一个长向量。这一步骤整合了不同子空间学到的信息,增强模型的表达能力。

  • 融合:对拼接后的向量进行一个最终的线性变换,以整合来自不同头的信息,得到最终的多头注意力输出。这一步骤对应着:
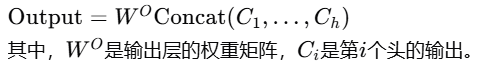
通过这种方式,线性投影在注意力机制中发挥着至关重要的作用,它们不仅帮助模型将输入数据映射到不同的表示空间,而且还允许模型学习如何根据当前任务的需要动态地聚焦于输入数据的不同部分。

多头注意力机制的应用

2.1 Transformer模型中的多头注意力

Transformer模型是多头注意力机制应用的典型代表,其核心架构中编码器(Encoder)和解码器(Decoder)都广泛使用了这一机制。

  • 编码器中的多头自注意力:在Transformer的每个编码器层中,多头自注意力机制允许模型在处理输入序列时,同时考虑序列内所有位置的信息。这种机制使得模型能够有效捕捉序列内部的长距离依赖关系,增强了对输入数据的理解。具体来说,编码器中的多头自注意力通过以下步骤实现:
**

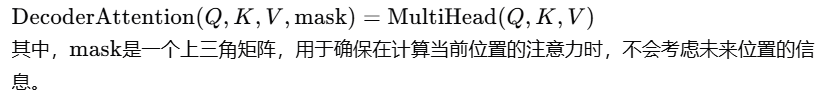
  • 解码器中的多头自注意力:与编码器类似,解码器中的多头自注意力机制也允许模型在处理目标序列时,同时考虑序列内所有位置的信息。不同的是,解码器还需要考虑防止未来信息的泄露,即所谓的“掩码”机制。解码器的自注意力计算过程如下:

**
2.2 GPT模型中的多头注意力

GPT(Generative Pre-trained Transformer)模型是另一类广泛应用多头注意力机制的模型,尤其在自然语言生成任务中表现出色。

  • GPT模型结构:GPT模型基于Transformer的解码器结构,使用了多层的多头自注意力机制。每个GPT版本(如GPT-1、GPT-2、GPT-3)都采用了不同数量的层和不同规模的模型参数,但核心的多头自注意力机制保持不变。GPT模型通过预训练大量文本数据,学习到了丰富的语言表示,能够生成连贯、合理的文本序列。

  • 多头自注意力的应用:在GPT模型中,多头自注意力机制使得模型能够捕捉到不同位置之间的依赖关系,这对于生成连贯文本至关重要。例如,在生成一个句子时,模型需要同时考虑到句子的开头和结尾,以确保生成的文本在语义上是连贯的。GPT模型通过以下方式实现这一点:GPTOutput=TransformerDecoder(Input,mask)其中,TransformerDecoder表示基于Transformer解码器的自注意力机制,maskmask确保了在生成过程中,模型只能看到当前位置之前的信息。

综上所述,多头注意力机制在Transformer和GPT模型中的应用,不仅增强了模型对序列数据的理解能力,还提高了模型在处理复杂任务时的性能和效果。通过并行处理多个注意力头,模型能够从不同角度捕捉数据的多样性,从而在自然语言处理等领域取得了显著的成果。

秀米兴趣班

自注意力机制(Self-Attention)和多头注意力机制(Multi-Head Attention)都是深度学习中用于处理序列数据的重要技术,它们在Transformer模型中发挥着核心作用。以下是对两者的对比,包括它们的定义、区别以及各自的优势。

自注意力机制(Self-Attention)

优势:

1.全局依赖捕捉: 自注意力机制可以捕捉序列中任意两个元素之间的依赖关系,无论它们之间的距离有多远。

2.并行计算: 自注意力机制的计算可以高度并行化,因为每个序列元素对的注意力计算是独立的,这使得它在GPU上能够高效执行。

3.适用性广: 自注意力机制适用于各种序列任务,如机器翻译、文本摘要、语音识别等。

多头注意力机制(Multi-Head Attention)

优势:

1.多角度特征捕捉: 多头注意力机制通过多个头并行处理,可以从不同的角度捕捉数据的特征,增强了模型对复杂依赖关系的捕捉能力。

2.表达能力提升: 每个头可以学习到不同的表示子空间,这增加了模型的表达能力,允许它学习更复杂的特征组合。

3.泛化能力增强: 多头注意力机制通过分散对单一特征的依赖,提升了模型的稳定性和泛化能力。

区别

1.头的数量: 自注意力机制通常只有一个头,而多头注意力机制包含多个头,每个头学习不同的表示子空间。

2.信息整合: 在多头注意力中,所有头的输出会被拼接在一起,然后通过一个线性层进行整合,以形成最终的输出。自注意力机制则直接输出加权的值向量。

3.计算复杂度: 多头注意力机制由于涉及多个头的计算,其参数量和计算复杂度相对较高,尤其是在资源受限的环境下。

总结来说,自注意力机制提供了一种有效的方式来捕捉序列数据中的长距离依赖关系,而多头注意力机制通过引入多个头进一步提升了模型的表达能力和泛化能力,使得模型能够从多个角度理解和处理复杂的序列数据。两者在不同的应用场景下都有其独特的价值和优势。

如何学习AI大模型 ?

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。

在这里插入图片描述
在这里插入图片描述

👉3.大模型实际应用报告合集👈

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型落地应用案例PPT👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(全套教程文末领取哈)

在这里插入图片描述

👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)

img

在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)

在这里插入图片描述
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习

优快云粉丝独家福利

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】

读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈

(👆👆👆安全链接,放心点击)
【深度学习】多头注意力机制详解 阅读详情

相关推荐

一步一步理解大模型:多头注意力机制的作用

初始权重随机分布,梯度下降优化过程推动每个头去适应其权重,以学习不同的特征,因为这有助于减少总体损失,训练数据本身是可解耦的,那么多头机制就可能碰上,Dropout,超参数,特殊设计。如果所有头都学习了相同的特征,则会冗余且效率低下,模型在其受训任务上的表现会不佳,那么这些训练结果会被放弃,留下的大概率就是学习到了更多特征的模型。:在工业化实用的模型上,对一些已知的、直觉体会到的、猜想到的特征,工程师会设计特殊的网络结构去捕捉,而这些经验性的网络结构有可能各种原因没有发表。所以,调参是非常重要的。

chattyfish的博客 7542

MultiHeadAttention多头注意力机制的原理

MultiHeadAttention多头注意力作为Transformer的核心组件,其主要由多组自注意力组合构成,Attention Is All You Need,self-attention。

tostq的专栏 2万+

从DeepSeek入手,Transformer架构大揭秘!

Transformer 架构的优势那是相当突出,在并行计算方面,它完全不依赖序列顺序,不同位置信息能同时处理,大大缩短了训练时间。就像工厂里多条生产线同时开工,生产效率直线上升。而且它处理长距离依赖关系的能力超强,自注意力机制让模型在计算时,能直接捕捉到序列中任意两个位置的关联,完全不受距离限制,这是传统 RNN 和 LSTM 望尘莫及的。在文本处理里,不管句子多长,它都能精准把握上下文逻辑。

qq_23519469的博客 2145

【Transformer系列(2)】注意力机制、自注意力机制、多头注意力机制、通道注意力机制、空间注意力机制超详细讲解

一文带你读懂注意力机制、自注意力机制、多头注意力机制、通道注意力机制、空间注意力机制,超详细的讲解,小白也能看得懂!

路人贾的博客 17万+

揭秘Transformer Layer与Transformer Block的异同:从理论到实践

本文深入解析了Transformer架构中Transformer Layer与Transformer Block的核心区别。Transformer Block是包含自注意力、前馈网络等操作的微观标准计算单元,而Transformer Layer是由一个或多个Block堆叠而成的宏观功能层。文章通过代码示例和结构图,从理论到实践厘清了二者关系,并提供了在PyTorch等框架中的具体实现指南,帮助读者避免常见混淆。

weixin_29066781的博客 203

揭秘Transformer架构:残差流与隐藏层的关系

残差流和隐藏层不是同一个东西: - 隐藏层是模型的**结构组件**(静态的计算单元); - 残差流是隐藏层之间**动态流动的数据**(被处理的特征张量)。 残差流依赖隐藏层的处理而更新,隐藏层则以残差流为输入和输出,共同构成LLM的特征提取 pipeline。

ZhangJiqun&191cm&85kg 7955

【收藏必看】大模型核心揭秘:一文读懂Transformer架构

本文详细解析了Transformer模型的底层架构,从词嵌入与位置编码、多头自注意力机制、前馈网络到编码器与解码器的工作原理。文章解释了Transformer如何通过自注意力机制捕捉上下文关系,以及前馈网络如何实现非线性变换。最后介绍了大模型如何基于Transformer架构构建,通过解码器实现自回归生成,使文字转化为可计算的思维。

2401_84815887的博客 872

揭秘 AI 人工智能领域的 Claude 训练机制

随着人工智能技术的飞速发展,自然语言处理领域涌现出了众多强大的模型,Claude 便是其中之一。本文的目的是全面揭秘 Claude 的训练机制,涵盖从其核心概念、算法原理、数学模型到实际应用和未来发展等多个方面。通过深入剖析,让读者对 Claude 的训练过程有一个清晰、全面的了解,为相关领域的研究和开发提供参考。本文将按照以下结构进行组织:首先介绍与 Claude 训练机制相关的核心概念和联系,包括其架构和数据处理流程;接着详细讲解核心算法原理和具体操作步骤,并结合 Python 代码进行说明;

欢迎来到我的优快云空间!这里聚焦AI大模型应用实战,分享前沿技术、实战案例与开发经验。 560

TensorRT对Transformer注意力机制专项优化揭秘

TensorRT通过层融合与FMHA内核,将Transformer注意力计算整合为单个CUDA kernel,显著减少显存往返。结合FP16/INT8混合精度和KV Cache优化,实测延迟下降70%,吞吐提升3倍以上,成为大模型高效部署的关键技术。

weixin_35755640的博客 828

实战指南:彻底清除TIA Portal卸载后遗留的SQL Server WinCC实例

本文详细介绍了如何彻底清除TIA Portal卸载后遗留的SQL Server WinCC实例,解决重新安装时的冲突问题。通过控制面板排查、注册表验证、安全卸载操作流程和注册表深度清理等步骤,确保完全移除残留组件,避免系统崩溃。文章还提供了安装环境重建策略和预防措施,帮助工程师高效管理西门子自动化软件。

weixin_30482181的博客 405

浅谈一下小波变换和EEG信号处理

浅谈小波变换,总结不是很到位,请大家指正。

qq_45045249的博客 2862

揭秘Transformer:AI变革的核心引擎

Transformer是一种革命性的深度学习架构,于2017年提出,通过自注意力机制处理序列数据,广泛应用于文本、图像、音频等领域。其核心包含三部分:嵌入层(将文本转换为向量)、Transformer块(多头自注意力机制和MLP层)和输出层(生成概率分布)。GPT-2是典型代表,通过Token化、位置编码和多层处理实现文本生成。模型通过预测下一个词的概率分布完成生成,temperature参数可调节输出的随机性。Transformer的创新在于能高效捕获长距离依赖关系,成为现代AI的基础架构。

小李同学_LSH的博客 875

Unity UI适配实战:从Canvas Scaler到主流游戏适配方案解析

本文深入解析Unity UI适配的核心技术,重点介绍Canvas Scaler组件的关键参数如Reference Resolution和Screen Match Mode,并提供主流游戏适配方案实战分析。通过九宫格拉伸、动态调整等技巧,帮助开发者解决多设备适配难题,提升游戏UI在不同分辨率下的表现。

weixin_29001419的博客 972

揭秘CLIP文本编码器:12层Transformer的奥秘

CLIP文本编码器采用12层Transformer结构处理文本输入。流程包含:1)BPE分词将文本转为77个token,结合词嵌入和位置嵌入;2)12层编码器通过多头注意力(12头×64维)和前馈网络(768→3072→768)提取特征;3)输出层取[CLS]标记,投影至512维并L2归一化,生成可计算跨模态相似度的特征向量。该模型通过残差连接和层归一化优化特征融合,最终输出聚焦语义相似性而非原始词序

2301_77385218的博客 566

Halcon 3D点云匹配实战:从预处理到模板创建的完整流程(附代码)

本文详细介绍了Halcon在3D点云匹配中的实战应用,涵盖从预处理到模板创建的完整流程。通过代码示例和实用技巧,帮助开发者掌握点云采样、降噪、三角化等关键技术,并优化匹配参数以提高精度和效率。适用于工业检测、机器人引导等领域。

weixin_33670786的博客 433

FreeCAD源码分析:Sketcher模块

Sketcher模块基于Part模块功能实现了特征编辑(Feature Editing)建模的功能。这类参数化建模系统主要包括几何表示、约束求解器等两大组成部分。

国产CAx(CAD/CAE/CAM)软件研发 6523

揭秘 AIGC 背后的技术:GPT、BERT 与 Transformer 模型的工作原理

本文将深入探讨 AIGC 背后的核心技术——Transformer、GPT 和 BERT,带你一步步了解它们的架构原理、训练机制及实际应用。我们将从 AIGC 的基础概念开始,逐步深入到每个关键模型的技术细节,最后展望这些技术未来可能带来的变革。AIGC,即人工智能生成内容,指的是通过人工智能技术自动化地生成文本、图像、音频或视频内容。它依赖于先进的机器学习模型,特别是在自然语言处理和计算机视觉领域的突破。内容创作:无论是新闻写作、博客生成,还是小说创作,AIGC 都能够根据给定的提示生成高质量的文本。

2402_82668782的博客 8920

帆软js--获取控件和单元格

参数面板: 获取面板控件 ,name为控件名称:_g().parameterEl.getWidgetByName("name") 取值:_g().parameterEl.getWidgetByName("tt3").getValue()2323 赋值:_g().parameterEl.getWidgetByName("tt2").setValue("987") 调用对应的事件比...

江湖行骗老中医 7198

揭秘DiT:Transformer如何彻底革新扩散模型的图像生成能力?

DiT(Diffusion Transformers)作为PyTorch官方实现的扩散模型,通过将Transformer架构与扩散过程深度融合,实现了图像生成质量的突破性提升。本文将从技术原理到实际应用,全面解析这一革新性模型如何通过注意力机制重构图像生成范式。 ## 🧠 扩散模型的进化:从CNN到Transformer的跨越 传统扩散模型依赖卷积神经网络(CNN)处理空间信息,在长距离依赖

gitblog_00809的博客 1052

Android Framework AMS面试题及参考答案

比如,应用 B 的 Activity 如果是 “singleTask” 启动模式,AMS 会查找应用 B 是否有包含该 Activity 的任务栈,若有则将这个任务栈切换到前台,并且清除该 Activity 之上的其他 Activity,实现流畅的跨应用跳转体验。如果一个 Activity 的启动依赖于另一个 Activity 的结果,AMS 会暂停当前 Activity 的部分生命周期操作,等待依赖的 Activity 完成相关操作后,再继续当前 Activity 的生命周期进程。

大模型大数据攻城狮的专栏 1862

内部函数方式获取工序包容盒(最低点和最高点)PTHDSP_ask_box

内部函数方式获取工序包容盒(最低点和最高点)PTHDSP_ask_box。

成长需要沉淀。 397

揭秘Transformer架构:从编码器到多头注意力

本文详细介绍了Transformer编码器的整体架构与实现细节。编码器由N个堆叠的编码器层构成,每个编码器层包含两个关键子层:多头自注意力机制和前馈神经网络,均配有层标准化和残差连接。多头注意力机制将输入特征拆分为多个头并行处理,提高效率与鲁棒性。前馈网络对注意力输出进行非线性变换。文章还深入解析了掩码张量、注意力计算公式(QKT/dk)、层标准化等技术要点,并提供了完整的PyTorch实现代码,包括注意力计算、多头注意力类、前馈网络、层标准化等核心组件的定义与测试案例。整个架构通过残差连接和层标准化有效缓

m0_74924137的博客 1248

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【Attention Is All You Need】Transformer 架构大揭秘!!!

本文详细解析了Transformer架构的核心设计。该模型采用编码器-解码器结构,完全基于自注意力机制,摒弃了传统的循环和卷积网络。编码器由6个相同层堆叠而成,每层包含多头自注意力和前馈网络;解码器同样6层,但增加了掩码自注意力机制确保自回归特性。模型采用残差连接和层归一化,使用位置编码注入位置信息。关键创新包括多头注意力机制(8个头)、位置前馈网络(维度512→2048→512)和缩放点积注意力计算。相比RNN和CNN,Transformer具有更高的并行性(O(1)顺序操作)和更短的路径依赖(O(1)最

m0_50826544的博客 773

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

揭秘GPT-1架构:hf_mirrors/wuhaicc/openai_gpt的12层Transformer工作原理

hf_mirrors/wuhaicc/openai_gpt项目提供了OpenAI经典的GPT-1模型镜像,这是首个基于Transformer架构的语言模型。本文将深入解析其核心的12层Transformer结构,帮助新手理解GPT系列模型的底层工作原理。 ## GPT-1模型概述:开启Transformer语言模型时代 `openai-gpt`(即GPT-1)是OpenAI发布的首个Trans

gitblog_00383的博客 741
上一篇: AI产品经理基础教程(非常详细),AI产品经理入门到精通,收藏这一篇就够了!
下一篇: 《一书解决几乎所有机器学习问题》.PDF下载
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值