[iceberg]3-spark调用iceberg入口分析

在Spark中开始一个Iceberg项目 在Spark中开始一个Iceberg项目在 Spark 中使用 IcebergSpark 中安装 Iceberg创建一个表读和写操作使用 SQL 读 在 Spark 中使用 Iceberg 最新版本是 0.8.0-incubating . 要在 Spark shell 中使用 Iceberg,请使用 --parkage 选项: spark-shell --packages org.apache.iceberg:iceberg-spark-runtime:0.8.0-incubating 您还可以在本地构建 阅读详情

以sql调用来分析:

[hadoop@10 ~]$ spark-sql --master local \

--conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions \

--conf spark.sql.catalog.spark_catalog=org.apache.iceberg.spark.SparkSessionCatalog \

--conf spark.sql.catalog.spark_catalog.type=hadoop \

--conf spark.sql.catalog.spark_catalog.warehouse=hdfs://ns1/user/wanghongbing/db

流程如下:
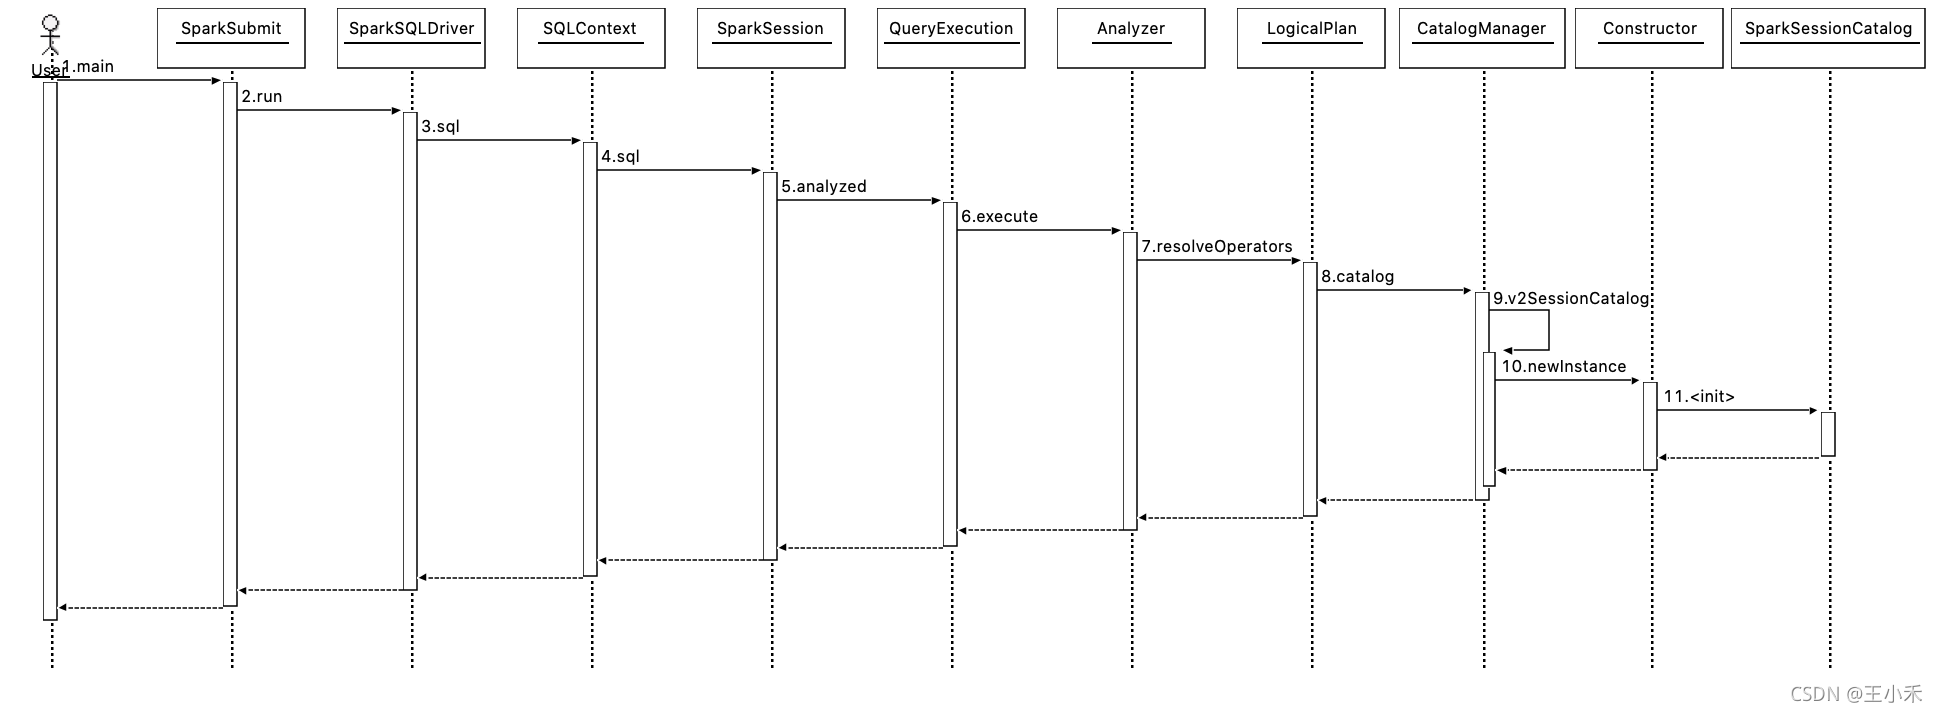
其中,spark包重要的类:

  • org.apache.spark.sql.connector.catalog.CatalogManager
  • org.apache.spark.sql.connector.catalog.Catalogs

iceberg包对应的类:

  • org.apache.iceberg.spark.SparkSessionCatalog
  • org.apache.iceberg.spark.SparkCatalog

# CatalogManager

def catalog(name: String): CatalogPlugin = synchronized {

  if (name.equalsIgnoreCase(SESSION_CATALOG_NAME)) {

    v2SessionCatalog

  } else {

    catalogs.getOrElseUpdate(name, Catalogs.load(name, conf))

  }

}

private[sql] object CatalogManager {

  val SESSION_CATALOG_NAME: String = "spark_catalog"

}


# SparkSessionCatalog

/**

 * A Spark catalog that can also load non-Iceberg tables.

 *

 * @param <T> CatalogPlugin class to avoid casting to TableCatalog and SupportsNamespaces.

 */

public class SparkSessionCatalog<T extends TableCatalog & SupportsNamespaces>

    extends BaseCatalog implements CatalogExtension {

这里 org.apache.iceberg.spark.SparkSessionCatalog 实现了 org.apache.spark.sql.connector.catalog.CatalogExtension 和 CatalogPlugin

public interface CatalogPlugin {


  void initialize(String name, CaseInsensitiveStringMap options);


  String name();


  default String[] defaultNamespace() {

    return new String[0];

  }

}

小结:Spark包中定义了Catalog的接口,iceberg用于实现。

数据湖iceberg和spark集成 为了解决数据存储和计算引擎之间的适配的问题,Netflix开发了Iceberg,2018年11月16日进入Apache孵化器,2020 年5月19成为Apache的顶级项目。Iceberg是一个面向海量数据分析场景的开放表格式(Table Format)可以理解为元数据以及数据文件的一种组织方式,处于计算框架(Flink,Spark…)之下,数据文件之上。 阅读详情

相关推荐

SPARKSQL3.0-各阶段自定义扩展规则源码剖析

SPARKSQL3.0-各阶段自定义扩展规则源码剖析

探索大数据世界 - 深入解析数据存储、分布式计算与人工智能 1559

Iceberg on Spark的示例1

iceberg

zhu2525wei的博客 954

数据湖(十二):Spark3.1.2与Iceberg0.12.1整合

文章目录Spark3.1.2与Iceberg0.12.1整合一、​​​​​​​向pom文件导入依赖二、SparkSQL设置catalog配置三、使用Hive Catalog管理Iceberg表1、创建表2、插入数据3、查询数据4、删除表四、用Hadoop Catalog管理Iceberg表1、创建表2、插入数据3、查询数据4、创建对应的Hive表映射数据5、删除表Spark可以操作Iceberg数据湖,这里使用的Iceberg的版本为0.12.1,此版本与Spark2.4版本之上兼容。由于在Spark2.4

Lansonli(蓝深李)的博客 3183

如何扩展Spark Catalyst,抓取spark sql 语句,通过listenerBus发送sql event以及编写自定义的Spark SQL引擎

我们可以实现特定的SQL方言,针对特殊的数据源做更深入的优化,进行SQL规范检查,针对特定执行环境制定特定的优化策略等等。Spark Catalyst的SQL处理分成parser,analyzer,optimizer以及planner等多个步骤,其中analyzer,optimizer等步骤内部也分为多个阶段,以Analyzer为例,analyse规则切分到不同的batch中,每个batch的执行策略可能不尽相同,有的只会执行一遍,有的会迭代执行直到满足一定条件。并且引入如下maven plugin。

1198

跟着团子学SAP CO:揭秘结果分析码在项目结算中的实战应用(一)KKA2/CJ88

本文深入解析了SAP CO模块中结果分析码在项目结算中的核心作用。以KKA2(方法10)和事务代码CJ88为例,详细阐述了如何在项目完工后一次性确认收入的场景下,通过结果分析功能实现收入与成本的精准匹配,将项目成本暂估为在制品,确保各期利润的准确反映。

gamma的博客 685

Oracle-如何修复undo坏快

undo出现坏快,导致数据库宕机,无法启动

qqqyyy0422的博客 570

Apache Iceberg 与 Spark整合-使用教程(Iceberg 官方文档解析)

spark & iceberg

喻师傅的学习笔记 5128

通信原理与MATLAB(八):2PSK的调制解调

通信原理和MATLAB

菜yuan~的博客 3万+

spark sql(二)sql解析流程扩展

spark sql大体在四个阶段提供了扩展能力,分别是未解析的逻辑计划、解析后的逻辑计划、优化后的逻辑计划、物理计划。在这四个阶段后面我们都可以引入自己的处理逻辑。

Interest1_wyt的博客 1441

ABAP调用启信宝API

方法参数定义如下 源代码如下 method qxb_http_get. data:lv_url type string. "===============初始化=============================================== "获取http实例 cl_http_client=>create_by_destination( exporting destination = space importing

u012232542的博客 1310

Python爬虫-汽车之家各车系月销量榜数据

本文是该专栏的第41篇,后面会持续分享python爬虫干货知识。本文以某汽车平台为例,基于python采集该平台“各车系月销量”的榜单数据。具体实现思路和详细逻辑,笔者将在正文结合完整代码进行详细介绍。接下来,跟着笔者直接往下看正文详细内容。(附带完整代码)

Python进阶专栏《爬虫实战进阶》,《Pyppeteer从入门到精通》原创作者 1617

【Iceberg分析】Spark与Iceberg集成落地实践(一)

iceberg表管理

有问题的请私信或关注v【技术印记】留言 2778

数字逻辑Fundamentals of Digital Logic with Verilog Design | 3rd Edition Solutins Chapter 3(step by step)

第三章3-1~3-27全部习题解析和代码模块

weixin_62651190的博客 1946

【Iceberg分析】Spark集成Iceberg采集输出

Spark集成Iceberg采集输出验证

有问题的请私信或关注v【技术印记】留言 1278

使用timeROC包的compare函数比较不同标记物下两个多时间AUC值是否具有统计显著性

时间依赖的接收器操作特征曲线(time-dependent receiver operating characteristic curve, time-dependent ROC curve)是评估和比较标记物在不同时间点上预测能力的重要工具。在R语言中,timeROC包提供了丰富的函数和工具,可用于分析和比较多时间点的AUC值。时间点(timepoints)表示观察的时间点,标记物1(marker1)和标记物2(marker2)分别表示在每个时间点上的预测概率。最后,我们输出比较结果。

2301_79331387的博客 921

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Iceberg从入门到精通系列之二十一:Spark集成Iceberg

Spark 支持通过指定catalog-impl 属性来加载自定义Iceberg Catalog 实现。

zhengzaifeidelushang的博客 3245

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

实践数据湖iceberg 第十六课 通过spark3打开iceberg的认知之门

实践数据湖icerberg专栏 本专栏记录iceberg菜鸟到专家的过程,记录踩坑,填坑,iceberg特征的了解与原理的认知

spark_dev的博客 2495

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

Spark与Iceberg集成:开源数据表格式实践

想象一下,2023年某电商平台的"双11"大促场景:数据团队凌晨3点接到紧急告警,昨天的销售报表数据异常,需要立即排查。分析师尝试回溯数据,却发现由于频繁的ETL操作,原始数据早已被覆盖;数据工程师试图调整分区策略优化查询性能,却发现传统表格式不支持无停机的分区变更;与此同时,实时计算团队需要基于相同的数据集构建流处理管道,却面临批流数据一致性的挑战。这并非虚构场景,而是数据湖发展过程中普遍面临的"冰火两重天"困境:一方面是数据价值挖掘的迫切需求(“火”),另一方面是数据管理技术的滞后(“冰”)。

AI架构全栈开发实战笔记 1362

数据湖之 Flink Spark 集成 iceberg

数据湖之 Flink Spark 集成 iceberg一、iceberg优点二、安装部署三、iceberg集成flink四、hive查询iceberg表五、spark集成iceberg表 一、iceberg优点 提供ACID事物,上游数据写入即可见,提供了 upsert、merge into 能力 支持计算引擎有 Spark、Flink、Presto 以及 Hive 支持 Parquet、Avro 以及 ORC 等存储格式 增量读取处理能力:支持通过流式方式读取增量数据,支持 Structed Strea

weixin_50213935的博客 1769

Docker、Spark 和 Iceberg:体验 Iceberg 的最快方式

如果您因为听说Iceberg解决了若干问题,例如模式演变或行级更新,而对Iceberg感兴趣,并且你想要一种简单的方法来体验它,那么您来对地方了!这篇文章将让您在本地几分钟内启动并运行 Spark 和 Iceberg。同时将展示出许多令人惊叹的 Iceberg 特性,这些特性可以解决您以前使用数据仓库时遇到的问题。

杂记 2273

iceberg-Spark3.0SQL 测试案例

iceberg-spark3.0 测试案例 参考:官网,调研传送门 测试使用的Spark3.0版本,iceberg-Spark操作分3部分,SQL、DF、Streaming 一、配置及参数 1、配置jar包: iceberg0.11.0版本,官网下载jar包,放到spark的jars目录下。 点击下载spark2.4和spark3的驱动包。 注意:要在Spark中使用Iceberg,请首先配置catalogs(注意:Spark2.4不支持DDL操作) 2、注意: 1、iceberg命名空间:V1和V2表

黑眼圈@~@从不出水文 3012

Iceberg0.11与Spark3.0结合

Iceberg0.11与Spark3.0结合 1.安装编译Iceberg0.11 此处我下载的是Iceberg0.11.1版本 需要提前安装gradle,iceberg的编译,此处使用的是gradle5.4.1版本 wget https://downloads.gradle.org/distributions/gradle-5.4-bin.zip unzip -d /opt/gradle gradle-5.4-bin.zip vim /etc/profile # 加入下面的 #GREDLE export G

美丽的毛毛草 976

实践数据湖iceberg 第十七课 hadoop2.7,spark3 on yarn运行iceberg配置

系列文章目录 实践数据湖iceberg 第一课 入门 实践数据湖iceberg 第二课 iceberg基于hadoop的底层数据格式 实践数据湖iceberg 第三课 在sqlclient中,以sql方式从kafka读数据到iceberg 实践数据湖iceberg 第四课 在sqlclient中,以sql方式从kafka读数据到iceberg(升级版本到flink1.12.7) 实践数据湖iceberg 第五课 hive catalog特点 实践数据湖iceberg 第六课 从kafka写入到iceber

spark_dev的博客 1629

hive2.1.1+spark3.0+iceberg踩坑日记

1、sparkSQL3.0支持iceberg需要引入iceberg-spark3-runtime jar包 iceberg-spark3-runtime-0.11.1.jar 下载地址http://iceberg.apache.org/releases/ 2、修改conf/spark-default.conf文件添加默认iceberg catalog # hive metastore的版本设置为 2.1.1 spark.sql.hive.metastore.version=2...

qq_33476283的博客 4747

【Iceberg分析】调研Iceberg中表的原地演变

iceberg的表的原地演变

有问题的请私信或关注v【技术印记】留言 1648
上一篇: [iceberg]2-hivecatalog
下一篇: Lock基础
王小禾
博客等级 码龄11年 80粉丝 291原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值