one-hot encoding不是万能的,这些分类变量编码方法你值得拥有

常见分类变量编码方法(Target、Leave-one-out、One-hot Encoding) one-hot 编码(one-hot encoding) one-hot 编码(one-hot encoding)类似于虚拟变量(dummy variables),是一种将分类变量转换为几个二进制列的方法。其中 1 代表某个输入属于该类别。 从机器学习的角度来看,one-hot 编码并不是一种良好的分类变量编码方法。 众所周知,维数越少越好,但 one-hot 编码却增加了大量的维度。例如,如果用一个序列来表示美国的各个州,那么 one-hot 编码会带来 50 多个维度。 one-hot 阅读详情
来自:机器之心

one-hot encoding 是一种被广泛使用的编码方法,但也会造成维度过高等问题。因此,medium 的一位博主表示,在编码分类变量方面,我们或许还有更好的选择。

one-hot 编码(one-hot encoding)类似于虚拟变量(dummy variables),是一种将分类变量转换为几个二进制列的方法。其中 1 代表某个输入属于该类别。
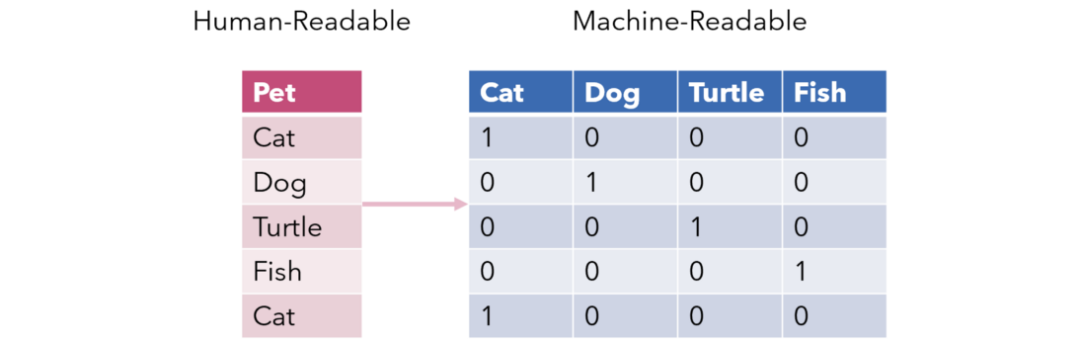
从机器学习的角度来看,one-hot 编码并不是一种良好的分类变量编码方法。

众所周知,维数越少越好,但 one-hot 编码却增加了大量的维度。例如,如果用一个序列来表示美国的各个州,那么 one-hot 编码会带来 50 多个维度。

one-hot 编码不仅会为数据集增加大量维度,而且实际上并没有太多信息,很多时候 1 散落在众多零之中,即有用的信息零散地分布在大量数据中。这会导致结果异常稀疏,使其难以进行优化,对于神经网络来说尤其如此。

更糟糕的是,每个信息稀疏列之间都具有线性关系。这意味着一个变量可以很容易地使用其他变量进行预测,导致高维度中出现并行性和多重共线性的问题。
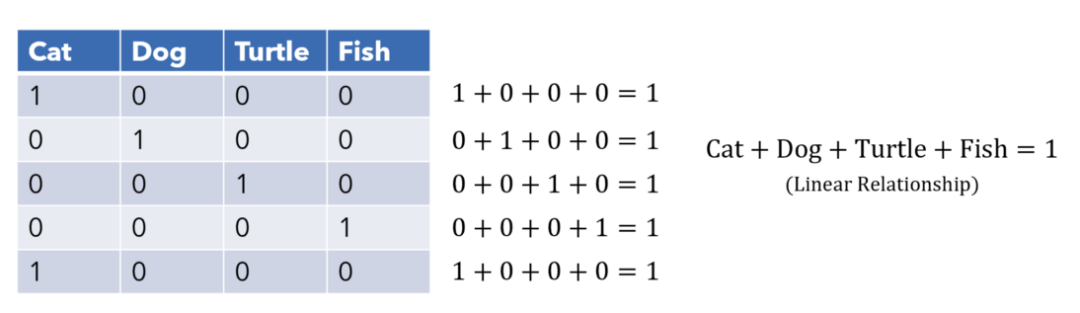
最优数据集由信息具有独立价值的特征组成,但 one-hot 编码创建了一个完全不同的环境。

当然,如果只有三、四个类,那么 one-hot 编码可能不是一个糟糕的选择。但是随着类别的增加,可能还有其他更合适的方案值得探索。本文作者列举了几个方案供读者参考。

目标编码

目标编码(Target encoding)是表示分类列的一种非常有效的方法,并且仅占用一个特征空间,也称为均值编码。该列中的每个值都被该类别的平均目标值替代。这可以更直接地表示分类变量和目标变量之间的关系,并且也是一种很受欢迎的技术方法(尤其是在 Kaggle 比赛中)。
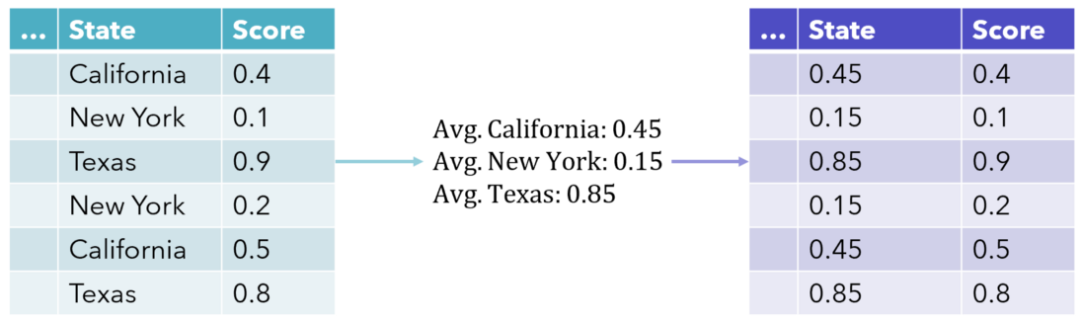
但这种编码方法也有一些缺点。首先,它使模型更难学习均值编码变量和另一个变量之间的关系,仅基于列与目标的关系就在列中绘制相似性。

而最主要的是,这种编码方法对 y 变量非常敏感,这会影响模型提取编码信息的能力。

由于该类别的每个值都被相同的数值替换,因此模型可能会过拟合其见过的编码值(例如将 0.8 与完全不同的值相关联,而不是 0.79),这是把连续尺度上的值视为严重重复的类的结果。

因此,需要仔细监控 y 变量,以防出现异常值。要实现这个目的,就要使用 category_encoders 库。由于目标编码器是一种有监督方法,所以它同时需要 X 和 y 训练集。

from category_encoders import TargetEncoder 
 enc = TargetEncoder(cols=[ Name_of_col , Another_name ]) 
 training_set = enc.fit_transform(X_train, y_train)

留一法编码

留一法(Leave-one-out)编码试图通过计算平均值(不包括当前行值)来弥补对 y 变量的依赖以及值的多样性。这使异常值的影响趋于平稳,并创建更多样化的编码值。
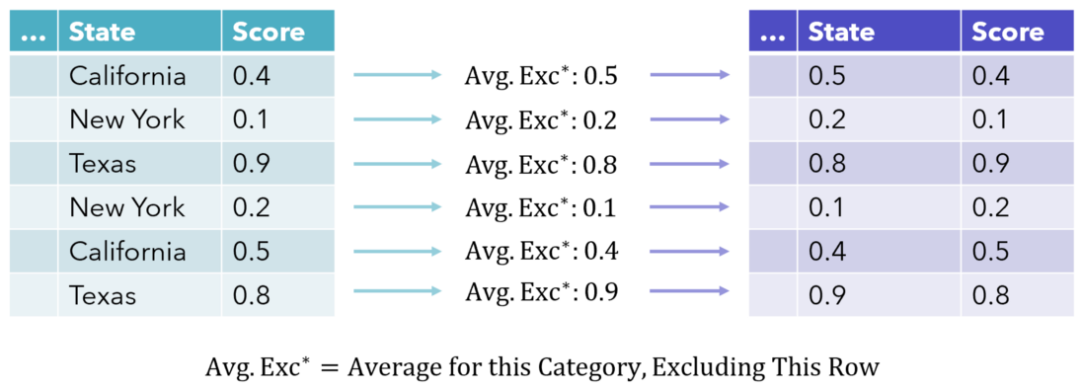
由于模型不仅要面对每个编码类的相同值,还要面对一个范围值,因此它可以更好地泛化。

在实现方面,可以使用 category_encoders 库中的 LeaveOneOutEncoder。

from category_encoders import LeaveOneOutEncoder
 enc = LeaveOneOutEncoder(cols=[ Name_of_col , Another_name ])
 training_set = enc.fit_transform(X_train, y_train)

实现类似效果的另一种策略是将正态分布的噪声添加到编码分数中,其中标准差是可以调整的参数。

贝叶斯目标编码

贝叶斯目标编码(Bayesian Target Encoding)是一种使用目标作为编码方法的数学方法。仅使用均值可能是一种欺骗性度量标准,因此贝叶斯目标编码试图结合目标变量分布的其他统计度量。例如其方差或偏度(称为高阶矩「higher moments」)。

然后通过贝叶斯模型合并这些分布的属性,从而产生一种编码,该编码更清楚类别目标分布的各个方面,但是结果的可解释性比较差。

证据权重

证据权重(Weight of Evidence,简称 WoE)是另一种关于分类自变量和因变量之间关系的方案。WoE 源自信用评分领域,曾用于区分用户是违约拖欠还是已经偿还贷款。证据权重的数学定义是优势比的自然对数,即:

ln (% of non events / % of events)

WoE 越高,事件发生的可能性就越大。「Non-events」是不属于某个类的百分比。使用证据权重与因变量建立单调关系,并在逻辑尺度上确保类别,这对于逻辑回归来说很自然。WoE 是另一个衡量指标「Information Value」的关键组成部分。该指标用来衡量特征如何为预测提供信息。

from category_encoders import WOEEncoder 
 enc = WOEEncoder(cols=[ Name_of_col , Another_name ]) 
 training_set = enc.fit_transform(X_train, y_train)

这些方法都是有监督编码器,或者是考虑目标变量的编码方法,因此在预测任务中通常是更有效的编码器。但是,当需要执行无监督分析时,这些方法并不一定适用。

非线性 PCA

非线性 PCA(Nonlinear PCA)是一种使用分类量化来处理分类变量的主成分分析(PCA)方法。它会找到对类别来说的最佳数值,从而使常规 PCA 的性能(可解释方差)最大化。

原文链接:

https://towardsdatascience.com/stop-one-hot-encoding-your-categorical-variables-bbb0fba89809

变量编码方式one-hot encoding ,label encoding 在机器学习中,我们拿到的数据通常比较脏乱,可能会带有各种非数字特殊符号,比如中文。而机器学习模型需要的数据是数字型的,因为只有数字类型才能进行计算。这时便需要对变量进行编码,那变量是如何进行编码的呢? 对于分类型数据的编码,我们通常会使用两种方式来实现,分别是:one-hot encoding 和 label-encoding。 独热编码就是将原始特征变量转换成以原始特征值分类的多维度的变量,并用... 阅读详情

相关推荐

Label Encoding & One-Hot Encoding

为什么需要Encoding? 绝大多数模型不支持类别型变量的输入,   什么是One-Hot Encoding? One-Hot编码即独热编码,又称一位有效编码,其方法是使用N位状态寄存器来对N个状态进行编码,每个状态都由他独立的寄存器位,并且在任意时候,其中只有一位有效。这样做的好处主要有: 1.解决了分类器不好处理属性数据的问题; 2.在一定程度上也起到了扩充特征的作用(有利有弊)...

lukeyyanghang的博客 2803

数据预处理 | 处理类别变量(categorical variable)python-sklearn实现 | 三种常用方法| Kaggle 学习笔记(四)

方法一:移除法(Drop) 将含有类别变量的列移除。 import pandas as pd # 读取数据 data = pd.read_csv("filename.csv") # 获取数据集中的含有类别变量的列的列名,并用列表表示 s = (data.dtypes == 'object') object_cols = list(s[s].index) # 移除含有类别变量的列 drop_d...

用途:中英文学习笔记,如有侵权,可评论留言,及时清理;学历:NUS计算机硕士;SYSU地球物理学士 1万+

机器学习之One-Hot Encoding详解-- one-hot编码解释-数据预处理之独热编码(One-Hot Encoding)

什么是one-hot编码?one-hot编码,又称独热编码、一位有效编码。其方法是使用N位状态寄存器来对N个状态进行编码,每个状态都有它独立的寄存器位,并且在任意时候,其中只有一位有效。 假设有如下表格,记录了某网站访问者的三个信息:性别,来自,使用的浏览器: 考虑以下三个特征: 性别:["男","女"] 来自:["北京","上海","广州"] 使用的浏览器:["Firefox","...

qinzaoxiaozhu的专栏 1万+

one-hot encoding 并非分类变量编码的唯一选择

本文转载自机器之心。选自towardsdatascience机器之心编译作者:Andre Ye编辑:小舟、张倩one-hot encoding 是一种被广泛使用的编码方法,但也会造成维度...

我爱计算机视觉 1068

机器学习数据中类别变量(categorical variable)的处理方法

类别变量(categorical variable):只有有限个值得变量,如性别就是一个类别变量,类似于这种。 如果不对这些变量做预处理,训练出来的模型可能是错误的。 主要有三种方法来处理这个变量。 如何从数据中找到类别变量? 我们可以对每一列检查它的数据类型,某列的数据类型为”object”,表明该列有文本(也可能是其他的,但对我们的目标来说不重要),某列是数据是文本,则该列表示类别变量。 代码如下: # 获得类别变量的列名,存放在列表中 s = (X_train.dtypes == 'object') object_cols = list(s[s].index) 1.直接删除类别变量。

普通人如何上岸华为OD-面试总结

总共有3道算法题,100分值的两道,200分值的一道,不同的毕业院校和专业,通过机试的分值不一样,最少需要150分通过,提前和hr联系,了解自己需要多少分通过。重中之重:哪怕你是背的题库,也请你一定不要直接抄原来的,最好是变更下方法名,否则会判定你重复率过高,从而失去后面的面试机会(实在是不会做再用此方法,凑分数所用,面试官能看到你的代码,会影响你的面试评价)本人女,所以还问道了婚育计划,有对象这点可以说,没有问题,但是如果可以的话,生孩子的时间,可以给hr说这几年不考虑。如果说没有难题,直接就挂了。

weixin_47767264的博客 5451

机器学习中的特征工程——分类变量的处理

出品 | CDA数据分析研究院,转载需授权 文章目录分类变量概念判断类型少类别分类变量处理方法独热编码(One-hot encoding)虚拟编码(Dummy coding)效应编码(Effect coding)优缺点对比多类别分类变量处理方法特征哈希方法(Feature hashing)Bin-counting方法优缺点对比 本文将介绍关于机器学习中的特征工程关于分类变量的处理。 分类变量...

CDA数据分析师 7053

机器人示教器方案昆仑通态脚本实现( 三菱FX3U+昆仑通态3轴联动))

项目应用场景:最终客户需要自由的修改程序流程,如检测什么信号,多少时间,再进入下一步,轴定位轨迹可以自由修改,方便最终可以在不修改PLC程序的情况下,自由示教程序。3.指令数量可以自行添加,在内存足够的情况下,无限制,只需要在PLC框架里面写好每个指令执行的内容就可以了,不需要在程序里面重复写相同类容;4.模板有延时指令,输入指令,输出指令,伺服定位指令,焊钳控制指令,自动修磨指令,转矩模式指令,结束指令等(可自行添加);1.有类似示教器编程功能,可以任意位置插入指令,可以任意位置删除指令;

huanyuecuiyu的博客 969

机器学习2.12——多类别分类问题处理

1⃣️高级优化 2⃣️多分类问题处理 3⃣️过度拟合 什么是多分类 答:一个类的不同属性情况 eg:邮件分类处理#来自朋友,来自亲人,来自同事 思路:将多分类转换为二元分类➡️把每个属性分别拟合分类器➡️输出识别概率越高分类器拟合效果越好 ...

weixin_54245989的博客 876

《探秘 BME680温度湿度气压气体传感器模块:环境感知的卓越之选》:此文为AI自动生成

BME680 是一款由博世公司推出的集成环境传感器模块,在环境监测和物联网等领域中发挥着重要作用。它能够同时测量温度、湿度、气压和气体浓度等多个环境参数,为各种应用提供准确可靠的环境数据。该模块采用小巧的封装形式,便于集成到各种设备中,无论是智能家居、可穿戴设备还是工业监测系统,都能轻松适配。例如,在智能家居系统中,BME680 模块可以监测室内环境参数,如温度、湿度、气压和空气质量等。通过与智能家居控制器或智能手机应用程序的连接,用户可以实时了解室内环境状况,并根据需要进行调整。

zheng_ruiguo的专栏 1865

从原理到代码:拆解UniFormer中动态位置嵌入(DPE)的3D卷积实现

本文深入解析了UniFormer模型中动态位置嵌入(DPE)模块的3D卷积实现原理与代码。DPE通过一个轻量的3D深度可分离卷积,替代传统静态位置编码,使模型能自动学习视频数据的时空位置关系。文章对比了其与Swin Transformer相对位置偏置的优劣,并提供了PyTorch实现代码与高级定制方案,为视频理解任务提供了高效灵活的动态位置编码解决方案。

weixin_29207149的博客 309

机器学习中级课程 3.分类变量

本文为kaggle机器学习中级课程 第三部分 Categorical Variables --There's a lot of non-numeric data out there. Here's how to use it for machine learning.在本教程中,您将了解什么是分类变量,以及处理此类数据的三种方法。

水滴的博客 4584

【学习路线】 游戏客户端开发入门到进阶

游戏开发是一个交叉性极强的技术领域,对开发者提出了高维度的要求。作为初学者,不要急于求成,打牢基础、注重原理、勤于实践,你的成长将会非常快速而稳健。希望这份学习路线与书单能为你指明方向,迈出职业开发者的第一步。

hhw_hhw的博客 2126

机器学习之One-Hot Encoding详解

看到One-Hot-Encoding发现网上大多数说明都是来自于同一个例子,最后结果感觉出的好突兀,因此这里总结一下。很多机器学习任务中,特征并不总是连续值,有可能是分类值。 考虑以下三个特征: ["male", "female"] ["from Europe", "from US", "from Asia"] ["uses Firefox", "uses Chrome",...

愿你远行千里,归来仍是少年 6780

【灰度共生矩阵(GLCM)原理及代码实现】

文章主旨详细介绍灰度共生矩阵(Gray-Level Co-occurrence Matrix, GLCM)的生成原理、核心特征量及其在图像纹理分析中的应用,并提供了可运行的Python代码实现。该网页是一篇理论结合实践的优秀技术文章。它不仅清晰地解释了GLCM这一经典纹理分析工具背后的数学原理,还提供了完整、可复现的代码,非常适合计算机视觉或图像处理领域的学习者和开发者入门并实践灰度共生矩阵。读者可以通过运行代码来直观理解GLCM如何工作,并提取图像的纹理特征。

blotemj.blog.youkuaiyun.com 176

基于YOLO26的实时目标追踪实战:从训练到视频追踪(附完整可视化代码)

核心组合:YOLO26(高精度检测)+ ByteTrack(稳定追踪)是实时目标追踪的最优工业组合,Ultralytics内置集成无需额外开发;训练优化:追踪场景需优先提升检测框精度(增加box损失权重),保证ID稳定性;可视化核心:为每个ID分配唯一颜色、绘制运动轨迹、显示FPS,是落地场景的必备功能;性能调优:轻量化模型+降分辨率+OpenVINO导出,可在边缘设备(如研华工控机)实现实时追踪。这套代码可直接复用到智慧园区、停车场、工业产线等场景,仅需修改park.yaml中的类别和。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 571

独热编码(One-Hot Encoding)

一、独热编码出现之前:针对无序离散的分类特征,机器学习算法的分类器并不能直接进行数据处理。因为,分类器通常处理的数据是连续且有序的。 但是我们可以对这些离散的特征数据建立映射表来让其有序并且连续起来。例如:针对一个人对象,我们可以假设其属性进行了如下映射。 性别特征: ["男","女"] => 0,1 =>二维 居住地特征: ["北京","上海,"深圳"] => 0,1,2 =>三维 职业特征: ["演员","老师","公务员","工程师","消防员"] => 0,...

3万+

Python数据可视化 Pyecharts 制作 Map 地图

大家好,我是Mr数据杨。想象一下,作为一名军师,如诸葛亮或郭嘉,'Map’就如同那战争的沙盘,兵马行动的轨迹,都需要准确的地图作为基础。‘基本设置’,就如同摆设这张战争沙盘,规定棋子的起始位置。‘数据配置选项’和’地图数据项’,就好比是军师们手中的情报,了解各路诸侯的兵力、粮草、地形等重要信息,以便于他们更好地布局。‘Demo’则代表着练兵之地,军师们可以在此基于已有数据,试验各种战术。

Mr数据杨 4万+

从One-Hot到Target Encoding:category_encoders编码方法演进史

category_encoders是一个与scikit-learn兼容的 categorical variable encoders库,它提供了多种强大的分类变量编码方法,帮助数据科学家和机器学习工程师更好地处理分类数据,提升模型性能。本文将带您深入了解从传统的One-Hot编码到先进的Target Encoding的演进历程,探索各种编码方法的特点、适用场景以及在实际应用中的表现。 ## 一、

gitblog_00527的博客 1417

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

机器学习:数据预处理之独热编码(One-Hot)详解

一. 什么是独热编码? ———————————————————————————————————————— 在机器学习算法中,我们经常会遇到分类特征,例如:人的性别有男女,祖国有中国,美国,法国等。 这些特征值并不是连续的,而是离散的,无序的。通常我们需要对其进行特征数字化。 那什么是特征数字化呢?例子如下: 性别特征:["男","女"] 祖国特征:["中国","美国,"法国"...

赵英超的博客 11万+

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

数据预处理:独热编码(One-Hot Encoding)

在很多任务中,特征并不总是连续值,而有可能是分类值。例如,考虑一下的三个特征:如果将上述特征用数字表示,效率会高很多。例如:["male", "from US", "uses Internet Explorer"] 表示为[0, 1, 3]["female", "from Asia", "uses Chrome"]表示为[1, 2, 1]但是,即使转化为数字表示后,上述数据也不能直接用在我们的分类器中。

皮皮blog 7万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

上一篇: 清华大学开源迁移学习算法库:基于PyTorch实现已有算法
下一篇: 知乎高赞:iOS 为什么感觉比 Android 流畅?
机器学习算法那些事
博客等级 码龄9年 1633粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值