


最近小编在研究yolo3的算法源码,在调试过程中发现中间层的BatchNorm2d的结果竟然出现了Nan。
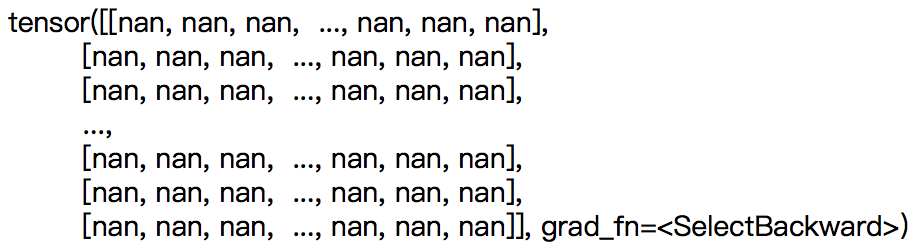
第一次遇到这种情况,为了找出其中的原因,小编查阅了Pytorch官网关于BatchNorm2d的函数解释和网上关于该函数的相关博客,脑壳还是有点模糊,没有代码的测试验证,仅仅用文字去解释BatchNorm2d函数,初学者很容易一头雾水,半知半懂。
本文结合代码去验证BatchNorm2d的算法实现,若有不懂,读者可以参考文中代码并修改参数,来验证自己对该函数的理解是否准确。
实际项目中,我们处理的数据大部分是4维的,如:
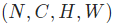
其中N为数据个数,C为通道数,H,W分别表示图形的宽和高。
我们用BatchNorm2d归一化上述的数据结构,值得注意的是归一化是每个通道的归一化,以每个通道作为视角来归一化数据。
首先引用Pytorch官网对BatchNorm2d的描述:

BatchNorm2d的计算公式:
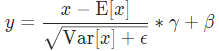
其中x为需要归一化的输入数据, 和
 为批量数据的均值和方差,
 为防止分母出现零所增加的变量,γ和β是对输入值进行仿射操作,即线性变换。γ和β的默认值分别为1和0,仿射包含了不进行仿射的结果,使得BatchNormlization的引入至少不降低模型,γ和β为模型的学习参数。
下面介绍BatchNorm2d的参数解释:
num_features:通道数,即维度大小
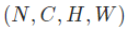 的C。
eps:为使数值稳定而在分母上增加的值。默认值:1 e-5
momentum:期望和方差的更新参数,与动量梯度下降法类似,期望和方差的更新公式:

 为模型的均值或方差,
 为当前观测值的均值或方差,
 为更新后的均值或方差,momentum为更新参数。
affine:归一化是否需要仿射,若设置为True,则需要对模型进行仿射,默认值为True。
track_runnning_states:模型的均值和方差是否需要更新,若为True,表示需要更新;反之不需要更新。更新公式参考momentum参数介绍 。
模型参数是否需要更新,需要结合参数布尔型参数trainning和track_running_states来看,模型归一化的结果也因这两种参数的不同而不同。
根据模型处于训练阶段或测试阶段,参数trainning和track_running_states有4种组合方式。
trainning = True,track_running_states = True,模型处于训练阶段,表示每作一次归一化,模型都需要更新参数均值和方差,即更新参数 running_mean 和 running_var 。
trainning = True,track_running_stats = False,模型处于训练阶段,表示对新的训练数据进行归一化时,不更新模型的均值和方差,这种设置是错误的,因为不能很好的描述全局的数据统计特性。
trainning = False,track_running_stats = True,模型处于测试阶段,表示模型在归一化测试数据时,需要考虑模型的均值和方差,但是不更新模型的均值和方差。
trainning = False,track_running_stats = False,模型处于测试阶段,表示模型在归一化测试数据时,不考虑模型的均值和方差,这种设置是错误的,归一化的结果会造成统计特性的偏移。
由上面4种组合参数的介绍,正确的参数设置应为:
训练阶段:trainning = True,track_running_stats = True
测试阶段:training = False,track_running_stats = True
脑壳是不是一头雾水,下面用例子说明参数的含义:
1. 训练阶段的归一化实例
初始化训练阶段的归一化模型:
m3 = nn.BatchNorm2d(3, eps=0, momentum=0.5, affine=True, track_running_stats=True).cuda()
# 为了方便验证,设置模型参数的值
m3.running_mean = (torch.ones([3])*4).cuda()     # 设置模型的均值是4
m3.running_var = (torch.ones([3])*2).cuda()      # 设置模型的方差是2

# 查看模型参数的值
print('trainning:',m3.training)
print('running_mean:',m3.running_mean)
print('running_var:',m3.running_var)
# gamma对应模型的weight,默认值是1
print('weight:',m3.weight)
# gamma对应模型的bias,默认值是0
print('bias:',m3.bias)

#>
trainning: True
running_mean: tensor([4., 4., 4.], device='cuda:0')
running_var: tensor([2., 2., 2.], device='cuda:0')
weight: Parameter containing:
tensor([1., 1., 1.], device='cuda:0', requires_grad=True)
bias: Parameter containing:
tensor([0., 0., 0.], device='cuda:0', requires_grad=True)
生成批量数据为1,通道为3,均值为0方差为1的416行416列输入数据:
# 生成通道3,416行416列的输入数据
torch.manual_seed(21)
input3 = torch.randn(1, 3, 416, 416).cuda()
# 输出第一个通道的数据
input3[0][0]

#>
tensor([[-0.2386, -1.0934,  0.1558,  ..., -0.3553, -0.1205, -0.3859],
        [ 0.2582,  0.2833,  0.7942,  ...,  1.1228,  0.3332, -1.2364],
        [-0.8235, -1.1512, -0.5026,  ...,  0.9393, -0.5026, -0.4719],
        ...,
        [-0.2843, -1.3638, -0.4599,  ...,  1.6502,  0.4864, -0.1804],
        [ 0.3813, -0.6426,  0.4879,  ...,  2.7496,  1.8501,  1.7092],
        [ 0.8221, -0.5702,  0.1705,  ...,  1.0553,  1.0248,  0.5127]],
       device='cuda:0')
对上面的数据进行归一化:
# 数据归一化
output3 = m3(input3)
# 输出归一化后的第一个通道的数据
output3[0][0]

#>
tensor([[-0.2427, -1.0955,  0.1508,  ..., -0.3592, -0.1249, -0.3897],
        [ 0.2529,  0.2779,  0.7876,  ...,  1.1154,  0.3277, -1.2382],
        [-0.8262, -1.1531, -0.5061,  ...,  0.9323, -0.5061, -0.4755],
        ...,
        [-0.2884, -1.3652, -0.4635,  ...,  1.6416,  0.4805, -0.1847],
        [ 0.3757, -0.6458,  0.4820,  ...,  2.7383,  1.8410,  1.7004],
        [ 0.8154, -0.5735,  0.1654,  ...,  1.0480,  1.0176,  0.5067]],
       device='cuda:0', grad_fn=<SelectBackward>)
为了理解BatchNorm2d的函数实现,我们编写此函数的算法实现,比对归一化结果。
因为trainning = True,track_running_stats = True,我们需要更新模型的均值和方差:
 为模型更新前的均值或方差,代码计算更新后的均值和方差:
# 计算更新后的均值和方差
momentum = m3.momentum    # 更新参数
# 更新均值
ex_new = (1 - momentum) * ex_old + momentum * obser_mean
# 更新方差
var_new = (1 - momentum) * var_old + momentum * obser_var
# 打印
print('ex_new:',ex_new)
print('var_new:',var_new)

#>
ex_new: tensor([2.0024, 2.0015, 2.0007], device='cuda:0')
var_new: tensor([1.5024, 1.4949, 1.5012], device='cuda:0')
我们不调用归一化函数,自己编写训练阶段的归一化代码:
# 输入数据的均值
obser_mean = torch.Tensor([input3[0][i].mean() for i in range(3)]).cuda()
# 输入数据的方差
obser_var = torch.Tensor([input3[0][i].var() for i in range(3)]).cuda()
# 编码归一化
output3_source = (input3[0][0] - obser_mean[0])/(pow(obser_var[0] + m3.eps,0.5))
output3_source

#>
tensor([[-0.2427, -1.0955,  0.1508,  ..., -0.3592, -0.1249, -0.3897],
        [ 0.2529,  0.2779,  0.7876,  ...,  1.1154,  0.3277, -1.2382],
        [-0.8262, -1.1531, -0.5061,  ...,  0.9323, -0.5061, -0.4755],
        ...,
        [-0.2884, -1.3652, -0.4635,  ...,  1.6416,  0.4805, -0.1847],
        [ 0.3757, -0.6458,  0.4820,  ...,  2.7383,  1.8410,  1.7004],
        [ 0.8154, -0.5735,  0.1654,  ...,  1.0480,  1.0176,  0.5067]],
       device='cuda:0')
结果一致,我们输出模型的running_mean和running_var:
m3.running_mean,m3.running_var

#>
(tensor([2.0024, 2.0015, 2.0007], device='cuda:0'),
 tensor([1.5024, 1.4949, 1.5012], device='cuda:0'))
发现模型的running_mean和running_var和我们计算的更新均值与方差结果一致,同时通过代码我们也知道模型的running_mean和running_var是在forward()操作中更新的,训练阶段的算法实现就介绍到这,下面介绍下测试阶段归一化的算法实现。
2. 测试阶段的归一化实例
初始化归一化模型,并设置模型处于测试阶段:
# 初始化模型,并设置模型处于测试阶段
import torch
import torch.nn as nn
m3 = nn.BatchNorm2d(3, eps=0, momentum=0.5, affine=True, track_running_stats=True).cuda()
# 测试阶段
m3.eval()
# 为了方便验证,设置模型参数的值
m3.running_mean = (torch.ones([3])*4).cuda()     # 设置模型的均值是4
m3.running_var = (torch.ones([3])*2).cuda()      # 设置模型的方差是2

# 查看模型参数的值
print('trainning:',m3.training)
print('running_mean:',m3.running_mean)
print('running_var:',m3.running_var)
# gamma对应模型的weight,默认值是1
print('weight:',m3.weight)
# gamma对应模型的bias,默认值是0
print('bias:',m3.bias)

#>
trainning: False
running_mean: tensor([4., 4., 4.], device='cuda:0')
running_var: tensor([2., 2., 2.], device='cuda:0')
weight: Parameter containing:
tensor([1., 1., 1.], device='cuda:0', requires_grad=True)
bias: Parameter containing:
tensor([0., 0., 0.], device='cuda:0', requires_grad=True)
生成3通道,416行416列的输入数据
# 初始化输入数据,并计算输入数据的均值和方差
# 生成通道3,416行416列的输入数据
torch.manual_seed(21)
input3 = torch.randn(1, 3, 416, 416).cuda()
# 输入数据的均值
obser_mean = torch.Tensor([input3[0][i].mean() for i in range(3)]).cuda()
# 输入数据的方差
obser_var = torch.Tensor([input3[0][i].var() for i in range(3)]).cuda()
# 打印
print('obser_mean:',obser_mean)
print('obser_var:',obser_var)

#>
obser_mean: tensor([0.0047, 0.0029, 0.0014], device='cuda:0')
obser_var: tensor([1.0048, 0.9898, 1.0024], device='cuda:0')
归一化输入数据,并打印第一个通道的数据
# 数据归一化
output3 = m3(input3)
# 输出归一化后的第一个通道的数据
output3[0][0]

#>
tensor([[-2.9971, -3.6016, -2.7182,  ..., -3.0797, -2.9136, -3.1013],
        [-2.6459, -2.6281, -2.2668,  ..., -2.0345, -2.5928, -3.7027],
        [-3.4107, -3.6424, -3.1838,  ..., -2.1642, -3.1838, -3.1621],
        ...,
        [-3.0295, -3.7928, -3.1536,  ..., -1.6615, -2.4845, -2.9560],
        [-2.5588, -3.2828, -2.4834,  ..., -0.8842, -1.5202, -1.6199],
        [-2.2471, -3.2316, -2.7078,  ..., -2.0822, -2.1038, -2.4659]],
       device='cuda:0', grad_fn=<SelectBackward>)
自己编写测试阶段的归一化代码,结果与调用BatchNorm2d函数结果一致。
# 归一化函数实现
output3_source = (input3[0][0] - m3.running_mean[0])/(pow(m3.running_var[0] + m3.eps,0.5))
output3_source

#>
tensor([[-2.9971, -3.6016, -2.7182,  ..., -3.0797, -2.9136, -3.1013],
        [-2.6459, -2.6281, -2.2668,  ..., -2.0345, -2.5928, -3.7027],
        [-3.4107, -3.6424, -3.1838,  ..., -2.1642, -3.1838, -3.1621],
        ...,
        [-3.0295, -3.7928, -3.1536,  ..., -1.6615, -2.4845, -2.9560],
        [-2.5588, -3.2828, -2.4834,  ..., -0.8842, -1.5202, -1.6199],
        [-2.2471, -3.2316, -2.7078,  ..., -2.0822, -2.1038, -2.4659]],
       device='cuda:0')
打印模型的running_mean和running_var
# 查看模型的running_mean和running_var
print(m3.running_mean,m3.running_var)

#>
tensor([4., 4., 4.], device='cuda:0') tensor([2., 2., 2.], device='cuda:0')
由结果可知,执行测试阶段的froward函数后,模型的running_mean和running_var不改变。
小结
3. 小结
由上面例子可知:
当trainning = True,track_running_stats = True,训练阶段改变了模型的running_mean和running_var,归一化算法的均值和方差采用了模型更新前的running_mean和 running_var 。
当trainning = False,track_running_stats = True,测试阶段不改变了模型的running_mean和running_var,归一化算法的均值和方差采用了模型的running_mean和 running_var 。
其他两种情况(trainning = True,track_running_stats = False 和 trainning = False ,track_running_stats = False),小伙伴可以用上述例子去验证这两种情况的算法实现,因为这两种情况会产生较大的偏差,这里不作介绍了。
回到本文的第一个问题,为什么归一化后会出现Nan,原来由于前面的失误,造成最后一个通道的方差小于 0 ,如下红框标记的图:

欢迎扫码关注:

 6516


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


