PyTorch VS TensorFlow谁最强?这是星标15000+ Transformers库的运行结果

TensorFlow和Pytorch两种机器学习框架的比较及优缺点 TensorFlow是一个开源的机器学习框架,由Google开发并发布,它被用来构建各种类型的机器学习模型,例如图像识别、语音识别、自然语言处理等。自然语言处理:使用TensorFlow可以构建深度学习模型,例如循环神经网络(RNN)和长短期记忆网络(LSTM),用于自然语言处理任务,例如文本生成和情感分析等。选择哪一种框架,还需要根据具体的应用场景进行考虑。1. 易用性和灵活性带来的缺点是,PyTorch在大型数据集上需要额外的工作来优化它的计算效率,而且同时也影响了代码的可维护性。 阅读详情
作者 | Lysandre Debut
译者 | 陆离
出品 | AI科技大本营(ID: rgznai100)
PyTorch VS TensorFlow谁最强?
这是标星15000+ Transformers库的运行结果
 
【导语】自然语言处理预训练模型库 Transformers 实现了几种用于 NLP 任务的最先进的 Transformer 架构,如文本分类、信息提取、问题解答和文本生成等,它经常被研究人员和公司所使用,提供 PyTorch 和 TensorFlow 的前端实现。

扫码加小编微信拉你入机器学习算法群,一起交流进步;

究竟是 PyTorch 还是 TensorFlow 更有效率地训练和运行 Transformers 模型?作者对不同环境下所展现的性能进行了对比,最终的结果是,无论在 CPU 还是 GPU 上,最终两大框架的表现都差不多。
Transformers库:
https://github.com/huggingface/transformers
 
自 TensorFlow 发布以来,我们一直在致力于模型产品化的工作,并使其可以用在 TPU 上,逐步适应它的性能。
 
本文对比了我们的模型在几种环境中所展现出来的性能。在 CPU 和 GPU 上比较了 PyTorch(1.3.0)和 TensorFlow(2.0)的推断结果。出于对一些原因的考虑,本文只是关于基准测试和后续性能优化系列文章中的第一篇。此外,我们还在文档中创建了基准测试部分,随着进一步的模型研究,并在不同环境中对它们进行基准测试,该部分还将不断完善。

结果


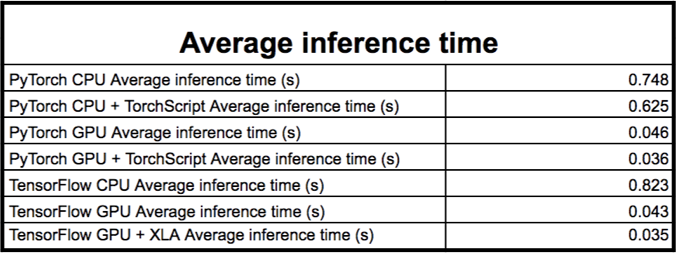
测试的平均结果显示在下表中,在接下来的讨论部分里将对这些结果进行详细介绍。
            平均推断时间

Benchmarking Transformers测试结果:https://url.cn/5hZHCll
 
电子表格中的 N/A 记录表示内存不足或是数列长度不合适。Transformer-XL(Transformer extra-long,Transformer 在模型设计上做了长度方面的延申)没有 TorchScript 结果,因为它当前不能由 TorchScript(TorchScript 是一种从 PyTorch 代码创建可序列化和可优化模型的方法)进行序列化。
 
大多数情况下,TensorFlow 和 PyTorch 的模型在 GPU 和 CPU 上都得到了非常相似的结果。下面是对结果相关的阐述,不仅是 PyTorch 和 TensorFlow 之间的比较,也是模型之间的比较。

测量推理

推理时间是模型投入生产时的一个重要指标。为了评估模型的推理时间,我们对不同批量和不同序列长度的模型进行了对比。我们比较了适当的批量大小[1,2,4,8]和序列长度[8,64,128,256,512,1024]。批量大小仍然很小,因为我们仅仅关注推断设置。BERT和其它类似模型的最大序列长度为 512 或 256(用于 CTRL),因此不能在最后一个序列长度上进行测量。
 
以下是我们在两种不同环境中的测试结果:
  • 在 CPU 上,使用 GCP n1-standard-32,它有 32 个 vCPU 和 120GB 的内存。CPU 的型号是 Intel Xeon@2.3GHz:
  • 在 GPU 上,使用了带有 12 个 vCPU、40GB 内存和一个 V100 的 GPU(16GB 的    VRAM)的定制 GCP 机器;


实验细节和最佳实践

为了最大化性能,我们进行了更进一步的优化:
  
  • 上述测量使用的 Intel Xeon CPU 带有 AVX 和 AVX2 的扩展,而 TensorFlow 需要从源代码编译之后才能够利用这些扩展,所以只能这么做;
  • 我们通过使用 tf.function 和预先跟踪模型来确保我们没有使用 TensorFlow 的 eager 模式;

  • 我们比较了依赖于库和不依赖于库的工具:PyTorch的 TorchScript 和带有 GPU 的TensorFlow 的 XLA(自动聚类),后面会详细介绍这两个工具;

  • 我们使用了原生的 Python 模块 timeit 来测量推断时间。另外,用repeat=30 和 number=3 来进行每个实验。然后求出30 个值的平均数,就会得到所期望的平均推理时间。通常超过30 个值就会获得非常稳定的结果了;
  • 我们不会使用如 TFX 这样的生产环境,并且我们使用的测量模型的可调用方法是:PyTorch 的nn.module.forward 和 TensorFlow 的tf.keras.layers.layer.call;
  • 对于 TensorFlow 和 PyTorch,我们会很谨慎地使用适当的 CUDA 版本;


讨论

PyTorch 和 TensorFlow


在大多数情况下,这两个框架都会得到类似的结果,与 PyTorch 相比,TensorFlow 在CPU 上的速度通常会稍慢一些,而在 GPU 上的速度则稍快一点:
  
  • 所有的模型中,在 CPU 上,PyTorch 的平均推断时间为 0.748s,而 TensorFlow 的平均推断时间为 0.823s;

  • 所有模型中,在 GPU 上,PyTorch 的平均推断时间为 0.046s,而 TensorFlow 的平均推断时间为 0.043s;

这些结果通过计算平均值来比较所有模型的推断时间。因此,输入值越大,对最终结果的影响就越大。当输入值过大时,PyTorch 就会耗尽内存;当计算平均值时,这些结果会从所有度量中删除,因为这样会使结果向 PyTorch 倾斜。
 
运行过程中,PyTorch 模型往往比 TensorFlow 模型更早地耗尽内存:除了Distilled 模型之外,PyTorch 在输入批量大小达到 8 以及序列长度达到 1024 时会耗尽内存。

TorchScript


TorchScript 是PyTorch 用来创建可序列化模型的一种方法,可以在不同的运行时间上运行,而不需要 Python 的依赖包,如 C++ 环境。我们的测试是通过在Python 中跟踪模型并在相同的环境中重用这个跟踪模型来完成的。我们通过预先执行前向传递以确保在测量其推断之前来跟踪模型。
 
免责声明:虽然 TorchScript 并不是为了在 Python 环境中提高运行速度而创建的,但是我们的结果表明,使用 TorchScript 的跟踪模型可以提高性能。
 
TorchScript 似乎非常依赖于模型以及输入的大小(批量大小*序列长度)。例如,在XLNet 上使用 TorchScript 可以获得永久性的性能提升,而在 XLM 上使用 TorchScript 则可能会出现问题,因为它在较小输入下才会提高性能,但在较大输入下反而会降低性能。
 
平均来说,使用 TorchScript 跟踪模型的推断速度比使用相同 PyTorch 非跟踪模型的推断速度快 20%。

XLA

XLA 是一个线性代数编译器,它可以提高 TensorFlow 模型的速度,但我们只能在 GPU上使用。它基于TensorFlow 的自动聚类,编译了模型的一些子图。
 
这些结果在速度和内存的使用效率方面得到了提高:大多数内部基准在启用了XLA 后运行速度提高了 1.15 倍。
 
在启用 XLA 后,我们所有模型性能都得到了提高。在某些极端情况下,特别是在较小输入的情况下,推断时间可以减少 70%。

模型及其精炼版本

精炼模型版本在这个测试中表现出色,因为它可以很快就进行基准测试。这两个 Hugging Face-engineered 模型——DistilBERT 和 DistilGPT-2 的推断时间比它们的老师模型减少了一半。

贡献

由于不同的基准测试有不同的设置和相应的工具,这些都不是靠一个组织所能实现的,因此我们也欢迎来自广大社区的基准。Github用户 @tlkh 已经通过在 TensorFlow 的模型上使用 AMP、XLA 和分布式策略实现的基准测试性能做出了重大的贡献,目前也被添加到文档的基准测试部分。


如何做贡献


如果你愿意参与,我们已经在 Github 上设置了主题模板,这样操作起来就会更简单一些。你可以随意打开已有结果的主题,或者打开一个请求并到文档的基准测试部分进行添加。

基准测试脚本


和本文的发布和文档中的基准测试页一起,我们在示例部分添加了一个新脚本:benchmarks.py,它是用于获取下面详细结果的脚本。它可以使用XLA 或 TorchScript 在 TensorFlow 或 PyTorch 上运行基准测试,并将结果保存到 CSV 文件当中。

接下来的计划

对模型进行基准测试只是提高性能的第一步。我们相信这篇介绍性的文章可能有助于比较模型的当前状态,特别是在研究 PyTorch 和 TensorFlow 之间的差异时。当我们深入研究 Transformers 生产方面时,一定会致力于性能改进。
 
对于 Pythorch 和 TensorFlow 的自动化脚本、新架构和定制 TPU 培训,请密切关注后续文章。
原文链接:
https://medium.com/huggingface/benchmarking-transformers-pytorch-and-tensorflow-e2917fb891c2

(*本文为 AI科技大本营编译文章)

2023-2024深度学习框架之争——选pytorch还是tensorflow? 深度学习是人工智能领域的一个重要分支,它利用多层神经网络来模拟人类的学习和推理能力,解决各种复杂的问题,如图像识别、自然语言处理、语音识别、推荐系统等。深度学习框架是一种软件工具,它提供了构建、训练、测试和部署深度学习模型的便利,使得开发者和研究者可以更高效地进行深度学习的开发和应用。目前,市场上有许多不同的深度学习框架,如PyTorch、TensorFlow、Keras、MXNet、Caffe2等,它们各有优劣,适用于不同的场景和需求。 阅读详情

相关推荐

TensorFlow VS PyTorch哪个更强?

TensorFlow 和 PyTorch 都是流行的深度学习框架,它们有一些共同点,例如都支持多种编程语言和硬件平台,也都提供了丰富的工具和库来支持深度学习模型的构建、训练和部署。

AI时代光年 2800

PyTorch、TensorFlow 两者和Transformers的关系,openai,chatgpt

Transformers库是由Hugging Face开发的,它建立在PyTorch和TensorFlow之上,提供了许多预训练的Transformer模型和相关工具。PyTorch是由Facebook开发的深度学习框架,它提供了丰富的工具和API,使得构建和训练神经网络变得更加简单和高效。因此,PyTorch和TensorFlow是深度学习框架,而Transformers是一个基于这两个框架之一的库,专注于提供预训练的Transformer模型和相关工具。

码农崛起 5230

4. PCIe 接口时序

在上一篇中,大致介绍IPcore接口。总的来说接口如下图数据的接收和发送通过transmitTLPinterface和ReceiveTLPinterface。收发数据的时序也只是描述这几个接口的关系。从手册上截取PCIex1的接口时序。

jjinl的专栏 6123

【LLM】概念解析 - Tensorflow/Transformer/PyTorch

本文将从算法原理、适用范围、强项、知名大模型的应用、python 调用几个方面,对深度学习框架 TensorFlow、PyTorch 和基于深度学习的模型 Transformer 进行比较。主要作用是基础概念扫盲。

lu_rong_qq的博客 2802

保姆级教程:将YOLOv8模型封装成Docker镜像,集成到CVAT实现自动标注

本文提供了一份详细的保姆级教程,指导如何将YOLOv8模型封装成Docker镜像并集成到CVAT平台,实现自动化标注。通过环境配置、模型服务化封装、Docker镜像构建与优化、CVAT平台集成等步骤,帮助开发者高效完成计算机视觉项目的自动标注工作流,显著提升标注效率。

weixin_28692817的博客 415

从零开始开发AI Agent:基于大模型的智能体实战指南

### 摘要 本文介绍了AI Agent的开发全流程,从基础概念到实际部署,涵盖大模型集成、工具调用和记忆系统构建等核心技术。通过电商客服案例展示实战应用,并提供调试优化与部署方案,最后展望了AI Agent的未来发展方向,帮助开发者快速掌握智能体开发技能。

ghs_gss的博客 4868

Transformer原理与代码精讲(TensorFlow)

Transformer发轫于NLP(自然语言处理),并跨界应用到CV(计算机视觉)领域。目前已成为深度学习的新范式,影响力和应用前景巨大。 本课程对Transformer的原理和TensorFlow 2代码进行精讲,来帮助大家掌握其详细原理和具体实现。 原理精讲部分包括:注意力机制和自注意力机制、Transformer的架构概述、Encoder的多头注意力(Multi-Head Attention)、Encoder的位置编码(Positional Encoding)、残差链接(Residual Connection)、层规范化(Layer Normalization)、FFN(Feed Forward Network)、Transformer的训练及性能、Transformer的机器翻译工作流程。  代码精讲部分使用Jupyter Notebook对Transformer的TensorFlow 2实现代码进行逐行解读,包括:安装TensorFlow、Transformer的数据集加载与预处理代码解读、Transformer的位置编码与多头注意力代码解读、Transformer的Transformer类代码解读、Transformer的优化器与损失函数代码解读、Transformer的训练代码解读、Transformer的推理与权重保存代码解读。相关课程: 《Transformer原理与代码精讲(PyTorch)》https://edu.youkuaiyun.com/course/detail/36697《Transformer原理与代码精讲(TensorFlow)》https://edu.youkuaiyun.com/course/detail/36699《ViT(Vision Transformer)原理与代码精讲》https://edu.youkuaiyun.com/course/detail/36719《DETR原理与代码精讲》https://edu.youkuaiyun.com/course/detail/36768《Swin Transformer实战目标检测:训练自己的数据集》https://edu.youkuaiyun.com/course/detail/36585《Swin Transformer实战实例分割:训练自己的数据集》https://edu.youkuaiyun.com/course/detail/36586《Swin Transformer原理与代码精讲》 https://download.youkuaiyun.com/course/detail/37045

Qt 6.5实战:用QMediaPlayer搞定RTSP监控流播放(附LAV Filters解码器避坑指南)

本文详细介绍了如何在Qt 6.5中使用QMediaPlayer实现低延迟RTSP监控流播放,并提供了LAV Filters解码器的配置避坑指南。通过优化缓冲策略和硬件加速设置,显著提升视频流的播放性能和稳定性,适用于工业视觉检测和安防监控等实时场景。

weixin_33712987的博客 401

PyTorch VS TensorFlow谁最强?这是标星15000+ Transformers库的运行结果

作者 | Lysandre Debut译者 | 陆离出品 | AI科技大本营(ID: rgznai100)【导语】自然语言处理预训练模型库 Transformers 实...

AI科技大本营 3138

汇川AM系列ethercat控制伺服的使用说明(含转矩模式)

本文以一个实际例子,介绍ethercat伺服驱动器的工作原理,以及在汇川AM系列PLC中,如何点动、定位、速度、转矩控制ethercat伺服。

qq_34047402的博客 5117

10.2 全栈 CRUD 工程结构搭建:Cursor 4 步初始化 + 3 层目录规范

揭示 Cursor 工程初始化中 4 个关键动作如何将 AI 上下文感知能力从 30% 提升至 85%,包括用 pnpm create 显式声明结构契约、通过 monorepo.config.json 设定 workspace 根以支持跨包类型引用、在 shared 包中固化共享类型与协议,以及后续

weixin_42545292的博客 69

2023年机器学习框架大家觉得tensorflow和pytorch哪个开发起来效率更高更容易入手呢?

从开发者使用 AI 框架来实现模型训练和推理部署的角度看,AI 框架需要能够通过动态图的编程范式,来完成在模型训练的开发阶段的灵活易用的开发体验,以提升模型的开发效率;AI求解,模型还是传统的科学计算模型,但是使用深度学习算法来求解,这个方向已经有一定的探索,目前看到不少基础的科学计算方程已经有对应的AI求解方法,比如PINNs、PINN-Net等,当然现在挑战还很大,特别是在精度收敛方面,如果要在AI框架上使用AI求解科学计算模型,最大的挑战主要在前端表达和高性能的高阶微分。支持CPU加速计算。

黑马程序员官方博客 3875

深度剖析XY2-100与SL2-100协议:解锁激光打标核心技术密码

XY2-100和SL2-100是激光打标领域的两种核心控制协议。XY2-100协议采用串行通信,指令集简单,适合常规打标任务,具有成本优势;SL2-100协议支持更高速率(1Mbps以上),具备曲线插补等高级指令,在精密加工领域表现突出。两者的主要差异体现在数据传输(帧结构、速率)、指令集(功能、数量)、参数调节(范围、精度)和错误处理机制等方面。实际应用中,XY2-100适合简单图形的大批量生产,SL2-100更胜任复杂曲面的高精度加工。选择时需综合考虑打标需求、设备兼容性和成本因素,未来两种协议将持续优

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 959

一文弄懂Pytorch TensorFlow Transformer Transformers Anaconda conda CUDA的原理以及它们之间的关系

PyTorch 和 TensorFlow 是两大深度学习框架,支持在 GPU 上使用 CUDA 加速,适合搭建和训练如 Transformer 这样的神经网络模型。Transformer 是一种强大的模型架构,广泛应用于自然语言处理和计算机视觉领域,而 Hugging Face 提供的 Transformers 库基于 PyTorch 和 TensorFlow 实现了许多预训练的 Transformer 模型,极大简化了它们的使用。Anaconda 和 Conda 则负责管理这些工具的环境和依赖,确保在同一

m0_45276337的博客 3626

〔重庆理工大学〕操作系统实验指导书【实验三 系统调用】

本实验指导书详细介绍了在Linux 0.11系统中添加两个自定义系统调用(iam()和whoami())的完整流程。实验内容包括:修改unistd.h添加系统调用号,更新sys_call_table数组,实现内核函数sys_iam()和sys_whoami(),以及编写测试程序验证功能。关键步骤涉及用户态与内核态数据传递、系统调用号分配、中断处理机制等核心概念。实验要求学习者通过修改内核源码、理解系统调用原理,最终实现名字存储与读取功能,并完成测试验证。实验还提供了视频学习资源和参考书籍,帮助深入理解操作系

Pretty Boy Fox的博客 1296

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

PyTorch 与 TensorFlow 怎么选

静态图在定义时使用了特殊的语法,就像学习一门新的语言,同时在构建静态图时需要考虑所有的情况,这导致静态图过于庞大,可能占用过多的显存,不过其运行速度相对较快。PyTorch 的设计符合人们的思维,它让用户尽可能地专注于实现自己的想法,所思即所得,不需要考虑太多框架本身的束缚。然而,作为一个还在快速发展探索的领域,人工智能研发人员实际需要的可能并没有这么复杂,他们更加希望快速地实现和尝试自己的想法,这也是为什么半路出家的 PyTorch 能够异军突起,一举成为最受欢迎的深度学习框架之一(可能没有“之一”)..

博文视点(北京)官方博客 3万+

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Tensorflow和pytorch的区别是什么?哪个更好?

另外,小普还注意到,许多教程和 MOOC 都涵盖了Tensorflow,这是因为与 Tensorflow 相比,PyTorch 是一个相对较新的框架。如果不提及 TensorBoard,这种比较将是不完整的。虽然 Tensorflow 和 PyTorch 都是开源的,但它们是由两个不同的向导创建的。免费分享一些我整理的人工智能学习资料给大家,包括一些AI常用框架实战视频、图像识别、OpenCV、NLQ、机器学习、计算机视觉、深度学习与神经网络等视频、课件源码、国内外知名精华资源、AI热门论文、行业报告等。

m0_74693860的博客 1万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Tensorflow2.0之理解语言的 Transformer 模型

项目介绍 我们将训练一个 Transformer 模型 用于将葡萄牙语翻译成英语。在此之前,建议先了解有关文本生成和注意力机制的相关内容。 Transformer 模型的核心思想是自注意力机制(self-attention)——能注意输入序列的不同位置以计算该序列的表示的能力。Transformer 创建了多层自注意力层(self-attetion layers)组成的堆栈,下文的按比缩放的点积注...

cocofisher的博客 9917

TensorFlow、PyTorch、Keras、Scikit-learn和ChatGPT。视觉开发软件工具 Halcon、VisionPro、LabView、OpenCV

选择哪种工具取决于你的需求。对于需要文本生成的应用,如自动文章写作,客户服务机器人,或者其他自然语言处理任务,ChatGPT是一个极好的选择。然而,如果你的需求是构建和训练自己的AI模型。

ZhangJiqun&191cm&85kg 1983

英伟达PyTorch优化神器TensorRT重磅更新!10亿参数大模型实时运行,GPT推理加速21倍...

视学算法报道编辑:好困 小咸鱼【新智元导读】12月2日,英伟达发布了最新的TensorRT 8.2版本,对10亿级参数模型进行了优化,让实时运行NLP应用成为可能。与原始PyTor...

zandaoguang的博客 977

加快10倍!GPT-Fast来了!使用原生 PyTorch 加速生成式 AI

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【视觉和Transformer】微信交流群扫码加入CVer知识星球,可以最快学习到最新顶会顶刊上的论文idea和CV从入门到精通资料,以及最前沿项目和应用!发论文,强烈推荐!转载自:量子位(QbitAI)PyTorch团队让大模型推理速度加快了10倍。且只用了不到1000行的纯原生PyTorch代码!项目名为GP...

阿木寺的博客 2853

GPT从入门到精通之 Tensorflow2.x 中如何使用 GPT 模型

在本篇文章中,我们将详细介绍如何使用 Tensorflow2.x 构建并使用 GPT 模型。在这个示例中,我们首先使用 GPT2Tokenizer 将输入的文本编码为 ID,然后使用 TFGPT2Model 将编码的 ID 传递给模型进行学习。首先,我们需要安装 Tensorflow2.x 和 Transformers 库(该库是一个用于构建和使用自然语言处理模型的 Python 库)。在安装完成 Tensorflow2.x 和 Transformers 库之后,我们需要配置 GPT 模型的参数。

Debug_Snail的专栏 1292

GPT模型介绍并且使用pytorch实现一个小型GPT中文闲聊系统

文章目录GPT模型介绍无监督训练方式模型结构微调下游任务输入形式GPT-2GPT-3pytorch实现一个小型GPT中文闲聊系统 GPT模型介绍 GPT与BERT一样也是一种预训练模型,与BERT不同的是,GPT使用的是Transformer的Decoder结构。在大量没有标号的数据上训练出一个预训练模型,然后少量有标号的数据上微调训练一个中下游任务的模型。在微调的时候构造与任务相关的输入,就可以很少地改变模型的架构。 无监督训练方式 使用一个标准的语言模型训练方式来进行无监督训练,就是给定一个句子,使用前

weixin_44599230的博客 1万+

chatgpt赋能python:Python如何利用GPU加速?

本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一角。作为通用的Aigc大模型,只是展现它原本的实力。对于颠覆工作方式的ChatGPT,应该选择拥抱而不是抗拒,未来属于“会用”AI的人。🧡AI职场汇报智能办公文案写作效率提升教程 🧡专注于AI+职场+办公方向。下图是课程的整体大纲下图是AI职场汇报智能办公文案写作效率提升教程中用到的ai工具。

vacvefito的博客 748

GPT-2解读(论文 + TensorFlow实现)

GPT-2是对GPT的一个升级,并且更着重于将思路放在为何pretrain是有用的上面,认为LM本身是一个Multi-task Learner,并且大力用ZSL实验来佐证这个思路。

Magical_Bubble的博客 1万+

【ChatBot开发笔记】GPT2模型的导入、使用和分析,模型训练

Transformers是一个先进的NLP框架,适用于pytorch和tensorflow2.0,这边使用的GPT2框架是一个OpenAI的先进技术,在上下文连贯性和情感表达上有相当好的表现,实际使用时可以直接从transformer库导入: from transformers.models.gpt2.modeling_gpt2 import GPT2Config, GPT2LMHeadModel 其实OpenAI还推出了GPT3——1750亿的参数和千万级别的算力需求就不是笔记本显卡带的动的了。GPT2有

qq_44776055的博客 4402
上一篇: 读书无用论?那个卖猪肉的北大毕业生,曾经受尽嘲讽,现在身价过亿了
下一篇: 方便!Jupyter Notebook自动补全
机器学习算法那些事
博客等级 码龄9年 1633粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值