利用python加selenium模拟浏览器爬取百度爱企查企业详细信息

python爬虫 爬取爱企查公司信息 python爬虫、 爬取爱企查公司信息、投机取巧 阅读详情
AI摘要

本文介绍了一个Python爬虫项目,通过PhantomJS模拟浏览器行为,从百度爱企查平台抓取企业的详细工商注册信息。首先在搜索结果中获取公司pid,然后构建详情页URL,利用PhantomJS访问并解析页面,提取所需数据,包括法定代表人、经营状态、注册资本等关键信息。这种方法适用于低频爬虫,虽然速度较慢但稳定性高。

说明

本人不是什么爬虫大佬,只是最近在做一个项目的时候需要根据企业的名称把企业的信息爬取下来,例如营业执照、工商注册号等。在网上找了很多的信息与资源,都不是很符合我们的需求,是一种比较低频的爬虫需求,最开始是在企查查上面做的爬虫,但是这个平台经常需要登录,造成我们经常访问失败(其实也是楼主不会在爬虫的时候绕过登录😂)。
后来就在百度的爱企查平台进行爬虫,毕竟大平台,对我们这种低频的爬虫容忍很大,目前为止没有产生需要登陆的情况。刚开始参考了一篇优快云博客,

这篇文章爬取到的是搜索到的企业列表,获取到的是列表里面的一些简单信息,并不能获取到企业的更详细的信息,例如工商注册号等,后来自己在这个基础上进行了改进,可以爬取到所有的信息了
以苏宁为例,文章爬取的列表信息:
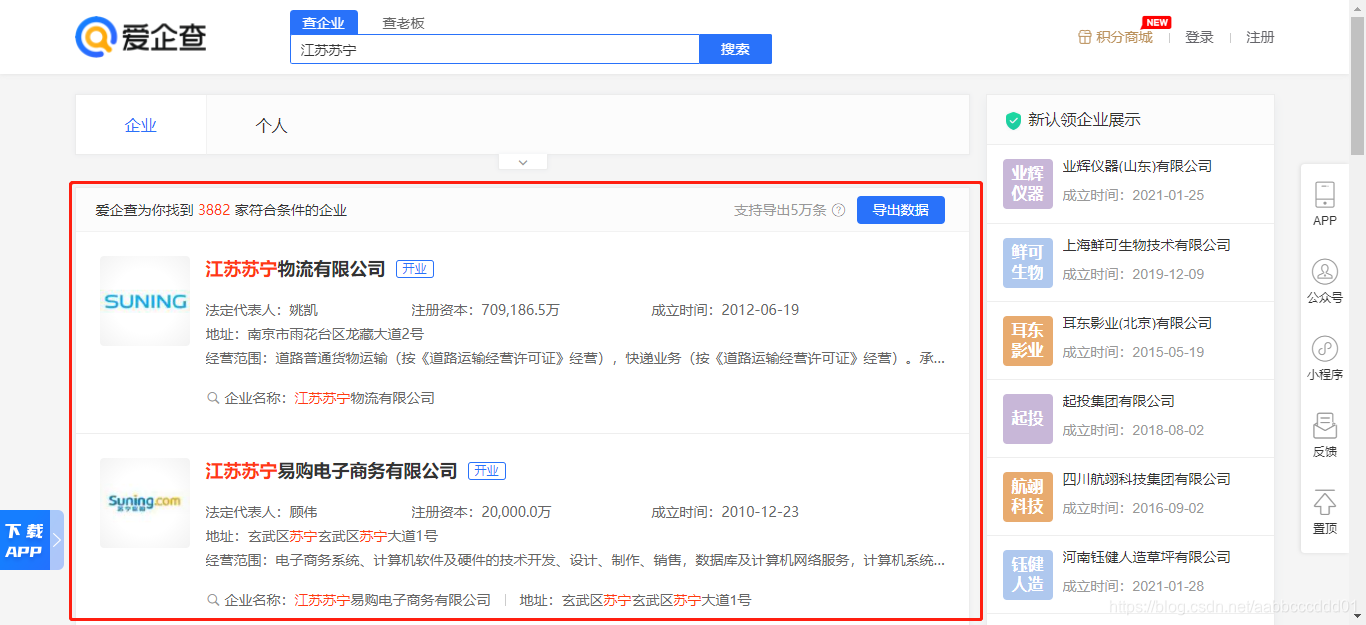
企业列表信息
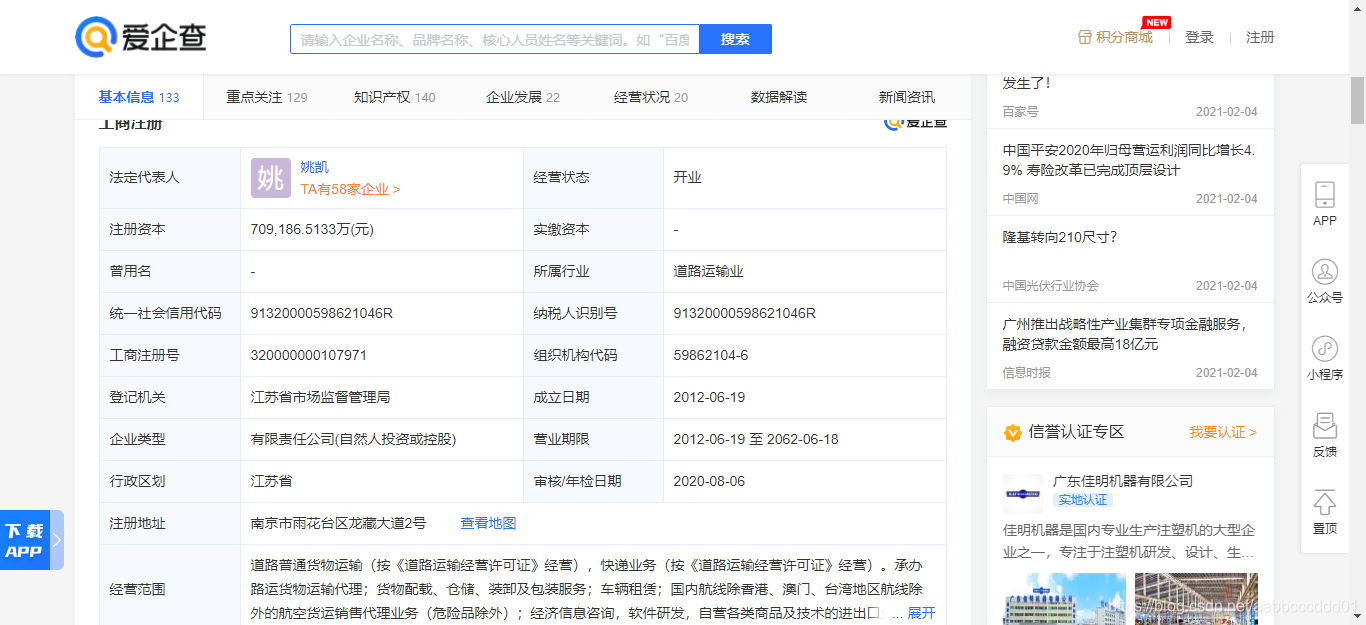
点进列表的第一条之后获取到的详细信息:
在这里插入图片描述
而我们需要的也是工商注册这一块的详细信息,下面讲解怎么获取到这些信息。

企查查网页构成方式

网页链接方式:
大家可以去查看一下上面csdn博客的内容,公司的列表信息里每一项都带着一个pid参数,表示当前公司的访问id

https://aiqicha.baidu.com/company_detail_65922533325239

后面的65922533325239就是搜索列表第一条所对应的访问链接。通过这样的方式构建链接查看企业信息详情。
打开页面之后,我们可以看到在谷歌浏览器的源码页面对应的信息是查看不到的,也就是说网页时通过js动态生成的,网页源码里不包含界面的主要信息,因此通过简单的解析源码不能获取得到数据。
网页sources源码:
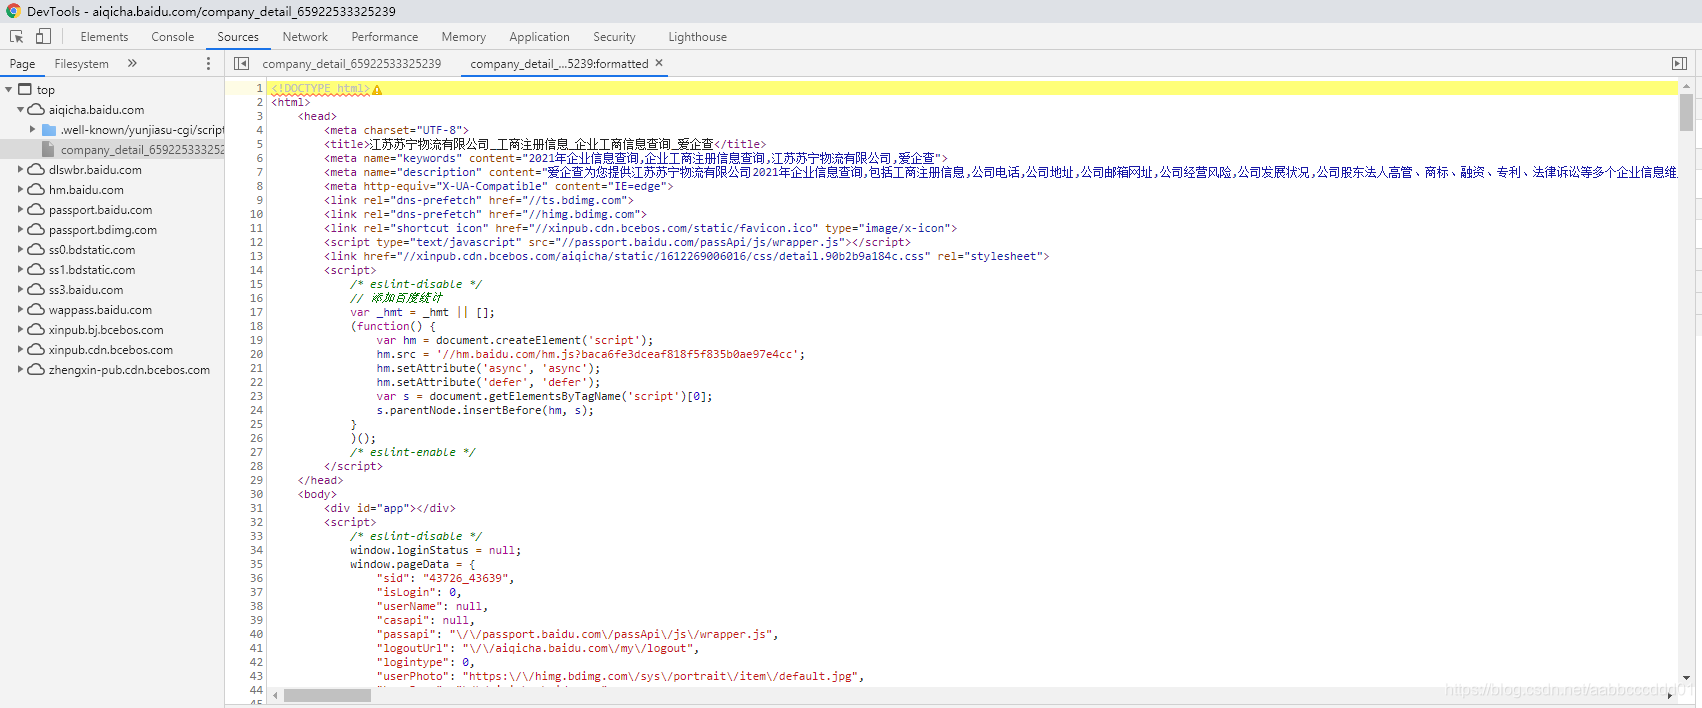
在这里插入图片描述
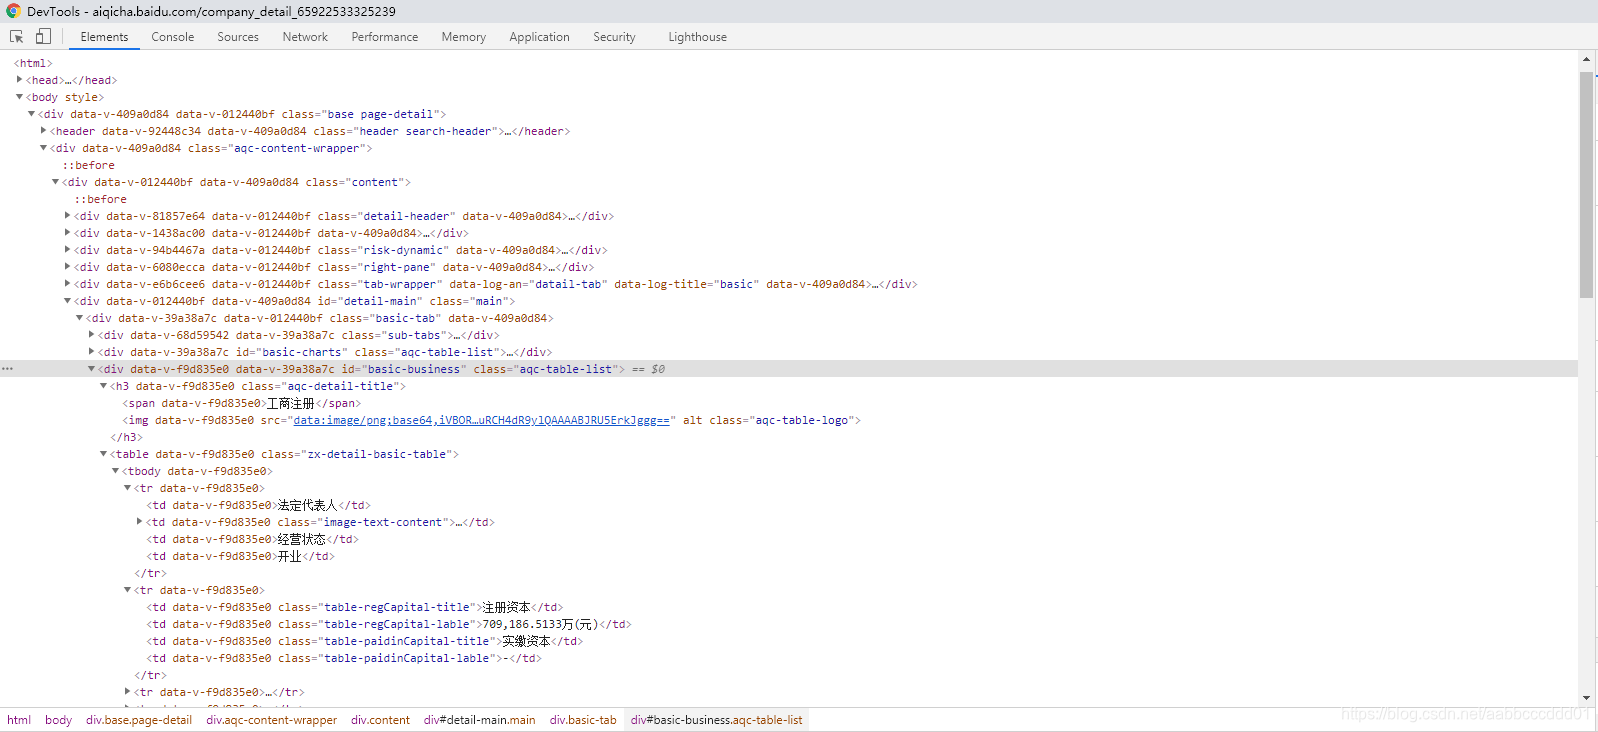
但是通过谷歌浏览器的Elements发现,对应的元素与值又显示出来了:
在这里插入图片描述
通过Python常规的网页访问方式如requets是不能获取到Elements对象的信息的,其实我也不太懂这里是什么意思,好像是由于没有加载网页?为了模拟浏览器登录获取到同样的信息,百去网上搜索之后采用PhantomJS模拟浏览器登录,这样就可以获取到我们需要的信息了,话不多说,直接看代码吧。

代码与详解

总结一下爬爬取企业信息的流程
1.先在企查查的主页搜索公司信息,获得搜索结果列表(公司名称可能相近,因此会得到很多相似的公司名搜索结果),这里我只取了搜索的第一个结果,在代码里也会注明。
2.根据搜索列表的pid参数构建点进去的得到公司的详情页面的链接
3.使用PhantomJS模拟浏览器直接访问详情页面
4,解析详情页面的标签,获取到需要爬取得数据

# -*- coding:utf-8 -*-
#爬虫获取企业工商注册信息

from selenium import webdriver
import requests
import re
import json
import os

headers = {'User-Agent': 'Chrome/76.0.3809.132'}

#需要安装phantomjs,然后将phantomjs.exe路径指定到path
path = os.path.join(os.getcwd(), 'static', 'phantomjs', 'phantomjs.exe')
# print(path)
# 正则表达式提取数据
re_get_js = re.compile(r'<script>([\s\S]*?)</script>')
re_resultList = re.compile(r'"resultList":(\[{.+?}\]),"totalNumFound')
has_statement = False


def get_company_info(name):
    '''
        @func: 通过百度企业信用查询企业基本信息
    '''
    url = 'https://aiqicha.baidu.com/s?q=%s' % name
    res = requests.get(url, headers=headers)
    if res.status_code == 200:
        html = res.text
        js = re_get_js.findall(html)[1]
        data = re_resultList.search(js)
        if not data:
            return
        company = json.loads(data.group(1))[0]
        url = 'https://aiqicha.baidu.com/company_detail_{}'.format(company['pid'])

        # 调用环境变量指定的PhantomJS浏览器创建浏览器对象
        driver = webdriver.PhantomJS(path)
        driver.set_window_size(1366, 768)
        driver.get(url)

        # 获取页面名为wraper的id标签的文本内容
        data = driver.find_element_by_class_name('zx-detail-basic-table').text
        data = data.split()
        data_return = {}
        need_info = ['法定代表人', '经营状态', '注册资本', '实缴资本', '曾用名', '所属行业', '统一社会信用代码', '纳税人识别号', '工商注册号', '组织机构代码', '登记机关',
                     '成立日期', '企业类型', '营业期限', '审核/年检日期', '注册地址', '经营范围']
        for epoch, item in enumerate(data):
            if item in need_info:
                if data[epoch + 1] in need_info or data[epoch + 1] == '-':
                    data_return[item] = None
                    continue
                if item == '法定代表人':
                    if len(data[epoch + 1]) == 1:
                        data_return[item] = data[epoch + 2]
                    else:
                        data_return[item] = data[epoch + 1]
                    pass
                elif item == '营业期限':
                    if data[epoch + 2] == '至':
                        data_return[item] = data[epoch + 1] + ' ' + data[epoch + 2] + ' ' + data[epoch + 3]
                else:
                    data_return[item] = data[epoch + 1]
        return data_return
    else:
        print('无法获取%s的企业信息' % name)


# get_company_info('江苏苏宁')

需要提前安装好phantomjs,这是一个无界面浏览器,大家可以资讯百度,将phantomjs.exe得路径指定到path就可以了
讲的不是很详细,但是结构比较简单,大家可以直接逐步打印信息查看爬虫过程,还是比较简单的。
这样的爬虫比较慢,一次爬虫大概5-10s,不过胜在稳定,用了这么久几乎没有出过问题。
喜欢的请一键三联👍
[1]: https://blog.youkuaiyun.com/qq_35408030/article/details/107068115

Python爬企查查网站数据的爬虫代码如何写? 在大数据时代,数据的获取与分析变得尤为重要。企业信息查询平台“企查查”作为国内领先的企业信用信息查询工具,提供了丰富的企业数据资源。对于数据科学家和工程师而言,能够从这些平台高效地抓取数据,无疑是一项重要的技能。本文将详细介绍如何使用Python编写爬虫代码,从企查查网站抓取企业数据,并探讨其中的技术难点和解决方案。 阅读详情

相关推荐

企查查企业详情爬虫(自动模拟登录企业详情页法律风险爬取)

由于爬取数据涉及到网站会员,没有会员有需求的别多虑,找老板冲啊 读取已有json文件爬取对应公司的企业数据,保存 工具: Chrome 点击下载chrome的webdriver:http://chromedriver.storage.googleapis.com/index.html 不同的Chrome的版本对应的chromedriver.exe 版本也不一样,下载时不要搞错了。如果是...

j163you的博客 1万+

企查查爬虫python实现(一)整体方法

企查查的爬虫的python实现,采用selenium模块+chromedriver驱动

qq_41900846的博客 9771

零基础用Selenium+Python爬取企查查动态加载数据(2024最新版)

本文详细介绍了2024年使用Selenium和Python爬取企查查动态加载数据的实战教程。从环境配置、动态加载破解到数据提取与反反爬策略,手把手教你如何高效获取企业信息,适合零基础开发者快速入门Python爬虫技术。

weixin_30892037的博客 503

一.(python爬虫ai企查)

在互联网领域,爬虫一般指抓取众多公开网站网页上数据的相关技术,此处不是我们说的脊椎动物,哈哈,言归正传,其实个人认为就是凭借一些小技巧,去获取一些公开的数据,反正不要钱,此前一直在用Java,最近接触了python,我也是python小白,接下来我们言归正传。......

yhyyhyyhygood的博客 5863

selenium 爬虫项目实例 爬取社保五险

1、背景 受疫情影响,2020年国家为缓解企业困难,进行社保补贴。中间社保费用多次变化。 用selenium做了爬取社保的小项目。 其中登录需要输入图片验证码,使用百度云的OCR识别功能接口 2、百度云OCR设别 百度云注册后通过身份识别可以开启“通用OCR识别”功能,每天免费5万次。虽然识别率低,勉强能用 import time from aip import AipOcr APP_ID = '你的app_id' # 修改成你的app_id API_KEY = '你的api_key' # 修改成你的a

lsnow8624的博客 1898

ptyhon 通过企查查获取统一社会信用代码,并导入到EXCEL

通过Python 自动获取企查查企业信用代码(也可以是其他的信息),并导入到excel中

菜鸡一枚 2985

用selenium库爬取爱企查体育类企业相关信息

这段代码是用于爬取爱查网(https://www.aiqicha.com)上体育类企业的相关信息,包括企业名称、信用代码、成立时间和法人代表。

2301_81334385的博客 1365

浏览器自动化工具怎么选?MCP 控制浏览器 vs Selenium 深度对比

摘要: Selenium与MCP控制浏览器是两种不同定位的自动化工具。Selenium作为主流开源框架,支持多语言、多浏览器及复杂场景(如测试、爬虫),扩展性强但需编程基础;MCP工具则适合零代码用户完成简单操作(如点击、打开网页),功能局限且兼容性差。核心建议:除临时性基础任务外,优先选择Selenium——学习成本可控,且能覆盖长期需求,职业适配性更高。示例代码显示,Selenium仅需3行即可实现基础操作,新手友好。

wanhuiba3269的博客 1342

企查查之企业信息查询自动化

1、今天主管提了个需求,需要查询上海市公布一批高新技术企业的基本 信息,名单大概有2890个,名单地址 http://stcsm.sh.gov.cn/gk/tzgq/gqgg/bsgqgg/jtgq/153798.htm 2、下载打开一看,pdf格式是这样子的,112页,这也不能直接用啊, 3、打开Chrome,搜索pdf 转 excel,成功将pdf 文件转换成了112个excel 表 继续搜索:python将Excel 表合并,csdn上大佬教程很多,天下代码一大抄, 不抄白不抄。 ...

Tangjes的博客 1万+

python爬取企查查公司工商信息

爬取企查查网站上公司的工商信息,路径大家根据自己情况自行修改,然后再在工程路径下创建个company.txt,里面输入想要爬取的公司名,就会生成该公司的工商信息网页。

python爬虫爬取企查查公司工商信息

爬取企查查网站上公司的工商信息,路径大家根据自己情况自行修改,然后再在工程路径下创建个company.txt,里面输入想要爬取的公司名,就会生成该公司的工商信息网页。

python 爬虫中selenium 爬取数据 csv储存思路加代码

爬虫这行运到一点加密问题就难了一b,加密处理要么破解,要么模仿人为操作,下面给大家分享下简单的selenium的一个小项目进入网站首页 会出现这类的提示,如果用平常不能得到想要的数据文本,要模仿人为操作点击确定按钮, 最终获取是文本中企业数据内容 直接上代码 代码中有time间隔睡眠等待数据加载 其实最好用WebDriverWait来等待加载(自己写的小demo 这些东西了解下流程) from selenium import webdriver import time import random

hou9876543210的博客 2053

基于Python的企查查爬虫,爬取完整的公司数据+源代码+文档说明

# Python_Crawler_Qichacha 基于Python的企查查爬虫,爬取完整的公司数据 -------- 该资源内项目源码是个人的毕设,代码都测试ok,都是运行成功后才上传资源,答辩评审平均分达到96分,放心下载使用! <项目介绍> 1、该资源内项目代码都经过测试运行成功,功能ok的情况下才上传的,请放心下载使用! 2、本项目适合计算机相关专业(如计科、人工智能、通信工程、自动化、电子信息等)的在校学生、老师或者企业员工下载学习,也适合小白学习进阶,当然也可作为毕设项目、课程设计、作业、项目初期立项演示等。 3、如果基础还行,也可在此代码基础上进行修改,以实现其他功能,也可用于毕设、课设、作业等。 下载后请首先打开README.md文件(如有),仅供学习参考, 切勿用于商业用途。 --------

爬取天眼查数据 附代码

摘要: 一、常规抓包分析 比如要爬取企业注册信息查询_企业工商信息查询_企业信用信息查询平台_发现人与企业关系的平台-天眼查该页面的基础信息。 通过火狐浏览器抓包,可以发现,所要数据都在下图的json文件里 查看其请求 伪装成浏览器爬取该文件: 伪装成浏览器爬取该文件: import requests header = { 'Host': 'www. 一、常规抓包分析 比如要爬取企

hzp666的博客 3万+

告别有线:用PVE直通无线网卡,打造一台真正的‘无线’Win10软路由/测试机

本文详细介绍了如何通过PVE直通无线网卡技术,构建全无线Win10软路由或测试机。从硬件选型、PVE环境配置到PCIe和USB双模直通技术,逐步指导实现Wi-Fi AP和蓝牙连接功能,为家庭实验室和小型办公环境提供灵活高效的网络解决方案。

weixin_28683689的博客 587

Windows 游戏 EXCEPTION_ACCESS_VIOLATION 修复:3类硬件问题与5步软件排查法

本文提供Windows游戏EXCEPTION_ACCESS_VIOLATION错误的终极修复指南,涵盖3类硬件问题(内存故障、显卡问题、超频不稳定)和5步软件排查法(文件验证、驱动更新、DEP调整等),帮助玩家彻底解决0xFFFFFFFFFFFFFFFF内存访问冲突问题。

weixin_31856057的博客 2448

python爬虫--selenium的理解以及使用(六)

文章目录前言一、selenium简介二、使用步骤1.引入库2.读入数据总结 前言 关于一个页面是否是动态加载(Aajax)数据的判断方法⭐⭐ 动态加载数据意味着直接对网址进行请求是无法直接拿到页面数据的,我们可以通过网页上的抓包工具定位到network对网页进行请求,并查看网页上的某个数据是否在network请求页面加载的数据页中 步骤详解 动态加载的数据是如何来的? 一、selenium简介 selenium模块和爬虫之间具有怎样的关联? 便捷的获取网站中动态加载的数据 边

HG0724的博客 1万+

【紫光同创PG2L200H开发板】盘古200Pro+开发板(MES2L676-200HP)

开发板 SMA接口符合标准 SMA 接口规范,可使用”内螺旋+插针“的 SMA 线连接板卡”外螺旋+插孔”的 SMA 接口进行通信,板卡 SMA 接口与 FPGA 的 HSST 收发器的一路 RX/TX 相连,TX信号和 RX 信号都是以差分信号方式通过隔直电容连接 FPGA 和 SMA 接口, TX 发送和 RX 接收数据速率高达 6.6Gb/s。为了减轻带电插拔造成对 FPGA 芯片的损坏,在设计上在 JTAG 信号位置添加了保护二极管来保证信号的电压在 FPGA 接受的范围,避免 FPGA 的损坏。

MYMINIEYE的博客 2885

百度百聘企业简单信息获取

百度百聘企业简单信息获取背景思路完整代码代码解析免责声明

帅帅de三叔 1099

华为OD机试双机位C卷:挑选宝石 (C/C++/Python/JAVA/JS/GO)

华为OD机试双机位C卷 挑选宝石,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解。华为OD机试-挑选宝石,华为OD机考-挑选宝石。

qq_45776114的博客 1500

【AutoSAR】【WdgM】WdgM安全管理模块

一、WdgM在AutoSAR里的整体架构 WdgM是在autosar架构里位于服务层的一个基础软件模块;主要监督程序的执行; 主要包括三个模块: 看门狗管理器(WdgM) 看门狗接口(WdgIf) 看门狗驱动(Wdg) 二、三种监督机制 Alive监控-------主要监控周期性软件程序的时间 DeadLine监控-------主要监控非周期软件程序 程序流监控-------主要监控程序流执行的正确性 三、基于全局状态的检测流程 受监管实体(SE):Supervised Ent

专注汽车软件开发、AutoSAR、车载以太网、SOA、EE架构。 2993

记录一次利用python调用chrome爬取天眼查网址工商信息的过程

1.首先准备工作: 1.pyhton3.6(官网有下载)。https://www.python.org/downloads/release/python-363/ 2.pycharm 2017 开发工具。(官网有下载,破解方法百度)。 下载地址:https://www.jetbrains.com/zh/pycharm/specials/pycharm/pycharm.html 破解方法参考:htt...

1万+

2025年7月5日全国青少年信息素养大赛Python编程初中组复赛真题+答案解析

2025年7月5日全国青少年信息素养大赛Python编程初中组复赛真题+答案解析

伶俐角少儿编程 466

node.js 爬虫 登录验证码_企查查爬虫

链接:https://pan.baidu.com/s/14OMqMjZPeMum8JKfajXZZA 提取码:ma5v伸手党的福利,这是爬虫的文件,运行qcc.py,另个py文件是用来拖动验证码的。程序需要输入的是一个公司名称的列表文件,由于我也是初学,所以程序写的一般,大家凑合看吧。下面是爬虫的相关背景以及思路介绍:同学在证券公司上班,需要企查查的一些信息,他给了我一个公司名称的表格,找我帮忙做...

weixin_39968309的博客 608

5.1 rocr-runtime libhsakmt event 机制全景—从 Doorbell 到 Signal

本文介绍了ROCm/KFD中的Event机制架构,主要解决GPU异步计算中的反馈问题。Event机制分为三层:硬件层触发事件,内核层管理事件通知,用户态接收处理。事件类型分为三大类:同步类事件(如SIGNAL、QUEUE_EVENT)用于任务完成通知,异常类事件(如MEMORY、HW_EXCEPTION)报告错误,拓扑类事件(如NODECHANGE)处理设备变更。该机制通过共享内存和中断实现高效通信,避免CPU轮询开销。后续文章将深入内核实现、Thunk层封装和多队列完成检测实战。

图形/计算GPU的驱动与虚拟化技术分享园地 1307

创龙 瑞芯微 RK3588 国产2.4GHz八核 工业开发板—ISP图像处理开发案例

创龙科技研发的 TL3588-EVM 评估板具备强大视频处理能力,可满足多场景视频开发需求。为助力开发者快速上手,本文整理 7 个实用视频开发案例,涵盖从采集到显示的全流程,详细说明各案例的硬件连接、参数配置与代码解析,帮助开发者高效实现评估板视频相关功能开发与调试。

创龙,嵌入式一体化解决方案商 209
上一篇: Labelimg标注工具汉化及32位、64位可执行exe文件下载
下一篇: ubuntu linux更新gilbc导致大部分命令都用不了的解决办法
小小码农、、、
博客等级 码龄8年 156粉丝 14原创
评论 17
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值