统计Python常用英文单词

使用Python+NLTK实现英文单词词频统计 使用Python+NLTK实现英文单词词频统计使用PythonNLTK实现英文单词词频统计 应用场景 Fork Me 参考运行环境 流程步骤图 详细步骤 读取文件 过滤特殊符号以及还原常见缩写单词 分词 词形还原 NLTK 单词的TAG 词形还原 统计词频 结果写入文件应用场景本人近来想要提高英语水平,决定从直接看英文书籍开始做起,在选择英文书的时候,我需要了解这本书的词汇量以及词频,这样在遇到生词 阅读详情

0、原理

  1. 从Python安装目录开始,遍历文件
  2. 从源码中提取合法英文单词
  3. 使用爬虫获取百度翻译的中文解释

1、统计统计Python常用英文单词

1.1、代码

import os, re, sys
from nltk.corpus import wordnet  # 过滤非英文单词,需要下载
from collections import Counter
c = Counter()

def extract_eng(text):
    global c
    eng_ls = re.findall('[a-zA-Z]{5,}', text)
    c += Counter([eng.lower() for eng in eng_ls if wordnet.synsets(eng)])

def traversal(path):
    for file_name in os.listdir(path):
        extract_eng(file_name)  # 收集文件名中的单词
        abs_path = os.path.join(path, file_name)
        if os.path.isdir(abs_path):
            traversal(abs_path)
        elif os.path.isfile(abs_path):
            print(abs_path)
            with open(abs_path, encoding='utf-8') as f:
                try:
                    text = f.read()
                    extract_eng(text)  # 收集文件中的单词
                except UnicodeDecodeError as e:
                    print('\033[031m', e, '\033[0m')

def shortest(ls=sys.path):
    min_path = '_' * 99
    for path in ls:
        if len(path) < len(min_path):
            min_path = path
    return min_path

def main():
    from time import time
    import pandas as pd
    t = time()
    root = shortest()  # Python安装目录
    traversal(root)
    most = c.most_common(30000)  # 保存3万个词
    pd.DataFrame(most).to_excel('words.xlsx', columns=['word', 'frequency'], index=False)
    print(time() - t)

if __name__ == '__main__':
    main()

1.2、算法拆解

1.2.1、递归遍历目录

import os
def traversal(path):
    for file_name in os.listdir(path):
        abs_path = os.path.join(path, file_name)
        if os.path.isdir(abs_path):
            traversal(abs_path)
        elif os.path.isfile(abs_path):
            print(abs_path)
traversal(os.path.dirname(__file__))  # 测试:遍历打印当前目录

1.2.2、词频统计

from collections import Counter
import jieba.posseg as jp
counter = Counter()
posseg = jp.cut(text)
for p in posseg:
    """自定义过滤条件"""
    counter[(p.word, p.flag)] += 1
most = counter.most_common()
print(most)
# 写入Excel
import pandas as pd
pd.DataFrame([(m[0][0], m[0][1], m[1]) for m in most], columns=['word', 'flag', 'frequency'])\
    .to_excel('word_count.xlsx', index=None)

1.2.3、提取列表中最短字符串

def shortest(ls=sys.path):
    min_path = '_' * 99
    for path in ls:
        if len(path) < len(min_path):
            min_path = path
    return min_path
print(shortest(['abc', 'ab', 'aaa']))  # 测试,返回最短的'ab'

1.2.4、判断是否为英文单词

from nltk.corpus import wordnet  # 可过滤非英文单词,需要下载
words = ['python', 'ipython']
for word in words:
    print(word, 'is EN') if wordnet.synsets(word) else print(word, 'is not EN')

1.2.5、英文停词过滤

# from nltk.corpus import stopwords
# print(stopwords.words('english'))
stopwords = [
    'i', 'me', 'my', 'myself', 'we', 'our', 'ours', 'ourselves', 'you', "you're", "you've", "you'll", "you'd", 'your',
    'yours', 'yourself', 'yourselves', 'he', 'him', 'his', 'himself', 'she', "she's", 'her', 'hers', 'herself', 'it',
    "it's", 'its', 'itself', 'they', 'them', 'their', 'theirs', 'themselves', 'what', 'which', 'who', 'whom', 'this',
    'that', "that'll", 'these', 'those', 'am', 'is', 'are', 'was', 'were', 'be', 'been', 'being', 'have', 'has', 'had',
    'having', 'do', 'does', 'did', 'doing', 'a', 'an', 'the', 'and', 'but', 'if', 'or', 'because', 'as', 'until',
    'while', 'of', 'at', 'by', 'for', 'with', 'about', 'against', 'between', 'into', 'through', 'during', 'before',
    'after', 'above', 'below', 'to', 'from', 'up', 'down', 'in', 'out', 'on', 'off', 'over', 'under', 'again',
    'further', 'then', 'once', 'here', 'there', 'when', 'where', 'why', 'how', 'all', 'any', 'both', 'each', 'few',
    'more', 'most', 'other', 'some', 'such', 'no', 'nor', 'not', 'only', 'own', 'same', 'so', 'than', 'too', 'very',
    's', 't', 'can', 'will', 'just', 'don', "don't", 'should', "should've", 'now', 'd', 'll', 'm', 'o', 're', 've', 'y',
    'ain', 'aren', "aren't", 'couldn', "couldn't", 'didn', "didn't", 'doesn', "doesn't", 'hadn', "hadn't", 'hasn',
    "hasn't", 'haven', "haven't", 'isn', "isn't", 'ma', 'mightn', "mightn't", 'mustn', "mustn't", 'needn', "needn't",
    'shan', "shan't", 'shouldn', "shouldn't", 'wasn', "wasn't", 'weren', "weren't", 'won', "won't", 'wouldn', "wouldn't"
]

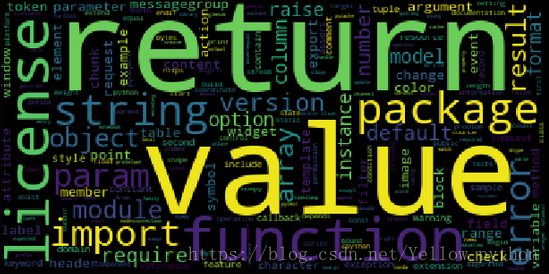
1.3、结果可视化

在这里插入图片描述

2、单词翻译

2.1、代码

import requests, pandas as pd
from random import choice, randint
from time import sleep
UA = [
    'Mozilla/5.0(compatible;MSIE9.0;WindowsNT6.1;Trident/5.0;',  # IE9.0
    'Mozilla/4.0(compatible;MSIE8.0;WindowsNT6.0;Trident/4.0)',  # IE8.0
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT6.0)',  # IE7.0
    'Mozilla/4.0(compatible;MSIE6.0;WindowsNT5.1)',  # IE6.0
    'Mozilla/5.0(Macintosh;IntelMacOSX10.6;rv:2.0.1)Gecko/20100101Firefox/4.0.1',  # Firefox4.0.1–MAC
    'Mozilla/5.0(WindowsNT6.1;rv:2.0.1)Gecko/20100101Firefox/4.0.1',  # Firefox4.0.1–Windows
    'Opera/9.80(Macintosh;IntelMacOSX10.6.8;U;en)Presto/2.8.131Version/11.11',  # Opera11.11–MAC
    'Opera/9.80(WindowsNT6.1;U;en)Presto/2.8.131Version/11.11',  # Opera11.11–Windows
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT5.1;Maxthon2.0)',  # 傲游(Maxthon)
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT5.1;TencentTraveler4.0)',  # 腾讯TT
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT5.1;360SE)',  # 360浏览器
    'Mozilla/4.0(compatible;MSIE7.0;WindowsNT5.1;TheWorld)',  # 世界之窗(TheWorld)3.x
    'Mozilla/5.0 (Windows NT 6.1; WOW64; Trident/7.0; rv:11.0) like Gecko']
url = 'https://fanyi.baidu.com/sug'
headers = {
    'Host': 'fanyi.baidu.com',
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:61.0) Gecko/20100101 Firefox/61.0',
    'Accept': 'application/json, text/javascript, */*; q=0.01',
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
    'Accept-Encoding': 'gzip, deflate, br',
    'Referer': 'https://fanyi.baidu.com/?aldtype=16047',
    'Content-Type': 'application/x-www-form-urlencoded; charset=UTF-8',
    'X-Requested-With': 'XMLHttpRequest',
    'Connection': 'keep-alive',
    'Content-Length': 3}
words = pd.read_excel('words.xlsx')['word'].values
dictionary = []
for word in words:
    word = str(word)
    post_data = {'kw': word}
    headers['User-Agent'] = choice(UA)
    headers['Content-Length'] = str(3 + len(word))
    try:
        js = requests.post(url, headers=headers, data=post_data, timeout=99).json()
        kv = js['data'][0]
    except Exception as e:
        kv = {'k': word, 'v': str(e)}
    print(kv)
    dictionary.append((kv['k'], kv['v']))
    sleep(randint(1, 9))
# 存
pd.DataFrame(dictionary, columns=['English', 'Chinese']).to_excel('dictionary.xlsx', index=None)

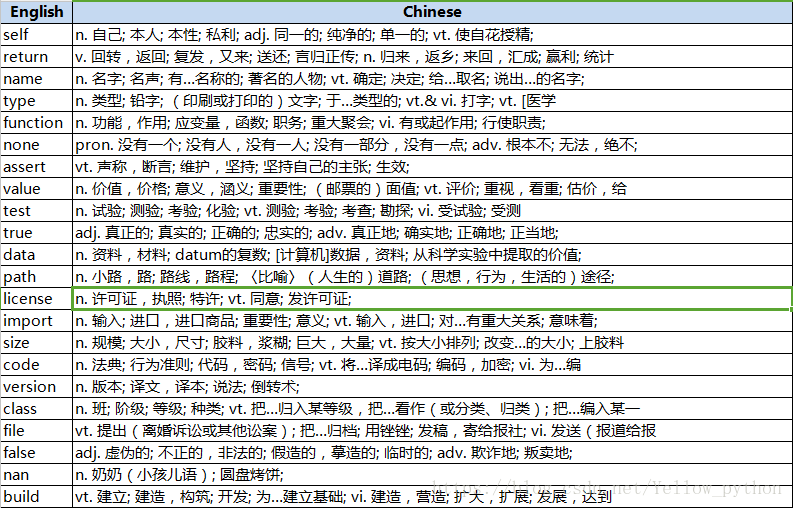
2.2、结果

  • 根据自身情况过滤一下,然后就可以开始背单词啦,哈哈哈哈。。。
    在这里插入图片描述
python英文文本词频统计,python英文文章词频统计 通过这篇文章,我们学习了如何使用Python来统计英文文本和中文小说中的词频。通过使用正则表达式来处理文本,并使用字典来存储和计算词频,我们能够更好地理解文本中的词汇使用情况。这对于学术研究、语言分析和文本挖掘都非常有帮助。 阅读详情

相关推荐

打造高效英文单词记忆系统:基于Python的实现与分析

在当今全球化的世界中,掌握一门外语已成为必不可少的技能。对于许多学习者来说,记忆大量的英文单词是一个漫长而艰难的过程。为了提高学习效率,我们开发了一个基于Python的英文单词记忆系统。这个系统结合了数据管理、复习计划、学习统计和测试练习等多个模块,旨在为用户提供了一个全面、高效的学习工具。

qq_36224726的博客 1160

Python轻松实现对英文文章单词总数统计

一篇英文文章,要统计其中单词总数。在Python中可以很轻松的实现,假如英文文章为this.txt,里面的内容就是import this这个彩蛋的内容。 &gt;&gt;&gt; import this The Zen of Python, by Tim Peters Beautiful is better than ugly. Explicit is better than implici...

杰瑞的专栏 1万+

Python: 统计英文纯文本文件中的单词出现次数

在日常的数据分析、自然语言处理等领域,需要对文本进行单词的统计分析。本篇文章介绍如何使用Python统计一个英文的纯文本文件中单词的出现次数。以上就是使用Python实现了统计英文纯文本文件中单词出现次数的方法。欢迎大家试用,并在实际应用中进行改进和优化。Python: 统计英文纯文本文件中的单词出现次数。

qq_37934722的博客 4493

史上最全python常用英语单词,建议收藏

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。大家好,又见面了,今天小编带来的是学习python常用的一些英语单词,都说学习python是比较简单,但是还是有些人担心自己学不好,觉得英语不好等等…Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

m0_58477260的博客 3907

GEO数据挖掘实战:用R语言从GSE42872数据集中找到关键差异基因(附完整代码)

本文详细介绍了使用R语言从GSE42872数据集中挖掘关键差异基因的完整流程,包括数据下载、探针ID转换、差异表达分析和功能富集分析。通过实战代码演示,帮助生信研究者掌握GEO数据挖掘的核心技术,快速识别疾病相关基因并理解其生物学功能。

weixin_42625070的博客 366

电力市场小白必看:手把手教你用Matlab实现市场出清电价计算(附完整代码)

本文为电力市场初学者提供了使用Matlab计算市场出清电价的完整指南。通过Yalmip和Matpower工具包,详细讲解了从环境配置到模型构建、求解及结果分析的整个过程,帮助读者快速掌握节点电价计算的核心技术。

weixin_30379531的博客 74

Python 常用 150 个英语单词,作为一名Python面试者你应该知道的

10、del(delete):删除11、clear:清除12、sort:排序八、集合1、set:集合/设置2、add:添加3、update:更新4、discard:丢弃5、intersection:相交6、union:联合7、difference:差数8、symmetric:对称9、in:在…里面10、not:不/不是11、disjoint:不相交12、subset:子集13、superset:父集/超集14、copy:复制九、字典1、dict:字典。

2401_83620927的博客 4567

工业视觉光源频闪控制的三种核心模式与选型实战

本文深入解析工业视觉系统中光源频闪控制的三种核心模式:光源主控、相机主控与硬同步。针对高速飞拍、缺陷检测等场景,详细对比了各模式的时序原理、硬件要求与适用场景,并提供了基于产线速度与检测需求的实战选型指南,帮助工程师有效消除运动模糊、提升成像质量与系统稳定性。

weixin_29299807的博客 441

python常用英语词汇(持续更新)

如果你也是看准了Python,想自学Python,在这里为大家准备了丰厚的免费。

m0_60607895的博客 7089

Java写项目前的准备工作指南(技术栈选择 环境搭建和工具配置 项目结构设计与模块划分)

在开始编写一个 Java 项目之前,做好充分的准备工作是至关重要的。很多初学者可能在没有清晰规划的情况下就开始编写代码,导致项目开发进度缓慢、结构混乱,甚至最终无法按预期完成。而事实上,项目的成功不仅仅取决于编码能力,还包括项目初期的规划和准备。准备工作是确保项目顺利进行的基础,它包括技术选型、环境搭建、需求分析、团队协作及项目管理等多个方面。通过这些准备,我们可以确保项目的开发不仅高效而且有可维护性,最终能交付出高质量的代码。在项目开发过程中,异常处理是非常关键的一部分。

eternal__day的博客 1188

运行时安全引擎RSE

该博客重点介绍了运行时安全引擎(Runtime Security Engine,简称 RSE)与应用处理器(Application Processor,简称 AP)之间的关系。 根据 ARM 的参考设计,RSE 是位于同一芯片(die)上的一个独立核心,与 AP 和系统控制处理器(System Control Processor,简称 SCP)并列存在。RSE 为整个系统提供基本的安全保障和运行时服务,例如:可信启动(trusted boot)、度量启动(measured boot)、平台认证(platf

AI-安全-功耗 1369

使用ntlk完成英文单词及二元词组的词频统计

NLTK是什么NLTK是Natural Language Toolkit的缩写,是Python自然语言处理领域中最流行的一款工具包。它是一款免费的、开源的、由Python编写的自然语言处理工具包。NLTK包括了众多的库和数据集可以用来完成NLP的各种任务。NLTK的历史和现状NLTK最初由宾夕法尼亚大学的计算机科学系,由Steven Bird、Ewan Klein和Edward Loper三位教授和研究员共同开发。现在NLTK已经成为了NLP领域中使用最广泛的一款自然语言处理工具包。

wangrunhahaha的博客 1383

浅谈innovus Update io latency相关作用

同样我们使用update io latency,工具取launch clock latency负值反标到clock端口上,同时认为capture clock latency与launch clock latency相等,这样可以相互抵消,这样setup time slack = T – Tsetup -Tcomb – Toutput_delay,因此采用update io latency后,reg2out timing path的setup check变得真实些。图3 in2reg示意图。

芯冰乐 478

Python:统计文件中所有英文单词的数量

#!/usr/bin/env python # coding:UTF-8 """ @version: python3.x @author:曹新健 @contact: 617349013@qq.com @software: PyCharm @file: 统计文件中所有英文单词的数量.py @time: 2019/1/1 20:12 """ import re words = {} r = r...

caoxinjian423的博客 1万+

dy创作者平台上传并发布视频

整体上来说不是很难,就是过程有点复杂。因为这个是别人给的单子,所以这里不放源码了。细致一点就可以搞定。如果要Signature算法,可私信,不免费。

记录一些web逆向的过程 1518

innovus:NRDB-2276 special net route layer与NanoRouteMode route layer冲突问题解决方法

NanoRouteMode中设置绕线层次2-6,但是被动到的special net有8-11的preferred route layer,这个层次可能是create_route_type+set_ccopt_property -net_type 定义的。二者绕线层次范围有冲突,导致在调整过这条net后再绕线就会提示失败。然后再下route_design 等route命令去绕别的net。我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?

m0_61544122的博客 1105

python英文文档_python3 怎么统计英文文档常用词?(附解释)

# coding: utf-8# In[32]:#import requests#from bs4 import BeautifulSoup#res = requests.get("http://www.guancha.cn/america/2017_01_21_390488_s.shtml")#res.encoding = 'utf-8'#soup = BeautifulSoup(res.tex...

weixin_39599097的博客 130

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

split函数python统计英文单词_Python实现统计英文单词个数及字符串分割代码

Python实现统计英文单词个数及字符串分割代码这篇文章主要介绍了Python实现统计英文单词个数及字符串分割方法,本文分别给出代码实例,需要的朋友可以参考下字符串分割代码如下:str="a|and|hello|||ab"alist = str.split('|')print alist结果复制代码代码如下:str="a hello{这里换成5个空格}world{这里换成3个空格}"alist=s...

weixin_36304087的博客 3855

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

python统计英文单词个数_统计英文单词的个数的python代码 及 字符串分割

字符串分割str="a|and|hello|||ab"alist = str.split('|')print alist结果 str="a hello{这里换成5个空格}world{这里换成3个空格}"alist=str.split(' ')print alist 统计英文单词的个数的python代码# -*- coding: utf-8 -*-import os,sysinfo = os.get...

weixin_39941732的博客 3180

【Python】1行Python代码统计文本中每个英文单词出现次数(python词频统计) | 附完整代码

今天来试一下如何利用 python 来统计文本中每个英文单词出现的次数 列出了两种方法,一种是直接调用 Counter 函数,核心代码一行搞定 另一种是手写的利用 python 中的字典来统计 1.首先将文本文件导入 文本是长这样子的 f = open(r"C:\Users\aaa\Desktop\new.txt",encoding="utf-8") a = f.read().s...

人人都是量化师的专栏 2万+

Python统计英文单词出现情况次数实验

接下来剩下的都是一些单词了,因为单词之间以空格隔开,可以通过split方法将剩余的单词转化为列表,然后遍历这个单词列表,通过字典的特性,将单词作为字典的键,单词出现的次数作为字典的值。最后获取字典的值,这时候,字典的值的从大到小的顺序,就是所对应单词的排序,我们通过lambda表达式对字典进行一个排序,然后循环输出数量前十的值所对应的单词即可。前些天发现了一个巨牛的人工智能学习电子书,通俗易懂,风趣幽默,无广告,忍不住分享一下给大家。(1)单词不区分大小写,即单词的大小写或组合形式一样;......

叶绿体不忘呼吸 6389

python统计英文单词个数_Python实现统计英文单词个数及字符串分割代码

字符串分割代码如下:str="a|and|hello|||ab"alist = str.split('|')print alist结果代码如下:str="a hello{这里换成5个空格}world{这里换成3个空格}"alist=str.split(' ')print alist统计英文单词的个数的python代码代码如下:# -*- coding: utf-8 -*-import os,sys...

weixin_39629989的博客 1992

python3 怎么统计英文文档常用词?(附解释)

# coding: utf-8 # In[32]: #import requests #from bs4 import BeautifulSoup #res = requests.get("http://www.guancha.cn/america/2017_01_21_390488_s.shtml") #res.encoding = 'utf-8' #soup ...

dnsf5926的博客 191

python英文单词词频统计_如何用python实现英文短文的双词频统计

匿名用户1级2017-05-13 回答简单版:#!/usr/bin/envpython3importreimportjiebafromcollectionsimportCounterfname='counttest.txt'withopen(fname)asf:s=f.read()pattern=re.compile(r'[a-zA-Z]+\-?[a-zA-Z]*')...

weixin_39978101的博客 342

python统计句子中单词个数_Python实现统计英文单词个数及字符串分割代码

字符串分割复制代码 代码如下:str=”a|and|hello|||ab”alist = str.split(‘|’)print alist结果复制代码 代码如下:str=”a hello{这里换成5个空格}world{这里换成3个空格}”alist=str.split(‘ ‘)print alist统计英文单词的个数的python代码复制代码 代码如下:# -*- coding: utf-8 -...

weixin_39772651的博客 3531

python统计英文单词数量_python 统计 英文 单词

import sys, os, redef count_words(text):# !num !char -> ' 'text = re.sub("\W+", " ", text)# number -> ' 'text = re.sub("[0-9]", " ", text)# shrink whitespacetext = re.sub("\s+", " ", text)return...

weixin_39735247的博客 2365
上一篇: Python【递归】遍历嵌套字典
下一篇: jieba分词,识别【带空格的词】
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值