大数据(3b)HIVE入门补充

Hive 整合 Spark 全教程 (Hive on Spark) 文章目录Hive 引擎简介环境配置 (ssh已经搭好)JDK准备Hadoop准备部署配置集群配置历史服务器配置日志的聚集启动集群LZO压缩配置Hadoop 3.x 端口号 总结MySQL准备Hive 准备Spark 准备Hive on Spark 配置Hive on Spark测试 Hive 引擎简介 Hive 引擎包括:默认 MR、tez、spark 最底层的引擎就是MR (Mapreduce)无需配置,Hive运行自带 Hive on Tez 配置:https://blog.youkuaiyun.com/we 阅读详情

                                😄
本文续:https://yellow520.blog.youkuaiyun.com/article/details/111563044

1、HIVE配置

cd $HIVE_HOME/conf
主要配置文件简述
hive-default.xml基本配置
hive-env.shHIVE环境,如:客户端内存、辅助jar的路径…
hive-log4j2.properties日志相关

1.1、建库不指定LOCATION时的默认位置

vim hive-default.xml
<property>
    <name>hive.metastore.warehouse.dir</name>
    <value>/user/hive/warehouse</value>
    <description>location of default database for the warehouse</description>
</property>

1.2、日志相关

mv hive-log4j2.properties.template hive-log4j2.properties
vim hive-log4j2.properties

HIVE日志默认存储路径(临时目录+用户名:/tmp/root)

property.hive.log.dir = ${sys:java.io.tmpdir}/${sys:user.name}

HIVE日志默认文件名

property.hive.log.file = hive.log

HIVE日志默认等级

property.hive.perflogger.log.level = INFO

2、HIVE执行MapReduce曾遇报错

2.1、用户问题

虽然能进入HIVE,但在插入数据时,才真正执行MapReduce,此时遇到报错

终端界面提示:
FAILED: Execution Error, return code 2 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask

再查YARN历史:
Error: Could not find or load main class org.apache.hadoop.mapreduce.v2.app.MRAppMaster

解决方案:https://yellow520.blog.youkuaiyun.com/article/details/115724120

2.2、内存问题

还有个报错是Container [pid=6982,containerID=container_1609054009886_0001_01_000005] is running 537283072B beyond the 'VIRTUAL' memory limit. Current usage: 103.6 MB of 1 GB physical memory used; 2.6 GB of 2.1 GB virtual memory used. Killing container

大概是说:container因内存使用超出限制而被杀掉;于是加入下面配置

vi $HADOOP_HOME/etc/hadoop/yarn-site.xml
<!-- 不 检查物理内存 -->
<property>
    <name>yarn.nodemanager.pmem-check-enabled</name>
    <value>false</value>
</property>
<!-- 不 检查虚拟内存 -->
 <property>
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>
vi $HADOOP_HOME/etc/hadoop/mapred-site.xml
<!-- Map内存,单位MB-->
<property>
    <name>mapreduce.map.memory.mb</name>
    <value>512</value>
</property>
<!-- Reduce内存,单位MB -->
<property>
    <name>mapreduce.reduce.memory.mb</name>
    <value>1024</value>
</property>
<!-- Map下Java程序最大内存 -->
<property>
    <name>mapreduce.map.java.opts</name>
    <value>-Xmx384m</value>
</property>
<!-- Reduce下Java程序最大内存 -->
<property>
    <name>mapreduce.reduce.java.opts</name>
    <value>-Xmx768m</value>
</property>

3、HIVE的三种执行方式

执行方式说明示例
hive交互界面hive
hive -e命令行hive --database '库名' -e 'SHOW TABLES'
hive -f文件模式hive -f ./hive-script.sql

4、解决HIVE中文注释乱码

加上useUnicode=true&characterEncoding=UTF-8,注意&和&amp;

vim $HIVE_HOME/conf/hive-site.xml
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>
jdbc:mysql://hadoop100:3306/metastore?useSSL=false&amp;useUnicode=true&amp;characterEncoding=UTF-8
</value>
</property>

修改mysql元数据字符集为utf-8

mysql -uroot -p123456 -Dmetastore
ALTER TABLE DBS MODIFY COLUMN `DESC` VARCHAR(4000) CHARACTER SET utf8;
ALTER TABLE COLUMNS_V2 MODIFY COLUMN `COMMENT` VARCHAR(256) CHARACTER SET utf8;
ALTER TABLE TABLE_PARAMS MODIFY COLUMN PARAM_VALUE VARCHAR(4000) CHARACTER SET utf8;
ALTER TABLE PARTITION_PARAMS MODIFY COLUMN PARAM_VALUE VARCHAR(4000) CHARACTER SET utf8;
ALTER TABLE PARTITION_KEYS MODIFY COLUMN PKEY_COMMENT VARCHAR(4000) CHARACTER SET utf8;
ALTER TABLE INDEX_PARAMS MODIFY COLUMN PARAM_VALUE VARCHAR(4000) CHARACTER SET utf8;

5、HIVE开启网络服务并使用IDEA连接

https://blog.youkuaiyun.com/Yellow_python/article/details/115944692

6、入门DDL和DML

-- 建库
CREATE DATABASE IF NOT EXISTS hjw_temp;
-- 切换库
USE hjw_temp;
-- 建表
CREATE TABLE student (s_id INT,s_name STRING)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';
-- 写数据
INSERT INTO TABLE student VALUES(1,'a1'),(2,'b3');
-- 查询
SELECT * FROM student;

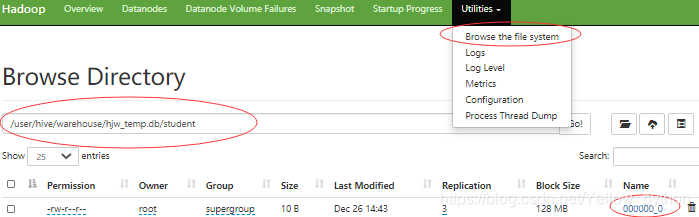
建库默认路径:/user/hive/warehouse/

去浏览器查看HDFS9870

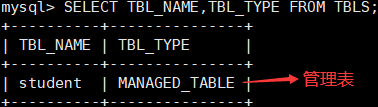
在MySQL查看

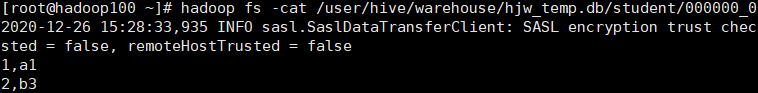
用Hadoop命令查看

-- 强制删库(若数据库不为空)
DROP DATABASE hjw_temp CASCADE;

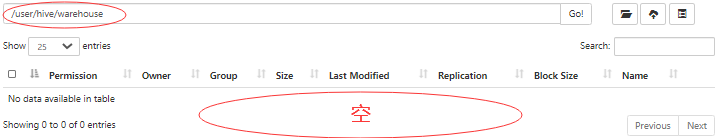
强制删库后
大数据面试题——Hive篇 1. Hive有哪些方式保存元数据,各有什么特点? Hive支持三种不同的元存储服务器,分别为:内嵌式元存储服务器、本地元存储服务器、远程元存储服务器,每种存储方式使用不同的配置参数。 内嵌式元存储主要用于单元测试,在该模式下每次只有一个进程可以连接到元存储,Derby是内嵌式元存储的默认数据库。 在本地模式下,每个Hive客户端都会打开到数据存储的连接并在该连接上请求SQL查询。 在远程模式下... 阅读详情

相关推荐

大数据领域 Hive 入门指南:从基础到实战

随着企业数据规模从TB级向PB级跨越,传统关系型数据库(如MySQL)在海量数据存储与分析场景中逐渐显现性能瓶颈。Hive作为Apache基金会旗下基于Hadoop的数据仓库工具,通过类SQL语法(HiveQL)将复杂的MapReduce任务透明化,使数据分析师无需掌握Java编程即可完成大规模数据处理。

AI天才研究院 1224

【hive】怎么解决Hive中metaData 字符集中文问题?--详细步骤

一.首先,一般常见的错误有以及几种以及他们的解决方案:1.Hive中创建数据库或者表,如下图示但是,当你去查看该数据详细信息时,中文出现了乱码,但英文不会,查看数据详情图为了解决Hive中创建表或者数据库的时候,注解等中文显示的乱码问题,需要设置MetaStore DataBase中某些字段的字符编码为utf-8二.HiveMetaStore 配置说明1. MySQL 授权(如果安装M...

wyz0516071128的博客 1750

大数据问题排查系列 - HIVE踩坑记-HIVE-15642

前言大家好,我是明哥!本片博文是“大数据线上问题排查系列”大类别之一,讲述前段时间我司某产品在某券商遇到的一个问题及解决方案,其背后涉及到 hive 的一个 BUG,在 hive 3.0 ...

明哥的IT随笔 3万+

1.4.3.3 Hive常用需知

总目录:https://www.jianshu.com/p/e406a9bc93a9 Hadoop - 子目录:https://www.jianshu.com/p/9428e443b7fd 常用命令行交互命令 [root@master ~] hive -h usage: hive -d,--define <key=value> Variable su...

寒暄的博客 319

以可视化的方式来打开大数据,tableau是如何连接到Hadoop hive的?

前言 Hadoop Hive是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供完整的SQL查询功能;可以将SQL语句转换为MapReduce任务进行运行,优点是学习成本低;可以通过类SQL语句快速实现简单的MapReduce统计,不必开发专门的MapReduce应用,十分适合数据仓库的统计分析。本文将详细介绍Tableau如何连接Hadoop Hive及其注意事项。 以下链接为博主精心整理的tableau学习教程,包含基础部分及高级教程,有需要的小伙伴可自行订阅。

wenyusuran的专栏 7474

【大数据hive】hive 拉链表设计与实现

hive 拉链表设计与实现

congge_study的博客 8024

hive sql alter table 修改表操作小记

ALTER TABLE仅仅会修改表的元数据,但是不会对表数据本身作任何修改 有全量表如下: create external table test.class_info( class string, student array<string>, user_info map<string, int>, position struct<province:string, city:string, district:string> ) row format delimi.

qq_41018861的博客 4759

【大数据Hive】hive 优化策略之job任务优化

hive job优化策略

congge_study的博客 9521

ALTER TABLE 语句

ALTER TABLE 语句 2011-07-22 11:02 ALTER TABLE 语句用于在已有的表中添加、修改或删除列。 1 . ALTER TABLE table_name  ADD column_name datatype 2.  ALTER TABLE table_name  DROP COLUMN  column_name 3. ALTER TABLE

liyanhui1001的专栏 3万+

【大数据Hive】hive 表设计常用优化策略

hive表常用优化策略

congge_study的博客 8942

【短路计算篇】短路电流计算详解:从理论到实践

短路电流是指在正常电路中电势不同的两点之间发生阻抗极小的故障而引起的过电流。短路时电流强度很大,可能达到额定电流的10-15倍,大容量电力系统中短路电流可达数万安。简单比喻:短路就像水管突然爆裂,水流瞬间增大很多倍,对管道系统造成巨大冲击。短路电流计算是电气系统设计中的基础性工作,关系到整个系统的安全运行。通过本文介绍的各种计算方法,工程师可以根据具体情况选择合适的方法进行准确计算。

2301_81299416的博客 3973

CM给hive添加自定义jar包

CM给hive添加自定义jar包

Ran 2549

CentOS7.9 安装 ImageMagick,图片转换为HEIC图像格式

由于ImageMagick7以下不支持heic等图片格式,所以重新安装了ImageMagick7.1版本支持heic格式,在网上找了很多资料,归纳总结并写此文章记录一下。在Linux(CentOS7.9)上安装ImageMagick7.1.1-38。

shmily_i的博客 1941

问我大数据怎么入门,我总结了亲身体验的学习路线推荐给她【推荐收藏】

前两天有学妹私信我说,她已经上完大一,大数据专业的,只学过大数据导论,问我大数据该如何入门?我不禁感慨普通高校擅长培养算法人才,但在工程人才的培养上存在很多的问题。

Maynor的博客 5687

Qwen2.5-7B大模型实战:从零部署到高效推理全流程解析

本文详细解析了Qwen2.5-7B大模型从零部署到高效推理的全流程。内容涵盖环境准备、模型下载、使用Transformers进行核心对话推理,并深入介绍了vLLM与TGI生产级服务部署、GPTQ/AWQ量化技术以降低显存消耗,以及llama.cpp、Ollama等本地推理方案。旨在帮助开发者快速掌握部署技巧,实现大模型在消费级硬件上的高效运行。

weixin_29061425的博客 491

首个基于LBS方案的3D传感器,VoxelSensor解析

该传感器将结合OQmented的Lissajous模式的MEMS扫描镜,与每帧逐行工作的光栅扫描相比,Lissajous轨迹扫描速度更快,并且能耗很低,它可以更快地捕获完整的场景和快速移动,并且需要更少的数据处理,可满足AR/VR对于低延迟、高效率的需求。简单来讲,Switching Pixels的区别是专注于识别激光事件,性能比普通事件相机更好,但也可以使用事件相机的算法。在具体应用中,它需要在X和Y方向发射一个或多个脉冲光束,以在X和Y轴上定位,而Z轴,也就是深度,则是通过计算光返回的时间来测量。

qingtingwang的博客 576

大数据入门-五分钟读懂Hive

最近在收集整理大数据入门文章,各位盆友关注点赞不迷路,每天都要开心鸭! 大数据入门系列文章 1.大数据入门-大数据是什么 2.大数据入门-大数据技术概述(一) 3.大数据入门-大数据技术概述(二) 4.大数据入门-三分钟读懂Hadoop 一、概念 Hive是基于Hadoop的一个数据仓库工具,用来进行数据抽取,转化,加载,这是一种可以存储,查询和分析存储在Hadoop中的大规模数据的机制。Hive数据仓库工具能将结构化的数据文件映射成一张表,并提供SQL查询功能,能将SQL语句转化成.

水坚石青的博客 1939

离线环境下 Ubuntu 22.04 制作自定义apt源 安装 Docker环境 的部署方案

本文介绍了一种在无外网环境下部署服务器项目的离线方案。通过在外网环境中制作包含APT软件包和Docker镜像的离线资源包,实现在内网环境中的完整部署。方案详细说明了离线APT源的制作方法、Docker镜像的导出/导入流程,以及内网服务器的软件安装和网络配置步骤。特别强调了版本一致性、目录结构规范和网络适配等注意事项,适用于需要严格隔离网络的生产环境部署。该方案具有可扩展性,可根据实际需求调整软件包和镜像列表。

mmx_2022的博客 654

大数据BigData之hive怎么样才能够直接读取amazon s3中的.gz文件数据呢?

在看这篇文章之前,请确保以下几件事 安装好 jdk 安装好 hadoop (记得准备好需要用到的jar包) 安装好 hive (记得配置元数据库、准备好需要用到的jar包) 配置好 hadoop 连接 amazon s3 的文件 配置好 hive 连接 amazon s3 的文件 配置好 hive 与 hadoop 之间的连接 hive怎么样才能够直接读取amazon s3中的.gz文件数...

RunFromHere的博客 1863

【乐企文件生成工程】添加数据库、SpringEvent事件支持

更新!1、乐企版式文件生成工程添加数据库支持2、乐企版式文件生成工程添加事件机制,异步处理文件生成,提高系统并发能力。

九七的博客 338

手把手教你学 MATLAB 实战训练(6.9):卷积神经网络(CNN)模型来进行图像分类任务(预训练的 ResNet-50 模型)

加载数据集数据预处理加载预训练模型修改和扩展预训练模型设置训练选项训练模型测试模型。

xiaoheshang_123的博客 646

大数据技术之Hive

大数据技术之Hive

我从不打没有准备的仗! 1万+

基于单片机的宠物狗智能项圈设计

GPS定位功能:利用GPS模块实时获取宠物的位置,帮助主人追踪宠物的活动轨迹。活动监测:使用加速度传感器监测宠物的活动情况,如运动、休息等,并进行分析。健康监测:集成心率传感器,实时监控宠物的心率,以确保其健康。声音识别功能:通过麦克风捕捉宠物的叫声,检测宠物的状态(如饥饿、疼痛等)。蓝牙/Wi-Fi通信:通过蓝牙或Wi-Fi模块与手机APP或云端平台进行数据交互,实时反馈宠物的状态信息。电池管理:实现低功耗设计,确保设备的续航能力。

2201_76125393的博客 2281

大数据BigData之Hive的结构

文章目录   1. Hive结构介绍   2. 结构描述     2.1 用户接口主要有三个:CLI,Client 和 WUI     2.2 Hive 将元数据存储在数据库中,如 mysql、derby     2.3 解释器、编译器、优化器、执行器   3. Hive 和普通 DB 的异同   4. 元数据   5. 数据存储 1. Hive结构介绍 Hive 构建在Hadoop的HDFS和...

weixin_34216036的博客 277

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大数据(3f)HIVE拉链表

什么是拉链表 HIVE实现拉链表 建表 插入数据到 每天新增和变化表 更新拉链表 首次导入 第一次更新 第二次更新

ArYe 2147

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

上一篇: 大数据(3c)HIVE开启网络服务并使用IDEA连接
下一篇: 大数据(3e)HIVE基础查询
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值