


元气满满的目录
1、什么是 高可用性
- High Availability
- 目标:减少停工时间
- 策略:消除单点故障
工作模式

1.1、NameNode高可用原理
主从NameNode模式

| 简称 | 全称 | 主要作用 | 详细 | 备注 |
|---|---|---|---|---|
| NN | NameNode | 存储元数据 | 活跃NN将 元数据编辑日志 写到QJM,备用NN读取QJM同步元数据 | 断电或升级会使NN停工 |
| QJM | Quorum Journal Manager | 在活跃NN和备用NN之间共享编辑日志 | 为NN提供RPC接口 | |
| ZKFC | ZooKeeper Failover Controller | 是ZK的客户端,用于故障转移 | 监控NN状态; 隔离异常NN并使本地NN活跃 | 每个NN配套1个ZKFC |
| ZK | ZooKeeper | 使 故障转移自动化 | 记录NN状态,保证只有1个NN活跃; NN故障时通知ZKFC | ZKFC在ZK创建临时节点(ephemeral node) |
1.1.1、高可用额外配置
| 配置文件 | 配置属性 | 说明 |
|---|---|---|
| hdfs-site.xml | dfs.nameservices | nameservices的 逻辑名称 |
| hdfs-site.xml | dfs.ha.namenodes | nameservices中每个NN的唯一标识符 |
| hdfs-site.xml | dfs.namenode.rpc-address | 每个NN的RPC地址 |
| hdfs-site.xml | dfs.namenode.http-address | 每个NN的HTTP地址 |
| hdfs-site.xml | dfs.namenode.shared.edits.dir | NN元数据编辑日志的共享存储位置,即JournalNode列表 |
| hdfs-site.xml | dfs.client.failover.proxy.provider | DFS客户端将使用该Java类来确定哪个NN是活跃的 |
| hdfs-site.xml | dfs.ha.fencing.methods | 故障转移时用来隔离活跃NN的方法 |
| hdfs-site.xml | dfs.ha.fencing.ssh.private-key-files | 若使用sshfence方法,配置sshfence的SSH私钥路径 |
| core-site.xml | fs.defaultFS | Hadoop客户端的默认路径前缀 |
| hdfs-site.xml | dfs.journalnode.edits.dir | JournalNode在本地磁盘存放数据的位置 |
| hdfs-site.xml | dfs.ha.automatic-failover.enabled | 启用自动故障转移 |
| core-site.xml | ha.zookeeper.quorum | 用于ZKFC自动故障转移的ZK集群地址列表 |
1.2、YARN高可用原理
主从ResourceManager模式

1.2.1、高可用额外配置
| 配置文件 | 配置属性 | 说明 |
|---|---|---|
| yarn-site.xml | yarn.resourcemanager.ha.enabled | 启用ResourceManager高可用 |
| yarn-site.xml | yarn.resourcemanager.cluster-id | RM集群的逻辑ID |
| yarn-site.xml | yarn.resourcemanager.ha.rm-ids | RM节点逻辑ID列表,如rm1,rm2 |
| yarn-site.xml | yarn.resourcemanager.hostname. | RM节点对应的主机名 |
| yarn-site.xml | yarn.resourcemanager.webapp.address. | RM网络应用程序地址 |
| core-site.xml | hadoop.zk.address | ZK集群地址 |
2、开发环境 and 集群规划
| 环境 | 版本 | 备注 | 下载地址 |
|---|---|---|---|
| CentOS | 7-5 | 开源的Linux操作系统 | |
| JDK | 1.8 | Java软件开发工具包 | https://download.youkuaiyun.com/download/Yellow_python/14033620 |
| Hadoop | 3.1.3 | 分布式系统基础架构 | 同上JDK |
| ZooKeeper | 3.5.7 | 分布式应用程序协调服务 | https://mirrors.bfsu.edu.cn/apache/zookeeper/ |
| 集群规划 | 服务名 | hadoop100 | hadoop101 | hadoop102 |
|---|---|---|---|---|
| Hadoop(HDFS) | DataNode | 1 | 1 | 1 |
| Hadoop(HDFS) | NameNode | 1 | 1 | |
| Hadoop(HDFS) | JournalNode | 1 | 1 | 1 |
| Hadoop(ZKFC) | DFSZKFailoverController | 1 | 1 | |
| ZooKeeper | QuorumPeerMain | 1 | 1 | 1 |
| Hadoop(YARN) | ResourceManager | 1 | 1 | |
| Hadoop(YARN) | NodeManager | 1 | 1 | 1 |
先装好必备Linux命令,
psmisc是【ssh fence】的前提
yum -y install psmisc
3、网络配置和免密登录
链接:CentOS7集群网络配置+免密登录
集群免密登录配好了,后述命令全在hadoop100上执行,不用切来切去
4、环境变量
vi /etc/profile.d/custom.sh
# Java
export JAVA_HOME=/opt/jdk
export PATH=$PATH:$JAVA_HOME/bin
# Hadoop
export HADOOP_HOME=/opt/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
# ZooKeeper
export ZOOKEEPER_HOME=/opt/zookeeper
export PATH=$PATH:$ZOOKEEPER_HOME/bin
# Hadoop user
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
# Hadoop high availability
export HDFS_JOURNALNODE_USER=root
export HDFS_ZKFC_USER=root
scp -r /etc/profile.d/custom.sh hadoop101:/etc/profile.d/
scp -r /etc/profile.d/custom.sh hadoop102:/etc/profile.d/
source /etc/profile.d/custom.sh
ssh hadoop101 "source /etc/profile.d/custom.sh"
ssh hadoop102 "source /etc/profile.d/custom.sh"
5、解压Java、Hadoop、ZooKeeper
tar -zxf jdk-8u212-linux-x64.tar.gz -C /opt/
tar -zxf hadoop-3.1.3.tar.gz -C /opt/
tar -zxf apache-zookeeper-3.5.7-bin.tar.gz -C /opt/
cd /opt
mv hadoop-3.1.3 hadoop
mv jdk1.8.0_212 jdk
mv apache-zookeeper-3.5.7-bin zookeeper
chown -R root:root jdk hadoop zookeeper
ll
6、配置文件
6.1、Hadoop配置
Hadoop核心配置,加入configuration
vi $HADOOP_HOME/etc/hadoop/core-site.xml
<!-- 存放Hadoop数据的总目录 -->
<property>
    <name>hadoop.data.dir</name>
    <value>/opt/hadoop/data</value>
</property>
<!-- 以下为高可用配置 -->
<!-- Hadoop客户端的默认路径前缀 -->
<property>
    <name>fs.defaultFS</name>
    <value>hdfs://myha</value>
</property>
<!-- 用于ZKFC自动故障转移的ZK集群地址列表 -->
<property>
    <name>ha.zookeeper.quorum</name>
    <value>hadoop100:2181,hadoop101:2181,hadoop102:2181</value>
</property>
<!-- ZK集群地址 -->
<property>
    <name>hadoop.zk.address</name>
    <value>hadoop100:2181,hadoop101:2181,hadoop102:2181</value>
</property>
HDFS配置,加入configuration
vi $HADOOP_HOME/etc/hadoop/hdfs-site.xml
<!-- NameNode数据存放的目录 -->
<property>
    <name>dfs.namenode.name.dir</name>
    <value>file://${hadoop.data.dir}/name</value>
</property>
<!-- DataNode数据存放的目录 -->
<property>
    <name>dfs.datanode.data.dir</name>
    <value>file://${hadoop.data.dir}/data</value>
</property>
<!-- 以下为高可用配置 -->
<!-- nameservices的逻辑名称 -->
<property>
    <name>dfs.nameservices</name>
    <value>myha</value>
</property>
<!-- nameservices中每个NN的唯一标识符 -->
<property>
    <name>dfs.ha.namenodes.myha</name>
    <value>nn0,nn1</value>
</property>
<!-- 每个NN的RPC地址 -->
<property>
    <name>dfs.namenode.rpc-address.myha.nn0</name>
    <value>hadoop100:8020</value>
</property>
<property>
    <name>dfs.namenode.rpc-address.myha.nn1</name>
    <value>hadoop101:8020</value>
</property>
<!-- 每个NN的HTTP地址 -->
<property>
    <name>dfs.namenode.http-address.myha.nn0</name>
    <value>hadoop100:9870</value>
</property>
<property>
    <name>dfs.namenode.http-address.myha.nn1</name>
    <value>hadoop101:9870</value>
</property>
<!-- NN元数据共享编辑日志的存储位置,即JournalNode列表 -->
<property>
    <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://hadoop100:8485;hadoop101:8485;hadoop102:8485/myha</value>
</property>
<!-- DFS客户端将使用该Java类来确定哪个NN是活跃的 -->
<property>
    <name>dfs.client.failover.proxy.provider.myha</name>
    <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
</property>
<!-- 故障转移时用来隔离活跃NN的方法 -->
<property>
    <name>dfs.ha.fencing.methods</name>
    <value>sshfence</value>
</property>
<!-- 若使用sshfence方法,配置sshfence的SSH私钥路径 -->
<property>
    <name>dfs.ha.fencing.ssh.private-key-files</name>
    <value>/root/.ssh/id_rsa</value>
</property>
<!-- JournalNode在本地磁盘存放数据的位置(要求绝对路径) -->
<property>
    <name>dfs.journalnode.edits.dir</name>
    <value>/opt/hadoop/data/jn</value>
</property>
<!-- 启用自动故障转移 -->
<property>
    <name>dfs.ha.automatic-failover.enabled</name>
    <value>true</value>
</property>
YARN配置,加入configuration
vi $HADOOP_HOME/etc/hadoop/yarn-site.xml
<!-- 配置成 mapreduce_shuffle 才可运行 MapReduce -->
<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
<!--
环境变量通过从NodeManagers的容器继承的环境属性,
对于MapReduce应用程序,
除了 默认值 hadoop op_mapred_home 应被加入 外,
还有如下属性值:
-->
<property>
    <name>yarn.nodemanager.env-whitelist</name>
    <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
</property>
<!-- 不 检查虚拟内存 -->
 <property>
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>
<!-- 以下为高可用配置 -->
<!-- 启用RM高可用 -->
<property>
    <name>yarn.resourcemanager.ha.enabled</name>
    <value>true</value>
</property>
<!-- RM集群的逻辑ID -->
<property>
    <name>yarn.resourcemanager.cluster-id</name>
    <value>rmha</value>
</property>
<!-- RM节点的逻辑ID列表 -->
<property>
    <name>yarn.resourcemanager.ha.rm-ids</name>
    <value>rm0,rm2</value>
</property>
<!-- RM节点对应的主机名 -->
<property>
    <name>yarn.resourcemanager.hostname.rm0</name>
    <value>hadoop100</value>
</property>
<property>
    <name>yarn.resourcemanager.hostname.rm2</name>
    <value>hadoop102</value>
</property>
<!-- RM网络应用程序地址 -->
<property>
    <name>yarn.resourcemanager.webapp.address.rm0</name>
    <value>hadoop100:8088</value>
</property>
<property>
    <name>yarn.resourcemanager.webapp.address.rm2</name>
    <value>hadoop102:8088</value>
</property>
MapReduce配置,加入configuration
vi $HADOOP_HOME/etc/hadoop/mapred-site.xml
<!-- 让 MapReduce 运行在 YARN 上 -->
<property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
</property>
<!-- Map内存,单位MB-->
<property>
    <name>mapreduce.map.memory.mb</name>
    <value>512</value>
</property>
<!-- Reduce内存,单位MB -->
<property>
    <name>mapreduce.reduce.memory.mb</name>
    <value>1024</value>
</property>
<!-- Map下Java程序最大内存 -->
<property>
    <name>mapreduce.map.java.opts</name>
    <value>-Xmx384m</value>
</property>
<!-- Reduce下Java程序最大内存 -->
<property>
    <name>mapreduce.reduce.java.opts</name>
    <value>-Xmx768m</value>
</property>
从机配置,
-e指(enable interpretation of backslash escapes)启用反斜杠转义的解释
echo -e "hadoop100\nhadoop101\nhadoop102" > $HADOOP_HOME/etc/hadoop/workers
cat $HADOOP_HOME/etc/hadoop/workers
6.2、ZooKeeper配置
cd $ZOOKEEPER_HOME/conf
cp zoo_sample.cfg zoo.cfg
vi zoo.cfg
# 数据存放路径,建议写绝对路径
dataDir=/opt/zookeeper/zkData
# 集群服务器配置
server.0=hadoop100:2888:3888
server.1=hadoop101:2888:3888
server.2=hadoop102:2888:3888
7、文件分发
rsync -a $JAVA_HOME/ hadoop101:$JAVA_HOME/
rsync -a $JAVA_HOME/ hadoop102:$JAVA_HOME/
rsync -a $HADOOP_HOME/ hadoop101:$HADOOP_HOME/
rsync -a $HADOOP_HOME/ hadoop102:$HADOOP_HOME/
rsync -a $ZOOKEEPER_HOME/ hadoop101:$ZOOKEEPER_HOME/
rsync -a $ZOOKEEPER_HOME/ hadoop102:$ZOOKEEPER_HOME/
mkdir $ZOOKEEPER_HOME/zkData
ssh hadoop101 "mkdir $ZOOKEEPER_HOME/zkData"
ssh hadoop102 "mkdir $ZOOKEEPER_HOME/zkData"
echo 0 > $ZOOKEEPER_HOME/zkData/myid
ssh hadoop101 "echo 1 > $ZOOKEEPER_HOME/zkData/myid"
ssh hadoop102 "echo 2 > $ZOOKEEPER_HOME/zkData/myid"
8、初次启动
1、启动ZooKeeper
zkServer.sh start
ssh hadoop101 'zkServer.sh start'
ssh hadoop102 'zkServer.sh start'
2、启动QJM集群
hdfs --daemon start journalnode
ssh hadoop101 'hdfs --daemon start journalnode'
ssh hadoop102 'hdfs --daemon start journalnode'
3、格式化nn0
hdfs namenode -format
4、启动nn0
hdfs --daemon start namenode
5、nn1同步nn0
ssh hadoop101 'hdfs namenode -bootstrapStandby'
6、启动nn1
ssh hadoop101 'hdfs --daemon start namenode'
7、初始化HA在Zookeeper中状态
hdfs zkfc -formatZK
ssh hadoop101 'hdfs zkfc -formatZK'
8、启动nn1和nn2的ZKFC
hdfs --daemon start zkfc
ssh hadoop101 'hdfs --daemon start zkfc'
9、启动全部DataNode
hdfs --daemon start datanode
ssh hadoop101 'hdfs --daemon start datanode'
ssh hadoop102 'hdfs --daemon start datanode'
10、启动YR
start-yarn.sh
11、按序执行过上述步骤1~10一次,以后就可以用一下命令启停集群
start-dfs.sh
start-yarn.sh
stop-dfs.sh
stop-yarn.sh
9、高可用性验证
1、查看主从状态

hdfs haadmin -getServiceState nn0
hdfs haadmin -getServiceState nn1
yarn rmadmin -getServiceState rm0
yarn rmadmin -getServiceState rm2
2、
jps查看进程

3、
kill -9强制杀死活跃的nn和rm,然后再次查看节点状态
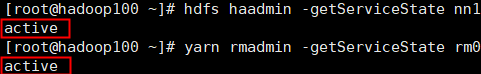
4、重启挂掉的nn和rm,然后再次查看节点状态

10、补充
- 高可用模式比较耗内存,主要因为有多个NameNode
- 仅用
sshfence隔离方式是不够的,还要添加其它方式 - 初次启动必须按序1~10执行,第二次起可用
start-dfs.sh,ZKFC会随NN自动创建
| en | 🔉 | cn |
|---|---|---|
| quorum | /ˈkwɔːrəm/ | 法定人数 |
| journal | 日报 | |
| manager | 经理 | |
| failover | /'feɪləʊvə/ | 故障切换 |
| controller | 控制器 | |
| fence | 栅栏;用篱笆围住 | |
| ephemeral | /ɪˈfemərəl/ | 只生存一天的事物;朝生暮死的 |
| inform | 告诉 |
hadoop fs -ls hdfs://myha/


 2234


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


