快速 Pearson Correlation 计算

科研必备|Origin实战:快速绘制高颜值相关性系数矩阵图 本文详细介绍了使用Origin软件快速绘制高颜值相关性系数矩阵图的实战教程。通过Correlation Plot插件,科研人员无需编程即可高效完成数据可视化,生成符合期刊出版要求的专业图表。文章涵盖了从数据准备、插件安装、参数设置到深度美化的全流程,并提供了色彩映射、文本处理及常见问题解决方案,助力提升科研图表质量与工作效率。 阅读详情

调用scipy.stats 的pearsonr进行运算,运算量 (33003 * 33002 / 2) 达到五亿规模的情况下运算速度特别慢,无法接受。如何快速进行correlation计算?

源代码和结果:

import pickle
from scipy.stats import pearsonr
import numpy as np


def CorrelationPool():
    
    with open('map_pool.pkl','rb') as handle:
        pool = pickle.load(handle)
    
    print("There are "+str(len(pool))+" cells in the pool!")
    l = len(pool)
    # Notes: the shape of the pool is (l, 2304), the type is 'list'. 

    correlation_pool = np.zeros(int(l*(l-1)/2), dtype = np.float64)
    t = 0
    for i in tqdm(range(l-1)):
        for j in range(i+1,l):
            correlation_pool[t], _ = pearsonr(np.array(pool[i]),np.array(pool[j]))
            t += 1
    
    with open('CorrelaitonPool.pkl','wb') as f:
        pickle.dump(correlation_pool,f)
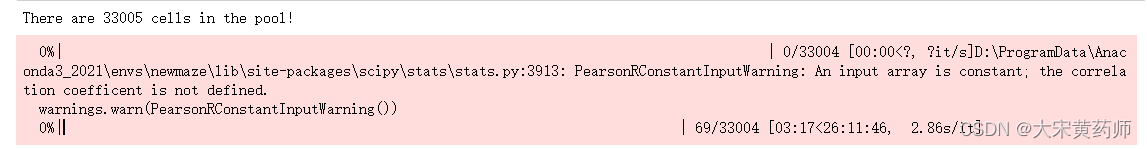
预计用时13小时(考虑到for循环结构,最终用时大约是26小时的一半)这可能是调用两层for循环导致的。为检验这种可能,隐去第二层for循环内的pearson计算时,此时五亿次for循环计算仅用时36秒:

 可见scipy.stats.pearson运算占据了绝对的时间消耗。尝试用numpy重写pearson r,利用numpy的矩阵运算速度优势显著提高运算效率。

方法:标准化数据之后利用标准化数据中欧氏距离方等价于pearson相关系数的原理计算pearsonr相关系数。参考 

https://www.zhihu.com/question/19734616

采用此方法后利用numpy进行运算:

def CorrelationPool(map_type = 'smooth'):
    
    with open('map_pool.pkl','rb') as handle:
        pool = np.array(pickle.load(handle), dtype = np.float64)
    
    # Z-score Normalization
    pool = scale(pool, axis = 1)
    
    l = pool.shape[0]
    print("There are "+str(l)+" cells in the pool!")
    correlation_pool = np.zeros(int(l*(l-1)/2), dtype = np.float64)

    t = 0
    for i in tqdm(range(l-1)):
        eu = np.sum((pool[0:l-i-1,:] - pool[i+1:l])**2, axis = 1)
        correlation_pool[t:t + l-i-1] = 1- eu / (2*pool.shape[1])
        t += l-i-1
    
    with open('CorrelaitonPool_'+map_type+'.pkl','wb') as f:
        pickle.dump(correlation_pool,f)

 时间缩短到不到3小时(受for循环结构的影响,循环会越来越快,当然受CPU的限制)

这在运算超过5亿结果的运算量下属于可以接受。

Origin绘制相关性热力图:零代码生成可发表级Correlation Plot 相关性热力图是多变量统计分析的基础可视化手段,用于直观揭示变量间线性或单调关联强度。其核心原理基于Pearson、Spearman等相关系数矩阵计算,通过颜色映射实现关系量化表达。该技术具备高可复现性、强结果一致性与期刊级输出能力,广泛应用于环境科学、农学、医学等领域的数据探索与论文图表制作。相比Python(如seaborn)或R(如corrplot)需配置环境、处理数据格式、调试渲染参数,Origin凭借原生集成的数据导入、一键矩阵计算、矢量热力图渲染及EMF/TIFF导出能力,显著降低使用门槛与出错概 阅读详情

相关推荐

SPSS相关性分析实战:从Pearson到偏相关,掌握数据关联性检验

相关性分析是统计学中用于量化两个变量之间线性关系强度和方向的基础方法,其核心在于计算相关系数。Pearson相关系数适用于连续变量且数据服从正态分布的情形,而Spearman等级相关系数则用于非正态分布或等级数据,两者共同构成了变量关联性检验的主要工具。在数据分析实践中,理解相关系数的计算原理与前提假设至关重要,这直接决定了分析结果的科学性与可靠性。相关性分析的技术价值在于能够快速识别变量间的统计关联,为后续的因果推断、预测建模提供关键线索,广泛应用于市场研究、社会科学、医学研究等领域。例如,在商业分析中,

weixin_34214500的博客 357

皮尔逊相关(Pearson correlation)系数概述及其计算例

相关是最常用的统计度量。用一个数来描述两个变量之间的相关联的程度。相关系数的取值范围为[-1,+1]。负值表示随着一个变量值的增大另一个则减小;正值表示随着一个变量值的增大另一个也跟着增大;0则表示一个变量的增大减小对另一个的取值没有 影响。 三种常用的相关系数为:皮尔逊相关系数,斯皮尔曼相关系数,Kendall相关系数.本文概要性地介绍皮尔逊相关系数。

chenxy_bwave的专栏 18万+

时间序列滞后相关性分析:用hister精准定位变量间延迟关系

在时间序列数据分析中,两个变量往往存在时间上的延迟,直接计算同一时刻的相关系数容易陷入“时差陷阱”,得出错误结论。滞后互相关通过逐次平移序列,计算不同滞后步长下的相关系数,能够揭示变量间真正的关联强度与方向。hister作为一个轻量级Python库,内置了滞后相关分析、显著性检验与置信区间估计,可快速输出标准化结果表,帮助工程师和数据科学家定位最优滞后步长。该方法广泛应用于传感器数据、能源负荷、广告营销等场景,例如识别温度对能耗的延迟影响或广告曝光到销售额的转化周期。本文结合实战案例,详解hister的使用

weixin_30235225的博客 226

scipy.stats.pearsonr - 皮尔森相关系数

函数:pearsonr(x,y) 功能: 计算特征与目标变量之间的相关度 参数说明: 1)输入:x为特征,y为目标变量. 2)输出:r: 相关系数 [-1,1]之间,p-value: p值。 注: p值越小,表示相关系数越显著,一般p值在500个样本以上时有较高的可靠性。 示例: 数据 样本数:1000 特征数:3(3维数据) 重要特征:1 from sklearn.datasets import make_regression X,y = make_regression(n_s

壮壮不太胖的学习笔记 2万+

Kydavra相关性特征筛选:三行代码实现目标感知的冗余特征剔除

相关性特征筛选是机器学习数据预处理的关键环节,旨在识别并移除高度线性或单调相关的冗余特征,缓解多重共线性、提升模型稳定性与可解释性。其核心原理涵盖Pearson、Spearman与Kendall三类相关系数的适用边界与融合策略,并需兼顾特征间冗余度与特征对目标变量的贡献度。技术价值在于降低维度灾难风险、加速训练收敛、增强业务可解释性;典型应用场景包括供应链需求预测、金融反欺诈建模、用户流失预警等高维结构化数据任务。Kydavra通过目标感知分层检验、自适应阈值机制与鲁棒相关矩阵计算,将传统统计操作转化为可嵌

chushang0934的博客 502

Python进行相关性分析三种操作和可视化

相关性分析在数据科学的实践中扮演着关键角色,它不仅能够揭示变量间的潜在关系,还为进一步的预测和建模提供了坚实的依据。通过本文的介绍,利用NumPy、SciPy和Pandas等工具进行相关性分析,变得更加易于理解和实现。无论是简单的线性回归分析,还是复杂的等级相关性测量,相关性分析的方法为解决实际问题提供了多样化的工具和思路。未来在数据分析的过程中,掌握这些技术将有助于更有效地解读数据,并做出更科学的决策。

Mr数据杨 8545

python统计分析——线性相关

pearson相关系数,有时也称为总体相关系数或样本相关性,它的取值范围是[-1,1]。注意相关系数的公式在x和y之间是对称的,但线性回归中不是这样的。在这种情况下,我们可以对数据集的每个变量进行排序,比较这个顺序。”也就是说,如果一个变量的变化,那另一个也改变了吗?对于两个相关的变量,相关性度量的是两个变量之间的关联程度。相反,线性回归是用一个变量的值来预测另一个变量的值。和pearson相关系数r完全一样,但计算的不是原始的数字,二是观测值的秩。也是一个秩相关系数,测量两个观测量之间的而相关。

maizeman126的博客 1037

Matlab实现GCN特征图分类:Pearson相关建图

图神经网络(GNN)是一类处理非欧结构数据的深度学习模型,其核心在于将数据建模为节点与边构成的图结构。在多变量时序或传感器数据分析中,特征间存在天然耦合关系,传统全连接网络忽略这种拓扑信息,而图卷积网络(GCN)可通过邻接矩阵编码特征相关性,提升分类判别能力。本文基于Matlab平台,利用Pearson相关系数动态构建特征图,并结合Glorot初始化、自适应阈值剪枝与早停训练机制,实现端到端的GCN分类流程。适用于水文监测、设备故障诊断等多源信号融合场景,尤其适合缺乏Python环境但具备Matlab基础的

weixin_32308101的博客 179

pearsonr() python_深入理解皮尔逊相关系数&python代码

1.常见理解误区(1)计算出变量A和变量B的皮尔逊相关系数为0,不代表A和B之间没有相关性,只能说明A和B之间不存在线性相关关系。例:温度和冰淇淋销量之间的散点图像如下,可以发现大致成二次函数图像,随着温度升高,销量也会增加,达到峰值后,随着温度升高,销量反而下降。也就是说,销量和温度之间是有关系的。不过,计算温度和销量之间的皮尔逊相关系数却为0。这只能说明温度和销量之间没有线性相关关系,而不能说...

weixin_39914499的博客 7623

十一种室内定位传感器方案汇总介绍与对比(机器人、物联网领域)

室内定位传感器方案汇总 目录 室内定位传感器方案汇总 1、定位方案概述 1.1、内定位系统有最基本的5种算法: 1.2、常用的室内定位技术主要包括以下几种: 1.3、定位理论 1.4、不同的定位方案对比 2、各种定位方案详细介绍 2.1、单线激光定位 2.2、多线激光定位: 2.3、视觉定位: 2.4、基于射频识别(RFID)技术室内定位 2.4.1、RFID标签(不涉及...

JK-Cool的博客 3万+

Dify部署后访问报502?手把手教你排查和修复Nginx反向代理问题

本文针对Dify部署后常见的502 Bad Gateway错误,提供了从基础容器状态检查到Nginx配置与Docker网络诊断的完整排查流程。详细解析了错误本质,并给出动态服务发现修复与静态IP配置两种解决方案,帮助开发者彻底解决Nginx反向代理问题,确保Dify平台稳定访问。

rnn9storyteller的博客 1096

基于Python的相关分析(correlation)

相关分析(《Python数据分析基础》学习笔记)一、函数关系与相关关系1.函数关系2.相关关系(1)相关关系的定义(2)相关关系的分类二、简单相关关系 一、函数关系与相关关系 1.函数关系   当一个或几个变量取一定的值时,另一个变量有确定值与之具体严格相对应,则称这种关系为函数关系。 2.相关关系 (1)相关关系的定义   变量之间的影响不能够用具体的函数来度量,但变量之间的关系确实存在数量上不...

Arvin_Austin的博客 1万+

别再死记硬背窗函数公式了!用MATLAB实战汉宁窗FIR滤波器,从频谱图看懂‘主瓣’和‘旁瓣’

本文通过MATLAB实战演示汉宁窗FIR滤波器的设计过程,帮助读者从频谱图直观理解主瓣与旁瓣的特性。文章详细对比了矩形窗与汉宁窗的频谱差异,并提供了高通滤波器设计的完整代码示例,适用于数字信号处理学习和工程应用。

weixin_30555125的博客 490

Spark MLlib 基础统计模块相关性、卡方检验与向量汇总

本文介绍了Spark MLlib中的三种基础统计工具:相关性分析(Correlation)、卡方检验(ChiSquareTest)和特征摘要(Summarizer)。相关性分析用于计算特征间的Pearson或Spearman相关系数矩阵,帮助识别冗余特征;卡方检验用于判断离散特征与标签的统计相关性;Summarizer可快速计算向量特征的均值、方差等统计量。这些工具能有效支持特征工程和数据分析,如特征筛选、多重共线性检查等,并可通过权重参数处理特殊样本。合理运用这些统计方法,能够提升机器学习模型的特征质量和

hello.reader 801

手把手教你用Simulink搭建DSOGI-PLL模型(附完整代码下载)

本文详细介绍了在Simulink中搭建高鲁棒性DSOGI-PLL模型的完整工程实践指南。针对传统锁相环在非理想电网下的不足,文章深入剖析了双二阶广义积分器锁相环(DSOGI-PLL)的核心原理与优势,并提供了从模块构建、系统组装到参数整定与测试验证的全流程手把手教程,附有完整代码下载,助力工程师应对谐波、电压跌落等复杂电网工况。

weixin_29223603的博客 387

PySpark 本地开发环境搭建与实践

本文详细介绍了 PySpark 本地开发环境的搭建过程,包括 JDK、Hadoop、Anaconda、PySpark 的安装以及 Pycharm 工程的创建。同时,深入讲解了代码编写、本地开发案例(如 WordCount、处理特殊分隔符、读取 hdfs 数据、获取外部变量)、Spark 程序的监控和 local 模式下结果文件数量问题等内容。通过掌握这些知识和技能,读者可以在 Windows 本地环境中高效地进行 PySpark 开发,处理大规模数据,解决实际业务中的数据分析和处理问题。

天冬忘忧的博客 3011

Apache Spark MLlib 基础统计指南:Correlation、ChiSquareTest 与 Summarizer 实战

Apache Spark 的 MLlib 在 `spark.ml` 包中提供了一组面向 DataFrame/Dataset 的统计工具,用于完成基础统计分析:`Correlation`(相关系数矩阵)、`ChiSquareTest`(皮尔逊卡方独立性检验)与 `Summarizer`(向量列汇总统计)。本篇指南以 [docs/ml-statistics.md](https://link.gitco

gitblog_00228的博客 687

4D毫米波雷达:高度信息与微多普勒效应

4D毫米波雷达:高度信息与微多普勒效应​ ,人工智能,计算机视觉,大模型,AI,本文深入解析4D毫米波雷达的高度信息获取与微多普勒效应。4D毫米波雷达通过MIMO技术、垂直天线布局及相位差计算等获取高度信息,相较传统雷达更精准。微多普勒效应由目标微运动引发,可用于目标识别、分类和运动监测。文中结合自动驾驶、安防监控案例,分析技术挑战与未来趋势,如信号干扰、数据处理复杂,未来将向高精度、与其他传感器融合发展,展现出在多领域的巨大应用潜力。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 9万+

Pearson相关分析和 Spearman秩相关

Pearson相关系数是分析两个连续变量之间线性关系的常用指标,但其有效性依赖于以下前提条件:1)变量之间的关系是线性的;2)变量的分布服从或近似服从正态分布;3)变量是连续的。然而,在实际临床研究中,数据往往并不符合这些假设。例如,许多变量可能是分类型或非正态分布的连续变量。在这种情况下,直接使用Pearson相关系数可能会导致错误的结论。

MD Code 764

11、基于多阵列电极的表面肌电信号运动估计

本文介绍了一种基于多阵列电极的表面肌电信号运动估计技术,旨在实现对手腕和手指运动的高精度估计,解决传统人机接口在操控多自由度机器人时的局限性。通过多阵列电极系统采集前臂肌肉活动信号,结合独立成分分析(ICA)和非负矩阵分解(NMF)等信号处理方法,提取肌肉协同作用,进而生成运动指令以控制机器人或假肢手。文章对比了多阵列电极与传统电极的优势,展示了运动估计算法的整体流程,并以假肢手控制为例说明其实际应用。最后探讨了该技术在测量精度、应用拓展、智能化和便携化等方面的未来发展方向。该技术为假肢控制、康复训练和人机

ik678901234的博客 86

Vue3 - Element Plus 树形表格组件 el-table 一键全部展开折叠功能,支持动态数据及懒加载点击父级才去请求的场景,Tree树状表格每行带有children的表格全部收起和折叠!

vue3,element-plus,表格Table组件,el-table,怎样一键展开/收起,一键展开或折叠树形表格,如何通过按钮来实现全部展开,不生效,一键折叠或展开表格,表格children嵌套,带有子集,多级表格,懒加载,动态数据,table表格的children通过后端请求过来的怎么一键展开请求数据呢,表格如何一键展开和折叠,怎么使用,教程,树形数据table全部展开和折叠,一键展开或折叠树形表格,点击展开接口获取数据,toggleRowExpansion,树形表格懒加载与全部折叠,深层多级,复杂,

🏆 前端领域优质创作者 6802

相关性不是因果:从Pearson到Spearman的底层逻辑与避坑指南

相关性是衡量两个变量线性协同程度的基础统计量,其核心原理在于标准化协方差以消除量纲影响,从而获得-1到1之间的无量纲度量。它并非因果证据,而是一种受多重假设约束的描述性工具——对离群值敏感、依赖线性关系、要求双变量近似正态。技术价值在于为特征筛选、EDA和模型诊断提供可解释的初始洞察,但必须配合散点图、正态性检验与分组分析才能避免误读。典型应用场景包括用户行为分析(如停留时长与付费金额)、风控变量筛查(如收入与信用分)及多变量共线性识别。本文聚焦Pearson相关系数的本质推演与三大致命假设,并系统对比Sp

weixin_30321449的博客 381

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

R语言Pearson、Spearman、Kendall全解析:选择正确的相关性方法只需这1步

掌握R语言数据探索中的相关性分析关键一步:根据数据类型与分布选择Pearson、Spearman或Kendall方法。详解三大相关系数适用场景、计算方式与结果解读,助你精准判断变量关系。方法清晰,操作简单,值得收藏。

CompiLume的博客 973

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

数学建模中Pearson与Spearman相关系数实战选择指南

相关性分析是数据建模的基础环节,其核心在于理解变量间关系的本质而非套用公式。Pearson系数衡量线性关联,依赖正态分布与无异常值假设;Spearman则基于秩次,对非线性单调关系和异常值更具鲁棒性。在真实建模场景中(如国赛、华为杯),数据常呈非正态、含离群点或存在倒U型等复杂模式,单一使用Pearson易导致关键变量误删。Scipy.stats模块因可复现、可嵌入Python工作流、支持p值与置信区间输出,成为竞赛首选工具。正确应用需结合样本量、分布检验、缺失值策略及业务语境动态判断——例如小样本下p值校

weixin_34087307的博客 486

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

相关系数假设检验:从计算到统计推断的完整指南

在数据分析中,计算两个变量间的相关系数(如皮尔逊相关系数)是描述其线性关系强度和方向的基础步骤。然而,仅凭样本计算出的相关系数可能受到抽样误差的影响,无法直接推断总体是否存在真实关联。统计推断中的假设检验为此提供了严谨的框架,其核心逻辑是通过反证法,在原假设(如总体相关系数为零)成立的前提下,计算得到当前样本相关系数或更极端情况的概率(即p值)。该技术价值在于将数据分析从单纯的描述提升到统计推断层面,帮助研究者量化结论的可靠性,避免将偶然的样本现象误判为普遍规律。其应用场景广泛,涵盖学术研究、商业决策与数学

weixin_34214500的博客 431

从相关性矩阵到变量交互分析:fg-data-profiling多变量分析新手完全教程

fg-data-profiling(ydata-profiling 社区版)是一款**一行代码即可生成数据质量剖析与探索性数据分析(EDA)报告**的开源工具,支持 Pandas 和 Spark DataFrame。除了单变量检查,它还能自动完成**多变量分析**:生成相关性矩阵热力图、检测变量交互关系,帮助新手快速发现特征之间的隐藏关联。 ## 为什么需要多变量分析? 单变量剖析只能告诉你"

gitblog_00563的博客 632
上一篇: np.dot 浮点类型运算远快于整型运算
下一篇: plt.plot() marker 一览表 (散点图)
大宋黄药师
博客等级 码龄5年 24粉丝 13原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
