Pandas Style 为数据表格美颜

多模态数据融合:从对齐粒度到特征归一化的工程实践 多模态机器学习的核心挑战在于如何让图像、文本、音频等异构数据在语义空间中达成可计算的一致性。其本质不是简单拼接,而是基于对齐粒度与协同边界的协同建模;关键原理涵盖信号层、特征层与决策层三类融合机制,每种对应不同延迟、鲁棒性与精度约束。技术价值体现在提升跨模态检索准确率、增强缺失模态下的系统鲁棒性,并支撑工业级低延迟部署。典型应用场景包括图文检索、医疗影像-报告联合分析、智能巡检与课堂行为理解。本文聚焦数据融合中最易被忽视却决定成败的硬核细节:模态间特征归一化(如Batch-Aware Instance No 阅读详情

1. 创建样式

传递样式函数的方法:

  • Styler.applymap: 逐个元素,返回带有CSS属性-值对的单个字符串。

  • Styler.apply: 列/行/表方式,返回形状相同的Series或DataFrame,其中每个值都是带有CSS属性值对的字符串。

Styler.applymap 作用于DataFrame中的每一个元素。Styler.apply 通过axis参数,每一次将一列或一行或整个表传递到DataFrame中。对于按列使用 axis=0, 按行使用 axis=1, 整个表使用 axis=None.

import pandas as pd
import numpy as np

np.random.seed(24)
df = pd.DataFrame({'A': np.linspace(1, 10, 10)})
df = pd.concat([df, pd.DataFrame(np.random.randn(10, 4), columns=list('BCDE'))],
               axis=1)
df.iloc[3, 3] = np.nan
df.iloc[0, 2] = np.nan
# 默认无样式
df.style

「注意」: DataFrame.style 返回Styler对象的属性。

# 通过调用.render方法来查看它们
df.style.highlight_null().render().split('\n')[:10]
['<style  type="text/css" >',
 '    #T_98ef3b58_b54d_11ea_87c2_8056f2b2fdccrow0_col2 {',
 '            background-color:  red;',
 '        }    #T_98ef3b58_b54d_11ea_87c2_8056f2b2fdccrow3_col3 {',
 '            background-color:  red;',
 '        }</style><table id="T_98ef3b58_b54d_11ea_87c2_8056f2b2fdcc" ><thead>    <tr>        <th class="blank level0" ></th>        <th class="col_heading level0 col0" >A</th>        <th class="col_heading level0 col1" >B</th>        <th class="col_heading level0 col2" >C</th>        <th class="col_heading level0 col3" >D</th>        <th class="col_heading level0 col4" >E</th>    </tr></thead><tbody>',
 '                <tr>',
 '                        <th id="T_98ef3b58_b54d_11ea_87c2_8056f2b2fdcclevel0_row0" class="row_heading level0 row0" >0</th>',
 '                        <td id="T_98ef3b58_b54d_11ea_87c2_8056f2b2fdccrow0_col0" class="data row0 col0" >1.000000</td>',
 '                        <td id="T_98ef3b58_b54d_11ea_87c2_8056f2b2fdccrow0_col1" class="data row0 col1" >1.329212</td>']

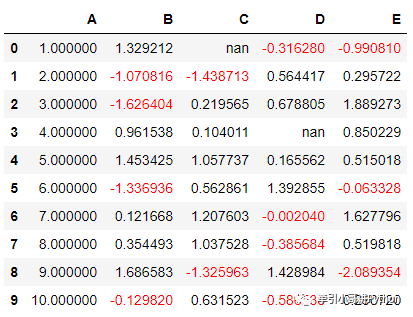
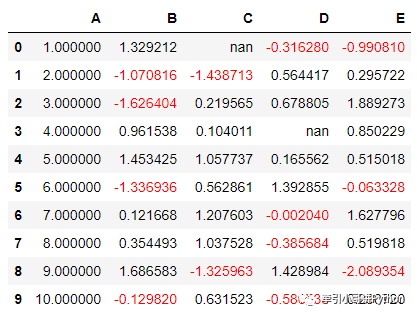
编写一个简单的样式函数,该函数会将负数涂成红色,将正数涂成黑色。

def color_negative_red(val):
    """
    Takes a scalar and returns a string with
    the css property `'color: red'` for negative
    strings, black otherwise.
    """
    color = 'red' if val < 0 else 'black'
    return 'color: %s' % color

在这种情况下,单元格的样式仅取决于其自身的值。我们应该使用在 Styler.applymap作用于每个元素。

df.style.applymap(color_negative_red)
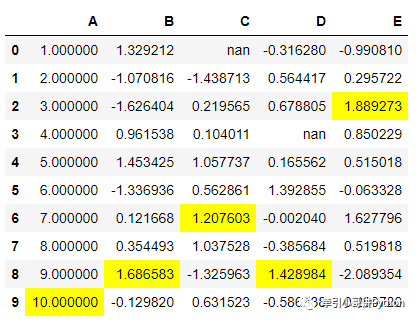
定义一个突出显示每列中的最大值的函数。

def highlight_max(s):
    '''
    highlight the maximum in a Series yellow.
    '''
    is_max = s == s.max()
    return ['background-color: yellow' if v else '' for v in is_max]
df.style.apply(highlight_max)
实际上,已有定义好的各类高亮函数:

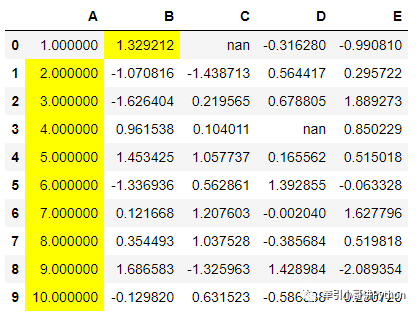
配合axis参数使用

  • highlight_max():高亮最大值

  • highlight_min():高亮最小值

  • highlight_null():高亮空值

# 高亮行最大值
df.style.highlight_max(axis=1)
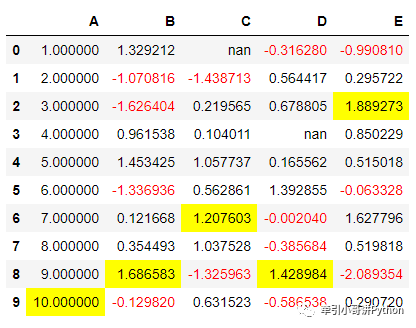
使用链式操作进行定义样式

df.style.applymap(color_negative_red).apply(highlight_max)
2. 切片

subset 参数控制作用的行列。

subset 传入的参数类似DataFrame的切片:

  • 列标签

  • 列表(或者numpy数组)

  • 元组(row_indexer, column_indexer)

df.style.apply(highlight_max, subset=['B', 'C', 'D'])
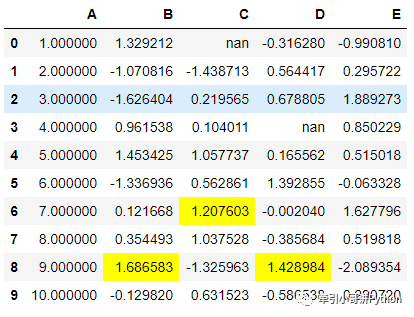
使用pd.IndexSlice构造一个切片元组。
# B, D两列,2:5行中的负数标红 
df.style.applymap(color_negative_red,
                  subset=pd.IndexSlice[2:5, ['B', 'D']])
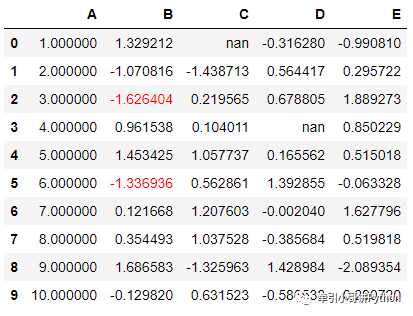
「注意」:目前仅支持基于标签的切片,不支持位置切片。

3.值的显示格式

使用Styler.format控制。类似字符串输出方法。

df.style.format("{:.2%}")
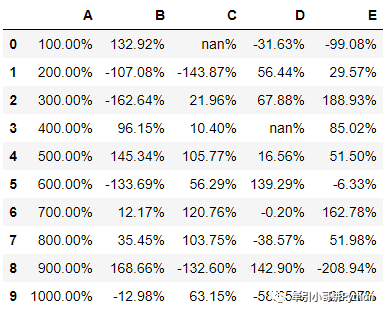
使用字典来格式化特定的列。
df.style.format({'B': "{:0<4.0f}", 'D': '{:+.2f}'})
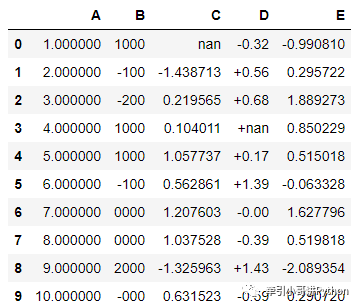
使用lambda函数。
df.style.format({"B": lambda x: "±{:.2f}".format(abs(x))})
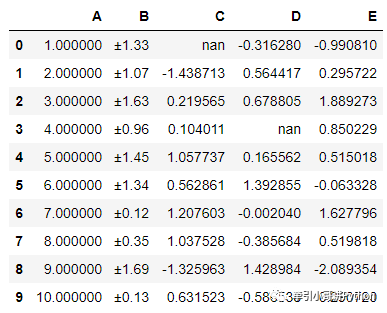
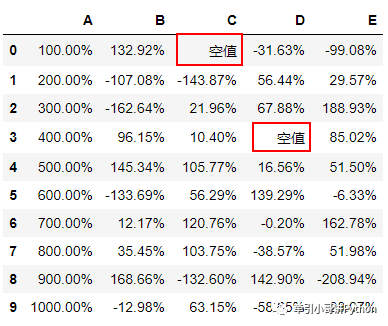
使用 na_rep设置空值的显示。
df.style.format("{:.2%}", na_rep="空值")
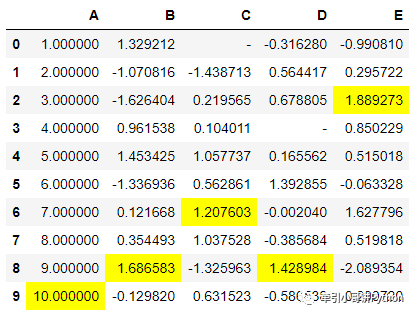
df.style.highlight_max().format(None, na_rep="-")
4. 内置样式函数

参考链接:https://pandas.pydata.org/docs/reference/style.html

# 高亮空值
df.style.highlight_null(null_color='red')
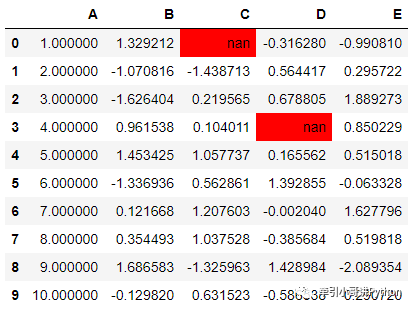
使用background_gradient 创建“热力图”式背景。需要配合matplotlib或者Seaborn使用。
import seaborn as sns
cm = sns.light_palette("green", as_cmap=True)

df.style.background_gradient(cmap=cm)
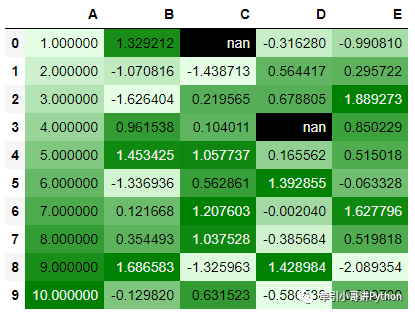
# Uses the full color range
df.loc[:4].style.background_gradient(cmap='viridis')
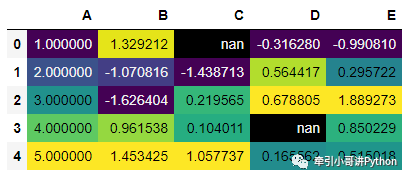
使用关键字参数low和high限定色谱百分比范围。
# Compress the color range
(df.loc[:4]
    .style
    .background_gradient(cmap='viridis', low=.5, high=0)
    .highlight_null('red'))
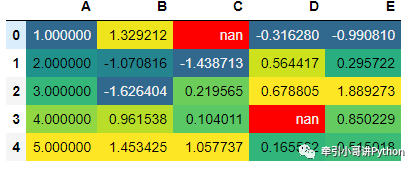
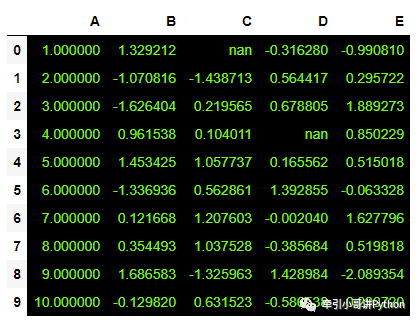
当样式不取决于值时,使用set_properties 。
df.style.set_properties(**{'background-color': 'black',
                           'color': 'lawngreen',
                           'border-color': 'white'})
5. 数据中包含“条形图”

df.style.bar(subset=['A', 'B'], color='#d65f5f')
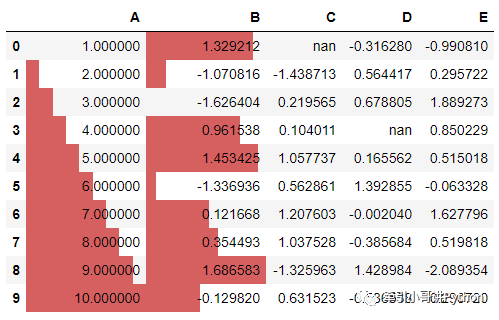
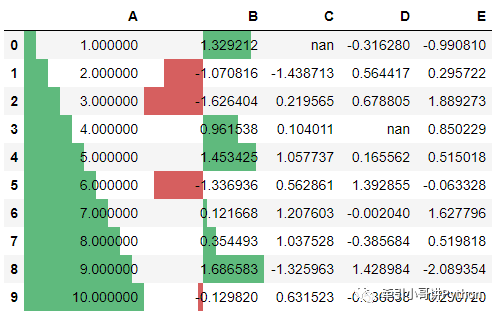
使用align 控制对其方式:
  • left: 最小值从单元格的左侧开始。

  • zero: 零值位于单元格的中心。

  • mid: t单元格的中心在(max-min)/ 2,或者如果值全为负(正),则零对齐于单元格的右(左)。

df.style.bar(subset=['A', 'B'], align='mid', color=['#d65f5f', '#5fba7d'])
6. 共享样式

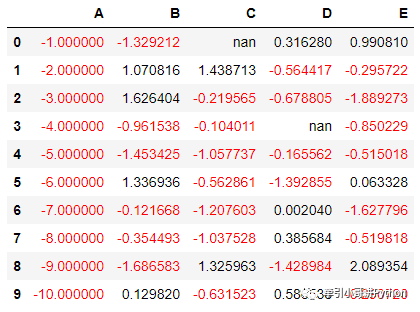
假设为DataFrame建立了一个样式,想将相同样式应用于第二个DataFrame。使用df1.style.export导出样式。

df2 = -df
style1 = df.style.applymap(color_negative_red)
style1
style2 = df2.style
style2.use(style1.export())
style2
7. 其他样式

精度set_precision

df.style.applymap(color_negative_red).apply(highlight_max).set_precision(2)
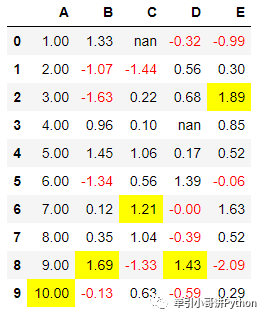
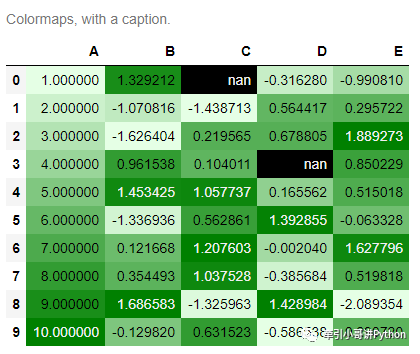
标题set_caption

df.style.set_caption('Colormaps, with a caption.')\
    .background_gradient(cmap=cm)
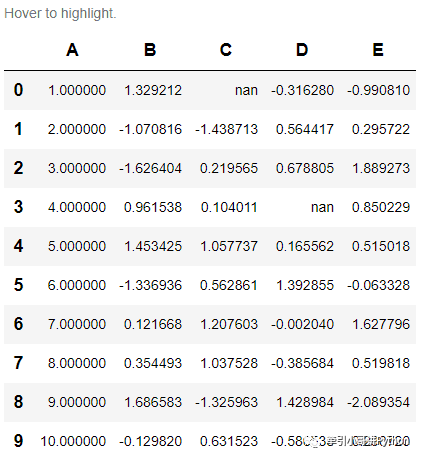
表格整体样式set_table_styles

from IPython.display import HTML

def hover(hover_color="#ffff99"):
    return dict(selector="tr:hover",
                props=[("background-color", "%s" % hover_color)])

styles = [
    hover(),
    dict(selector="th", props=[("font-size", "150%"),
                               ("text-align", "center")]),
    dict(selector="caption", props=[("caption-side", "top")])
]
html = (df.style.set_table_styles(styles)
          .set_caption("Hover to highlight."))
html
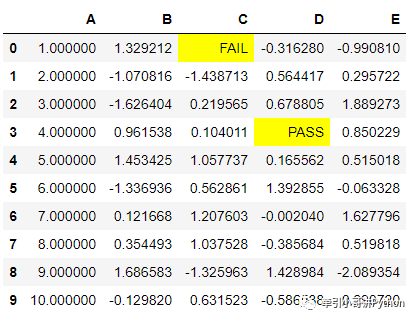
缺失值set_na_rep

(df.style
   .set_na_rep("FAIL")
   .format(None, na_rep="PASS", subset=["D"])
   .highlight_null("yellow"))
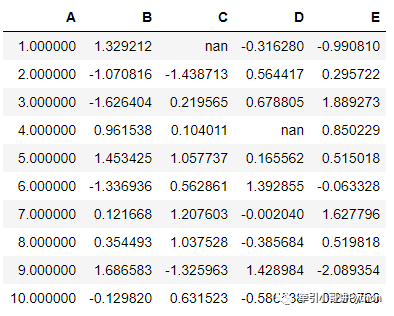
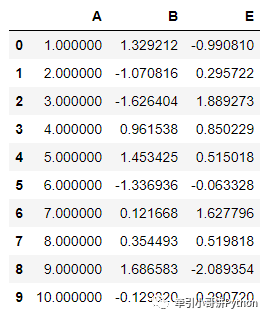
隐藏索引hide_index或列hide_columns

# 隐藏索引
df.style.hide_index()
#隐藏列
df.style.hide_columns(['C','D'])
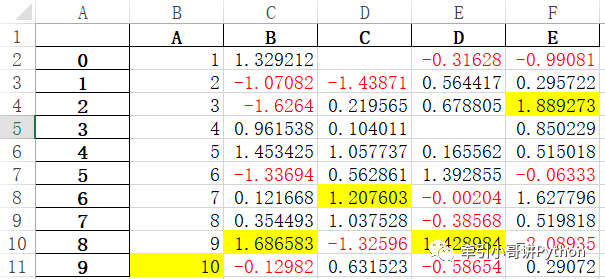
8. 导出为Excel(还在开发实验阶段)

DataFrames 使用「OpenPyXL」或「XlsxWriter」引擎可以将样式导出到Excel工作表。CSS2.2处理的属性包括:

  • background-color

  • border-style, border-width, border-color and their {top, right, bottom, left variants}

  • color

  • font-family

  • font-style

  • font-weight

  • text-align

  • text-decoration

  • vertical-align

  • white-space: nowrap

  • 当前仅支持CSS2命名或十六进制颜色,格式为 #rgb或#rrggbb。

df.style.\
    applymap(color_negative_red).\
    apply(highlight_max).\
    to_excel('styled.xlsx', engine='openpyxl')
以上内容参考自:https://pandas.pydata.org/pandas-docs/stable/user_guide/style.html

SAP ABAP Append structure 介绍 所有在 append structure 上增强的字段都是 append structure 的一部分,这意味着对这些增强所做的任何更改仅仅施加在 append structure 上,而不会影响被增强的 ABAP DDIC 结构。这同样适用于 transport. 激活数据库表或结构时,会找到所有关联的 append structure,并将它们的组件附加到数据库表或结构。Append structure(附加结构)是 ABAP 字典中附加到另一个结构或数据库表并将其组件附加到它们的结构。 阅读详情

相关推荐

PDPS16.0单机版与SPLMLicenseServer授权避坑指南:从安装到冲突解决

本文详细解析了PDPS16.0单机版的安装与授权流程,重点阐述了如何正确配置SPLMLicenseServer本地许可证服务器以实现软件激活。针对安装过程中常见的许可证冲突问题,提供了清晰的排查思路和解决方案,并介绍了通过设置环境变量等替代授权方法,帮助用户高效避坑,确保Tecnomatix Process Simulate顺利运行。

weixin_29231221的博客 570

Pandas表格样式,你有table-style吗

Pandas提供了style功能,可以直接实现excel里的高亮、色阶、数据条、单元格格式设置、字体设置等等功能,简单场景下不需要把数据导出再调整样式了,本文逐条盘点一下

机器学习、深度学习、文本分类、异常检测、风控等知识的积累和分享 1131

【IC设计实战】去耦电容decap在电源完整性中的关键作用与选型策略

本文深入探讨了去耦电容(decap)在IC设计电源完整性中的核心作用。文章分析了decap如何通过提供本地电荷缓冲来抑制电源噪声与电压波动,并详细阐述了其选型与布局策略,包括MIM、MOM、MOS电容的特性对比,以及如何权衡峰值抑制与建立速度的矛盾,为设计稳定可靠的芯片电源系统提供实践指导。

weixin_29233857的博客 250

pandas style格式化数据

对数据的格式化是pandas经常遇到的,使用style属性也可以进行。 python如何对数字和字符格式化可以参考以下文章:python格式化 下面对使用style格式化做出相应说明: import pandas as pd import numpy as np np.random.seed(24) df = pd.DataFrame({'A': np.linspace(1, 10, 10)}) df = pd.concat([df, pd.DataFrame(np.random.randn(10, 4),

weixin_45144170的博客 5735

VMware虚拟机的安装教程

VMware 虚拟机的备份与恢复是保障数据安全和业务连续性的重要措施。综上所述,VMware 虚拟机的备份与恢复策略有多种选择,企业和用户可以根据实际需求和资源情况选择适合自己的方案,以确保虚拟机数据的安全和业务的连续性。

huanghm88的专栏 3021

UG\NX二次开发 一个创建小平面体的例子

介绍。

王牌飞行员_里海的博客 446

pandas style属性的设置(一)

首先,回答一下上篇文章中的一个问题,为什么最终在目前常用的开发工具中,需要选择jupyter notebook作为学习style属性的开发工具? 在pandas style的官方文档中,有这样一句note,意思大致是这样的:style属性本身会返回object对象,这个对象内部有一个_repr_heml_方法,可以转为html语言,可以调用.render()方法,查看其html语言及css样式。 css样式在程序里是可以被浏览器识别的,而jupyter notebook本身是运行在网页上的开发工...

weixin_45144170的博客 5244

三甲医院等级评审八维数据分析应用(三)--主数据管理篇(上)

三甲医院主数据范畴涵盖了医院运营与医疗服务全过程所涉及的核心业务实体信息,这些主数据是医院信息系统流畅运行、数据交互共享以及管理决策精准制定的基石。患者主数据作为核心要素之一,囊括了患者的基本身份信息,如姓名、性别、年龄、身份证号、联系方式等,这些信息是患者在医院就诊流程中的身份标识,贯穿挂号、就诊、检查检验、住院、出院结算等各个环节。患者的医保信息同样关键,包括医保类型、参保地、医保卡号等,直接关联医疗费用报销流程,影响医院财务结算与医保部门的数据交互。

AllenLV的博客 1660

python--pandas样式

pandas的DataFrame类拥有style属性,style属性返回Styler类, Styler类的applymap和apply等方法可以很方便的对表格样式做自定义调整。 环境 python3.9 win10 64bit pandas==1.2.1 快速了解 先通过一个实例快速了解style的设置方法和效果。 import pandas as pd import numpy as np # 构造数据框 np.random.seed(24) df = pd.DataFrame(np.random.

jhr112的博客 7728

SAP 清账凭证 完整生成逻辑(超详细原理 + 底层规则 + 分录逻辑 + 互清特殊规则)

【SAP清账凭证核心逻辑摘要】(149字) SAP清账凭证生成遵循两大类型:1)资金往来对冲型(如F-32/F-44互清),强制生成含完整借贷分录的独立凭证,通过AUGDT/AUGBL字段绑定未清项,典型场景如应收冲应付(借:应付账款 贷:应收账款);2)纯核销型(如F.13自动清账),仅标记行项目状态不产生实际分录。关键规则:①仅未清项管理科目可清账;②互清必须配置主数据关联;③差额清账自动补差(折扣/汇差);④原始凭证永不修改,仅更新BSIK/BSAD等表状态。清账凭证均保留可追溯性,支持FBRA重置还

金牌架构师 547

Python爬虫实战:全自动采集银行理财产品收益率数据

本文通过Playwright动态爬虫技术,成功实现了对银行理财产品收益率数据的实时采集,并通过 Pandas 数据清洗、SQLite 存储、调度自动化等模块,构建了一个可扩展的银行理财数据抓取系统。理财非儿戏,数据做决策。掌握银行收益信息是我们迈向理性投资的第一步。希望这套工具对你有所帮助!

2201_76125261的博客 1162

Pandas表格美颜技巧

本文中主要介绍的是:如何来美化Pandas的DataFrame的数据。主要是通过Pandas中的两个方法来实现:Styler.applymap:逐个元素,返回带有CSS属性-值对的单个字符串Styler.apply:列、表、行的方式,返回具有相同形状的Series或者DataFrame,其中每个值都是带有CSS属性值对的字符串。该方法在作用的时候,通过参数axis来传递,axis=0表示按列作用,axis=1表示按行作用。

Python数据挖掘 842

广义S变换在MATLAB中的仿真

广义S变换是对信号进行时频分析的一种方法,它基于短时傅里叶变换(Short-Time Fourier Transform,STFT)和小波变换(Wavelet Transform)。广义S变换将信号分解成时频平面上的一系列矩形框,每个框内的数值表示相应时刻和频率下信号的能量。本文将介绍如何使用MATLAB进行广义S变换的仿真,并提供相应的源代码。函数,我们可以方便地计算信号的广义S变换,并获取时频平面上的时域和频域信息。广义S变换在信号处理和相关领域中具有广泛的应用,可以用于分析和处理各种类型的信号。

CodeNexus的博客 1124

【建议收藏】Python 江湖兵器谱:从入门到入土,这篇万字长文让你玩转各大神库!

return "准点下班,走向人生巅峰!else:print(f"还有 {bugs} 个 Bug,继续肝!")return "头发掉光,但代码终于跑通了!编程是一场没有终点的修行。Python 生态的繁荣,给了我们最好的武器库。但真正决定你能走多远的,永远是你解决问题的思维和持续学习的心。别犹豫了,打开你的终端,输入(或者uv add),开始你的江湖之旅吧!🚀你在 2026 年最离不开的 Python 库是哪个?或者有什么"冷门但超好用"的神库?欢迎在评论区留言交流,看看谁的兵器最锋利!

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 813

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

Python 数据处理 —— pandas 表格样式

讲到这里,Python的数据处理部分已经写的差不多了。学完了前面的部分,差不多已经能够熟练的处理各种各样的数据了。在本系列的最后,我们将介绍如何展示数据,当然,并不是数据的可视化,而是像Excel表格一样,设置数据的颜色、字体、大小等样式在pandas中,通过属性,可以获取一个Styler对象,该对象提供了方法,让我们很方便的格式化和展示DataFrame数据样式的设置是通过CSS来完成,所以,所有的代码需要在中运行:逐元素是将函数应用于每个元素上的函数接受一个标量值,返回一个属性-值对的。

dxs18459111694的博客 2101

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

pandas style添加表格边框,或是只添加下边框等自定义边框样式设置

【代码】pandas style添加表格边框,或是只添加下边框等自定义边框样式设置。

呆萌的代Ma 1321

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

10Python的Pandas:样式Style

Pandas 提供了多种样式选项,可以让你对数据框的显示进行格式化。这些样式可以帮助突出显示数据中的某些元素、设置颜色、格式化数字等。

XiaoCai 1425

Pandas 2 使用指南:表格可视化

在对 DataFrame 的数据进行处理之后,应该执行样式和输出显示的自定义操作。如果对 DataFrame 进行进一步更改,Styler 不会动态更新。属性是一个返回Styler对象的属性。它在 Jupyter Notebook 中自动呈现,因为它在其上定义了方法。HTMLLaTeX字符串(通过扩展支持 CSV)Excel(JSON 目前不可用)前三种格式都有用于格式化和自定义输出的显示自定义方法。使用.format()和格式化值、索引和列标题,使用重命名索引或列标题标签,

数智笔记 2388

pandas 学习笔记15 pandas样式

1 内置样式 import pandas as pd import numpy as np #内置样式 df.style Styler CSS 实现 依赖库jinja2 df = pd.read_excel(r'D:\pythonproject\pythonVsc\pandas\data\team.xlsx') df.style #样式对象,可显示所有数据 type(df.style) #查看样式 pandas.io.formats.style.Styler # 空值高亮 style.highligh

weixin_43237709的博客 2900

Pandas数据分析25——pandas数据框样式设置

pandas像excel表一样做条件样式,给数据标注和填充不同的颜色,方便观察和可视化

weixin_46277779的博客 6093

五种Pandas图表美化样式汇总

我们在做excel表格的时候,常常会对重要数据进行highlight,或者用不同颜色表示数据的大小。Pandas是一种高效的数据处理库,它以dataframe和series为基本数据类型,呈现出类似excel的二维数据。Pandas中的数据美化样式不仅可以展示在notebook中,还可以输出到excel。一般的,我们需要将样式函数作为参数传递到下面方法中,就可以实现图表美化。Excel条件格式里,有一个数据条显示方式,用以可视化表达数据大小。色阶也就是热力图,它和数据条一样,都用来表达数据大小。

分享Python、数据分析、人工智能前沿知识 882

pandas 笔记 style 调整DataFrame格式

用作浮点数、复数和整数的十进制分隔符的字符。浮点数、复数和整数的千位分隔符的字符。

qq_40206371的博客 892

Pandas:利用Styler对象设置Series、Dataframe在Jupyter Notebook中的输出样式(1)——基础接口

当前pandas版本为:1.2.5。 概述 Jupyter Notebook能够风靡Python数据科学圈的重要原因之一就是可以便捷的显示pandas数据结构。 pandas数据结构在Jupyter Notebook中的格式化依赖于pandas中的Styler对象。Dateframe.style属性返回值为Styler对象。 Styler对象通过生成CSS样式进行格式化。 Styler类定义在pandas/io/formats/style.py中,具体原理随后详述。 接口 格式化主要通过以下方法实现。 S

mighty13的专栏 3万+
上一篇: 快上车吧!手把手带你精准解读计算机视觉原始论文细节阅读
下一篇: CPU为什么是方形而不是圆形的?
Wang_AI
博客等级 码龄12年 998粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值