Enterprise:Elastic App Search 入门 - Ruby

高级搜索变得简单。Elastic App Search 的精心策划的经验将 Elasticsearch 的专注能力带入了一组完善的 API 和直观的仪表板。 利用无缝的可伸缩性,可调的相关性控件,详尽的文档,维护良好的客户端以及强大的分析功能,可以轻松构建领先的搜索体验。
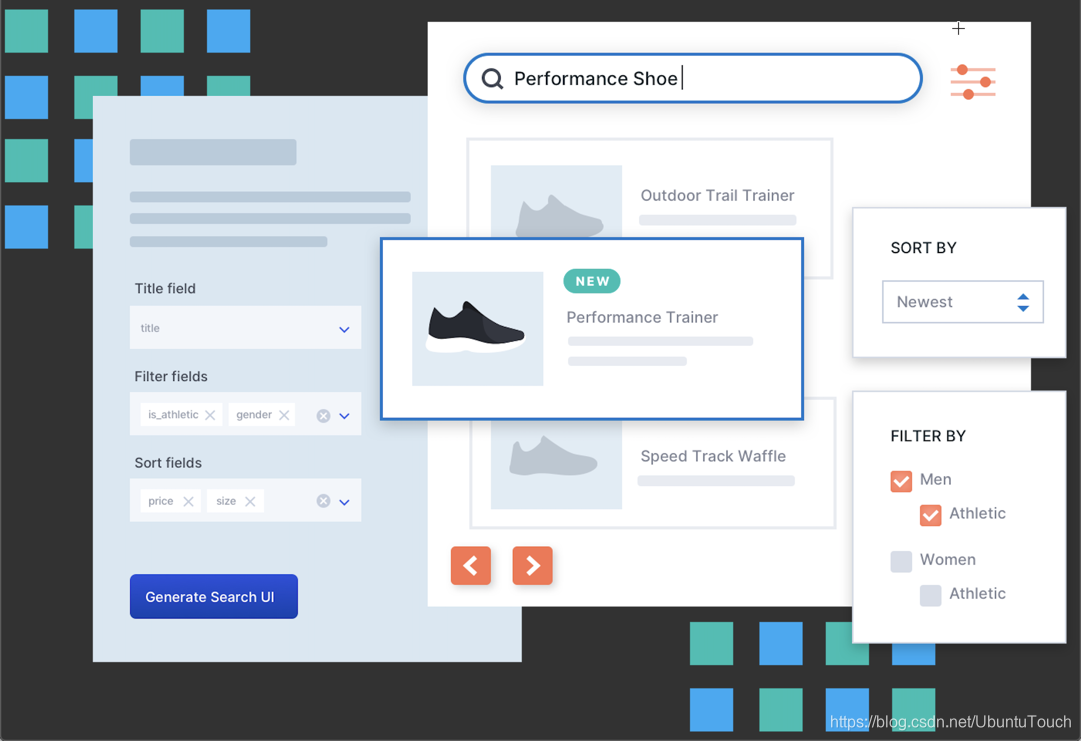
在今天的文章中,我们将详细地一步一步地介绍如何构建一个完整的 Elastic App Search 应用。

Elastic App Search 展示

什么是 Elastic App Search?

简单地说,Elastic App Search 是一组功能强大的 API 和开发人员工具,旨在为开发人员构建丰富的,面向用户的搜索应用程序。开箱即用的一些功能包括:

  • 与搜索用例的优化相关性
  • 容忍错误的输入
  • 相关性微调
  • 第一方 API 客户端和强大的 API
  • 详细的 API 日志和搜索分析
  • 自动扩容和运营支持
  • Search UI 库

Elastic App Search 架构

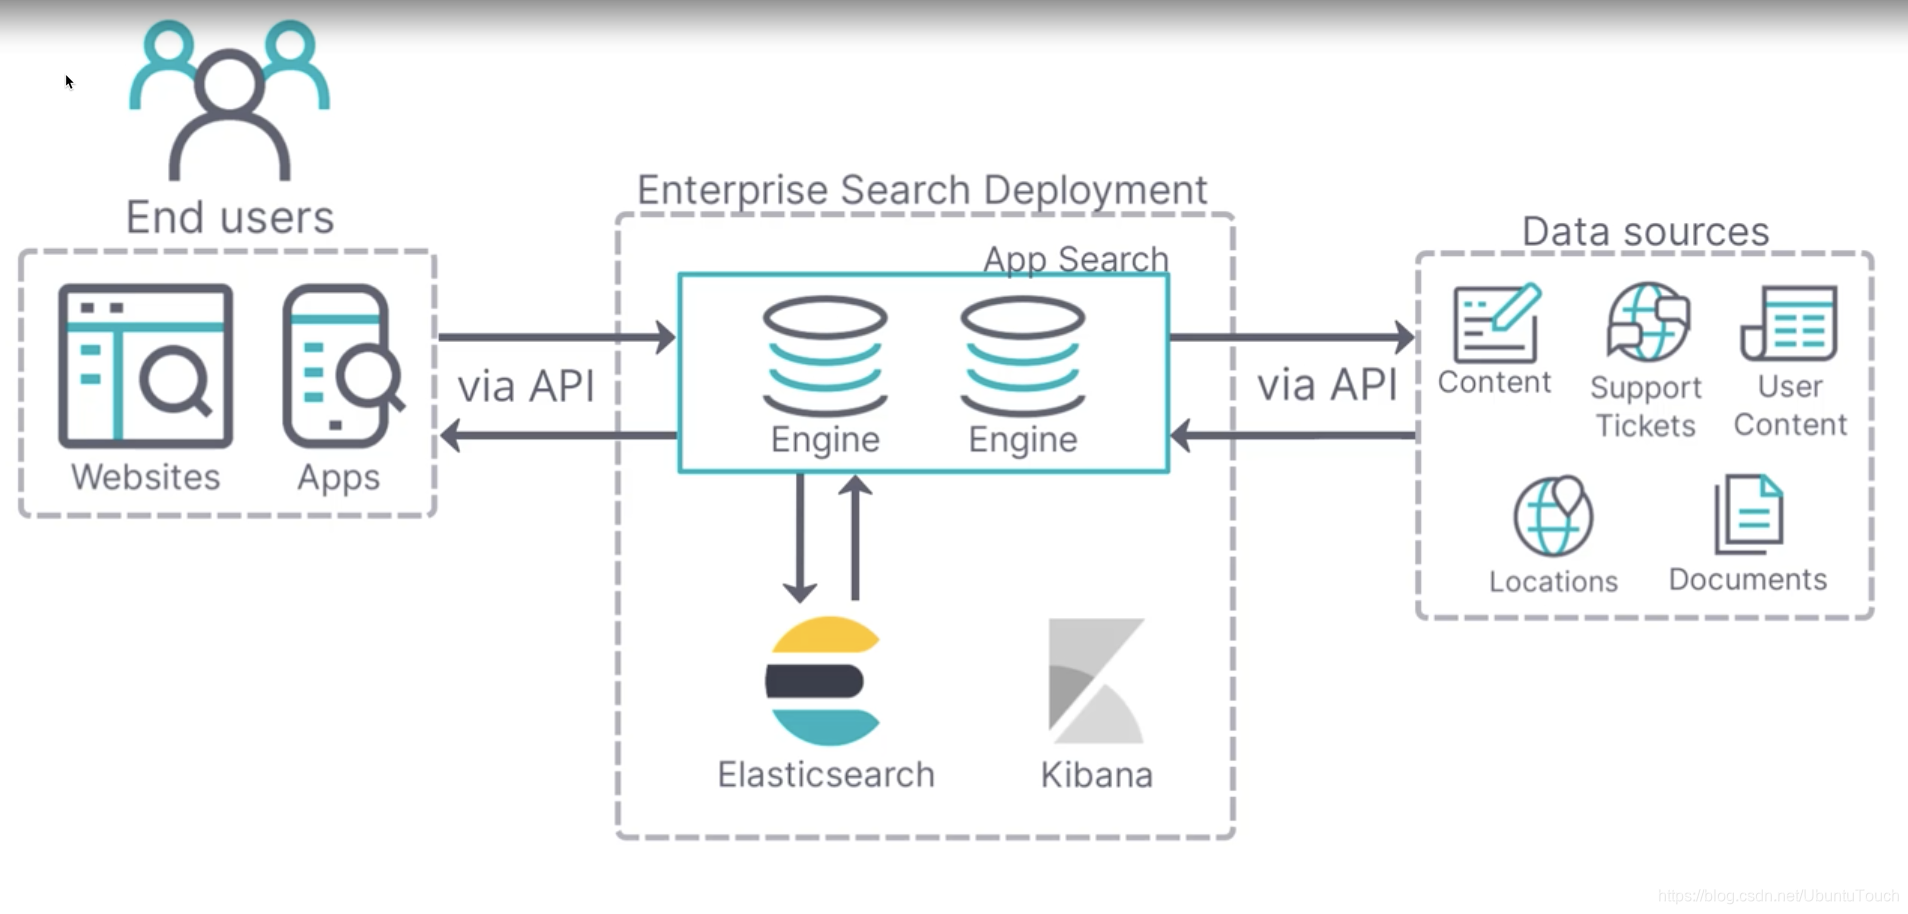
架构图如下:
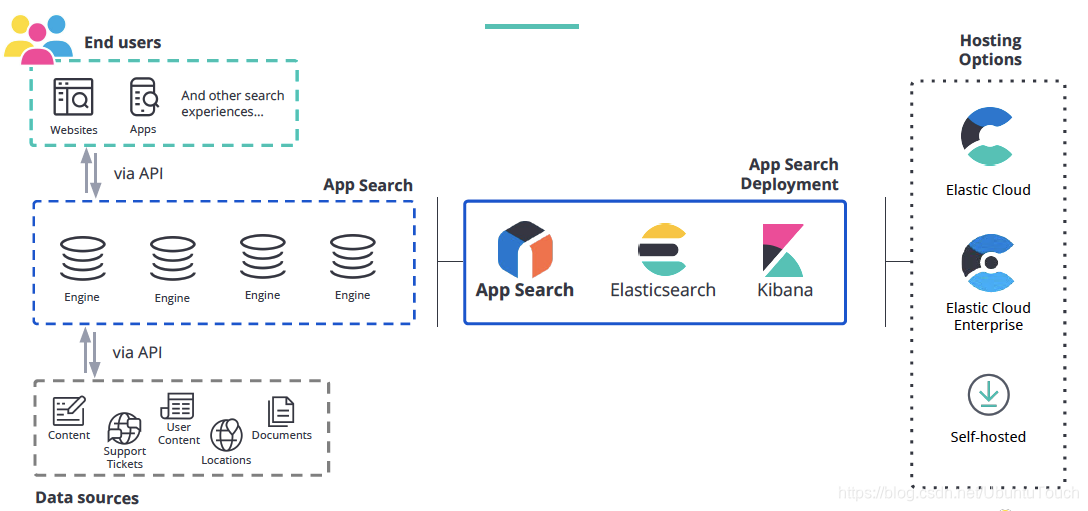
将数据摄取到 App Search 后,你可以轻松地通过 API 将你的应用程序连接到引擎,为你的最终用户创造强大的搜索体验。Enterpise Search 的部署通常由 Elasticsearch,Kibana 及 Enterprise Search 组成。App Search 是一组搜索引擎。 每个都有自己的一组文档,你可以在其中运行查询、调整相关性和探索搜索分析。数据源通过 API 或网络爬虫被摄入到引擎中。 数据源可以是技术支持票证、站点、电子商务库存、分支机构位置或你想从应用程序中搜索的任何数据。

App Search 允许你将搜索添加到你可能正在使用的任何类型的应用程序。 要成功设置你的搜索引擎,需要遵循几个步骤。 让我们来看看它们:
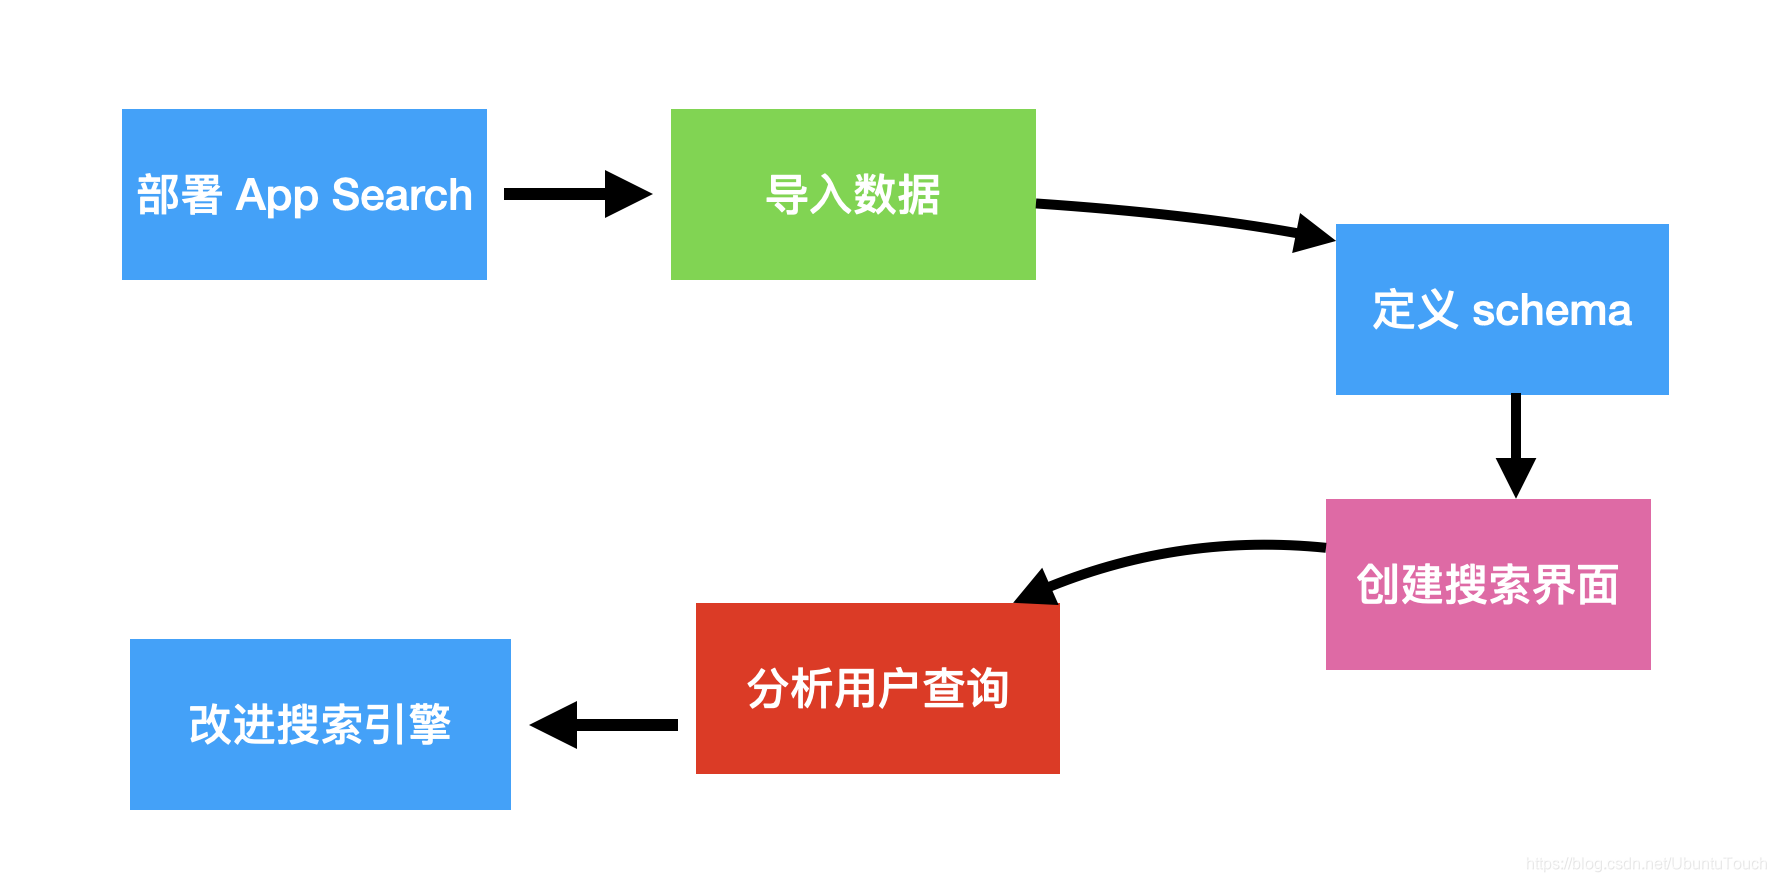
  • 部署 App Search:第一步是部署 App Search,它由 Enterprise Search、Kibana 和 Elasticsearch Servers 组成
  • 导入数据:创建一个引擎并索引你要搜索的数据
  • 定义 schema:索引数据时,会创建默认架构。 为了优化体验,你需要调整这个schema
  • 创建搜索界面:你已将文档索引到你的引擎中,现在你需要创建一个搜索界面以允许用户使用此搜索引擎
  • 分析用户查询:你用户的查询会登录到 App Search。 分析它们以更好地了解用户的行为并找出引擎的弱点
  • 改进搜索引擎:在分析方面,通过调整引擎的相关性、设置同义词和筛选并展示(curations)来改善你的搜索体验

安装

安装 Elasticsearch

我们可参考我之前的文章 “如何在 Linux,MacOS 及 Windows 上进行安装 Elasticsearch” 来安装 Elasticsearch

安装 Kibana

我们接下来安装 Kibana。我们可以参考我之前的文章 “如何在 Linux,MacOS 及 Windows 上安装 Elastic 栈中的 Kibana” 来进行我们的安装。

Java安装

你需要安装 Java。版本在 Java 8 或者 Java 11。

App search 安装

我们在地址 https://www.elastic.co/downloads/app-search 找到我们需要的版本进行下载。并按照相应的指令来进行按照。如果你想针对你以前的版本进行安装的话,请参阅地址 https://www.elastic.co/downloads/past-releases#app-search。

如果我们不对 Elasticsearch 或 app-search 做任何的配置的话,我们会看到如下的错误信息:
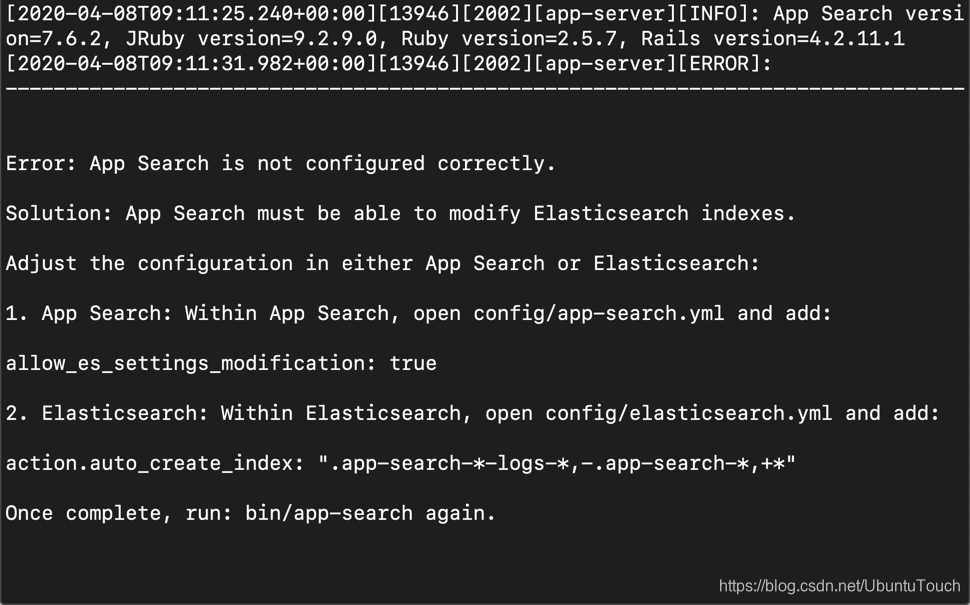
按照要求,我们也需要对我们的 Elasticsearch 的配置进行修改。在 Elasticsearch 的安装根目录中打开文件 config/elasticsearch.yml 文件,并添加如下的配置:

action.auto_create_index: ".app-search-*-logs-*,-.app-search-*,+*"

等修改完后,我们重新启动 Elasticsearch:

./bin/elasticsearch

我打开 App search 安装目录下的 confing/app-search.yml 文件,并添加如下的配置:

allow_es_settings_modification: true

我们保存配置文件,并重新启动 app-search:

./bin/app-search

如果我们配置正确的话,这次我们的 App search 的启动将是成功的。

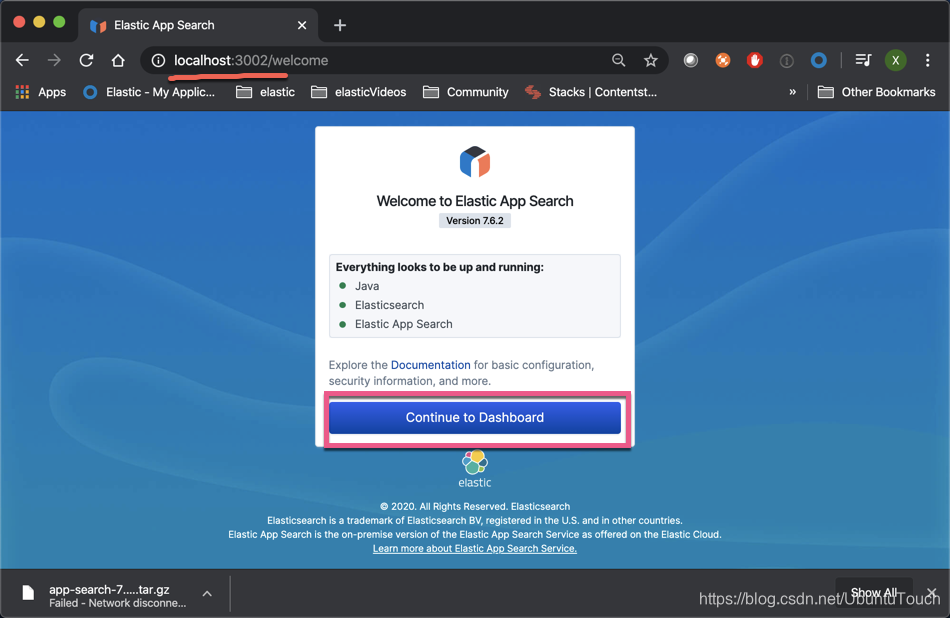
对于第一使用的开发者来说,你可能找不到 App search 的用户界面在哪里。你在自己的浏览器中输入地址 http://localhost:3002。这样你就可以看到如下的界面:
导入数据

点击上面的 Continue to Dashboard 按钮:
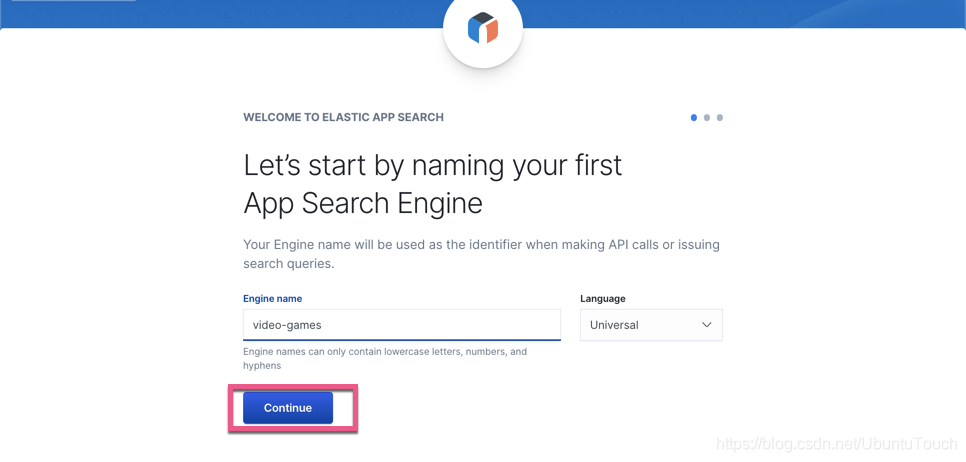
下载 最佳视频游戏数据集 到本地的电脑的硬盘里。这个数据的名字叫做 games-array.json。如果由于一些原因,你不能下载这个文件,请到地址 https://github.com/liu-xiao-guo/elastic_app_search 去下载。

在 Engine name 里,我们输入 video-games,并点击上面的 Continue 按钮:
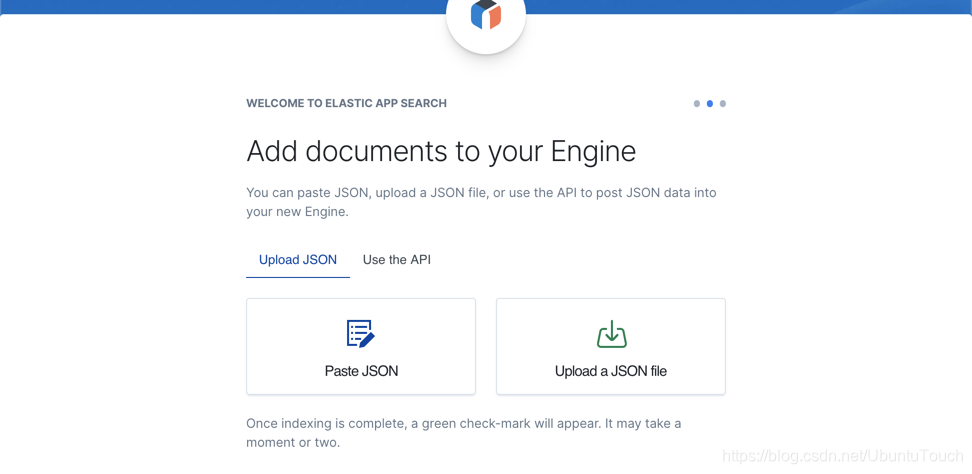
这样我们的 video-games 引擎已经被成功地创建了。我们可以按照上面的 Upload a JSON file 按钮来装载我们的数据。但是在今天的练习中,我们将展示如何使用API接口的方法把我们的数据导入到 Elasticsearch 中。我们点击上面图中的 Use the API 超链接:
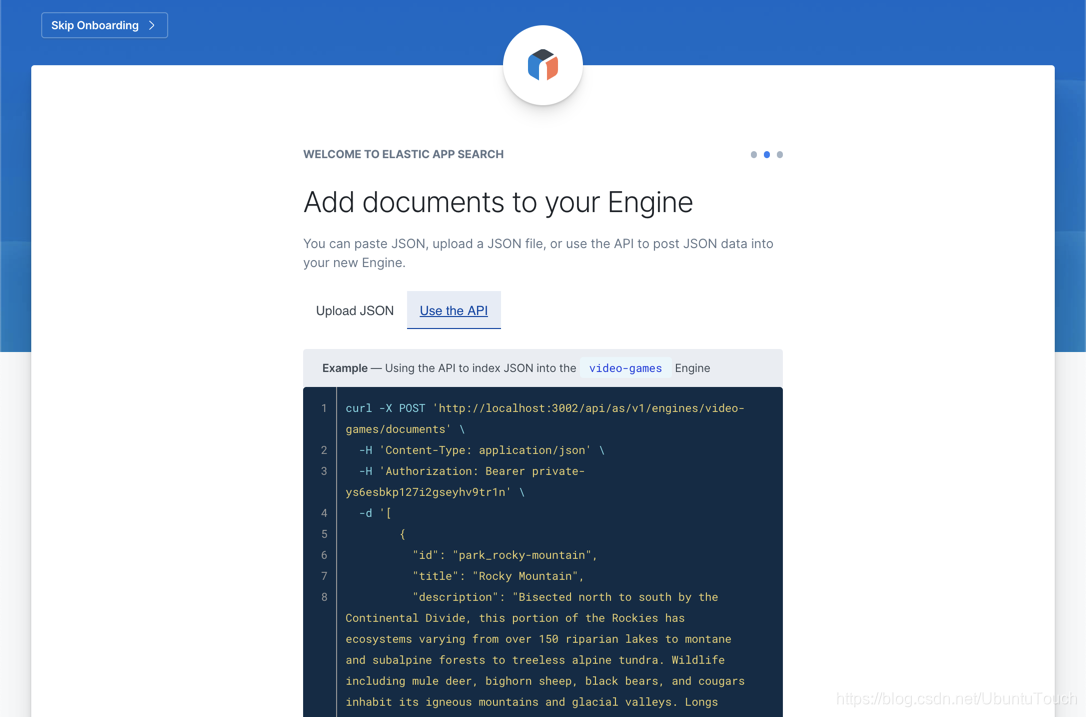
我们会发现在这里有如何通过 API 的方式把我们的数据导入到 Elasticsearch 中。在今天的演示中,我们将使用 ruby 来把数据导入。你也可以根据自己喜欢的语言把数据进行导入。我们创建一个叫做 upload.rb 的文件:

upload.rb

require 'elastic-app-search'
require 'json'
require 'progress_bar'


API_ENDPOINT = ''
API_KEY = ''
ENGINE_NAME = ''

client = Elastic::AppSearch::Client.new(:api_key => API_KEY, :api_endpoint => API_ENDPOINT)
file = File.read('./games-array.json')
data = JSON.parse(file)
bar = ProgressBar.new(data.count / 100)

data.each_slice(100) do |slice|
  client.index_document(ENGINE_NAME, slice)
  bar.increment!
end

在上面,我们需要填入自己 App search 的配置:

  • API_ENDPOINT: 这个可以在我们上面的截图中可以看出来:http://localhost:3002/api/as/v1/
  • API_KEY: 这个是我们访问 App search 服务器的 key。在上面的 API 接口的 Authorization 部分可以看到:private-ys6esbkp127i2gseyhv9tr1n
  • ENGINE_NAME:这个就是我们之前定义的那个引擎的名称 videos-games

我们将上面的信息填入到 upload.rb 中。在运行上面的 ruby 应用之前,我们需要安装上面三个需要的库:

sudo gem install progress_bar
sudo gem install elastic-app-search
sudo gem install json

我们的工作目录中的文件是:

$ pwd
/Users/liuxg/data/appsearch
liuxg:appsearch liuxg$ ls
games-array.json upload.rb

然后在 terminal 中打入如下的命令:

ruby upload.rb

显示结果为:

$ ruby upload.rb 
[#####################################] [5/5] [100.00%] [00:02] [00:00] [1.99/s]

这样我们的数据就导入到 Elasticsearch 中了。这个时候在我们的 App search 界面,我们可以发现:
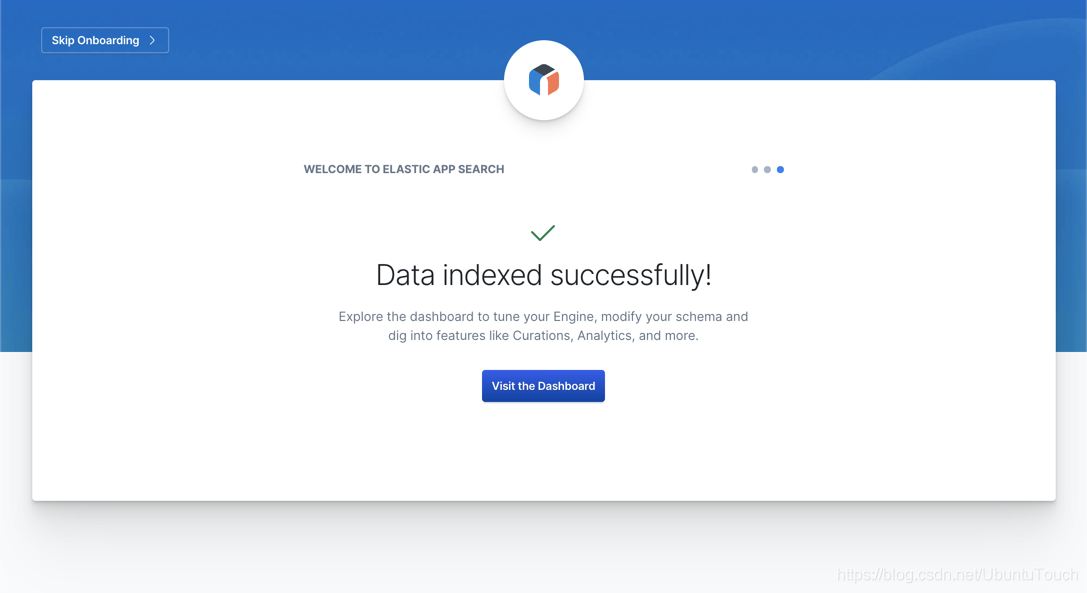
它显示我们的数据已经被成功地导入到 Elasticseach 中了。

搜索引擎: Elastic App Search

我们点击上面的 Visit the Dashboard 按钮:
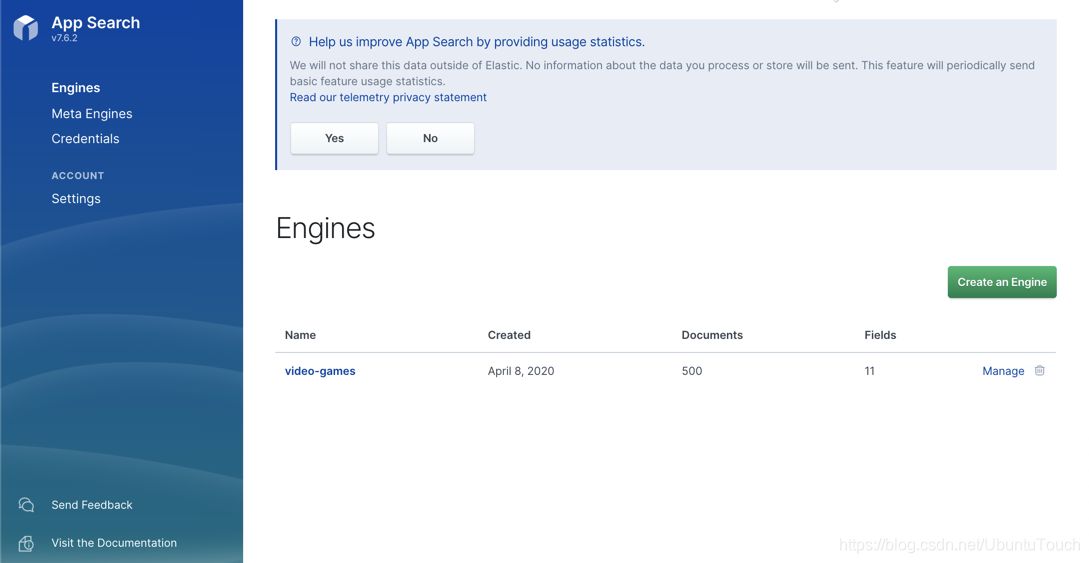
我们在这个页面可以点击一下 Credentials,你也可以发现我们的 private-key 在这里:
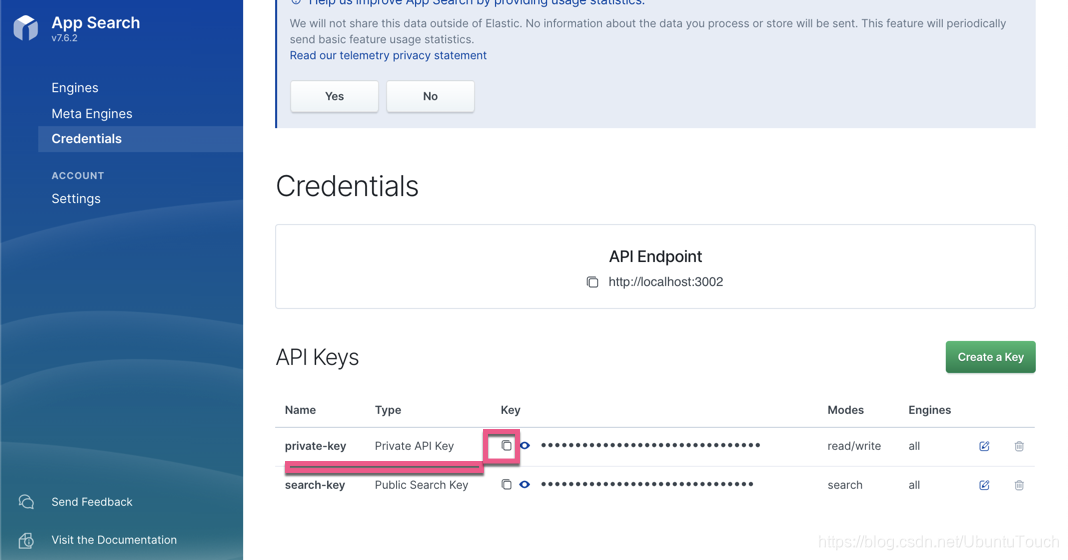
我们可以点击 copy 图标来得到我们所需要的 private-key。按照同样的方法,我们也可以得到 search-key。

我们接下来点击 Engines:
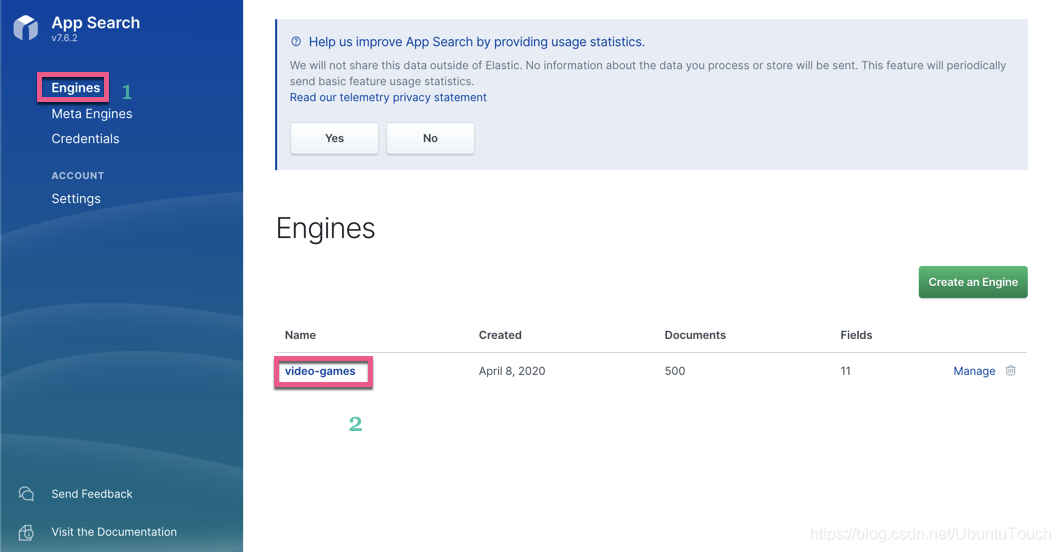
我们点击上面的 video-games:
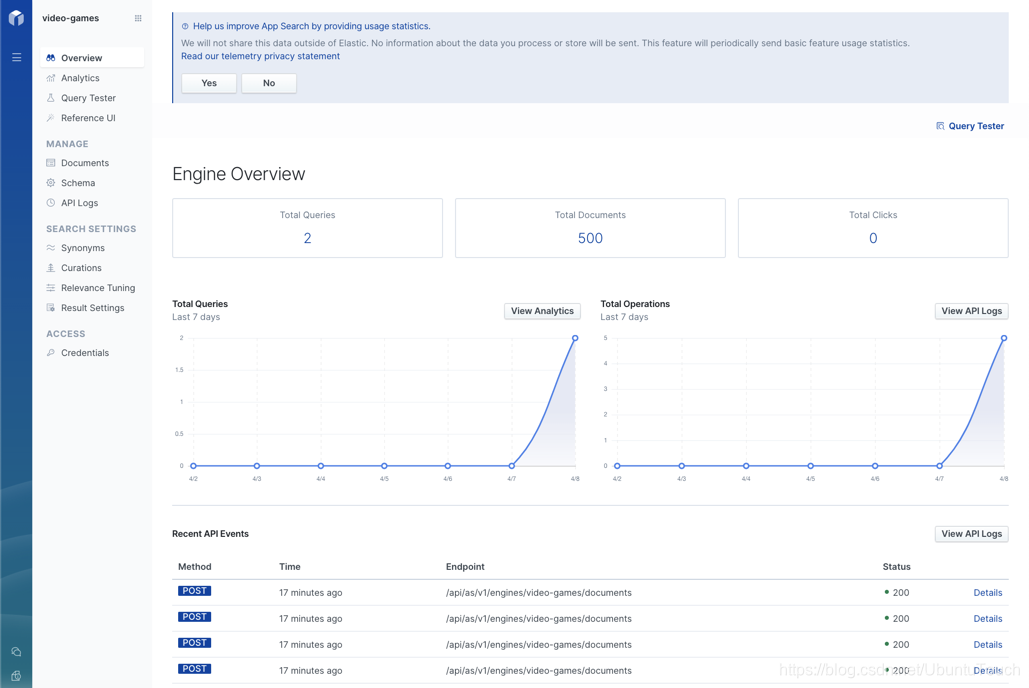
从上面我们可以看到整个 video-engine 的统计情况。它显示我们共用500个文档。同时我们也可以看到所有的 API 的使用情况。如果你发现有任何的问题,你可以点击 View API Logs 来查看 API 的使用情况:
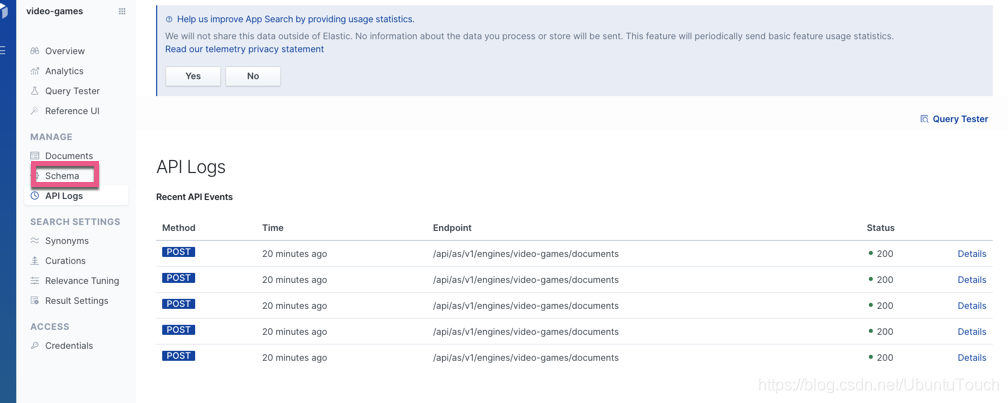
我们接着下来想修改索引的 schema,这是因为在默认的情况下,所有的11个字段都被视为 text 类型。
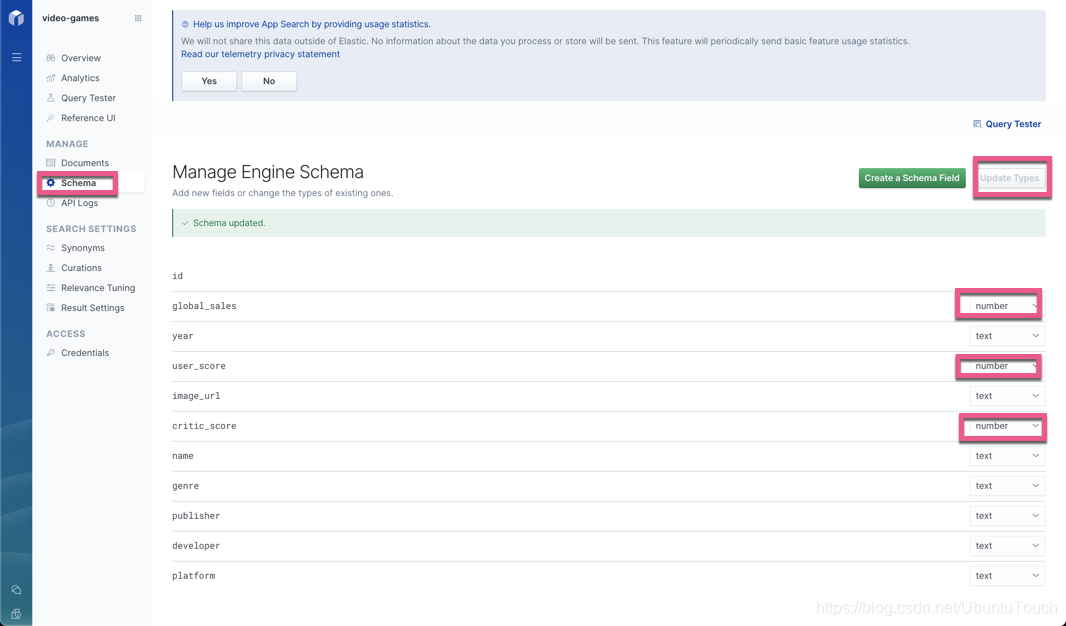
在完成我们的修改过后,点击 Update Types 按钮。这样我们的索引将会被重新更新。我们点击 Documents:
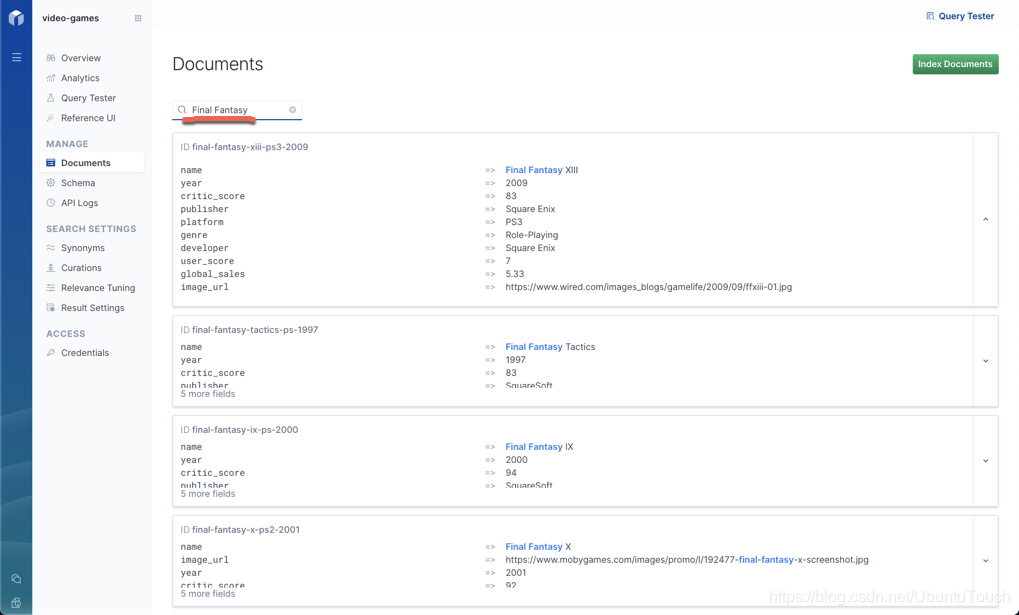
在这里,我们可以看到所有的文档。我可以尝试在 Filter documents 的位置输入一个关键词,比如 Final Fantasy 。我们可以看到所有被搜索到的文档。

调节相关度

具有三个关键的相关功能:Synonyms,Curations 和 Relevance Tuning。
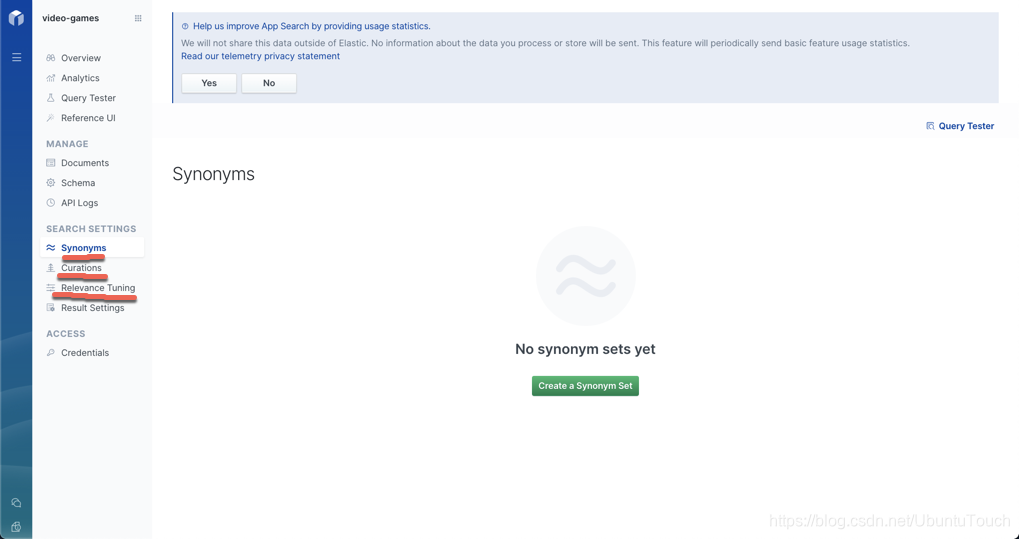
Synonyms

世界各地的人们使用不同的词来形容事物。 同义词可帮助你创建被视为一个或一组相同的术语集。

就 video game 搜索引擎而言,我们知道人们会希望找到 Final Fantasy。 但是也许他们会改用FF。

单击进入同义词,然后选择创建同义词集并输入术语:
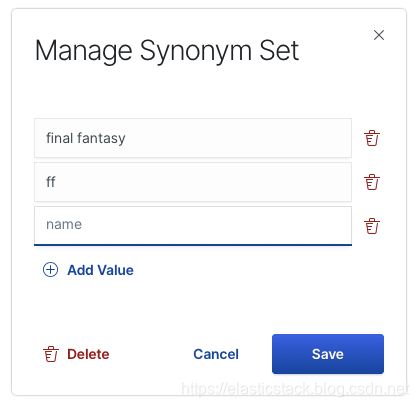
单击 Save。 你可以根据需要添加任意多个同义词集。

现在,搜索 FF 与搜索 Final Fantasy 的权重相同。
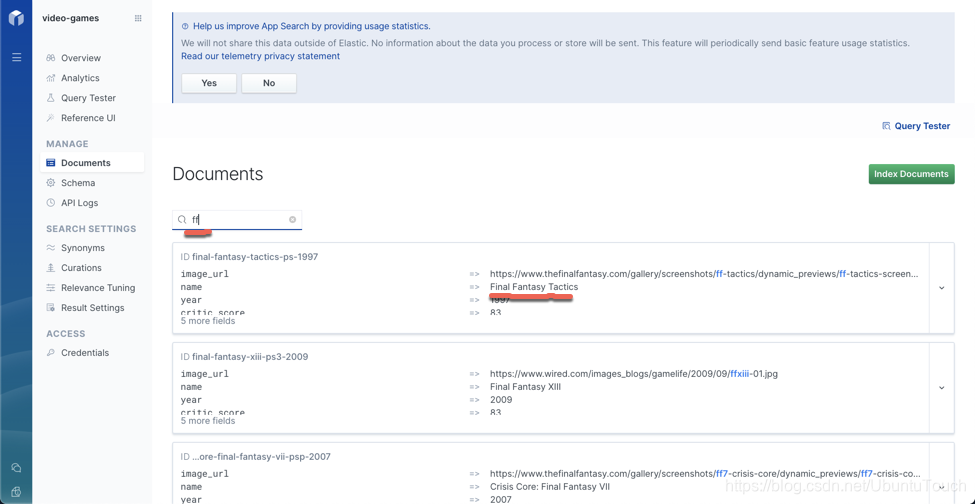
Curations

Curations 是另一种可用于优化搜索体验的工具。 Curation 允许你手动提升或隐藏特定查询的文档。 Curation 可用于增加每次点击的搜索比率或执行推广特定内容的活动。

Curations 是最最让人喜欢的。 如果有人搜索 Final Fantasy 或 FF,该怎么办? 系列赛中有很多游戏-他们会得到哪些?

默认情况下,前五个结果如下所示:

  1. Final Fantasy VIII
  2. Final Fantasy X
  3. Final Fantasy Tactics
  4. Final Fantasy IX
  5. Final Fantasy XIII

这似乎不正确……Final Fantasy VII 是所有游戏中最好的 Final Fantasy 游戏。 而且 Final Fantasy XIII 不是很好! 😜

我们可以做到这一点,以便搜索 Final Fantas y的人会收到 Final Fantasy VII 作为第一结果吗? 我们可以从搜索结果中删除 Final Fnatasy XIII 吗?

我们可以!

单击 “Curations”,然后输入查询:“Final Fantasy”。

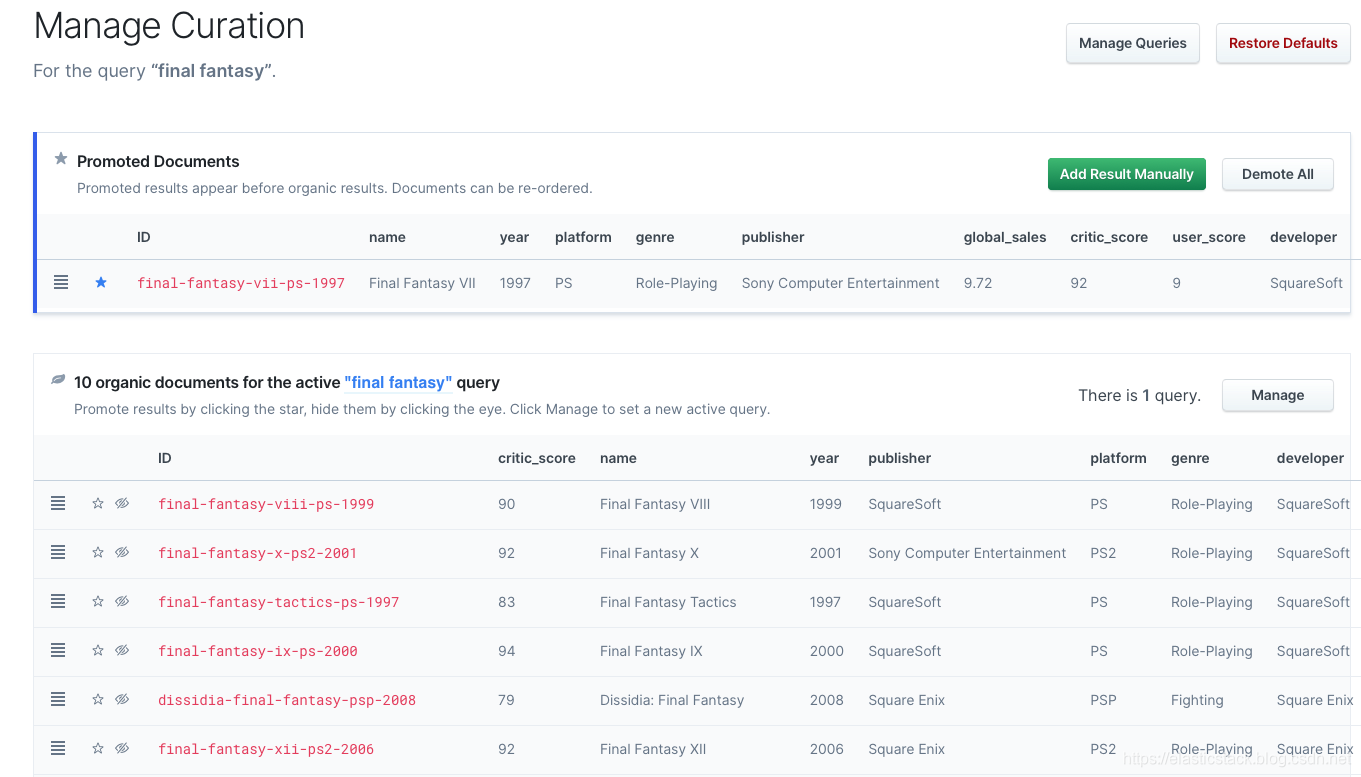
接下来,通过抓住表格最左侧的把手将 “Final FantasyVII” 文档拖到 “Promoted Documents” 部分:
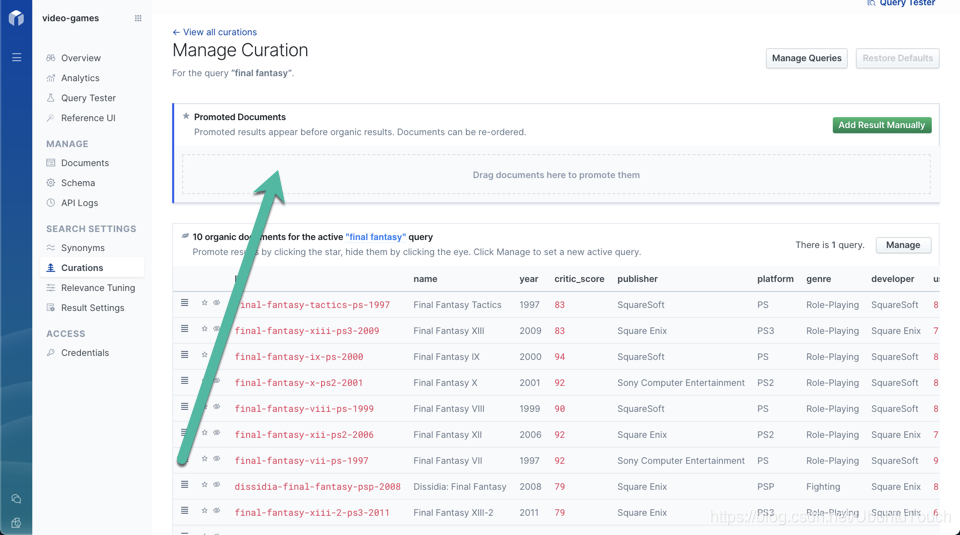
然后单击 “Final Fantasy XIII” 文档上的 “Hide Result” 按钮(那个有一条线穿过眼睛的图标,下图列表中第三个图标):
现在,执行 “Final Fantasy” 或 “FF” 搜索的任何人都将首先看到 “Final Fantasy VII”:
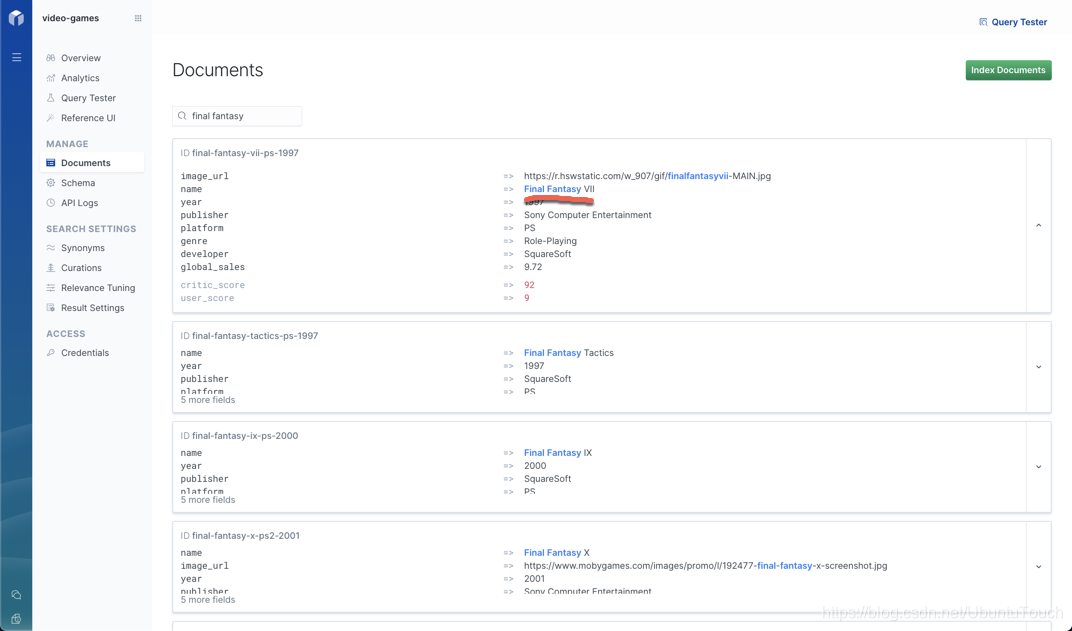
他们根本看不到 Final Fantasy XIII。 哈!

我们可以升级和隐藏许多文档。 我们甚至可以对升级后的文档进行排序,因此我们可以完全控制每个查询顶部显示的内容。

Relevance tuning

单击边栏中的 “Relevance Tuning”。

我们搜索一个文本字段:name 字段。 但是,如果我们有多个文本字段可供人们搜索,例如 name 字段和 description 字段,该怎么办? 我们正在使用的 video game 数据集不包含 description 字 段,因此我们假想一些文档以进行仔细考虑。

说我们的文档看起来像这样:

{ 
  "name":"Magical Quest",
  "description": "A dangerous journey through caves and such." 
},
{ 
  "name":"Dangerous Quest",
  "description": "A magical journey filled with magical magic. Highly magic." 
}

如果有人想找到游戏 Magical Quest,他们会输入该内容作为查询。 但是第一个结果将是 Dangerous Quest:
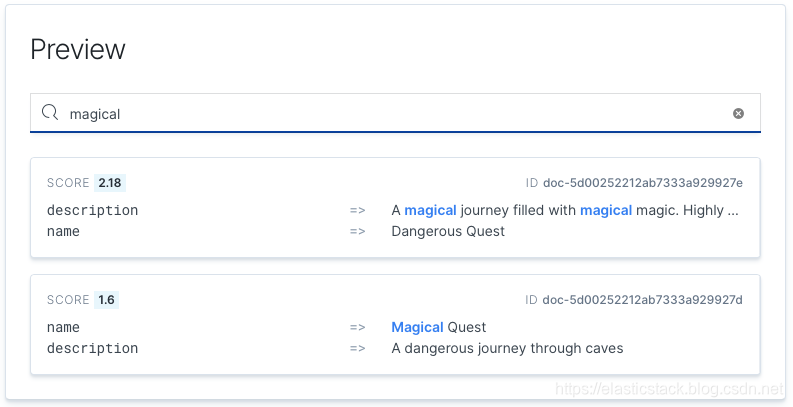
为什么? 因为在 “Dangerous” 的 description 中 “Magical” 一词出现了3次,所以搜索引擎不会知道一个字段比另一个字段更重要。 然后,它将使 “Dangerous Quest” 的排名更高。 这就是为什么存在相关性调整的难题。

我们可以选择一个字段,除其他外,还可以增加其相关性的权重:
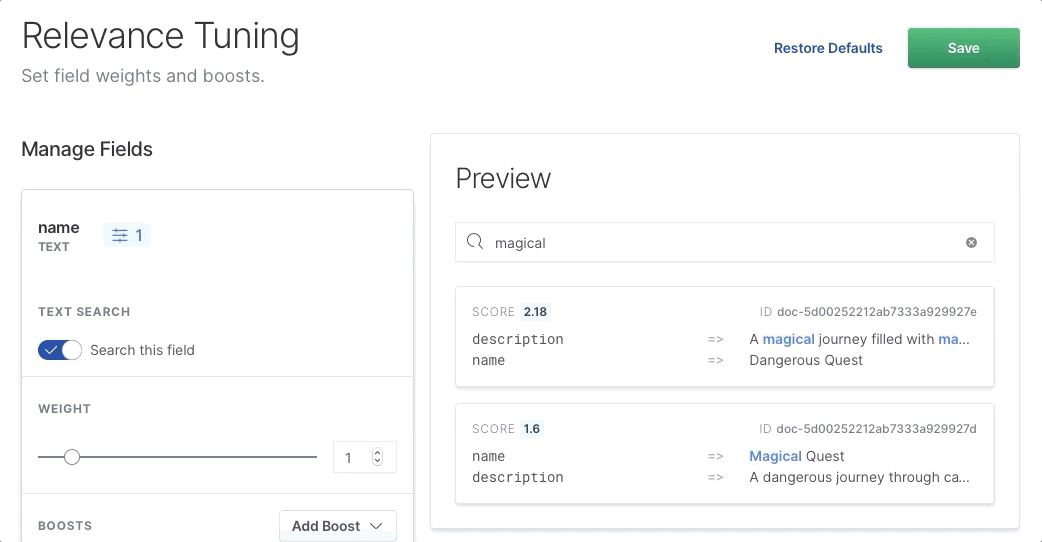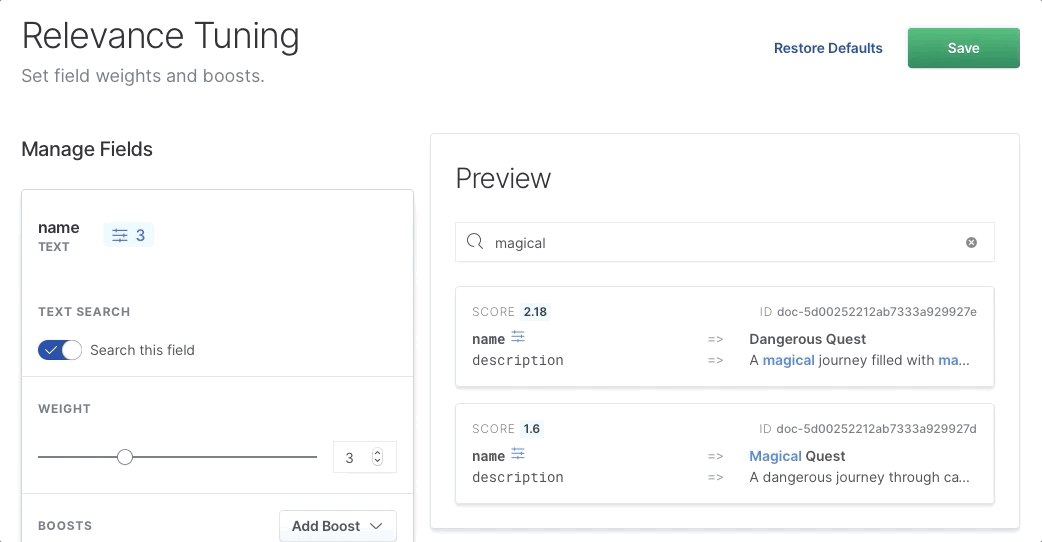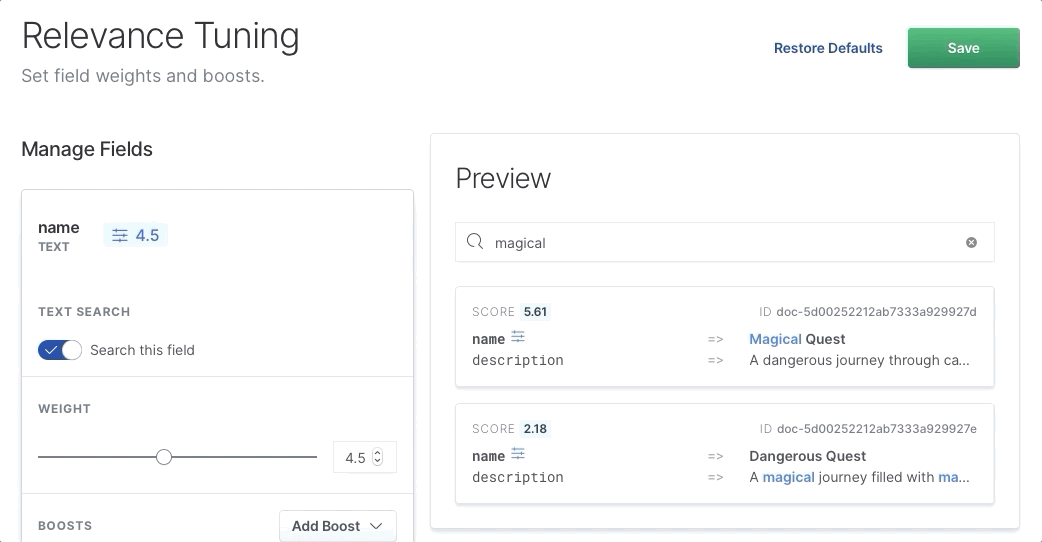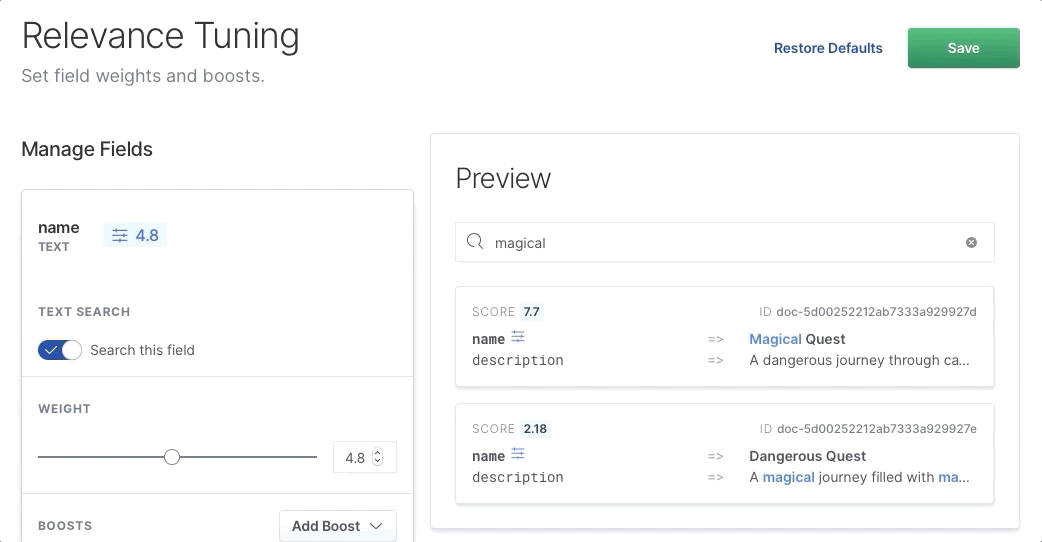
我们看到,当我们增加权重时,正确的项目 “Magical Quest” 上升到顶部,因为 name 字段变得更重要。 我们需要做的就是将滑块拖动到更高的值,然后单击 “Save”。

现在,我们已经使用 App Search 实现了如下的任务:

  • 调整 schema,并将 user_score 和 critic_score 更改为数字字段。
  • 微调关联(relevance)模型。

通常我们进行文字搜索的时候,相关性可以体现在不同 text 字段的匹配度上。在上面,我们通过调整 name 字段的 weight 来达到 relevance 的调整。通过这样的设置,可以使得 name 字段比其它字段更为重要。但是在实际的应用中,我们也可以使用数字来提高文档的相关度。比如,我们可以使用 user_score 来评估一个视频的受欢迎程度。一个视频的用户打分越高,那么就越值得推荐。在我们的搜索中,我们也希望能把这个视频的排名排在前面。在这种情况下,我们可以使用 boost 来调整这些数值字段从而提高相关文章的搜索相关度。比如,在上面的搜索场景中,我们可以使用 user_score 来 boost 搜索的结果。user_score 越高,则代表文档的相关性越高。

weights 和 boosts 有一下的一些区别,尽管两个都会影响最终的文档的分数。首先,通过组合每个搜索的字段的分数来计算文档的分数。 请注意,只能在文本(text)字段上启用搜索,并且你可以在相关性调整中手动禁用字段。

  • Weight 通过将该字段的分数乘以你设置的权重来影响单个字段的分数。
  • Boost 会影响整个文档的分数。 提升通过使用加法或乘法来增加文档分数。 你可以选择三种不同类型的函数来计算此提升。

这样就总结出了精美的“仪表板”功能-每个功能都有一个匹配的 API 端点,如果你不是 GUI 的用户,则可以使用它们使程序以编程方式工作。

我们可以点击 Analyics 来发现我们的搜索的统计情况:
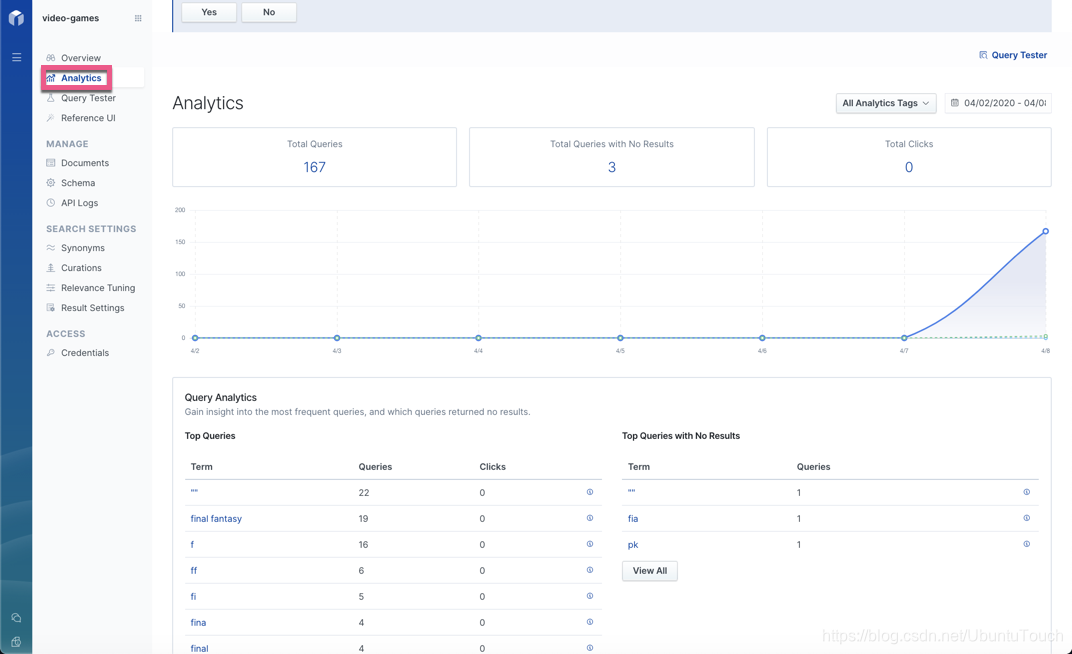
你可以看到 Top queries 及 Top Queries with No  Results。

App Search 跟踪所有执行的查询和点击的结果。 分析页面使你能够分析这些数据。可以通过多种不同方式使用分析来帮助你改善用户体验。 几个例子是:

  • 没有点击或没有结果的 queries -> 应该返回带有更多文档的结果 -> 修复它创建同义词或新内容
  • 每次搜索点击率低的查询 -> 应该返回具有更多相关文档的结果 -> 修复它创建 curations 或重新考虑相关性调整策略

Reference UI

我们点击 Reference UI:
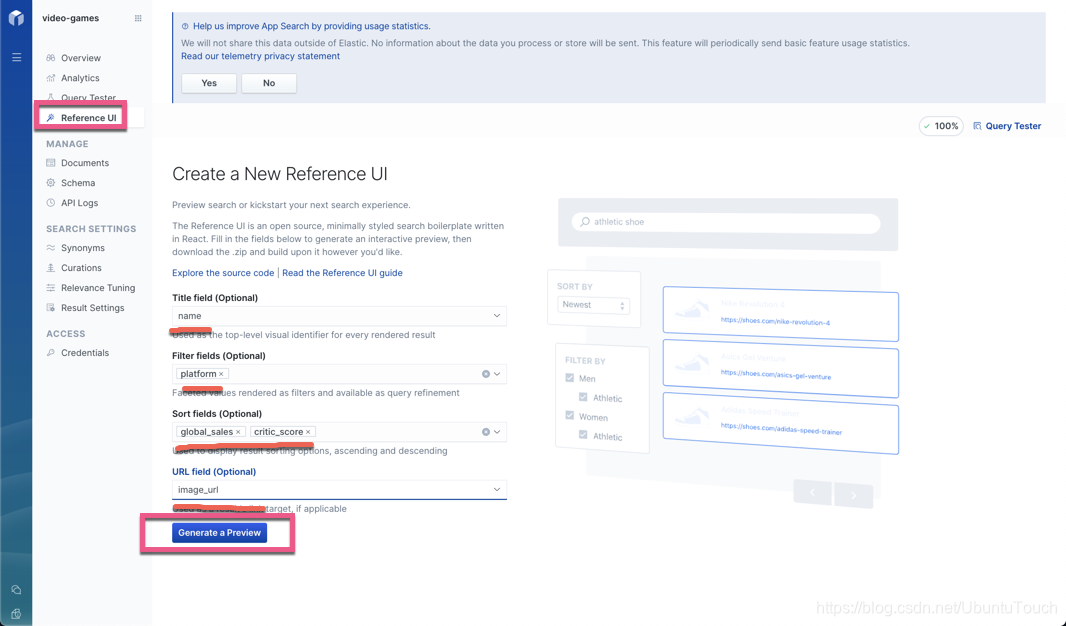
并做相应的配置。点击 Generate a Preview 按钮:
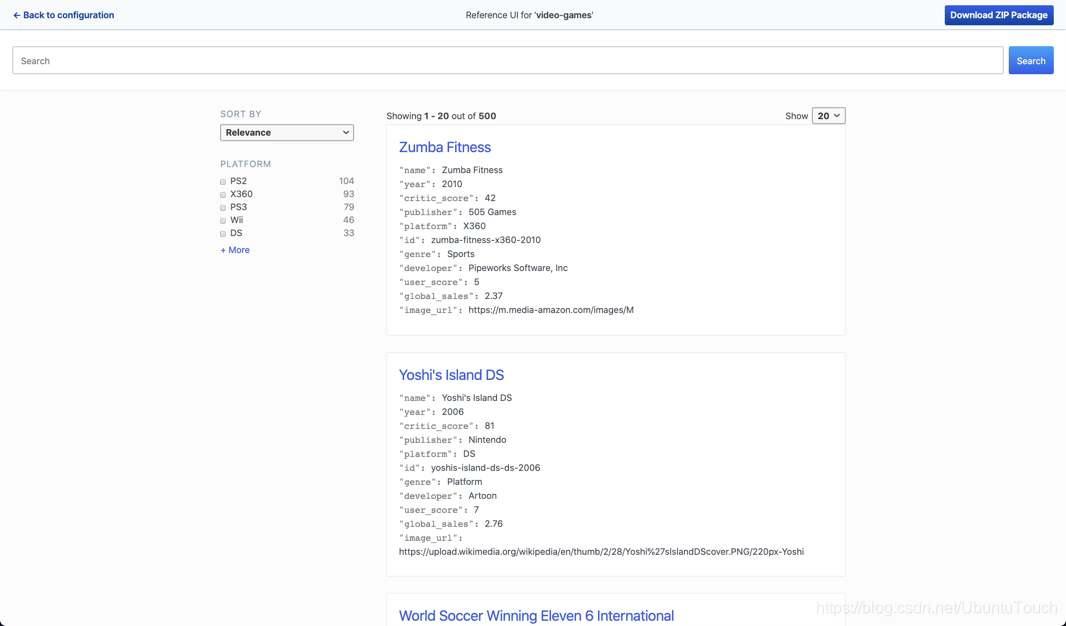
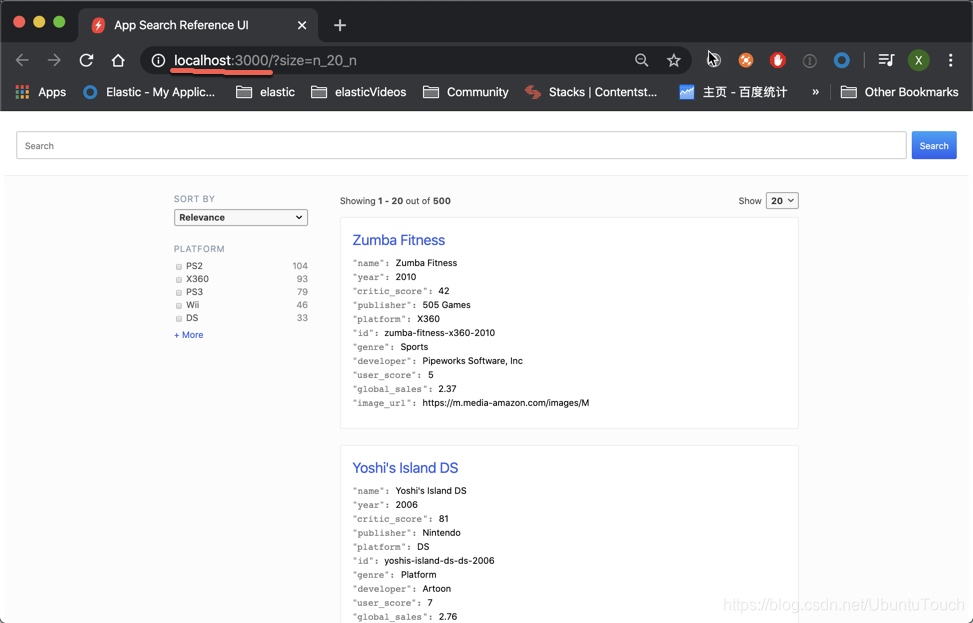
这样我们就可以看到如上所示的用户界面。我们可以尝试输入一个关键字比如 final fantasy 来进行搜索:
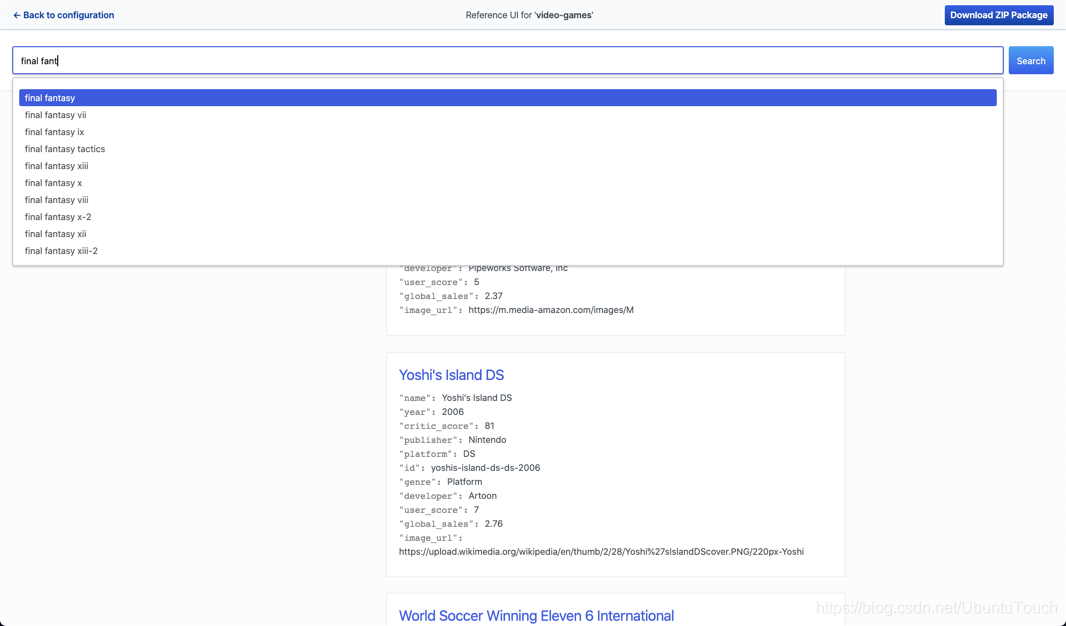
在上面我们可以看到在输入框中,它含有 auto-complete 的功能。我们选择 final fantasy:
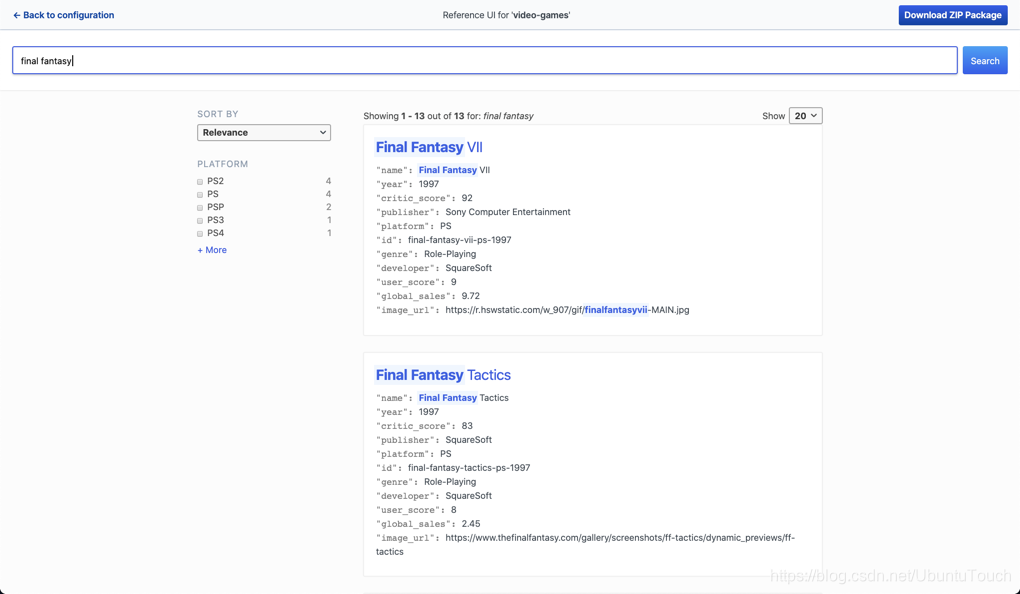
我们马上看到我们想要的结果了。我们有我可以点击上面显示的 filter 及 sort by:
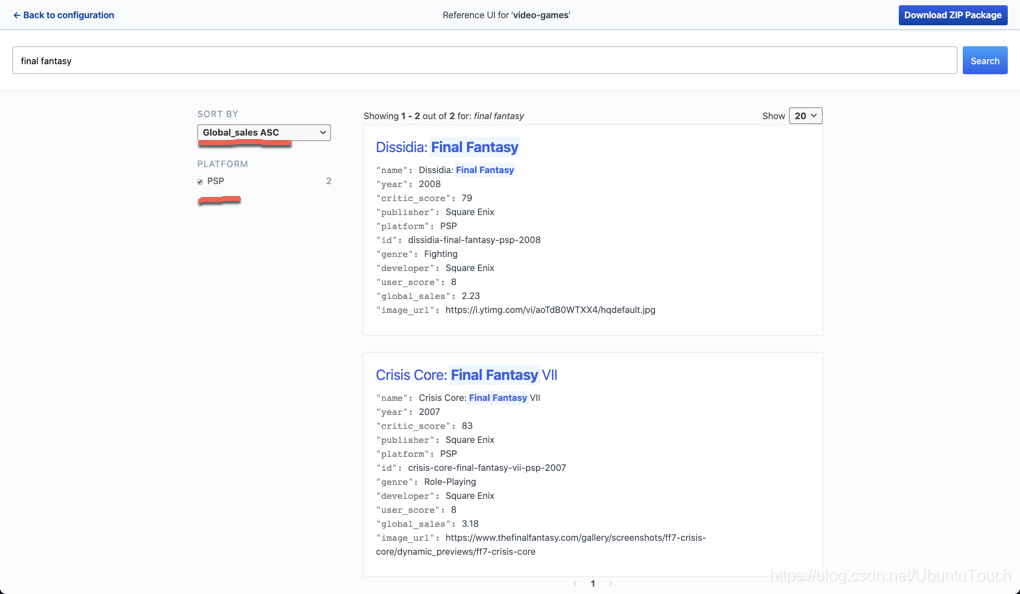
到目前为止是不是很酷啊。我们没有做任何的开发就有一个非常酷的界面给我们进行搜索了。

我们点击上面屏幕右上角的 Download Zip Package,并保存于一个文件目录中。我们解压这个压缩包:

$ pwd
/Users/liuxg/data/appsearch/app
liuxg:app liuxg$ ls
LICENSE.txt         bin                 package.json
NOTICE.txt          logo-app-search.png public
README.md           package-lock.json   src

在上面,我们可以看到这是一个 nodejs 的应用程序。我们使用如下的命令来进行安装:

npm install

一旦安装完后,我们可以使用如下的命令来进行运行:

npm start

在上面我们可以看到和之前一样的界面。

好了到此为止,我们已经创建了一个真正意义上的从0开始的 App search 应用。希望大家喜欢。如果你希望对 Elastic 的 Search UI 感兴趣的话,或者你想更加细致地设计自己的UI和搜索体验的话,你可以参阅:

 参考:

【1】https://swiftype.com/documentation/app-search/self-managed/installation#app-search

【2】https://github.com/elastic/search-ui

相关推荐

AgentHack Shanghai|基于阿里云AI搜索 Elasticsearch x Qoder 构建AI Agent应用

2026年12月12日,Elastic社区、阿里云与Qoder联合举办AgentHack实战活动,聚焦AI编程、搜索检索与智能体工具链融合。参赛者将使用唯一指定工具QoderCN,在一天内完成从需求分析到可演示原型的构建,结合阿里云AI搜索或Elastic生态实现真实场景应用。活动提供技术工作坊、导师答疑及1个月QoderCN专业版会员,鼓励展示数据检索、工具调用与任务闭环的完整链路。参赛者可基于阿里云Elasticsearch、ElasticCloud或自部署环境,打造企业知识问答、业务分析等智能体原型,

Elastic 中国社区官方博客 1429

Elastic 线下 Meetup 将于 2026 年 12 月 19 号下午在西安举行

2026年12月19日,Elastic、阿里云与新智锦绣联合举办西安站ElasticMeetup。活动聚焦Elasticsearch向量搜索、AI Agents构建及企业级知识引擎演进,特邀刘晓国、陈星宇、孔祥超等专家分享技术前沿实践。内容涵盖语义搜索、智能诊断、云原生管控与大模型时代搜索架构升级,助力开发者掌握企业级AI应用落地核心能力。

Elastic 中国社区官方博客 1290

Elastic 线下 Meetup 将于 2026 年 11 月 28 号下午在杭州举行

2026年11月28日,杭州阿里云谷园区将举办AI搜索技术盛会。活动汇聚Elastic社区首席布道师刘晓国、中国电子云高斌、阿里云汤祯捷及预言家科技欧阳楚才等专家,聚焦Elasticsearch向量搜索、AI Agents构建、本体智能体上下文引擎与电商智能导购系统,探讨AgenticSearch 2.0、多模态检索与企业级智能搜索演进。现场设茶歇、合影与抽奖,报名成功后请扫码入群。

Elastic 中国社区官方博客 1077

Elastic:如何成为一名 Elastic 认证工程师,Elastic 认证分析师及 Elastic 认证可观测性工程师

Elasticsearch 无疑是是目前世界上最为流行的大数据搜索引擎。根据 DB - Engines 的统计,Elasticsearch 雄踞排行榜第一名,并且市场还在不断地扩大:能够成为一名 Elastic 认证工程师也是很多开发者的梦想。这个代表了 Elastic 的最高认证,在业界也得到了很高的认知度。得到认证的工程师,必须除了具有丰富的 Elastic Stack 知识,而且必须有丰富的操作及有效的解决问题的能力。拥有这个认证证书,也代表了个人及公司的荣誉。针对个人的好处是,你可以..

Elastic 中国社区官方博客 2万+

Elastic:开发者上手指南

你们好,我是Elastic的刘晓国。如果大家想开始学习Elastic的话,那么这里将是你理想的学习园地。在我的博客几乎涵盖了你想学习的许多方面。在这里,我来讲述一下作为一个菜鸟该如何阅读我的这些博客文章。我们可以按照如下的步骤来学习:1)Elasticsearch简介:对Elasticsearch做了一个简单的介绍2)Elasticsearch中的一些重要概念:cluster,n..........................................................

Elastic 中国社区官方博客 17万+

Elastic:培训视频 - ​在生产环境中配置 Fleet Server 和 Elastic Agent 之间的安全

在这篇文章中,我将会把我写的有些内容录制成视频,供大家参考。希望对大家有所帮助。优酷的视频频道地址在这里。Elastic 简介及Elastic Stack 安装:优酷,腾讯 Elastic Stack docker 部署:优酷,腾讯 Elasticsearch中的一些重要概念(Cluster/Shards/Replica/Document/Type/Index):优酷,腾讯 开始使用El...............

Elastic 中国社区官方博客 1万+

Elasticsearch 简介

Elasticsearch是一个非常强大的搜索引擎。它目前被广泛地使用于各个IT公司。Elasticsearch是由Elastic公司创建并开源维护的。它的开源代码位于https://github.com/elastic/elasticsearch。同时,Elastic公司也拥有Logstash及Kibana开源项目。这个三个开源项目组合在一起,就形成了 ELK软件栈。他们三个共同形成了一个强大的...

Elastic 中国社区官方博客 17万+

Kibana 中的人工智能连接器:你的 agent 可调用的 90 多个数据源

Elastic推出Kibana内置的90+人工智能连接器,支持Slack、GitHub、Confluence、PagerDuty等平台,让agent在推理中自动调用外部数据源,无需编写集成代码。通过身份验证中继服务,agent可安全访问个人或组织数据,快速关联告警与背景信息(如变更记录、讨论串、文档),显著缩短故障排查时间。结合ElasticCloud Trial,用户可即刻体验完整功能。

Elastic 中国社区官方博客 234

更少的位数,相同的召回率:DiskBBQ 更保守的自动校准扫描

Elasticsearch 现在在成本模型中将文档位数的权重提高至原来的三倍,因此 DiskBBQ 会先尝试预处理和更深层的重排序,再增加一个比特,使量化向量在保持相同召回率的同时维持较小的体积。

Elastic 中国社区官方博客 278

对 OpenTelemetry Kafka 接收器的两项改动,避免一个缓慢的租户拖住其他租户

Elastic通过两项改进解决OpenTelemetry Kafka接收器中的“吵闹邻居”问题:一是为每个Kafka分区引入独立工作单元,实现租户间分区隔离;二是添加租户限流处理器,动态限制各租户在共享发送队列中的槽位占用,防止慢租户阻塞其他租户。结合max_in_flight配置提升单分区吞吐量与内存控制,确保记录不丢失、投递至少一次,同时保障多租户环境下稳定高效的数据处理。

Elastic 中国社区官方博客 335

三次模型调用,占据 92% 的等待时间:使用 OpenTelemetry 实现人工智能 agent 可观测性

使用OpenTelemetry追踪LangChain购物助手,发现92%耗时源于三次模型调用。虽将比较模型替换为更便宜的版本后,成本降低76%-83%,但四成问题响应变慢。通过追踪数据定位瓶颈,结合ES|QL分析词元用量与费用,验证了成本优化但延迟未改善。借助Elastic AI Agent建议,进一步测试return_direct=True以跳过冗余调用,实现性能与成本双赢。可观测性助力精准决策,确保答案正确、响应高效。

Elastic 中国社区官方博客 406

Elasticsearch:稠密向量字段类型

dense_vector字段用于存储稠密向量,支持k近邻搜索(kNN),默认启用索引并使用余弦相似度。可接受浮点数数组或Base64编码字符串输入,支持自动量化(如int8、int4、bbq)以降低内存占用。通过index_options配置索引类型(如hnsw、bbq_disk),并可启用过采样与重新评分提升精度。向量默认不存储于_source中以节省空间,可通过fields或_source.exclude_vectors显式返回。支持bit向量及GPU加速索引,适用于高维向量场景。

Elastic 中国社区官方博客 289

使用 Qoder 将 CSV 文件导入 Elasticsearch

本文演示如何通过Qoder智能助手,仅用4轮对话,将IMDB电影数据CSV文件(10,178条)高效导入Elasticsearch。无需编写代码,Qoder自动完成依赖安装、连接配置、字段类型推断(text/keyword/double)、数据验证及导入,支持自定义映射与数据转换,耗时约30秒,显著简化数据导入流程。

Elastic 中国社区官方博客 247

两条规则,一次故障,一条告警:变点检测如何减少告警噪声

Elastic Carlos Crespo揭示了基于ES|QL规则的AI agent如何通过重运行查询验证告警真实性,实现从日志变化到重大事件告警的自动化。系统先通过变点检测识别规则行为突变,再由发现agent核实故障存在性、规模与影响范围,并合并同类信号以减少噪声。每条告警均附带可追溯的查询证据,确保结论可验证。最终生成的告警包含严重程度、置信度、受影响拓扑及量化指标,支持运维决策。该流程结合代码与模型分工,保障可靠性与可解释性,已在多场景测试中验证有效性。

Elastic 中国社区官方博客 333

把词向量“贴”在地球仪上:用球面视角看 Embedding 的真实几何

本文通过将归一化词向量投影至3D球面,利用slerp绘制大圆弧,以真实反映余弦相似度对应的测地线距离。相比传统PCA平面散点图,球面可视化避免几何扭曲,直观呈现词间语义关系。结合Plotly实现交互式“词语地球仪”,可旋转观察聚类、跨语言对齐(如“cat”与“猫”),并对比高维真值与降维后距离的失真。代码简洁(<200行),支持模型替换与扩展,揭示“向量相近”在球面上的真实形态。

Elastic 中国社区官方博客 263

我们的 agent 技能如何调研、构建和测试完整的 Elastic 集成

作者:来自 Elastic我们让 agent 技能处理美国国家标准与技术研究院的国家漏洞数据库接口,得到了两个数据流和一个经过验证的通用表达式语言程序,并通过了流水线测试和系统测试。调研发现,一天中 78% 的通用漏洞与披露记录都是旧记录的重新发布,这一发现改变了设计。Elasticsearch 原生集成了业界领先的生成式人工智能工具和服务提供商。欢迎观看我们的网络研讨会,了解如何,或使用构建可用于生产环境的应用。要为你的使用场景构建最佳搜索解决方案,立即开始,或在你的上试用 Elastic。

Elastic 中国社区官方博客 130

基于 Elasticsearch 与 Jina AI 的全模态智能搜索实践:技术全解析

是一个结构清晰、覆盖全面且极具实操价值的开源项目。它不仅展示了Jina AI 多模态模型在非结构化数据表征上的强悍性能,也展现了在混合检索(BM25 + k-NN + RRF)以及多模态 RAG 架构上的工程实践。无论是准备构建企业级智能知识库、多媒体图库检索系统,还是探索音视频多模态推荐,该项目都提供了非常优秀的代码模版与架构参考。

Elastic 中国社区官方博客 208

你的日志早已写好告警:在 Elasticsearch 中生成 ES|QL 检测查询

Elastic Observability Labs展示如何基于OpenTelemetry日志自动生成精准的ES|QL检测查询。通过30个知识指标(27个推断、3个计算),生成10条查询,其中4条转化为Kibana告警规则。查询严格遵循三条提示词规则:精确匹配短语、不依赖log.level、仅在同文档中组合谓词。正常运行时匹配0条,故障期间捕获676条支付服务异常日志。查询随依赖知识失效自动停用,确保持续有效性。

Elastic 中国社区官方博客 685

基于 Jina OCR v1 与 Elasticsearch 的 PDF 智能混合检索与 RAG 系统实战指南

本文介绍开源项目jina-ocr-v1-pdf,基于JinaOCRv1高精度视觉解析与Elasticsearch的混合检索(RRF),构建端到端PDF智能问答系统。通过PyMuPDF渲染高清图像、并发OCR提取结构化文本(Markdown/HTML),结合自动切片向量化与BM25+语义检索融合,实现精准页码定位与上下文相关性提升。配合Streamlit前端与Kibana监控,支持企业级文档智能处理,有效解决扫描件、多栏、表格等复杂排版难题,为RAG应用提供高效、可扩展的技术范本。

Elastic 中国社区官方博客 556

Elastic Cloud 无服务器服务审计日志:将审计记录发送到可观测性或安全解决方案

ElasticCloud无服务器服务推出审计日志投递功能,支持将Elasticsearch与Kibana的活动日志(如索引变更、登录行为、数据访问)自动投递至同一组织内的可观测性或安全项目。附带8条告警规则和7个仪表板,涵盖凭据攻击检测、对象取证、数据访问追踪等场景。通过忽略筛选条件可降低存储成本,实现按需保留关键证据。支持跨项目日志聚合,助力安全与合规团队高效调查。立即免费试用14天,体验AI驱动的搜索与智能监控。

Elastic 中国社区官方博客 183

Elastic 在《Forrester Wave™:2026 年第四季度智能运维平台》报告中被评为强劲表现者

Elastic在《ForresterWave®:2026年第四季度智能运维平台》中被评为强劲表现者,获五项最高评分,涵盖算法可信度、可观测性即代码、AI技术栈、数据主权与定价透明度。其人工智能站点可靠性工程师以透明推理、完整上下文、持续学习和开放标准为核心,实现可验证排查、高效存储与跨环境兼容,助力团队信任AI、提升响应效率,推动智能运维迈向可验证、可进化的新阶段。

Elastic 中国社区官方博客 194

使用 OpenTelemetry 在 Elastic 中实现 Claude 平台的人工智能 agent 可观测性

Elastic与Claude平台集成,通过OpenTelemetry将AI agent追踪数据实时发送至Elastic,实现无代码观测。用户可在Kibana中查看模型请求、工具调用及上下文协议的完整交互轮次,包含耗时、词元计数与对话内容。支持服务清单、告警规则与SLO设置,结合SDK可实现跨服务追踪。免费云试用已开放,快速接入即可全面掌握Claude agent性能与成本。

Elastic 中国社区官方博客 894

三个区域、三个 Kibana、一个视图:跨集群搜索登陆 Elastic 合成监测

Elastic 9.5推出合成监测跨集群搜索功能,实现多集群监测器统一视图。无需复制数据,中央Kibana可实时查询远程集群的探测结果,展示状态、用户旅程、截图与证书,支持按远程集群筛选与分组。配置仍保留在原集群,仅提供只读访问,管理需返回源Kibana。适用于有状态部署,暂不支持无服务器服务。告警跨集群功能正在开发中。

Elastic 中国社区官方博客 384

Elastic 重大事件功能如何将 100 条日志样本转化为检测规则

本文介绍Elastic重大事件功能如何通过智能日志采样,从100份样本中提取27个知识指标(如服务、依赖关系、技术等),构建有证据支撑的日志源描述,进而生成精准检测规则。相比均匀采样易遗漏罕见故障信息,该系统采用三路分层采样(按实体筛选、多样性、随机)确保覆盖长尾模式,并通过循环迭代与去重机制提升准确性。知识指标可审核、手动保留或排除,支持持续接入。第二部分将基于这些指标生成可执行的查询,实现从“看到”到“检测”的跨越。

Elastic 中国社区官方博客 301

给海量查询“减负”:列式查询改写如何让检索更“省力”

Elasticsearch 9.5.0推出的列式查询改写技术,实现“零改造、高兼容、高精准”的查询优化。通过按需读取字段、谓词下推与嵌套扁平化,显著降低冗余读取与解码开销。基于1.8亿条日志的实测验证:16个用例命中数完全一致,核心时延持平,边界场景稳定,DSL语法兼容。系统自动降级兜底,确保功能可用。该技术特别适用于日志检索等海量数据场景,为集群性能提升提供开箱即用的底层支撑。

Elastic 中国社区官方博客 637

Elastic 如何帮助奥迪 Revolut F1® 车队在工程软件中找到关键信息

Elastic与奥迪RevolutF1®车队达成多年合作,将作为2026年美国大奖赛官方赛事合作伙伴,并自2027年起成为其官方搜索与可观测性供应商。通过Elastic技术栈(Logstash、Elasticsearch、Kibana),车队实现跨系统日志与遥测数据的统一视图,助力工程师在毫秒级内快速排查问题,提升软件可靠性。该合作不仅强化工程效率,更推动AI辅助诊断与决策支持,为赛车性能持续优化提供技术支撑。

Elastic 中国社区官方博客 218

5 分钟内将 56 页扫描文档转化为带引用的答案:面向搜索无法读取的文档的检索增强生成流水线

通过Elasticsearch与jina-ocr-v1结合,可将扫描版PDF(如56页植物指南)快速转化为可检索、可引用的知识库。该流程利用单一模型完成文档解析,输出结构化Markdown,再由Elasticsearch自动分块并生成嵌入向量,支持混合检索(关键词+语义)。用户以自然语言提问,系统返回带页码引用的答案及推荐商品,全程在统一平台内完成,无需自建流水线。

Elastic 中国社区官方博客 499

我们如何通过 70 多个拉取请求,将 OpenTelemetry Java agent 迁移到 invokedynamic

Elastic团队历时三年,将OpenTelemetry Java Agent从内联字节码插桩迁移至基于invokedynamic的类加载器隔离模式,支持100+插桩模块,提升可维护性与调试能力。相比此前三人团队的迁移,此次协作规模扩大,通过渐进式发布、运行时开关与自动化工具确保生产稳定。新架构实现插桩代码独立加载、兼容Java平台模块系统,并解决旧版本字节码兼容性问题。2026年7月,相关任务正式关闭,标志着迁移完成。

Elastic 中国社区官方博客 331

将 Elastic 引入 Claude:原因、方法与注意事项

Elastic发布Claude插件,将自身AI能力融入开发者工作流。从提交到上线仅用三周,但过程充满挑战:需绕过权限限制、调整版本管理策略(改用stable分支)、应对审核警告(如凭据提示、图标缺失等),且上线后无通知。插件首发于社区目录,需额外验证才能进入官方市场。作者强调,技术之外,与Anthropic团队的人际沟通是关键。经验表明,文档未覆盖的细节常需实战互动解决。欢迎开发者共享经验,共同推动生态发展。

Elastic 中国社区官方博客 117

告别繁琐控制台:Kabanos 如何将 MongoDB Compass 的易用性带入 Elasticsearch

Kabanos是一款专为macOS设计的本地优先桌面客户端,整合Elasticsearch与OpenSearch集群管理痛点。它结合MongoDB Compass式树状浏览与Kibana DevTools高效控制台,支持凭据安全加密、生产环境二次确认、只读模式及沙盒化架构,保障操作安全。内置查询库、自动化Routines与DryRun模式,提升运维效率。基于Electron与Zod校验,实现渲染层与网络请求隔离。快速上手:克隆仓库,启动Docker测试集群,运行pnpm dev即可使用。开源项目欢迎贡献,推

Elastic 中国社区官方博客 392
上一篇: Elastic:如何创建一个动态的阈值 watcher
下一篇: Elastic:我应该使用 Logstash 或是 Elasticsearch ingest 节点?
Elastic 中国社区官方博客
Elastic 中国社区官方博客 企业官方账号 企业官方账号 领域专家: 大数据技术领域 领域专家: 大数据技术领域
博客等级 码龄12年 5万+粉丝 3111原创
评论 10
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值