从插入排序一窥时间复杂度的计算方法

插入排序及其时间复杂度分析 摘要: 插入排序是一种基于比较的简单排序算法,通过构建有序序列逐步插入未排序元素实现排序。其核心步骤为:取出元素,在已排序序列中从后向前扫描定位,插入到正确位置。时间复杂度:最佳O(n)(已排序),最坏O(n²)(逆序),平均O(n²);空间复杂度O(1),属于原地稳定排序。算法在小规模或基本有序数据中表现优异,常作为高级排序的补充(如Java对小子数组的优化)。优化方向包括二分查找定位(减少比较次数)和希尔排序(分组插入)。代码实现简洁(文中提供Java/Python/Golang示例),适用于面试基础考 阅读详情

为什么需要分析时间复杂度

通常在运行一段代码之前,我们需要预测其需要的资源。虽然有时我们主要关心像内存、网络带宽或者计算机硬件这类资源,但是通常我们想度量的是计算时间。
接下来我们以插入排序算法为切入点一窥时间复杂度的计算方法。

时间复杂度分析

一般来说,算法需要的时间于输入的规模同步增长,所以通常把一个程序的运行时间描述成其输入规模的函数。为此,我们必须先给出术语运行时间和输入规模。

输入规模通常依赖于研究的问题。比如,对于排序问题来说,最自然的量度是需要排序元素的数量。又比如对于最短路算法而言,其输入是一个图,则输入规模可以用该图中的顶点数及边数来描述。

一个算法在特定输入上的运行时间是指执行的基本操作数或步数。首先我们假设执行一行代码需要常量时间。常量时间是指:无论输入规模如何变化,执行这一行代码的时间都不受输入规模的影响。我们记第 i 行代码的执行时间为 CiC_iCi​。

在用插入排序举例之前,我们先看下该算法的基本思想:每步将一个待排序的元素,按其值的大小插入前面已经排序的序列中适当位置上,直到全部元素插入完为止。以升序排序为例,具体代码如下:

template<typename Array>
void InsertionSort(Array &data) {                       
    for(size_t i = 1, n = data.size(); i < n; i++) {  // 1           
        auto key = data[i];                           // 2  
        auto j = i-1;                                 // 3
        while(j >= 0 && data[j] > key) {              // 4
            data[j+1] = data[j];                      // 5
            j--;                                      // 6
        }
        data[j+1] = key;                              // 7
    }
}

我们设上述代码的 for 循环中七行代码的执行时间分别为:
C0,C1,C2,C3,C4,C5,C6C_0, C_1, C_2, C_3, C_4, C_5, C_6C0​,C1​,C2​,C3​,C4​,C5​,C6​
设枚举到第 i 个元素时,第四行代码的执行次数为 TiT_iTi​。
每行代码的执行次数可表示为:
n,n−1,n−1,∑i=2nTi,∑i=2n(Ti−1),∑i=2n(Ti−1),n−1n, n-1, n-1, \sum_{i=2}^nT_i, \sum_{i=2}^n(T_i-1), \sum_{i=2}^n(T_i-1),n-1n,n−1,n−1,∑i=2n​Ti​,∑i=2n​(Ti​−1),∑i=2n​(Ti​−1),n−1。

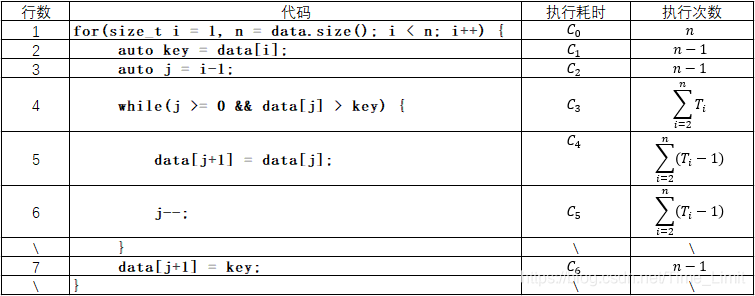
具体对应关系如下:
每行的执行耗时和执行次数
该算法的运行时间是执行每条语句的运行时间之和。为计算在具有 n 个元素的输入上该算法的运行时间S(n),我们将代价和次数列对应元素之积求和,得:
S(n)=C0n+C1(n−1)+C2(n−1)+C3∑i=2nTi+C4∑i=2n(Ti−1)+C5∑i=2n(Ti−1)+C6(n−1)\begin{aligned} S(n)=&C_0n + C_1(n-1)+C_2(n-1)\\ &+C_3\sum_{i=2}^nT_i\\ &+C_4\sum_{i=2}^n(T_i-1)\\ &+C_5\sum_{i=2}^n(T_i-1)\\ &+C_6(n-1) \end{aligned} S(n)=​C0​n+C1​(n−1)+C2​(n−1)+C3​i=2∑n​Ti​+C4​i=2∑n​(Ti​−1)+C5​i=2∑n​(Ti​−1)+C6​(n−1)​

即使对给定规模的输入,一个算法的运行时间也有可能依赖于给定输入的一些特点。例如,对于插入算法来说,若输入数组已排好序,则出现最佳情况。这时,对每个 i=1,2,3,...,n−1i = 1,2,3,...,n-1i=1,2,3,...,n−1有 Ti=1Ti = 1Ti=1 ,该最佳情况的运行时间为
S(n)=C0n+C1(n−1)+C2(n−1)+C3(n−1)+C6(n−1)\begin{aligned} S(n) =&C_0n\\ &+ C_1(n-1)\\ &+C_2(n-1)\\ &+C_3(n-1)+C_6(n-1)\\ \end{aligned} S(n)=​C0​n+C1​(n−1)+C2​(n−1)+C3​(n−1)+C6​(n−1)​
整理一下上述式子得:
S(n)=(C0+C1+C2+C3+C6)n−(C1+C2+C3+C6)\begin{aligned} S(n)= &(C_0+C_1+C_2+C_3+C_6)n\\ &-(C_1+C_2+C_3+C_6) \end{aligned}S(n)=​(C0​+C1​+C2​+C3​+C6​)n−(C1​+C2​+C3​+C6​)​
我们可以把该运行时间表示为an+ban+ban+b,其中常量 a 和 b 依赖于语句代价CiCiCi。因此,它是n的线性函数。

若输入数组已反向排序,即按递减序列排好序,则导致最坏情况。这时,对于i=1,2,3,...n−1i=1,2,3,...n-1i=1,2,3,...n−1 有 Ti=i+1Ti=i+1Ti=i+1。将 TiTiTi 代入 S(n)S(n)S(n) 得:
S(n)=(C32+C42+C52)n2+(C0+C1+C2+C32−C42−C52−C6)n−(C1+C2+C3+C6)\begin{aligned} S(n) &=(\frac{C_3}{2}+\frac{C_4}{2}+\frac{C_5}{2})n^2\\ &+(C_0+C_1+C_2+\frac{C_3}{2}-\frac{C_4}{2}-\frac{C_5}{2}-C_6)n\\ &-(C_1+C_2+C_3+C_6) \end{aligned}S(n)​=(2C3​​+2C4​​+2C5​​)n2+(C0​+C1​+C2​+2C3​​−2C4​​−2C5​​−C6​)n−(C1​+C2​+C3​+C6​)​
我们可以把最坏情况运行时间表示为an2+bn+can^2+bn+can2+bn+c,其中常量a,b,ca,b,ca,b,c依赖于语句执行耗时CiC_iCi​。因此,它是n的二次函数。

最坏情况与平均情况分析

在分析插入排序时,我们同时研究了最坏情况和最佳情况。然而我们往往集中于最坏情况运行时间,即规模为n的所有输入中,算法运行时间最长的情况。原因如下:

  • 一个算法的最坏情况运行时间给出了运行时间的上界。从而可以保证在任何情况下,算法的运行时间绝对不会超过这个上界。
  • 对于大多数算法来说,最佳情况出现的频率极低。
  • "平均情况"往往和最坏情况大致一样差。

增长量级

我们使用某些简化的抽象来使插入排序的分析更加容易。
首先,通过使用常量CiC_iCi​表示每条语句的执行耗时以忽略每条语句的细节。
其次,我们进一步整合总体耗时的计算公式,使其表示为an2+bn+can^2+bn+can2+bn+c,进一步忽略了每条语句的执行耗时。
现在我们做出一种更简化的抽象:即我们真正感兴趣的运行时间的增长率或增长量级。所以我们只考虑公式中最重要的项,因为当 n 的值很大时,低阶项相对来说并不重要。我们也忽略最重要的项的常系数,因为对大的输入,在确定计算效率时常量因子不如增长率重要。对于插入排序,当我们忽略掉低阶项和最重要的项的常系数时,只剩下最重要的项中的因子n2n^2n2。我们记插入排序的时间复杂度为O(n2)O(n^2)O(n2)。

如果一个算法的最坏情况运行时间具有比另一个算法更低的增长量级,那么我们通常认为前者比后者更有效。由于常量因子和低阶项,对于小的输入,运行时间具有较高增长量级的一个算法与运行时间具有较低增长量级的另一个算法相比,其可能需要较少时间。但是当输入足够大时,例如,一个 O(log2n)O(log_2^n)O(log2n​)算法在最坏情况下比另一个O(n2)O(n^2)O(n2)的算法要运行的更快。

扫码关注,快乐加倍

OpenVox 8FXO板卡驱动安装记录 OpenVox A800P和A1200P的板卡驱动安装及问题解决方法 阅读详情

相关推荐

STC15W204S最小系统开发指南:从串口通讯到自动热加载全流程

本文详细介绍了STC15W204S最小系统的完整开发流程。从芯片资源解析、最小系统搭建、串口通讯驱动编写(使用Timer2生成波特率),到实现基于魔术值触发的自动热加载功能,并最终集成Keil与STC-ISP软件,构建高效的自动化开发工作流,显著提升嵌入式调试效率。

a1b2c的博客 391

排序算法-插入排序的时间复杂度分析

插入排序的原理是,将数组分为已排序区间和未排序区间两部分,从未排序区间中依次取元素跟已排序区间的元素一一对比,找到适合插入的位置。 对于任何数据结构和算法的学习,要充分理解数据结构本身的特点以及熟练数据结构的各种操作(比较、移动方式等)

2万+

ERA5获取的风场数据转换为.dfs2文件

ERA5获取风场数据的具体步骤可以参考下面的文章下载好后应该是.nc格式的文件,想要读取或者转换成其他格式的文件可以安装下面步骤,本文介绍如何转换为.dfs2文件。

我的博客 1459

排序算法之插入排序(全解+代码)

直接插入排序(Insertion Sort)是一种简单的排序算法,其基本思想是将一个待排序的元素插入到已排好序的有序数列中的适当位置,直到全部元素排序完成为止。具体实现过程如下:将待排序的数组分成两部分,已排序区间和未排序区间。初始时,已排序区间只有一个元素,就是数组的第一个元素。将未排序区间的元素依次插入到已排序区间的适当位置,直到未排序区间为空。

m0_58381606的博客 3228

Eureka常见面试题总结

点击关注我的博客原文 Eureka是Netflix组件的一个子模块,也是核心模块之一。云端服务发现,一个基于 REST 的服务,用于定位服务,以实现云端中间层服务发现和故障转移(来源springcloud中文网的介绍:https://www.springcloud.cc/)。下图总结了Eureka服务端(以下简称服务端)与Eureka客户端(以下简称客户端)之间协同工作的流程: 流程说明:...

u012105931的博客 2万+

stm32F103定时器使用方法

文章目录1、STM32的Timer简介2、普通定时器TIM2-TIM52.1 时钟来源2.2 计数器模式2.3 编程步骤3、程序源代码4、总结 1、STM32的Timer简介 STM32中一共有11个定时器,其中2个高级控制定时器,4个普通定时器和2个基本定时器,以及2个看门狗定时器和1个系统嘀嗒定时器。其中系统嘀嗒定时器是前文中所描述的SysTick,看门狗定时器以后再详细研究。今天主要是研究剩下的8个定时器。 其中TIM1和TIM8是能够产生3对PWM互补输出的高级登时其,常用于三相电机的驱动,时钟

weixin_43582209的博客 4515

【算法】直接插入排序解析

直接插入排序是一种最简单的排序方法,其基本操作是将一条记录插入到已排好的有序表中,从而得到一个新的、记录数量增1的有序表。

NoBack7--For the dream 4470

SAP CO实战:如何用KKA2/CJ88结果分析码搞定项目收入成本匹配(附真实案例)

本文深入解析了SAP CO模块中结果分析码KKA2/CJ88的核心应用,通过真实案例详细阐述了如何在成本波动剧烈的销售型项目中,运用结果分析实现收入与成本的精准匹配。文章重点拆解了不同结果分析方法的适用场景与财务影响,并提供了从配置、操作到问题排查的完整实战指南,帮助财务顾问提升项目财务管理能力。

qsc9012345的博客 607

排序算法之 直接插入排序及时间复杂度分析

排序算法之 冒泡排序及性能优化(时间复杂度+空间复杂度分析) 排序算法之 简单选择排序及时间复杂度分析 直接插入排序 直接插入排序的核心思想就是:将数组中的所有元素依次跟前面已经排好的元素相比较,如果选择的元素比已排序的元素小,则交换,直到全部元素都比较过。 因此,从上面的描述中我们可以发现,直接插入排序可以用两个循环完成: 第一层循环:遍历待比较的所有数组元素 第二层循环:将本轮选择的元素与前面已经排好序的元素相比较,若当前元素小,则进行交换 算法实现 int i,j,insertVal; fo.

qq_41519304的博客 1万+

从你的全世界路过---陌陌X-SIGN还原

我们上期介绍了hook 接口方式,今天我分析so 层。学习是为了复杂的事情简单化。不用如此繁琐。跟进native_sdbyecbu37x这个函数,我们f5看伪代码 v13 = sign(v9, v10, v11, a6); 跟进这个函数 代码如下(示例): 2.代码贴入 SHA消息摘要java代码如下: java 代码如下(示例): 总结 算法,结合动态调试!

任雪飘的博客 2299

YOLOv11 改进 - 检测头 | Detect_LSCD轻量共享卷积检测头:轻量化设计破解计算瓶颈,增强复杂场景目标感知能力

本文介绍了基于群归一化(GroupNorm)和共享卷积的轻量化检测头LSCD,并将其集成进YOLOv11。LSCD检测头充分利用了GroupNorm和共享卷积的优势,在保持特征信息有效融合的同时,减少计算量和运算复杂度。我们将LSCD的代码集成到YOLOv11检测头中,并在tasks文件中进行注册。实验证明,YOLOv11-LSCD在目标检测任务中取得了良好的效果。

魔改工程师的博客 2387

(纯白话算法系列)插入排序、时间复杂度分析、代码演示

定义 插入排序(Insertion sort)是一种简单直观且稳定的排序算法。如果有一个已经有序的数据序列,要求在这个已经排好的数据序列中插入一个数,但要求插入后此数据序列仍然有序,这个时候就要用到一种新的排序方法——插入排序法,插入排序的基本操作就是将一个数据插入到已经排好序的有序数据中,从而得到一个新的、个数加一的有序数据,算法适用于少量数据的排序,时间复杂度为O(n^2)。是稳定的排序方法...

Bean冷的心的博客 1540

DSP篇--C6678功能调试系列之EDMA3调试

EDMA主要用于数据的搬运,发送、接收,其搬运数据的形式有;AB模式,ABC模式以及ping-pong模式。 EDMA3分初始化、参数配置、以及中断配置。其中中断配置则需要注意的内容主要有:挂载的TC通道,对应的触发事件,以及中断的使能。

nanke_yh的博客 1720

时间复杂度大小排序_从插入排序一窥时间复杂度的计算方法

为什么需要分析时间复杂度通常在运行一段代码之前,我们需要预测其需要的资源。虽然有时我们主要关心像内存、网络带宽或者计算机硬件这类资源,但是通常我们想度量的是计算时间。接下来我们以插入排序算法为切入点一窥时间复杂度的计算方法。时间复杂度分析一般来说,算法需要的时间与输入的规模同步增长,所以通常把一个程序的运行时间描述成其输入规模的函数。为此,我们必须先给出术语运行时间和输入规模。输入规模通...

weixin_34282589的博客 1084

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

txt 插入特定列_从插入排序一窥时间复杂度的计算方法

为什么需要分析时间复杂度通常在运行一段代码之前,我们需要预测其需要的资源。虽然有时我们主要关心像内存、网络带宽或者计算机硬件这类资源,但是通常我们想度量的是计算时间。接下来我们以插入排序算法为切入点一窥时间复杂度的计算方法。时间复杂度分析一般来说,算法需要的时间与输入的规模同步增长,所以通常把一个程序的运行时间描述成其输入规模的函数。为此,我们必须先给出术语运行时间和输入规模。输入规模通...

weixin_39955423的博客 84

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

插入排序及时间复杂度

思想 在已经排好序的数组上插入值, 及选择第一个数为有序数组, 然后依次插入后面的数, 如 6 4 5 7 0排序, 选择6为有序数组, 依次插入4 5 7 0, 其过程数组如下 6 4 5 7 0 4 6 5 7 0 4 5 6 7 0 4 5 6 7 0 0 4 5 6 7 . 插入排序过程有三种情况, 一种是插入的数值应该在原地(结尾), 一种插入的数值在应该中间, 一种插入的数值应该在开头...

筱白痴的博客 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

插入排序 - 算法、源代码、时间复杂度

插入排序,一般也被称为直接插入排序。对于少量元素的排序,它是一个有效的算法。插入排序是一种最简单的排序方法,它的基本思想是将一个记录插入到已经排好序的有序表中,从而一个新的、记录数增1的有序表。在其实现过程使用双层循环,外层循环对除了第一个元素之外的所有元素,内层循环对当前元素前面有序表进行待插入位置查找,并进行移动。描述插入排序的工作原理。展示了 Java 中的实现。解释如何导出时间复杂度。并检查 Java 实现的性能是否与预期的运行时行为相匹配。2. 示例:对扑克牌进行排序。

在技术的广袤天地里,本博客如精准罗盘。剖析前沿科技,深掘代码奥秘,以精炼笔触,带您穿越复杂技术迷宫,速达知识彼岸。 2440

折半插入排序比较次数时间复杂度

折半插入排序比较次数时间复杂度 折半插入排序 — 插入第N个数时比较次数时间复杂度O(nlog2(n)): 根据算法思想有以下的推论: 每个数插入最多走了一个判定树的深度 即log2(n-1)(取最少正整数)+1 解析:在有序数组中插入的数每次比较都是与Mid(Mid指向待比较数组中的中间位置)所指向的数进行对比,先将有序数组转化成类似判定树的二叉树形式,可以得出比较的次数最多只能是这一棵二叉树的深度。 示例: 假设一组有序数组:1 2 3 4 5 6 7 8 9 (注意已经选过的Mid不再重选)

qq_45367825的博客 9705

插入排序及时间复杂度的计算

插入排序算法:def insertSort(listx):n=len(listx)for i in range(1,n):key=listx[i]j=i-1while j>0:if listx[j]>key:listx[j+1]=listx[j]...

baixie1994的博客 2705

排序算法-插入排序和时间复杂度

插入排序的原理就和打扑克牌一样,比如打扑克牌开始时给你发了5张牌,刚开始这五张牌没有整理是乱序的,那么这个时候你就先拿起一张牌默认为有序的(因为只有一张),之后再拿起第二张和前面的一张进行对比小的放前面大的放后面,之后再拿起第三张和前面两张进行比较按照从小到大的顺序找到合适的位置插入进去,一直循环直到没有牌需要插入。这就是插入排序的一个简单原理。在代码实现过程中就是按照这样的一个思路来走的,只是代...

阿巴卡的博客 1万+

8大排序之-----(一)插入排序与时间复杂度

(一)什么是插入排序呢?            插入排序就是每次把待排序的数据一个数据插入到已经排好序的正确位置。就好比,你左手拿着扑克牌,用右手去取牌的时候,把取到的牌放到左手正确的位置。 比如我们要排序4,3,5,7,6,2,1,9,88,0。 (1)我们先假设下标为0的数据是排好的,即4是排好序的 , 那么接下来就要3,5,7,6,2,1,88,0.中每次取出一位放到数组的正确

Yabber0914的博客 8882

冒泡排序、选择排序、插入排序算法及时间复杂度详解

冒泡排序算法及时间复杂度冒泡排序 冒泡排序 流程: 比较相邻的元素。如果第一个比第二个大,就交换他们两个。 对每一对相邻元素做同样的工作,从开始第一对到结尾的最后一对。在这一点,最后的元素应该会是最大的数。 针对所有的元素重复以上的步骤,除了最后一个。 持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较。 代码: #冒泡排序算法 def bubbling_sort(lst): if len(lst)==0 or len(lst)<2: return

RT1314的博客 3365

插入排序算法、时间复杂度

1.  插入排序算法 void sortt(int a[],int length) // 插入排序算法 { for (int i = 0; i &lt; length-1; i++) { if (a[i]&gt;a[i + 1]) { int temp = a[i+1]; int j = i+1-1; while ( j&gt;=0 &amp;&amp; a[...

qq_35712835的博客 4547

冒泡、快速、选择、插入排序以及时间复杂度、空间复杂度的解析

四大排序的时间复杂度和空间复杂度时间复杂度时间复杂度的表示方法时间复杂度的分析和计算方法常见的几种时间复杂度常见的时间复杂度排序空间复杂度 时间复杂度 (1)时间频率 一个算法执行所耗费的时间,从理论上是不能算出来的,必须上机运行测试才能知道。但我们不可能也没有必要对每个算法都上机测试,只需知道哪个算法花费的时间多,哪个算法花费的时间少就可以了。并且一个算法花费的时间与算法中语句的执行次数成正比例,哪个算法中语句执行次数多,它花费时间就多。一个算法中的语句执行次数称为语句频度或时间频度。记为T(n)。 (2

八爪大头鱼 2742

java 插入排序_插入排序过程、时间复杂度分析

插入排序是一个重要的排序算法,其思想类比于打扑克牌时候调整手牌的策略。一、插入排序过程大学本科期间在数据结构与算法课中,应该都学习过插入排序算法的过程与时间复杂度。下面简单来复习一下插入排序算法的过程与时间复杂度。插入排序过程假设对n个元素进行插入排序,则需要进行n-1趟排序。示例代码如下所示,使用java书写的,可以很容易改为c代码和python代码,大家可以进行简单的调式深刻理解插入排序的过程...

weixin_39692761的博客 381

冒泡、选择、插入排序——代码、时间复杂度分析

基本排序——三种冒泡排序选择排序插入排序 冒泡排序 图片讲解: 排序的话默认规则是从小到大排序 冒泡排序原理步骤: 比较相邻元素。如果6比3大,则交换它们的位置; 对每一轮的相邻元素做相同工作。n个数冒泡n-1轮,每一轮冒泡n-i次 代码实现 1、初步代码实现: public void sort(Comparable[] a){ for (int i = a.length-1; i > 0; i--){ for (int j = 0; j < i; j+

qq_46509219的博客 1718
上一篇: Codeforces 1323B - Count Subrectangles
下一篇: 单向链表漫谈
Time_Limit
博客等级 码龄7年 264粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值