用二维图像渲染3D场景视频

【mip-NeRF】使用一组二维图像渲染3D场景视频(mip-NeRF论文复现) 本文对mip-NeRF模型的pytorch实现进行了复现 阅读详情


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨

🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。

我是Srlua小谢,在这里我会分享我的知识和经验。🎥

希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮

记得先点赞👍后阅读哦~ 👏👏

📘📚 所属专栏:传知代码论文复现

欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙

​​

​​

​​​

目录

概述

原理介绍

传统NeRF的原理

mip-NeRF的改进

模型介绍

复现过程

安装环境

准备数据

训练(train)

评估(eval)

渲染(render)

参考资料


  本文所有资源均可在该地址处获取。

概述

NeRF(Neural Radiance Fields)是一种神经辐射场,用于将图像转换为3D场景表示。然而,在不同分辨率的训练或测试图像观察场景内容时,NeRF的渲染过程可能会产生过度模糊或伪影的图像。对于传统NeRF来说,使用多条光线对每个像素进行超采样的渲染方案是不实际的,因为渲染每条光线需要对MLP进行数百次查询。

本文提出的mip-NeRF模型,将NeRF扩展到连续值尺度上。通过向像素点投射一个锥形区域(而非光线)进行采样,mip-NeRF减少了伪影的产生,显著提高了NeRF对细节的表示能力,同时比NeRF快7%,仅为NeRF的一半大小。与NeRF相比,mip-NeRF在NeRF呈现的数据集上的平均误差率降低了17%,在多尺度变体数据集上降低了60%。此外,mip-NeRF还拥有与超采样NeRF相当的准确性,而速度快22倍。

原理介绍

传统NeRF的原理

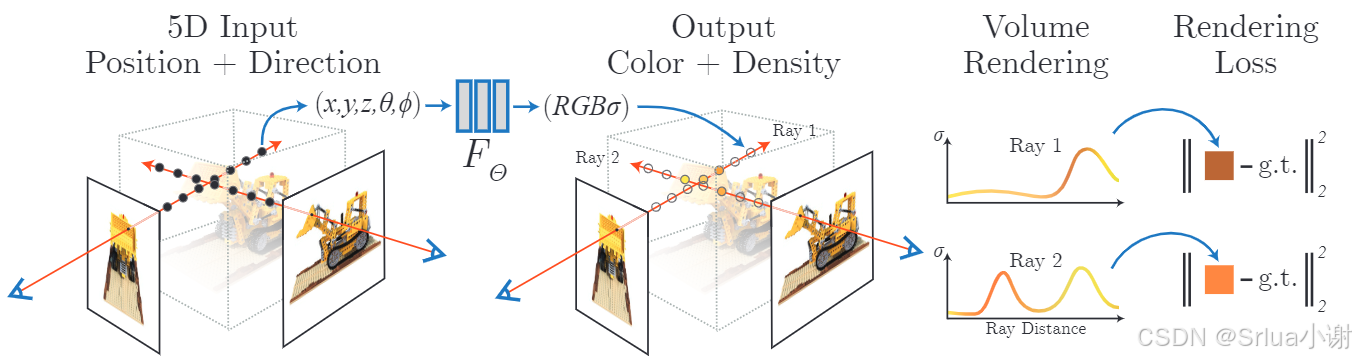
NeRF使用一个连续的5D函数来表示场景,并使用少量的输入视图来优化这个函数以生成复杂场景的新视角。NeRF使用基于MLP的全连接神经网络来表示场景,输入为一个连续的5D坐标,包括空间位置(x,y,z)和观察视角(θ, φ),输出为该空间位置的体密度σ和与视角相关的RGB颜色。通过沿着相机射线查询MLP并使用经典的体渲染技术将输出颜色和密度投影到图像中来生成新视图。
​

mip-NeRF的改进

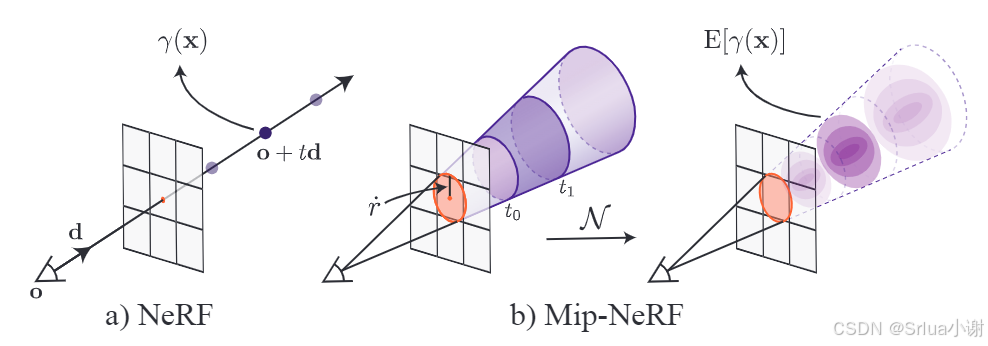
  1. 使用圆锥追踪代替光线追踪,从而显著改善了抗锯齿(伪影)效果。
  2. 使用集成位置编码(IPE)特征代替传统的位置编码(PE)特征,实现了更高效的采样和尺度编码。
  3. 通过单一的多尺度模型(而不是NeRF中的每个尺度单独的模型),使得mip-NeRF的准确性、效率和简单性都得到了提高。
​

模型介绍

Mip-NeRF是一种用于解决神经辐射场(NeRF)中降采样和抗锯齿问题的改进模型,模型的处理过程如下:

  1. 对于场景中的每个像素,从相机的中心沿着像素中心的方向投射一个圆锥。
  2. 计算每个采样间隔的集成位置编码(IPE)特征,作为多层感知机(MLP)的输入。
  3. MLP输出密度和颜色,用于渲染场景。

复现过程

笔者使用的硬件和系统环境如下:

  • 显卡使用RTX4090 24G(实际使用15.25G左右)
  • CPU:I9-10900X
  • 主存:46.8G
  • linux系统(ubuntu20.04.1-desktop)

*以上环境非最低要求,但尽量保证显卡显存16G以上,尽量使用linux桌面版系统

读者还需确保环境已正确安装nvidia显卡驱动(使用nvidia-smi命令能正常输出显卡信息)

我们基于pytorch框架的代码实现进行复现,有利于学习和环境搭建。

安装环境

  1. 克隆项目源码

    # 使用git克隆源码(笔者发现该源码由于作者更新过以后出现了些bug,
    # 笔者已经fork到自己的仓库,并修复了bug,推荐大家直接clone笔者的仓库)
    # git clone https://github.com/hjxwhy/mipnerf_pl.git #原作者仓库
    git clone https://github.com/Ryan2ky/mipnerf_pl.git
    # 进入项目目录
    cd mipnerf_pl
    

    用conda创建虚拟环境

  2. # 创建虚拟环境(推荐python版本为3.9.12)
    conda create --name mipnerf python=3.9.12
    # 激活环境
    conda activate mipnerf
    # 安装最新版的pip工具
    conda install pip
    pip install --upgrade pip
    # 使用pip安装依赖库
    pip install -r requirements.txt
    

    注意:如果读者使用的linux环境不支持桌面GUI,请将requirements.txt中的opencv-python==4.5.4.58依赖改为无头版本的opencv-python-headless==4.5.4.58

  3. 安装pytorch依赖

    可以前往地址根据自己的操作系统环境选择合适的pytorch版本:

    注意:pytorch的cuda工具包版本应根据显卡所支持的cuda版本选择(可使用nvidia-smi命令查看)

    (一般应满足:[pytorch+cuda]版本 <= [Cuda]版本)

    执行安装命令:

    pip3 install torch torchvision torchaudio
    

准备数据

  • 在项目根目录中创建一个data目录用来存放训练数据

  • 我们使用谷歌官方的NeRF数据集(下载链接见附件README.md中的Dataset小节)进行实验,将nerf_synthetic.zip 下载并解压到data目录下

  • 将nerf_synthetic数据集转换成多尺寸mipmap数据集

    python datasets/convert_blender_data.py --blender_dir ./data/nerf_synthetic --out_dir ./data/multiscale
    

至此,我们拥有了2个数据集,结构如下:

  • data
    • nerf_synthetic(单一尺寸Blender数据集)
    • multiscale(多尺寸Blender数据集)

训练(train)

我们以lego这一数据集为例,进行单尺寸和多尺寸的训练:

  1. 配置

    我们可以在configs文件夹下配置训练的参数,默认使用的是configs/default.yaml,其中已经配置好了lego场景的参数,我们可以复制一份到lego-multiscale.yaml,并修改exp_name为lego_multiscale加以区分。读者还可以根据需求配置一些其他的参数,例如:

    • check_interval:验证并保存模型的频率,该参数表示每经过一定步数,即进行一次验证,并保存模型到ckpt文件夹下。
    • resume_path:从ckpt恢复模型以继续训练,首次训练时应当设为None表示无需从ckpt恢复。
  2. 训练

    # 训练单一尺寸数据集
    python train.py --out_dir ./out --data_path ./data/nerf_synthetic/lego --dataset_name blender
    # 训练多尺寸数据集
    python train.py --out_dir ./out --data_path ./data/multiscale/lego --dataset_name multi_blender --config ./config/lego-multiscale.yaml
    

  3. 中断与恢复

    默认配置下,训练会不断进行(不超过max_steps),当认为差不多时,可以手动ctrl+c终止训练。训练模型保存在./out/{exp_name}/ckpt中。

    如果因为异常导致终止,我们也可以从之前保存的ckpt中恢复,只需在配置文件中指定resume_path为具体的ckpt文件即可。

评估(eval)

#单尺寸模型评估
python eval.py --ckpt ./out/lego/ckpt/last.ckpt --data ./data/nerf_synthetic/lego --out_dir ./out --scale 1 --save_image
#多尺寸模型评估
python eval.py --ckpt ./out/lego_multiscale/ckpt/last.ckpt --data ./data/multiscale/lego --out_dir ./out --scale 4 --save_image

评估结果存放在./out/{exp_name}/test下。

渲染(render)

# 单尺寸模型渲染
python render_video.py --ckpt ./out/lego/ckpt/last.ckpt --out_dir ./out --scale 1
# 多尺寸模型渲染
python render_video.py --ckpt ./out/lego_multiscale/ckpt/last.ckpt --out_dir ./out --scale 4

渲染结果保存在./out/{exp_name}/render_spheric下。

参考资料

论文地址:https://arxiv.org/abs/2103.13415

​​​

如何使用cornerstone3D渲染3D影像 在日常开发中经常会遇到除了渲染MPR视图外,还需要渲染3D扫描影像,本文从具体的实现、viewport type解读、场景预设等方面来介绍3D具体的实现及涉及到的相关概念。 阅读详情

相关推荐

AIGC视频生成中的3D场景重建技术详解

随着AIGC技术的爆发式发展,视频生成领域正经历从2D内容到3D场景的跨越式升级。3D场景重建作为连接视觉输入与虚拟世界的核心技术,能够从单视图或多视图视频中恢复真实场景的三维结构,为虚拟相机运镜、场景编辑、数字人合成等高级视频生成功能提供底层支撑。本文聚焦AIGC视频生成中3D场景重建的核心技术栈,涵盖传统计算机视觉方法(如多视图立体视觉)与深度学习方法(如神经辐射场NeRF),深入解析技术原理、数学模型、算法实现及工程落地经验,帮助读者建立从理论到实践的完整认知体系。基础理论。

大模型应用工坊 1349

【传知代码】用二维图像渲染3D场景视频-论文复现

本文介绍了mip-NeRF,这是一种改进的神经辐射场(NeRF)技术,用于用二维图像渲染3D场景视频。mip-NeRF通过多尺度表示和圆锥体采样减少伪影,提高细节表现力,比传统NeRF速度快7%,大小减半。相较于NeRF,mip-NeRF在某些数据集上的误差降低17%-60%。文章提供了源码链接,包括优快云和阿里云平台,读者可以获取源码进行复现。mip-NeRF的亮点在于圆锥追踪、集成位置编码和多尺度模型,解决了NeRF的抗锯齿和效率问题,适用于3D渲染等多个领域。

感谢关注-最近在编写开源的自动化测试框架还没整理完 1465

政安晨:【Keras机器学习示例演绎】(七)—— 利用 NeRF 进行 3D 体积渲染

本文目标:NeRF 中显示的体积渲染的最小实现。 在本示例中,我们将介绍 Ben Mildenhall 等人的研究论文 NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis 的最小实现。 作者提出了一种巧妙的方法,即通过神经网络对体积场景函数进行建模,从而合成场景的新颖视图。

政安晨——致力于AI人工智能数字互动领域 1439

什么是3D渲染?3D渲染的类型有哪些?

当涉及更复杂的渲染(如 3D 动画)时,成本可能达到每分钟 几万元或更多,具体取决于特征的多样性——从多边形计数到设计的复杂性(这已经涉及到 3D 建模,而不是渲染) . 因此,您应该与您喜欢的3D建模和渲染服务提供商讨论所有合作条件,因为只有他们才知道细节。,支持cpu及gpu渲染,可批量渲染,也可联机渲染,速度快效率高,大幅度降低成本,不占用本地的电脑做其它的工作,根据需求选择合适的配置,不用在本地购买硬件配置,按需使用,大幅度提高渲染速度,降低资金投入,提升工作效率,将更多的时间花费在创作创意上面。

专注于3D渲染行业,分享3D渲染的经验和技巧 2942

NeRF技术的3D渲染和场景重建项目实战

NeRF,即神经辐射场,是一种前沿的3D渲染技术,它通过神经网络来建模和渲染出高保真的3D场景。这项技术将传统图形学的渲染方法与深度学习相结合,利用连续的体渲染模型,对光线在3D空间中的传播进行建模,进而生成逼真的图像。NeRF能够处理复杂的场景,比如有着不规则光照和反射特性的场景,并能生成具有深度感和真实感的视觉效果。NeRF的应用已经渗透到了虚拟现实、游戏开发、影视特效等多个领域,极大地提升了数字化内容创作的质量和效率。

weixin_34413326的博客 866

D3D多层YUV420P纹理渲染技术与实践

在3D图形处理中,纹理贴图是一种将二维图像(纹理)应用到三维模型表面的技术,目的是增加场景的视觉复杂性和真实感。通过这种技术,可以在不显著增加几何模型复杂度的情况下,极大地提高图形的质量和细节。纹理贴图的实现主要依赖于纹理坐标系统。在模型的每个顶点上定义纹理坐标,这些坐标被插值到多边形面上,从而确定每个像素的纹理样本。这种技术允许模型具有颜色、光照、阴影和反射等更多细节。纹理坐标,又称UV坐标,是定义在模型顶点上的二维坐标系统。它的范围一般从0到1。

weixin_34456923的博客 628

使用NeRF进行3D体素渲染

使用NeRF进行3D体素渲染 文章目录使用NeRF进行3D体素渲染前言一、设置二、下载并载入数据3.数据处理流程四、NeRF模型五、训练六、训练步骤可视化七、推理八、渲染3D场景九、视频可视化总结 前言 在这个例子中,我们展示了文献NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis的最小实现。作者提出了一种巧妙的方法,通过神经网络对体积场景函数进行建模,从而合成场景的新视图。 为了帮助您直观地理解这一点,让我们从以

葫芦与瓢的博客 6286

insight3D:开源软件创建3D模型的探索之旅

随着3D技术的广泛应用,开源社区诞生了一款名为insight3D的软件,它旨在为用户提供一种高效、灵活的方式来处理和展示三维数据。本章节将详细介绍insight3D软件的核心功能、应用场景以及如何通过其开源特性为特定需求定制化解决方案。

weixin_33239721的博客 1187

电商3D产品渲染简明教程

3D 产品渲染是从 3D 模型创建 2D 图像的过程。换句话说,这就像为计算机软件中存在的产品拍照一样,以便可以轻松查看和共享。在过去几年中,随着 3D 建模和渲染软件的出现,3D 渲染现在更常用于营销和促销目的。设计师、制造商和营销人员使用 3D 产品渲染来制作逼真的照片、动画和交互式 3D 模型,以帮助解释、推广和销售产品。3D 产品渲染的最终结果可能会因几个因素而有所不同。人才、建模软件和渲染引擎都会影响最终的输出。

新缸中之脑 2695

团结引擎+OpenHarmony 2实战篇:从零构建鸿蒙应用开发环境

本文详细介绍了如何从零开始构建鸿蒙应用开发环境,重点讲解了团结引擎与OpenHarmony 2的实战配置步骤。内容包括DevEco Studio安装、OpenHarmony SDK配置、团结引擎集成及项目创建等关键环节,帮助开发者快速搭建高效的开发环境,提升鸿蒙应用开发效率。

weixin_29294395的博客 266

3DGS实战避坑指南:从零搭建到成功训练

本文详细介绍了3D Gaussian Splatting(3DGS)从环境配置到成功训练的实战避坑指南。涵盖git clone的正确使用、依赖安装的隐藏陷阱、CUDA版本兼容性解决方案、首次训练验证、常见报错急救方案、性能优化技巧及可视化调试方法,帮助开发者高效搭建和训练3DGS模型。

weixin_29053383的博客 368

3d重建+神经渲染

从这些训练视点,渲染估计的3D场景,并最小化渲染图像和观察图像之间的差异,根据这些观察结果训练网络。与使用神经网络学习渲染函数的方法相反,NeRF在该方法中更明确地使用了计算机图形学的知识,由于(物理)归纳偏差,能够更好地概括新视图:场景密度和半径的中间3D结构化表示。因此,NeRF在3D空间中学习物理上有意义的颜色和密度值,物理激发的光线投射和体集成可以持续渲染到新视图中。在该架构中,首先提取深层的视觉图像特征,然后通过可微分的单应变换,基于参考视图的相机视锥体构建3D代价体。

noobiee的博客 2534

爬虫君子协议-robots.txt协议

文章目录一.定义二.用法 一.定义 robots协议是一种约定俗称的爬虫协议,由网站主人规定了该网站的哪些内容可以爬取,哪些内容不可以爬取,擅自爬取可能承担相关法律责任。之所以称之为君子协议,是因为防君子不防小人,该协议并没有用技术手段实现反爬,只是一个申明。 在网站根目录后输入/robots.txt后即可查看该网站的君子协议 例如访问https://www.douban.com/robots.txt可查看豆瓣网站的君子协议 查看结果如下 User-agent: * Disallow: /subject_

Henrik-Yao的博客 7619

只需5秒视频就能生成3D模型的AI工具——Luma AI

以往建一个3D场景,需要花费大量的时间和精力。现在有了Luma AI,可以轻松创造出电影级别的3D效果。即使一个小白也能分分钟掌握,基本达成人人零门槛设计3D建模啦!

CCEEHM的博客 3万+

Windows音效增强设置详解:从系统开关到专业EQ调音

声音信号在Windows系统中需要经过混音器、声卡驱动与APO效果器等多层处理链路,最终才到达耳机或音箱。系统自带的响度均衡、低音增强、虚拟环绕等音频增强选项,本质上是对动态范围和频响的干预,理解其原理才能避免盲目开启导致声音发闷或失真。空间音效与采样率的正确配置,可减少SRC重采样带来的音质损失,而Win11的音频增强开关和通信设置也常被忽视。无论是板载声卡还是USB解码耳放,合理利用系统增强和Equalizer APO等工具,都能显著改善听感体验。本文结合场景给出设置建议,帮助用户告别声音浑浊,获得干净

weixin_31155097的博客 416

最新版IAR9.40和注册工具

IAR最新版的IDE在编译速度和代码提示等各个方面上都有很大提升,软件这个东西果然还是越新越好。之前的时候,IAR v9系列网上很多人都说能用,但是又没有把 IAR v9系列的注册方法写的很清楚,导致我一直都用注册老版本v8的方法去注册v9。结果注册后都会提示。

xue_nuo的博客 4万+

Unity 场景烘培 ——浅谈渲染管线流程的理解 (五)

渲染管线是计算机图形中最基础最核心的部分,但大多程序对它不是很了解,当然我也是,所有花时间去了解一下。我们有一个对知识点的认知度等级:了解,熟悉,精通,专业。在了解前…我对渲染管线认知:听说。哈哈!B站视频、优快云文章、及Siki付费课程结合理解编写(文章内容大多是优快云道友写的,我看了看写的太好了,干脆搬过来)主要参考文章:优快云链接:Unity3D 渲染管线全流程解析B站:链接:什么是渲染管线SiKi:链接:ShaderGraph入门教程好记性不如烂笔头!

qq_37524903的博客 1440

CEH Practical 实战考试真题与答案

CEH Practical 是 EC-Council 推出的Certified Ethical Hacker(CEH)认证项目中的一项高级动手实践考试。它不同于传统的理论考试,侧重于在真实环境中检验考生的实操能力。

sgafdgdagd的博客 970

有关实时3D渲染:定义、工作原理和应用方向

什么是实时3D渲染?它是如何工作的?简单地说,实时三维渲染允许用户查看或与模拟实时运动的三维图像和场景互动。实时成像允许对想法和设计进行更全面的可视化,包括它们在实际中的体验。三维渲染也可以让设计师和营销团队之间有更大的合作和创新。

RealTime_3DCAT的博客 1641

基于卷积神经网络CNN实现电力负荷多变量时序预测(PyTorch版)

随着智能电网的发展,精准的电力负荷预测对能源调度和电网稳定具有重要意义。本文基于PyTorch框架,提出一种基于卷积神经网络(CNN)的多变量时间序列预测模型,用于电力负荷的短期预测。

时序笔记 989

[从零开始学习FPGA编程-18]:快速入门篇 - 操作步骤2-6- VerilogHDL时序电路语法分析(以计数器为例)

目录前言:第1章 功能模块代码:counter.v第2章 驱动代码:tcounter.v前文以及阐述了VerilogHDL基本语法,本文将以modelsim自带的计数器程序来解读VerilogHDL的语法。代码路径:

文火冰糖(王文兵)的博客 7万+

SAM2POINT:以zero-shot且快速的方式将任何 3D 视频分割为视频

SAM2POINT 3D作为视频分割

qq_51659249的博客 1743

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

苹果的「AI 建筑师」GAUDI:根据文本生成 3D 场景

作者:李梅 | 编辑:陈彩娴 |转载自:AI科技评论(aitechtalk)如今,每隔一段时间就有新的文本生成图像模型释出,个个效果都很强大,每每惊艳众人,这个领域已经是卷上天了。不过,像 OpenAI 的 DALL-E 2 或谷歌 的 Imagen 等 AI 系统,都只能生成二维图像,如果文字也能变成三维场景,那带来视觉体验势必加倍提升。现在,来自苹果的 AI 团队推出了 3D 场景生...

idol24的博客 1万+

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Shader开发(一)什么是渲染

渲染技术是现代计算机图形学的核心,理解其基本概念是深入学习shader编程和图形优化的重要基础。随着硬件技术的发展和新算法的出现,渲染领域仍在快速演进,为开发者提供了更多创新的可能性。

ZeroBugX的博客 866

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【三维AIGC】扩散模型LDM辅助3D Gaussian重建三维场景

本文**提出一个三维场景的潜在扩散模型**,它仅使用2D图像数据训练。文章首先设计了一个 **1.自动编码器,将多视图图像映射到三维GS** ,同时构建这些splats的压缩潜在表示。然后,我们 **2.在潜在空间上训练一个多视图扩散模型来学习一个有效的生成模型** 。该管道不需要对象的mask 或深度,并且适用于具有任意摄像机位置的复杂场景。我们在两个复杂真实场景的

qq_45752541的博客 3110

RTX4090 云 GPU 在 Diffusion 3D 渲染中的测试

本文探讨了RTX4090云GPU在Diffusion 3D渲染中的技术优势与实践部署,分析其硬件架构如何支持基于扩散模型的3D内容生成,涵盖算法原理、性能优化及实际应用挑战。

weixin_42620563的博客 1083
上一篇: 联合模态融合+图对比学习
下一篇: 无监督目标检测最新CVPR解读
Srlua小谢
Srlua小谢 优质创作者: 编程框架技术领域 优质创作者: 编程框架技术领域
博客等级 码龄4年 8963粉丝 332原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
