


一、前言
在Go语言中,切片是一个非常常用的数据结构,很多开发者在编写代码时都会频繁使用它。尽管切片很方便,但有一个问题常常让人感到困惑:当我们把切片作为参数传递给函数时,为什么有时候切片的内容会发生变化?这让很多人一头雾水,甚至在调试时浪费了不少时间。
这篇文章简单明了地探讨这个问题,揭示切片按值传递时发生变化的原因。我们通过一些简单的示例,帮助大家理解这一现象是如何发生的,以及如何在实际开发中避免相关的坑。希望这篇文章能让你对Go切片有更清晰的认识,少走一些弯路!
二、思考
在开始之前我们先来看几则单测,思考一下切片调用reverse之后会发生什么样的变化?为什么会有这样的变化?
func TestReverse(t *testing.T) {
    var s []int
    for i := 1; i <= 3; i++ {
       s = append(s, i)
    }
    reverse(s)
}


func reverse(s []int) {
    for i, j := 0, len(s)-1; i < j; i++ {
       j = len(s) - (i + 1)
       s[i], s[j] = s[j], s[i]
    }
}
func TestReverse2(t *testing.T) {
    var s []int
    for i := 1; i <= 3; i++ {
       s = append(s, i)
    }
    reverse2(s)
}


func reverse2(s []int) {
    s = append(s, 4)
    for i, j := 0, len(s)-1; i < j; i++ {
       j = len(s) - (i + 1)
       s[i], s[j] = s[j], s[i]
    }
}
func TestReverse3(t *testing.T) {
    var s []int
    for i := 1; i <= 3; i++ {
       s = append(s, i)
    }
    reverse3(s)
}


func reverse3(s []int) {
    s = append(s, 4, 5)
    for i, j := 0, len(s)-1; i < j; i++ {
       j = len(s) - (i + 1)
       s[i], s[j] = s[j], s[i]
    }
}
带着上面的疑问,接下来我们回顾一下切片的基础知识点。
三、切片的结构
type slice struct {
    array unsafe.Pointer
    len   int
    cap   int
}
Go切片的底层结构由以下三个部分组成:
-
指针(unsafe.Pointer):
指向底层数组的第一个元素。如果切片的长度为 0,那么指针可以是nil。这个指针允许切片访问底层数组中的元素。 -
长度(len):
切片中实际包含的元素个数。通过len(slice)可以获取切片的长度。
长度决定了切片在进行迭代或访问元素时的范围。 -
容量(cap):
切片底层数组的大小,表示切片可以增长的最大长度。可以通过 -
cap(slice)获取容量。
当切片的长度达到容量时,使用append函数添加更多元素时,Go会新分配一个更大的数组并复制现有元素。
一个切片的示意图如下:

四、切片的创建
直接创建切片
func TestCreate(t *testing.T) {
    slice := []int{1, 2, 3}
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(slice), cap(slice), &slice, slice)
}
上述示例代码运行输出如下:
len=3, cap=3, slicePointer=0xc0000980d8, sliceArrayPointer=0xc0000b2048
此时创建出来的切片对应图示如下:

直接创建切片时,会为切片的底层数组开辟内存空间并使用指定的元素对数组完成初始化,且创建出来的切片的len等于cap等于初始化元素的个数。
从整个数组切得到切片
func TestCreate(t *testing.T) {
    originArray := [3]int{1, 2, 3}
    slice := originArray[:]
    fmt.Printf("originArrayPointer=%p\n", &originArray)
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(slice), cap(slice), &slice, slice)
}
上述示例代码运行打印如下:
originArrayPointer=0xc000010198
len=3, cap=3, slicePointer=0xc0000080f0, sliceArrayPointer=0xc000010198
此时创建出来的切片对应图示如下:

从整个数组切,实际就是切片直接使用了这个数组作为底层的数组。
从前到后切数组得到切片
func TestCreate(t *testing.T) {
    originArray := [6]int{1, 2, 3, 4, 5, 6}
    slice := originArray[:3]
    fmt.Printf("originArrayPointer=%p\n", &originArray)
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(slice), cap(slice), &slice, slice)
}
上述在切数组时,没有指定数组的开始索引,表示从索引0开始切(inclusive),指定了数组的结束索引,表示切到结束索引的位置(exclusive),运行代码输出如下:
originArrayPointer=0xc0000144c0
len=3, cap=6, slicePointer=0xc0000080f0, sliceArrayPointer=0xc0000144c0
此时创建出来的切片对应图示如下:

从前到后切数组得到的切片,len等于切的范围的长度,对应示例中索引0(inclusive)到索引2(exclusive)的长度3,而cap等于切的开始位置(inclusive)到数组末尾(inclusive)的长度6。
从数组中间切到最后得到切片
func TestCreate(t *testing.T) {
    originArray := [6]int{1, 2, 3, 4, 5, 6}
    slice := originArray[3:]
    fmt.Printf("originArrayPointer=%p\n", &originArray)
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(slice), cap(slice), &slice, slice)
}
上述在切数组时,指定了数组的开始索引,表示从索引3(inclusive)开始切,没有指定数组的结束索引,表示切到数组的末尾(inclusive),运行代码输出如下:
originArrayPointer=0xc0000bc060
len=3, cap=3, slicePointer=0xc0000980d8, sliceArrayPointer=0xc0000bc078
此时创建出来的切片对应图示如下:

从数组中间切到最后得到的切片,len等于cap等于切的范围的长度,对应示例中索引3(inclusive)到数组末尾(inclusive)的长度3。并且由上述图示可以看出,切片使用的底层数组其实还是被切的数组,只不过使用的是被切数组的一部分。
从数组切一段得到切片
func TestCreate(t *testing.T) {
    originArray := [6]int{1, 2, 3, 4, 5, 6}
    slice := originArray[2:5]
    fmt.Printf("originArrayPointer=%p\n", &originArray)
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(slice), cap(slice), &slice, slice)
}
上述在切数组时,指定了数组的开始索引,表示从索引2(inclusive)开始切,也指定了数组的结束索引,表示切到数组的索引5的位置(exclusive),运行代码输出如下:
originArrayPointer=0xc0000bc060
len=3, cap=4, slicePointer=0xc0000980d8, sliceArrayPointer=0xc0000bc070
此时创建出来的切片对应图示如下:

从数组切一段得到的切片,len等于切的范围的长度,对应示例中索引2(inclusive)到索引5(exclusive)的长度3,cap等于切的开始位置(inclusive)到数组末尾(inclusive)的长度4。切片使用的底层数组还是被切数组的一部分。
从切片切得到切片
func TestCreate(t *testing.T) {
    originArray := [6]int{1, 2, 3, 4, 5, 6}
    originSlice := originArray[:]
    derivedSlice := originSlice[2:4]
    fmt.Printf("originArrayPointer=%p\n", &originArray)
    fmt.Printf("originSlice: len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(originSlice), cap(originSlice), &originSlice, originSlice)
    fmt.Printf("derivedSlice: len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p\n",
       len(derivedSlice), cap(derivedSlice), &derivedSlice, derivedSlice)
}
上述示例代码中,originSlice是切数组originArray得到的切片,derivedSlice是切切片originSlice得到的切片,运行代码输出如下:
func TestCreate(t *testing.T) {
    slice := make([]int, 3, 5)
    fmt.Printf("slice: len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, slice=%v\n",
       len(slice), cap(slice), &slice, slice, slice)
}
此时创建出来的切片对应图示如下:

从切片切得到切片后,两个切片会使用同一个底层数组,区别就是可能使用的是底层数组的不同区域,因此如果其中一个切片更改了数据,而这个数据恰好另一个切片可用访问,那么另一个切片访问该数据时就会发现数据发生了更改。但是请注意,虽然两个切片使用同一个底层数组,但是切片的len和cap都是独立的,也就是假如其中一个切片通过类似于append() 函数导致len或者cap发生了更改,此时另一个切片的len或者cap是不会受影响的。
使用make函数得到切片
make() 函数专门用于为slice,map和chan这三种引用类型分配内存并完成初始化,make() 函数返回的就是引用类型对应的底层结构体本身,使用make() 函数创建slice的示例代码如下所示:
func TestCreate(t *testing.T) {
    slice := make([]int, 3, 5)
    fmt.Printf("slice: len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, slice=%v\n",
       len(slice), cap(slice), &slice, slice, slice)
}
上述示例代码中,会使用make() 函数创建一个int类型的切片,并指定len为3(第二个参数指定),cap为5(第三个参数指定),其中可以不指定cap,此时cap会取值为len。运行代码输出如下:
slice: len=3, cap=5, slicePointer=0xc0000980d8, sliceArrayPointer=0xc0000bc060, slice=[0 0 0]
此时访问索引3或索引4的元素,会引发panic:
func TestCreate(t *testing.T) {
    slice := make([]int, 3, 5)
    fmt.Printf("slice: len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, slice=%v\n",
       len(slice), cap(slice), &slice, slice, slice)
    fmt.Printf("%p\n", &slice[3])
    fmt.Printf("%p\n", &slice[4])
}
panic: runtime error: index out of range [3] with length 3
五、切片的扩容
在Go语言中,当使用append()函数向切片添加元素时,如果切片的当前长度达到了它的容量,Go会自动触发扩容。扩容是指创建一个新的更大的底层数组,并将原有元素复制到新数组中。以下是关于切片触发扩容的详细说明。
触发扩容的条件
- 当调用append()函数,如果当前长度小于容量,可以直接在底层数组中添加新元素;当切片的长度(len)达到或超过它的容量(cap)时,就会触发扩容。
扩容操作
- Go 会分配一个新的底层数组。
- 原有的元素会被复制到新的数组中。
- 切片的指针会更新为指向新的底层数组,长度和容量也会相应更新。
最新的扩容规则在1.18版本中就已经发生改变了,具体可以参考一下这个 commit:runtime: make slice growth formula a bit smoother。
在之前的版本中:对于<1024个元素,增加2倍,对于>=1024个元素,则增加1.25倍。而现在,使用更平滑的增长因子公式。在256个元素后开始降低增长因子,但要缓慢。
它还给了个表格,写明了不同容量下的增长因子:

从这个表格中,我们可以看到,新版本的切片库容,并不是在容量小于1024的时候严格按照2倍扩容,大于1024的时候也不是严格地按照1.25倍来扩容;在slice.go源码中也验证了这一点。
// nextslicecap computes the next appropriate slice length.
func nextslicecap(newLen, oldCap int) int {
    newcap := oldCap
    doublecap := newcap + newcap
    if newLen > doublecap {
       return newLen
    }


    const threshold = 256
    if oldCap < threshold {
       return doublecap
    }
    for {
       // Transition from growing 2x for small slices
       // to growing 1.25x for large slices. This formula
       // gives a smooth-ish transition between the two.
       newcap += (newcap + 3*threshold) >> 2


       // We need to check `newcap >= newLen` and whether `newcap` overflowed.
       // newLen is guaranteed to be larger than zero, hence
       // when newcap overflows then `uint(newcap) > uint(newLen)`.
       // This allows to check for both with the same comparison.
       if uint(newcap) >= uint(newLen) {
          break
       }
    }


    // Set newcap to the requested cap when
    // the newcap calculation overflowed.
    if newcap <= 0 {
       return newLen
    }
    return newcap
}
上面说到:一旦触发扩容,会创建新容量大小的数组,然后将老数组的数据拷贝到新数组上,再然后将附加元素添加到新数组中,最后切片的array指向新数组。也就是说,切片扩容会导致切片使用的底层数组地址发生变更,我们通过代码来了解这一过程:
func TestSliceGrow(t *testing.T) {
    // 原始数组
    originArray := [6]int{1, 2, 3, 4, 5, 6}
    // 原始切片
    originSlice := originArray[0:5]
    // 打印原始切片和原始数组的信息
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, originArrayPointer=%p\n",
       len(originSlice), cap(originSlice), &originSlice, originSlice, &originArray)
    // 第一次append不会触发扩容
    firstAppendSlice := append(originSlice, 7)
    // 打印第一次Append后的切片和原始数组的信息
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, originArrayPointer=%p\n",
       len(firstAppendSlice), cap(firstAppendSlice), &firstAppendSlice, firstAppendSlice, &originArray)
    // 第二次append会触发扩容
    secondAppendSlice := append(firstAppendSlice, 8)
    // 打印第二次Append后的切片和原始数组的信息
    fmt.Printf("len=%d, cap=%d, slicePointer=%p, sliceArrayPointer=%p, originArrayPointer=%p\n",
       len(secondAppendSlice), cap(secondAppendSlice), &secondAppendSlice, secondAppendSlice, &originArray)
}
运行上面代码输出如下:
len=5, cap=6, slicePointer=0xc0000980d8, sliceArrayPointer=0xc0000bc060, originArrayPointer=0xc0000bc060
len=6, cap=6, slicePointer=0xc000098108, sliceArrayPointer=0xc0000bc060, originArrayPointer=0xc0000bc060
len=7, cap=12, slicePointer=0xc000098138, sliceArrayPointer=0xc0000862a0, originArrayPointer=0xc0000bc060
在示例代码中,切数组originArray得到的切片如下所示:

第一次append元素后,切片如下所示:

第二次append元素时,会触发扩容,扩容后的切片如下所示:
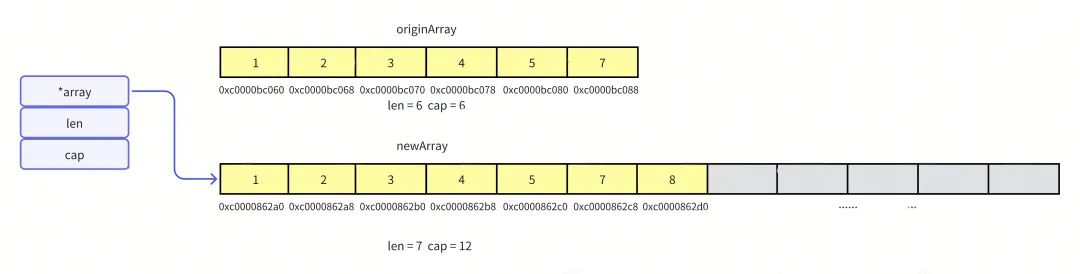
可见,扩容后切片使用了另外一个数组作为了底层数组。对扩容之后的切片任何操作将不再影响原切片;反之:扩容之前,对新切片的新增和修改影响的是底层数组,同时也会影响引用了该数组的任何切片。
现在,让我们回顾一下文章开头提到的三个单元测试,运行它们后得到的结果是否符合你的预期?结合我们对切片创建、初始化和扩容的基础知识,你是否能理解为何切片在传递时是值传递,但原始切片中的元素却可能会发生变化?
六、总结
这篇文章通过简单明了的示例,深入分析了Go语言中切片作为参数传递时值变化的问题。揭示了切片的运行机制,帮助开发者理解为什么在函数内部对切片的修改会影响到原始切片的内容。这样的分析旨在消除开发中遇到的困惑,为实际开发提供更清晰的指导。
最重要的是,希望这篇文章能够传达一个信息:当你对某个现象的原因尚不完全理解时,花时间去深入探究是非常值得的。这种探究不仅能提升你的编程能力,更能培养解决问题的能力。
*文/徒徒
本文属得物技术原创,更多精彩文章请看:得物技术
未经得物技术许可严禁转载,否则依法追究法律责任!
往期回顾
得物自建 Redis 无人值守资源均衡调度设计与实现
得物App白屏优化系列|归因篇
基于MySQL内核的SQL限流设计与实现|得物技术
得物App弱网诊断探索之路

 409


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


