


在 Lakehouse 架构中,数据通常以开放湖格式(如 Iceberg)存放在对象存储中,并由 Spark、Flink、Trino、Apache Doris 等计算引擎共同管理和访问。这是一套天然的存算分离架构,并且同一份开放数据可以服务于不同的计算场景。
但数据开放,并不意味着操作链路已经统一。围绕同一张 Iceberg 表,之前的分工往往是这样的:Iceberg 做表格式,Spark 负责管理(写入、修改、维护),Doris 负责查询。
这套分工的代价不在性能,而在链路。
假设一名数据工程师在 Doris 中发现某个批次的一条记录存在错误。修复本身可能只需要一条 UPDATE,但他仍需编写 Spark 任务、调整调度配置、提交代码评审,再等待平台团队执行。数据修改只需几秒,整个流程却可能持续十几个小时。
表维护也是如此。CDC 数据持续小批量写入并伴随频繁更新或删除后,小文件和删除信息会逐渐累积。工程师即使知道可通过 rewrite_data_files 优化文件布局,也可能因操作依赖另一套平台,最终将一条 SQL 变成等待排期的跨团队任务。
问题不在于 Iceberg 不够开放,而在于围绕同一张表的查询、修改和维护被拆散在不同系统里——为了完整地操作一张 Iceberg 表,用户必须同时维护两套技术栈。
Apache Doris 4.1 要补齐的,正是缺失的那一半。在已有查询能力的基础上,Doris 进一步支持了 UPDATE、DELETE、MERGE INTO 等数据修改操作、完整的表结构管理与分区演进,以及 rewrite_data_files、expire_snapshots 等日常维护操作,并完整支持 Iceberg V3 格式。分工因此可以简化为:
Iceberg 做表格式,Doris 同时负责管理和查询。
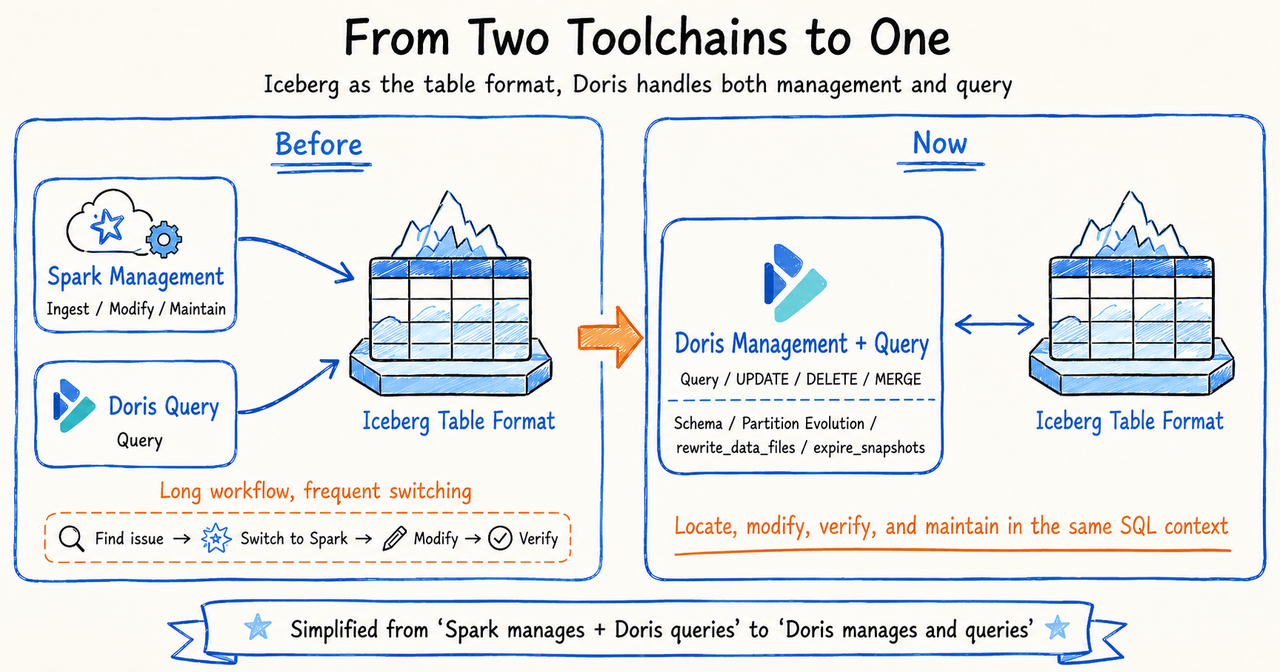
用户在查询中定位到问题之后,可以继续在当前 SQL 上下文中修改数据、验证结果并完成后续维护,不必再为了改一行数据而切换到另一套系统。
Apache Doris 在 Iceberg 生态中的定位
此前,Doris 在 Iceberg 生态中主要承担实时查询角色。到了 Apache Doris 4.1,这一角色扩展为覆盖数据读取、修改、表结构演进和日常维护的完整生命周期。
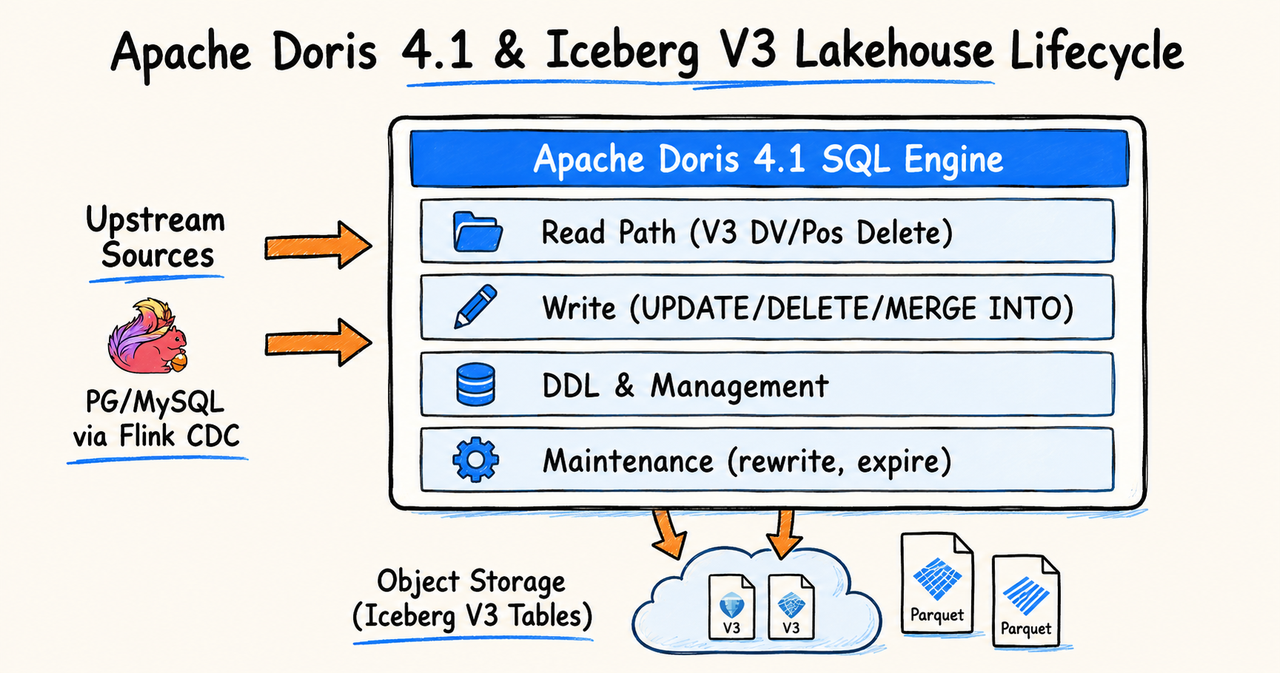
目前支持的主要范围包括:
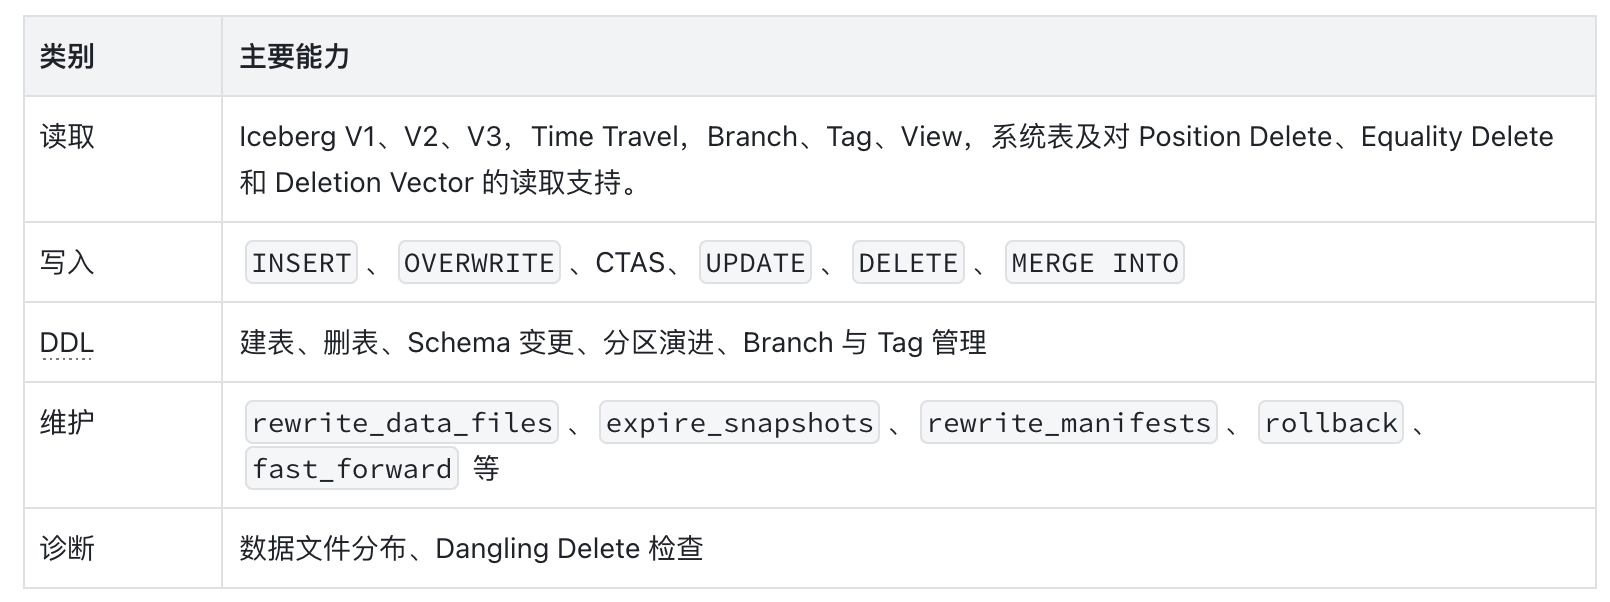
这并不意味着 Doris 要取代 Spark 或 Flink。Spark 擅长复杂的批处理与跨数据源 ETL,Flink 擅长持续的流式摄入与处理,Doris 擅长高并发、低延迟的实时分析。用户完全可以按照自己的技术栈,继续为每类任务选择最合适的引擎。
改变的是 Doris 的能力边界。过去,只要涉及对 Iceberg 表的任何修改——哪怕只是改一行数据、加一个字段、合一次小文件,用户都必须离开 Doris;现在,从数据查询、数据修改、增量合并,到表结构演进与文件维护,围绕 Iceberg 表的大部分日常工作都可以在 Doris 中直接完成。用户不再因为「Doris 改不了 Iceberg」这一条限制,被迫为同一张表搭起第二套系统。
本文将重点介绍其中两部分内容:Iceberg 表上的主要 DML 操作,以及支撑这些操作长期可用的 Iceberg V3 能力。
在 Doris 中修改 Iceberg 表:DML 与 Iceberg V3
最直观的变化,是用户可以在当前 SQL 客户端中直接修改 Iceberg 数据。
例如,修正查询中发现的错误记录:
UPDATE iceberg_tbl
SET name = 'Alice-fixed'
WHERE id = 1;
删除错误写入的数据批次:
DELETE FROM iceberg_tbl
WHERE dt = '2026-04-01'
  AND source = 'bad_pipeline';
对于 CDC 入湖或增量宽表场景,则可以通过 MERGE INTO 同时表达更新、删除和插入:
MERGE INTO iceberg_tbl t
USING incremental_data s
ON t.id = s.id

WHEN MATCHED AND s.flag = 'D' THEN
    DELETE

WHEN MATCHED THEN
    UPDATE SET
        name = s.name,
        age = s.age

WHEN NOT MATCHED THEN
    INSERT (id, name, age)
    VALUES (s.id, s.name, s.age);
Doris 支持 WHEN MATCHED THEN UPDATE、WHEN MATCHED THEN DELETE 和 WHEN NOT MATCHED THEN INSERT 等常见分支,也支持使用子查询作为数据源。
需要注意的是,Doris 的 UPDATE、DELETE 和 MERGE INTO 只作用于 format-version = 3 的 Iceberg 表(同时需要将 Doris 升级至 4.1 及以上版本)。因为决定这些 DML 能否长期可用的,从来不是「能不能执行」,而是「高频执行之后,这张表会变成什么样」。而这恰好是 Iceberg V3 要解决的问题。
Deletion Vector:让高频 DML 的代价不再累积
Iceberg V3 引入 Deletion Vector,使用位图记录数据文件中已经失效的行,并将相关信息存储在 Puffin 文件中。与为每次操作生成独立 Position Delete 文件不同,对同一数据文件产生的多次删除可以通过 Deletion Vector 统一表达:一个数据文件最多对应一个 Deletion Vector,查询时在扫描数据文件的过程中直接应用对应位图。
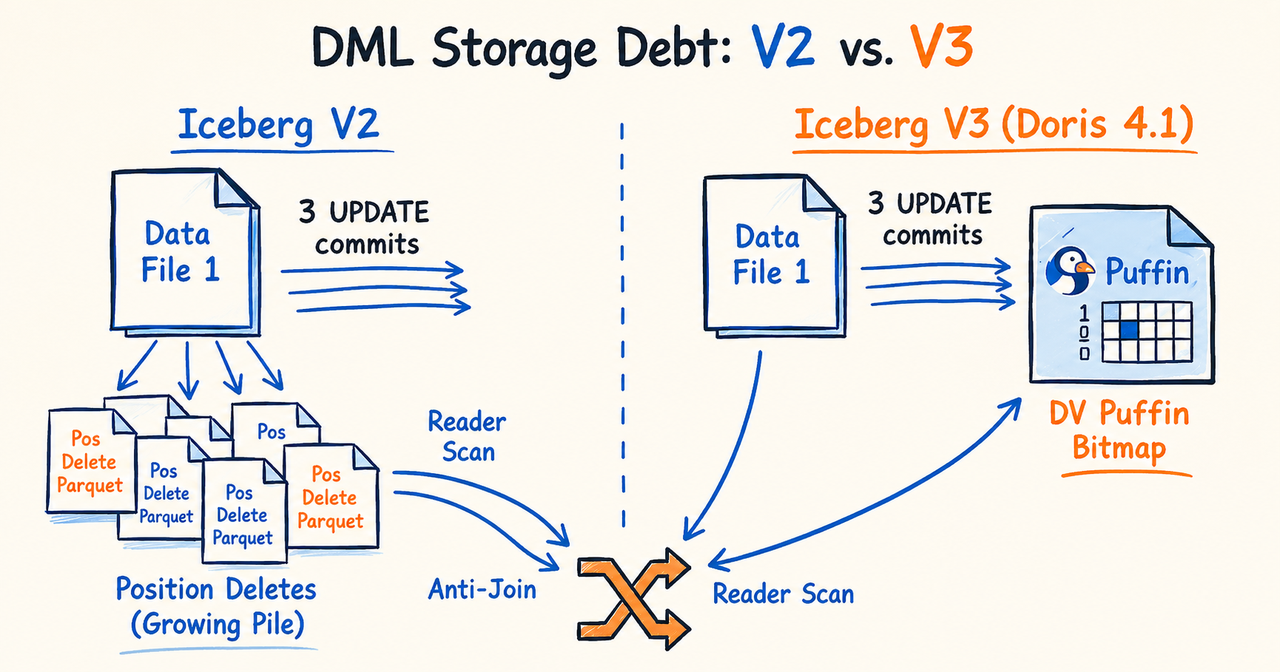
以连续执行两次更新和一次删除为例,V2 中的文件布局可能如下:
+---------+------------------------------------+--------------+
| content | file_path                          | record_count |
+---------+------------------------------------+--------------+
|    0    | .../data/00000-...parquet          |       3      |   <- data
|    1    | .../data/00001-...delete.parquet   |       1      |   <- pos delete
|    1    | .../data/00002-...delete.parquet   |       1      |   <- pos delete
|    1    | .../data/00003-...delete.parquet   |       1      |   <- pos delete
+---------+------------------------------------+--------------+
(在 content 列中,0 表示数据文件,1 表示位置删除文件)
在 V3 中,相同操作可以表现为一个数据文件和一个 Puffin 文件:
+---------+------------------------------------+--------------+
| content | file_path                          | record_count |
+---------+------------------------------------+--------------+
|    0    | .../data/00000-...parquet          |       3      |   <- data
|    1    | .../data/00000-dv.puffin           |       3      |   <- Deletion Vector
+---------+------------------------------------+--------------+
删除信息的文件数量,因此从「随修改次数线性增长」变成「与数据文件数量同阶」,这会直接反映在文件数、存储空间和查询开销上。在原文给出的测试环境和数据布局下,结果如下:
- 在 16 个数据文件上分多次删除 20% 的数据后,V2 需要处理 16 个数据文件和 320 个删除文件,共 336 个文件;V3 则只需要处理 16 个数据文件和一个 Puffin 文件。
- 在一亿行、99% 数据被删除的场景中,V2 的删除信息占用约 98 MiB,V3 仅使用一个约 3.8 MiB 的 Puffin 文件,存储空间下降约 96%。
在包含 16 个数据文件、共 100 万行的数据集上,不同删除比例下的查询结果如下:
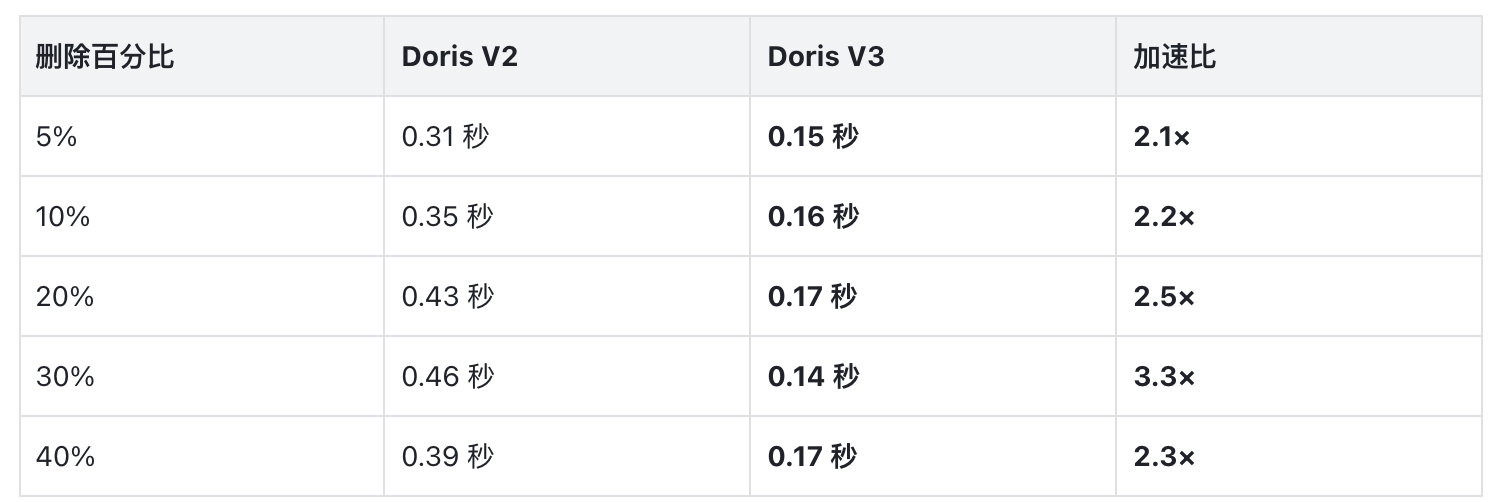
在大文件且 99% 数据被删除的测试中,V3 的查询时间约为 V2 的三分之一。
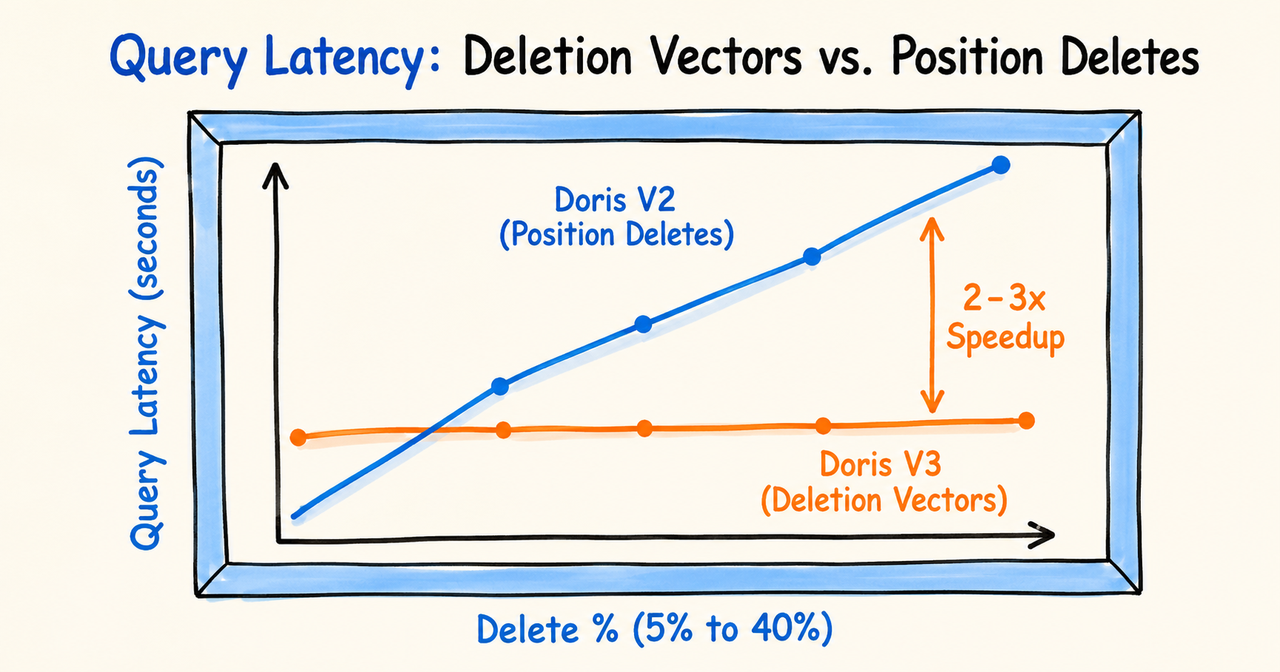
这些结果说明,在测试覆盖的工作负载中,Deletion Vector 能够显著减少删除文件数量与删除信息存储空间,并降低高删除比例下的读取成本。实际收益仍取决于数据规模、文件布局和查询方式。
Apache Doris 4.1 同时支持 Deletion Vector 的读取和写入,而这一点对用户是无感的:面对 format-version = 3 的 Iceberg 表,仍然使用普通的 DELETE、UPDATE 和 MERGE INTO 语法,Doris 会按照 V3 语义生成 Puffin 格式的删除信息,而不是继续堆积 Position Delete 文件。也就是说,前面那几条 DML 语句的代价,不会随着执行次数的增加而持续放大——这正是「在 Doris 里改 Iceberg」能够作为日常操作、而不只是一次性尝试的前提。
Row Lineage:识别真正发生变化的行
Deletion Vector 解决了频繁 DML 的物理开销,但增量同步还需要回答另一个问题:哪些行发生了真实变化?
Iceberg V3 为此增加了两个系统列:
_row_id:系统为每一行分配的稳定数值标识。_last_updated_sequence_number:该行最近一次修改对应的序列号。
这两个字段由系统自动维护,用户不能主动写入。初次插入数据时,每一行都会获得自己的 _row_id。当某条记录发生更新后,其 _row_id 保持不变,而 _last_updated_sequence_number 会更新为新的序列号。
Doris 4.1 支持读取这两个系统列,用户可以直接在 SQL 中观察行级变化。例如,创建一张 V3 表并插入三条数据:
CREATE TABLE users_v3 (
    id INT, name STRING, email STRING
) PROPERTIES ('format-version' = '3');

SET show_hidden_columns = true;

-- Step 1: initial insert of 3 rows
INSERT INTO users_v3 VALUES
    (1, 'Alice', 'alice@x.com'),
    (2, 'Bob',   'bob@x.com'),
    (3, 'Carol', 'carol@x.com');

SELECT id, name, email, _row_id, _last_updated_sequence_number FROM users_v3;
查询隐藏列后,可以看到每行的 Row ID 和序列号:
+----+-------+-------------+---------+-------------------------------+
| id | name  | email       | _row_id | _last_updated_sequence_number |
+----+-------+-------------+---------+-------------------------------+
|  1 | Alice | alice@x.com |    0    |              1                |
|  2 | Bob   | bob@x.com   |    1    |              1                |
|  3 | Carol | carol@x.com |    2    |              1                |
+----+-------+-------------+---------+-------------------------------+
更新 Bob 的邮箱后:
-- Step 2: update Bob's email
UPDATE users_v3 SET email = 'bob@newmail.com' WHERE id = 2;

SELECT id, name, email, _row_id, _last_updated_sequence_number FROM users_v3;
Bob 的 _row_id 仍然为 1,而 _last_updated_sequence_number 更新为 2;未被修改的 Alice 和 Carol 保持不变。
+----+-------+------------------+---------+-------------------------------+
| id | name  | email            | _row_id | _last_updated_sequence_number |
+----+-------+------------------+---------+-------------------------------+
|  1 | Alice | alice@x.com      |    0    |              1                |
|  2 | Bob   | bob@newmail.com  |    1    |              2                |  <-- SN++
|  3 | Carol | carol@x.com      |    2    |              1                |
+----+-------+------------------+---------+-------------------------------+
假设下游系统已经处理完序列号 1 对应的数据,并将 1 保存为 Watermark。下一次获取增量数据时,可以查询 _last_updated_sequence_number 大于当前 Watermark 的记录:
SELECT
    id,
    name,
    email,
    _last_updated_sequence_number
FROM users_v3
WHERE _last_updated_sequence_number > :watermark;
+----+------+-----------------+-------------------------------+
| id | name | email           | _last_updated_sequence_number |
+----+------+-----------------+-------------------------------+
|  2 | Bob  | bob@newmail.com |              2                |
+----+------+-----------------+-------------------------------+
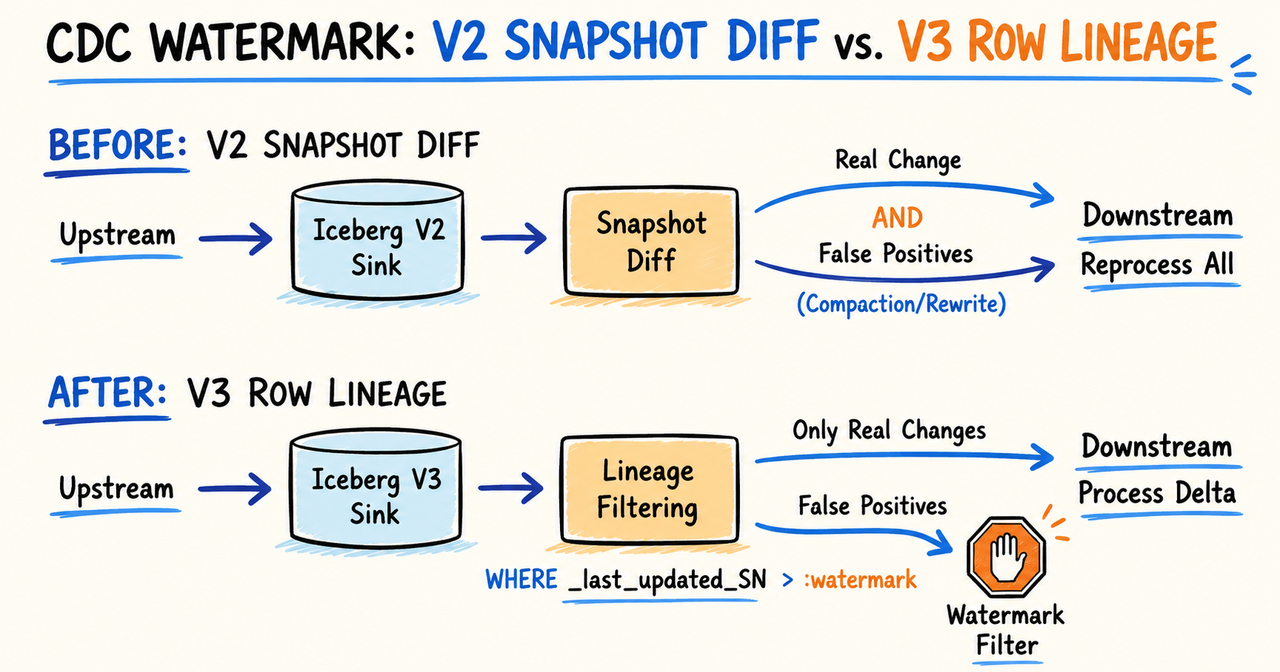
查询返回的是 Watermark 之后发生过修改的当前行状态。在该示例中,只有 Bob 会被返回,未发生变化的 Alice 和 Carol 不会出现在结果中。
即使在两次增量查询之间执行了 Compaction 或 rewrite_data_files,单纯的物理文件重写也不会更新 _last_updated_sequence_number,因此不会被识别为一次新的业务数据修改。
本次处理完成后,下游可以将返回结果中的最大序列号保存为新的 Watermark,供下一次查询使用。需要注意的是,这种方式用于识别哪些行在 Watermark 之后发生过变化,并不等同于返回完整的逐次变更事件。
以下是基于 Row Lineage 的增量行识别流程前后对比:
稳定的 _row_id 还可以与 Iceberg Time Travel 配合,用于在不同快照中定位同一条记录。例如,一条订单记录在多次更新后仍然保留相同的 _row_id,用户可以针对不同快照查询该 Row ID,以回看各阶段的记录状态。
但 Row Lineage 并不等同于完整的审计系统。它提供的是稳定的行标识和最近变更序列,修改人、修改原因、审批记录等业务审计信息,仍然需要由外部系统保存。
快速入门:五分钟体验 Doris + Iceberg V3
以下是一条从创建 Catalog 到验证 Deletion Vector 和 Row Lineage 的最简路径。
前置条件:
- Apache Doris 4.1.0 或更高版本(官网下载或从 Docker Hub 拉取
apache/doris:4.1.0)。 - 支持 Iceberg V3 的 Catalog。
- Doris BE 可以访问的对象存储,例如 S3、MinIO、OSS 或 HDFS。
第一步:创建 Iceberg Catalog。在任意已连接到 Doris FE 的 MySQL 协议客户端中执行以下 SQL:
CREATE CATALOG iceberg_v3 PROPERTIES (
    'type'              = 'iceberg',
    'iceberg.catalog.type' = 'rest',
    'uri'               = 'http://your-rest-catalog:8181',
    'warehouse'         = 's3://your-bucket/warehouse',
    's3.endpoint'       = 'https://s3.us-west-2.amazonaws.com',
    's3.access_key'     = '<AK>',
    's3.secret_key'     = '<SK>',
    's3.region'         = 'us-west-2'
);

SWITCH iceberg_v3;
CREATE DATABASE IF NOT EXISTS demo;
USE demo;
第二步:创建 V3 表并执行 DML。
CREATE TABLE orders (
    id INT, status STRING, amount DECIMAL(10,2)
) PROPERTIES ('format-version' = '3');

INSERT INTO orders VALUES (1,'pending',100), (2,'pending',200), (3,'pending',300);

UPDATE orders SET status = 'shipped' WHERE id = 1;
DELETE FROM orders WHERE id = 3;
第三步:验证 Deletion Vector 和 Row Lineage。
-- 检查是否生成 Puffin 格式的 Deletion Vector
SELECT content, file_path, record_count FROM orders$files;

-- 查看 Row Lineage 系统列
SET show_hidden_columns = true;
SELECT id, status, _row_id, _last_updated_sequence_number FROM orders;
如果结果中包含 _row_id 和 _last_updated_sequence_number 两个系统列,则说明当前 Catalog、Doris 和 Iceberg 表已经能够处理对应的 V3 行级信息。
第四步:尝试 MERGE INTO。
MERGE INTO orders t
USING (SELECT 1 AS id, 'delivered' AS status, 110 AS amount) s
ON t.id = s.id
WHEN MATCHED THEN UPDATE SET status = s.status, amount = s.amount
WHEN NOT MATCHED THEN INSERT (id, status, amount) VALUES (s.id, s.status, s.amount);
后续规划
Iceberg 生态仍在快速演进,Doris 对 Iceberg 的支持也会继续沿着「管理与查询收敛到同一套系统」这条主线推进。接下来有两项工作已经在设计开发中:
Iceberg Variant 类型的读写。Variant 是 Iceberg V3 引入的半结构化数据类型,用于在不预先定义完整 Schema 的情况下存储 JSON 类数据。Doris 自身已经具备成熟的 Variant 实现与相应的存储、查询加速能力,后续将把这部分能力对接到 Iceberg 表上,支持 Iceberg Variant 列的读取与写入,让日志、埋点、事件等半结构化数据也能直接在 Iceberg 上完成分析,而不必先做一轮打平和建模。
Iceberg 增量物化视图的支持。借助 V3 的 Row Lineage,两次刷新之间真正发生变化的行是可以被准确识别的。基于这一点,Doris 将支持构建在 Iceberg 表之上的增量物化视图:每次刷新只处理发生变化的数据,而不是全量重算,从而以更低的成本维持结果的新鲜度。这也让 Row Lineage 从一个「可以查询的系统列」,变成支撑上层增量计算的基础设施。
结束语
Apache Doris 4.1 将 Iceberg 支持从查询扩展到写入、修改和维护,使用户能够在同一个 SQL 上下文中完成问题定位、数据修正、结果验证和日常维护。对用户来说,最直接的变化是:为了完整地操作一张 Iceberg 表,不再需要同时维护两套系统。
Iceberg V3 是这条路径得以落地的基础。Deletion Vector 让高频 DML 不再持续累积删除文件与读取开销,Row Lineage 则提供了稳定的行标识和变更序列,让下游能够识别真正发生变化的数据。
Spark 和 Flink 依然承担各自擅长的大规模批处理与流式计算任务,这一点不会改变。改变的是 Doris 的能力边界:既然查询已经把用户带到了目标数据面前,接下来的修改、合并与维护,就不应该再迫使用户切换到另一套工具。Lakehouse 中围绕 Iceberg 的分工,正在从「Iceberg 做表格式 + Spark 管理 + Doris 查询」,走向「Iceberg 做表格式 + Doris 管理和查询」。
同时,欢迎体验 SelectDB,SelectDB 是基于 Apache Doris 打造的企业级实时数据仓库,提供更易用、更稳定的云服务与企业级能力


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


