【Python爬虫实战项目】Python爬取Top100电影榜单数据并保存csv文件

python基于爬虫技术的海量电影数据分析源码,数据处理分析可视化,GUI界面展示 阅读详情

前言

今天给大家介绍的是Python爬取Top100电影榜单数据保存csv文件,在这里给需要的小伙伴们帮助,并且给出一点小心得。
电影top!

开发工具

Python版本: 3.6

相关模块:

requests模块

time模块

parsel模块

csv模块

环境搭建

安装Python并添加到环境变量,pip安装需要的相关模块即可。

文中完整代码及文件,评论留言获取

思路分析

浏览器中打开我们要爬取的页面 按F12进入开发者工具,查看我们想要的Top100电影榜单数据在哪里 这里我们需要页面数据就可以了
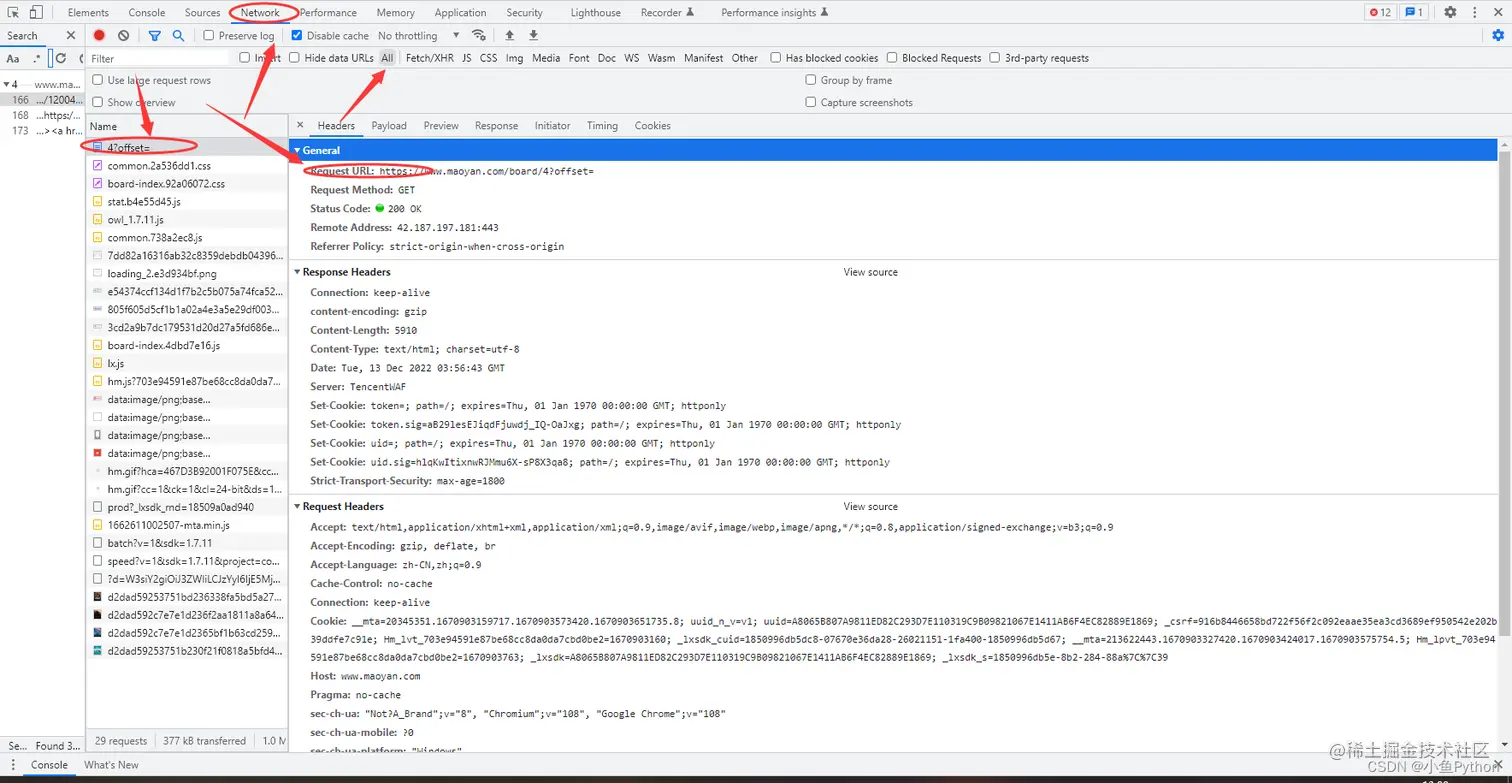
页面数据

代码实现

for page in range(0, 101, 10):
    time.sleep(2)
    url = 'https://maoyan.com/board/4?offset={}'.format(page)
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 

【爬虫实战项目】Python爬取Top100电影榜单数据并保存csv文件(附源码) Python爬取Top100电影榜单数据保存csv文件 阅读详情

相关推荐

【爬虫实战项目】Python爬取Top100电影榜单数据并保存csv文件(附源码)_python爬虫保存csv文件案例1000数据

不知道你们用的什么环境,我一般都是用的Python3.6环境和pycharm解释器,没有软件,或者没有资料,没人解答问题,都可以免费领取(包括今天的代码),过几天我还会做个视频教程出来,有需要也可以领取~给大家准备的学习资料包括但不限于:Python 环境、pycharm编辑器/永久激活/翻译插件python 零基础视频教程Python 界面开发实战教程Python 爬虫实战教程Python 数据分析实战教程python 游戏开发实战教程Python 电子书100本。

2401_84538510的博客 991

Python爬虫教程——7个爬虫小案例(附源码)_爬虫实例

爬虫的全称为网络爬虫,简称爬虫,别名有网络机器人,网络蜘蛛等等。网络爬虫是一种自动获取网页内容的程序,为搜索引擎提供了重要的数据支撑。搜索引擎通过网络爬虫技术,将互联网中丰富的网页信息保存到本地,形成镜像备份。我们熟悉的谷歌、百度本质上也可理解为一种爬虫。如果形象地理解,爬虫就如同一只机器蜘蛛,它的基本操作就是模拟人的行为去各个网站抓取数据或返回数据。

m0_74824091的博客 1万+

Python爬虫实战 | (1) 爬取猫眼电影官网的TOP100电影榜单

在本篇博客中,我们将使用requests+正则表达式来爬取猫眼电影官网的TOP100电影榜单,获取每部电影的片名,主演,上映日期,评分和封面等内容。 打开猫眼Top100,分析URL的变化:发现Top100榜总共包含10页,每页10部电影,并且每一页的URL都是有规律的,如第2页为https://maoyan.com/board/4?offset=10,第三页为https://maoyan.co...

sdu_hao的博客 3242

【爬虫实战】python入门爬取猫眼电影排行

应用场景:1、抓取特定网站或应用的内容,提取出有价值的信息。2、模拟用户在浏览器或应用中的操作,实现自动化流程。爬虫是什么专业术语:网络爬虫(又称网页蜘蛛、网络机器人)网络爬虫是一种自动按照特定规则抓取网页信息的程序或脚本。爬虫起源随着网络的迅猛发展,万维网成为海量信息的载体,如何有效地提取和利用这些信息成为一项巨大挑战。搜索引擎如Yahoo、Google、百度等,作为帮助人们检索信息的工具,成为用户访问万维网的入口和指南。

GR001009的博客 1749

python爬虫100个入门项目

断点续爬并存入MySQL 秒爬,python爬虫中的多线程,多进程,协程 抓取百度图片唯美意境模块 抓取百度贴吧某话题下的所有图片 淘宝模拟登录 天猫商品数据爬虫 爬取淘宝我已购买的宝贝数据 每天不同时间段通过微信发消息提醒女友 爬取5K分辨率超清唯美壁纸 爬取豆瓣排行榜电影数据(含GUI界面版) 多线程+代理池爬取天天基金网、股票数据(无需使用爬虫框架) 一键生成微信个人专属数据报告(了解你的微信社交历史) 一键生成QQ个人历史报告 微信公众号文章爬虫 新浪微博爬虫分享(一天可

daijunxia123的博客 3945

用Python爬取电影数据并可视化分析

本次实验通过使用爬虫获取2016年-2023年的电影数据,并可视化分析的得出以下结论:1.2016年-2019年电影数量逐渐增大,2019年达到最大值,从2020年开始迅速逐年下降。2.发布电影数量最多的国家是中国和美国。3.电影类型最多的剧情片。4.电影片长呈正态分布,且片长和评分呈正相关关系。

m0_64336780的博客 3万+

爬取猫眼电影Top 100榜单:从入门到实战

在这个数据驱动的时代,对电影行业而言,理解观众的偏好和市场动态变得尤为重要。通过这篇文章,我们不仅探索了如何使用Python的DrissionPage库进行网页抓取,还实际操作了从猫眼电影Top 100榜单获取电影信息的过程。这不仅是对网页抓取技术实战应用的一次演练,更是深入分析电影市场的一个关键步骤。通过这些数据,我们能够洞察到哪些电影受到广泛欢迎,它们的评分如何,主演是谁,以及它们的上映时间等关键信息。这些信息对于电影制片方来说,是调整制作策略、优化营销方案的宝贵资源。。

LucianaiB的博客 4万+

(学习用)电影数据库“movies.csv”

学习参考使用!

电影评分数据集-用于电影推荐系统

电影评分数据集-用于电影推荐系统。有两个数据集。 数据集1:包括movies.csv和ratings.csv两个文件。movies.csv文件总共有27,279行,除第1行是表头外,每行用3列表示一部电影,分别为电影id(movieId)、电影名称(title)和电影类型(genres)。ratings.csv文件总共有20,000,264行,除第1行是表头外,每行用4列表示一位用户对一部电影的评分,分别为用户id(userId)、电影id(movieId)、评分(rating)和评分时间(timestamp)。这里的评分时间是用unix时间戳表示的。在这个数据集中并没有提供用户的个人信息,可能是出于保护用户隐私的考虑。 数据集2:ratings.dat是另一个电影评分数据集。包含了6000多位用户对近3900个电影的共100万(1,000,209)条评分数据,评分均为1~5的整数,其中每个电影的评分数据至少有20条。

IMDB电影数据集 CSV 2K 记录

热门IMDB电影数据集 |类型 |演职员表 |更新至2023年12月15日。这个 csv 文件包含 11 列,即:影视名称、评级、投票、元分数、流派、PG 评级、年份、持续时间、演员、导演。

深入解析XTEA加密算法的核心机制与优化策略

本文深入解析XTEA加密算法的核心机制与优化策略,详细介绍了XTEA在嵌入式系统和资源受限环境中的优势,包括其高效的加解密速度和低资源消耗。文章还探讨了XTEA的轮函数设计、关键参数优化策略以及实战应用中的性能对比,为开发者提供了安全增强方案和优化技巧。

k8l9m0n的博客 243

S32K144 SDK实战:FTM输入捕获模块的配置与应用

本文详细介绍了S32K144 SDK中FTM输入捕获模块的配置与应用实践。从基础认知到开发环境搭建,再到引脚配置和中断处理技巧,全面解析了如何利用FTM模块实现高精度信号测量。特别适用于电机控制、工业测速等场景,帮助开发者快速掌握S32K144的FTM输入捕获功能。

weixin_42566424的博客 217

别再瞎改注册表了!实测Win10/Win11远程桌面60帧的正确姿势(附ToDesk对比)

本文深入解析Windows远程桌面60帧优化的科学方法,揭示常见误区并提供实测有效的解决方案。从版本差异到硬件加速,再到第三方工具对比(如ToDesk),帮助用户避开无效的注册表修改,实现流畅的远程桌面体验。

weixin_33738555的博客 346

PCL1.12.1+VTK9.1+Qt5.14.2实战:解决QVTKOpenGLNativeWidget点云渲染窗口初始化报错问题

本文针对PCL1.12.1、VTK9.1与Qt5.14.2集成开发中,QVTKOpenGLNativeWidget点云渲染窗口初始化时出现的报错与黑屏问题,提供了深度分析与两种实战解决方案。核心在于理解VTK版本升级导致的渲染窗口类型不匹配,并指导开发者通过显式创建vtkGenericOpenGLRenderWindow或利用窗口ID嵌入,正确初始化并绑定可视化组件,从而稳定实现点云渲染。

weixin_29284657的博客 223

ISP工程师实战笔记:5种Demosaic算法优缺点对比(含Hamilton/DFPD代码片段)

本文从ISP工程师实战角度,深入对比了五种经典Demosaic算法的优缺点。文章详细剖析了双线性插值、Hamilton、DFPD、DLMMSE和GBTF等算法的核心思想、实现差异与性能表现,并提供了Hamilton和DFPD算法的关键代码片段。重点探讨了在图像信号处理流水线中,如何根据画质、计算复杂度和功耗等工程约束进行算法选型与权衡。

weixin_42527589的博客 248

cartographer实现纯定位

实现纯定位 (1)因为正常的cartographer的建图的map是由cartographer发布的;如下 rostopic info /map Type: nav_msgs/OccupancyGrid Publishers: * /cartographer_occupancy_grid_node 因此需要把map的发布替换成 <node name="map_server" pkg="map_server" type="map_server" args="/home/lx.

Studying…… 5888

服务器取证——服务器基础知识

服务器基础知识

记录并分享学习安全的知识点.. 2483

Python爬取谷歌学术全攻略:基于Playwright与Asyncio的高效、抗反爬虫实践

同时,文章将详细解析爬虫过程中可能遇到的各种挑战,如IP封锁、验证码、动态内容加载等,并提供切实可行的解决方案。self.logger.info(f"第 {current_page} 页解析完成,共找到 {len(page_results)} 条结果。:谷歌学术的HTML结构并非一成不变,其CSS类名和标签结构可能会发生变化,且不同地区、不同语言的界面可能存在差异,增加了数据解析的难度。self.logger.info(f"开始搜索关键词: '{keyword}',计划爬取 {max_pages} 页")

2201_76125261的博客 1552

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

上一篇: Python入门简介
下一篇: 重学Python:零基础学习 Python 之初识生成器
Python_P叔
博客等级 码龄3年 5455粉丝 827原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值