Python爬虫| 爬虫框架Scrapy的构架、工作原理及工作流程是怎样的?

【Python Scrapy】详细介绍Scrapy的基本结构、组件和工作原理 Scrapy是一个功能强大的Python爬虫框架,提供了完备的爬取任务的工具集,同时也允许在需要的时候实现自定义组件,极大地提高了开发和维护的效率。掌握Scrapy并使用其组件进行爬虫开发,对于爬虫开发人员,是一门必不可少的技能。无论是对于爬虫性能的优化,还是对于数据的处理与管理,在Scrapy的丰富组件库中,都有非常成熟和专业的解决方案可以采用。 阅读详情

在这里插入图片描述

**1、**Scrapy框架的介绍

Scrapy是一个基于Python的开源网络爬虫框架,是一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。它可以帮助开发者快速、高效地从网站上获取数据。

Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。

Scrapy吸引人的地方在于它是一个框架,任何人都可以根据需求方便的修改。它也提供了多种类型爬虫的基类,如BaseSpider、sitemap爬虫等。

尽管Scrapy原本是设计用来屏幕抓取(更精确的说,是网络抓取),但它也可以用来访问API来提取数据。

2、Scrapy框架的基本原理

Scrapy框架的基本原理是通过发送HTTP请求获取网页内容,然后使用Xpath或CSS选择器等工具解析网页内容,最后新数据存储到数据库或文件中。

3、爬虫框架scrapy架构

scrapy框架的核心组件由五大组件引擎、调度器、下载器、爬虫、管道和中间件组成。

五大组件是调度器(Scheduler),下载器(Downloader),爬虫(Spider),实体管道(Item Pipeline),Scrapy引擎(Scrapy Fngine)。

3.1 Scrapy架构图
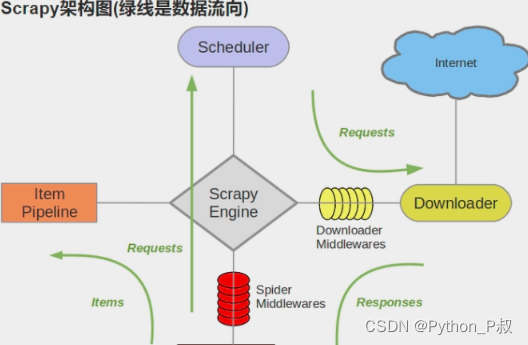
在这里插入图片描述

3.2 Scrapy五大组件及中间件

**(1)Scrapy Engine(引擎):**是整个框架的核心,它负责控制整个爬虫的流程,包括Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。

**(2)Scheduler(调度器):**负责管理待爬取的URL队列,它负责接受引擎发送过来的Request请求,并按照一定的方式进行整理排列,入队,当引擎需要时,交还给引擎。

**(3)Downloader(下载器):**下载器负责发送HTTP请求并获取网页内容,负责下载Scrapy Engine(引擎)发送的所有Requests请求,并将其获取到的Responses交还给Scrapy Engine(引擎),由引擎交给Spider来处理。

**(4)Spider(爬虫):**负责解析网页内容并提取数据,它负责处理所有Responses,从中分析提取数据,获取Item字段需要的数据,并将需要跟进的URL提交给引擎,再次进入Scheduler(调度器)。

**(5)Item Pipeline(管道):**负责将爬取到的数据存储到数据库或文件中,处理Spider中获取到的Item,并进行进行后期处理(详细分析、过滤、存储等)的地方。

**(6)Downloader Middlewares(下载中间件):**一个可以自定义扩展下载功能的组件。

**(7)Spider Middlewares(Spider中间件):**一个可以自定扩展和操作引擎和Spider中间通信的功能组件。

3.3 Scrapy工作流程

(1)spider中的url被封装成请求对象交给引擎(每一个对应一个请求对象)。

(2)引擎拿到请求对象之后,将全部交给调度器。

(3)调度器拿到所有请求对象后,通过内部的过滤器过滤掉重复的url,最后将去重后的所有url对应的请求对象压入到队列中,随后调度器调度出其中一个请求对象,并将其交给引擎。

(4)引擎将调度器调度出的请求对象交给下载器。

(5)下载器拿到该请求对象去互联网中下载数据。

(6)数据下载成功后会被封装到response中,随后response会被交给下载器。

(7)下载器将response交给引擎。

(8)引擎将response交给spiders。

(9)spiders拿到response后调用回调方法进行数据解析,解析成功后生成item,随后spiders将item交给引擎。

(10)引擎将item交给管道,管道拿到item后进行数据的持久化存储。

3.4 Scrapy框架的优点

Scrapy框架的优点在于它具有高度的可扩展性和灵活性。开发者可以根据自己的需求自定义爬虫、管道和中间件等组件,以满足不同的爬虫需求。此外,Scrapy框架还支持异步IO和分布式爬虫等功能,可能提高爬虫的效率和稳定性。

---------------------------END---------------------------

感兴趣的小伙伴,赠送全套Python学习资料,包含面试题、简历资料等具体看下方。

👉优快云大礼包🎁:全网最全《Python学习资料》免费赠送🆓!(安全链接,放心点击)

一、Python所有方向的学习路线

Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。img
img

二、Python必备开发工具

工具都帮大家整理好了,安装就可直接上手!img

三、最新Python学习笔记

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。

img

四、Python视频合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

img
五、实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。img

六、面试宝典

在这里插入图片描述
在这里插入图片描述

简历模板在这里插入图片描述​
2024 高级爬虫笔记(六)scrapy框架基础知识 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,我们只需要实现少量的代码,就能够快速的抓取。Scrapy 使用了Twisted异步网络框架,可以加快我们的下载速度。 阅读详情

相关推荐

Scrapy框架——初认识

Scrapy是一个高效的Python爬虫框架,旨在简化网站数据的抓取和结构化提取。它基于Twisted异步网络框架,能够显著提升爬虫的下载速度。Scrapy的核心组件包括引擎、调度器、下载器、爬虫和管道,这些组件通过引擎进行数据传递和协调。Scrapy的工作流程包括请求的调度、下载、数据处理和存储,开发者只需实现少量代码即可快速抓取数据。Scrapy的安装可以通过pip命令完成,创建项目后,开发者可以通过命令行生成爬虫并完善其逻辑,使用XPath等方法提取数据,并通过管道进行数据存储。Scrapy的异步和非

m0_74653634的博客 1737

超详细的Scrapy框架的基本使用教程

scrapy框架;Python爬虫

什么时候才不是菜鸟.... 1万+

【愚公系列】《Python网络爬虫从入门到精通》049-了解Scrapy爬虫框架

大家好,欢迎来到《Python网络爬虫从入门到精通》系列教程的第48篇文章。经过前面几十篇的学习,我们已经掌握了使用 requests、BeautifulSoup、Selenium 等工具进行数据抓取的基本方法。然而,随着项目的复杂度提升,这些工具在面对大型、高并发、高可维护性的爬虫任务时,往往力不从心。这时候,专业的爬虫框架——Scrapy,就该登场了。Scrapy 是一个由 Python 编写的、功能强大的异步爬虫框架,它具备高性能、模块化、易扩展等诸多优点,被广泛应用于各种数据采集任务中。

愚公智库 10万+

Scrapy----Scrapy架构及工作流程

本文主要介绍了scrapy的架构和工作流程

redrose2100的博客 1296

Python 网络爬虫入门与实战

网络爬虫(Web Crawler)是自动访问网络并提取信息的程序。它可以模拟人类用户在浏览器中的行为,访问网页、抓取数据并存储到本地或数据库中。网络爬虫在信息检索、数据挖掘、搜索引擎等领域有广泛应用。Scrapy 是一个强大的爬虫框架,支持异步处理和数据存储。它适合大型爬虫项目,可以高效抓取和解析数据。yield item通过本文的学习,您应该对 Python 网络爬虫有了全面的了解。从基础的 Requests 库到高级的 Scrapy 框架,再到实战案例,涵盖了网络爬虫的方方面面。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 2216

网络爬虫:Scrapy爬虫框架

介绍了Scrapy爬虫框架的原理和基本使用方式

Jingmin Wei's Blog 2996

爬虫框架 Scrapy 详解

Scrapy是适用于Python的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。Scrapy是一个框架,可以根据需求进行定制。它也提供了多种类型爬虫的基类,如BaseSpider、sitemap爬虫等,最新版本又提供了web2.0爬虫的支持。...

m0_67403076的博客 1万+

精通 Python 网络爬虫:核心技术、框架与项目实战

内容简介 本书从技术、工具与实战3个维度讲解了 Python 网络爬虫: 技术维度:详细讲解了 Python 网络爬虫实现的核心技术,包括网络爬虫的工作原理、如何用 urllib 库编写网络爬虫、爬虫的异常处理、正则表达式、爬虫中 Cookie 的使用、爬虫的浏览器伪装技术、定向爬取技术、反爬虫技术,以及如何自己动手编写网络爬虫; 工具维度:以流行的 Python 网络爬虫框架 Scrapy 为...

GitChat 7522

Scrapy框架(高效的网络爬虫)

介绍scrapy框架的使用,并给出案例

FFNCL的博客 3203

基于Scrapy框架下的Python网络爬虫的实现

基于Scrapy项目的目录结构以及相关功能的介绍 Scrapy的基本命令 图片类爬虫项目的实现

jinglong_mydog的博客 8206

利用python爬取东方财富网股吧评论并进行情感分析(一)

利用python爬取东方财富网股吧评论(一) python-东方财富网贴吧文本数据爬取 分享一下写论文时爬数据用到的代码,有什么问题或者改善的建议的话小伙伴们一起评论区讨论。 新的改变 我们对Markdown编辑器进行了一些功能拓展与语法支持,除了标准的Markdown编辑器功能,我们增加了如下几点新功能,帮助你用它写博客: 全新的界面设计 ,将会带来全新的写作体验; 在创作中心设置你喜爱的代码高亮样式,Markdown 将代码片显示选择的高亮样式 进行展示; 增加了 图片拖拽 功能,你可以将本地的图片直

YMG521000的博客 1万+

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

来自想要赚大钱的小周同学 9504

银河麒麟系统下VSCode安装全攻略:从下载到桌面快捷方式(附常见问题解决)

本文详细介绍了在银河麒麟系统下安装和优化VSCode的全流程,包括环境准备、安装策略、权限管理、桌面快捷方式创建以及系统级性能调优。特别针对国产系统环境提供了常见问题解决方案和必备插件推荐,帮助开发者高效配置开发环境。

v6b7n8m9q0的博客 1137

Python开发从入门到精通:网络爬虫高级应用与Scrapy框架

本文介绍了Python网络爬虫的高级应用与Scrapy框架的核心内容。首先概述了网络爬虫的基本概念和工作流程,然后重点讲解了Scrapy框架的安装、项目创建和爬虫编写方法。针对动态网页爬取,介绍了Selenium的使用及其与Scrapy的结合。在反爬虫策略方面,详细说明了代理IP、User-Agent旋转和Cookies池等技术的实现。最后,通过Scrapy-Redis实现了分布式爬虫,并以豆瓣电影Top250为案例进行了实战演示。文章涵盖了网络爬虫开发的核心技术要点,包括框架使用、反反爬措施和分布式处理等

编程世界如山海,探索不止。 2万+

电磁仿真新手必看:如何用CST Studio Suite 2023完成第一个PCB辐射仿真?

本文详细解析了如何使用CST Studio Suite 2023进行PCB辐射仿真,适合电磁仿真新手快速上手。从工程准备、求解器配置到端口设置和后处理技巧,全面覆盖三维全波电磁场仿真软件的核心操作步骤,帮助工程师精准预测和解决PCB电磁辐射问题。

y7z8a9的博客 734

解决win11无法安装.net framework 3.5(包括.net2.0和3.0)错误代码:0x80070005

解决win11无法安装.net framework 3.5(包括.net2.0和3.0)错误代码:0x80070005

zeng699304的博客 2万+

网络爬虫框架Scrapy

Scrapy是一个用Python编写的网络爬虫框架,它提供了许多工具和功能,使得开发者可以轻松地构建强大的网络爬虫。

2302_80048824的博客 2466

GEO生信数据挖掘实战:从临床信息提取到多维分组可视化(聚类与PCA)

本文以GSE1297数据集为例,详细讲解了GEO生信数据挖掘中临床信息提取与分组构建的实战流程。通过R语言解析样本元数据,利用字符串处理技术从文本中精准构建疾病与对照分组,并强调使用层次聚类图和PCA图进行可视化验证,确保分组合理性与分析可靠性,为后续差异表达等高级分析奠定坚实基础。

cheese的博客 361

基于Scrapy框架实现网络爬虫-Python

网络爬虫原理 互联网上大量的信息以网页形式提供给用户,用户通过浏览器从服务器获得网页数据并经过浏览器解析后,进行网页阅读、内容复制、链接单击等操作。用户与网页服务器的通信是通过HTTP或者HTTPS实现的,网络浏览器是用户向服务器发送请求数据、接收服务器回应数据、解析并呈现服务器回应数据的客户端软件。 用户不通过浏览器而是通过程序自动获取网页内容,有两种办法:一是当服务器提供API方法时,可以调用API获取网页数据;二是当服务器没有提供API方法时,需要使用爬虫程序从服务器获取网页数据并从中过滤提取所需数据

weixin_43845524的博客 6341

【用unity实现100个游戏之34】使用环状(车轮)碰撞器(Wheel Collider)从零实现一个汽车车辆物理控制系统,实现一个赛车游戏

本文介绍了在Unity中使用Wheel Collider组件实现3D车辆物理控制系统的详细步骤。主要内容包括: Wheel Collider参数详解:包括基础参数(质量、半径等)、悬挂弹簧系统(弹力、减震等)和摩擦力设置(前向/侧向摩擦曲线)。 准备工作流程: 导入赛车模型、赛道和树木素材 为车身添加Rigidbody和MeshCollider 创建四个Wheel Collider并调整参数(半径、悬挂距离等) 优化摩擦系数设置防止侧滑 实现车辆控制: 通过代码控制车轮前后移动和转向 提供底盘系统设置(四轮

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 2662

10、基于单倍型多样性隐马尔可夫模型的基因型错误检测

本文提出了一种基于单倍型多样性隐马尔可夫模型(HMM)的基因型错误检测方法,旨在提升三人组基因型数据中错误识别的准确性。通过利用群体水平的连锁信息,该方法克服了传统方法在小系谱数据中表现不佳的局限性。文章详细介绍了模型结构、三种替代似然函数及其计算方法,并通过模拟数据集和真实数据集验证了方法的有效性。实验结果显示,该方法在灵敏度、特异度和准确率方面均表现出色,为基因数据质量控制提供了新的解决方案。

moon9的博客 96

Python网络爬虫:Scrapy框架的全面解析

Scrapy是一个功能强大且灵活的开源网络爬虫框架,它提供了一种高效的方式来爬取网站并提取所需的数据。本文将深入探讨Scrapy框架的核心概念、使用方法以及高级技巧,帮助你更好地理解和应用Scrapy进行网络爬虫的开发。

4.0啊的博客 2848

RT-DETR改进策略【卷积层】| CVPR2025 GBConv轻量门控瓶颈卷积 低秩瓶颈降参 + 门控聚焦形态,强效捕捉纤细目标

裂缝形态不规则、纹理纤细,传统卷积参数大、计算冗余,且无法动态聚焦裂缝形态;背景噪声强易干扰特征提取,需要轻量且能自适应聚焦裂缝形态的卷积单元,因此提出轻量门控瓶颈卷积 GBC。

Limiiiing的博客 142

Scrapy:Python中强大的网络爬虫框架

Scrapy是一个开源的网络爬虫框架,由Python编写而成。它提供了一套强大的工具和API,用于处理网页的下载、解析、数据提取和存储。Scrapy的设计目标是高效、可扩展和易于使用,使开发者能够快速构建复杂的网络爬虫应用程序。Scrapy是一款功能强大的Python网络爬虫框架,为开发者提供了一种高效、灵活和可扩展的方式来构建网络爬虫应用程序。它具有强大的爬取能力、灵活的数据提取、自动化的流程控制、分布式和去重机制,以及扩展性和插件支持等特性。

爱编程的鱼的博客 2789

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

python网络爬虫知识---Scrapy框架

什么是Scrapy?Scrapy是用来干嘛的?怎么使用Scrapy?这篇让我们一起来认识。

x702604121的博客 2456

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Python Scrapy爬虫框架详解

Scrapy 是一个基于 Twisted 实现的异步处理爬虫框架,该框架使用纯 Python 语言编写。Scrapy 框架应用广泛,常用于数据采集、网络监测,以及自动化测试等。提示:Twisted 是一个基于事件驱动的网络引擎框架,同样采用 Python 实现。

ze_mingmingge123的博客 2280

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: P叔带你详解Python模块NumPy
下一篇: Python爬取暑期票房排行
Python_P叔
博客等级 码龄3年 5454粉丝 827原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值