Python爬虫基础--HTTP请求

用Python发送HTTP请求 python http 数据库 mysql 阅读详情

近期在用python编写http请求的代码,先学习一下基础知识--http请求,写篇博客保存记录一下。

网络爬虫的第一步就是爬取网页(获取源代码),爬取网页要向web服务器发送请求构造的http请求,获得所需数据的http响应。

HTTP的基本原理

在浏览器中输入URL,按回车键或点击搜索按钮,这是浏览器向Web服务器发送一个HTTP请求,Web服务器接收到这个请求后进行解析和处理,然后返回给浏览器对应的HTTP响应,之后浏览器对HTTP响应进行解析,显示网页内容。

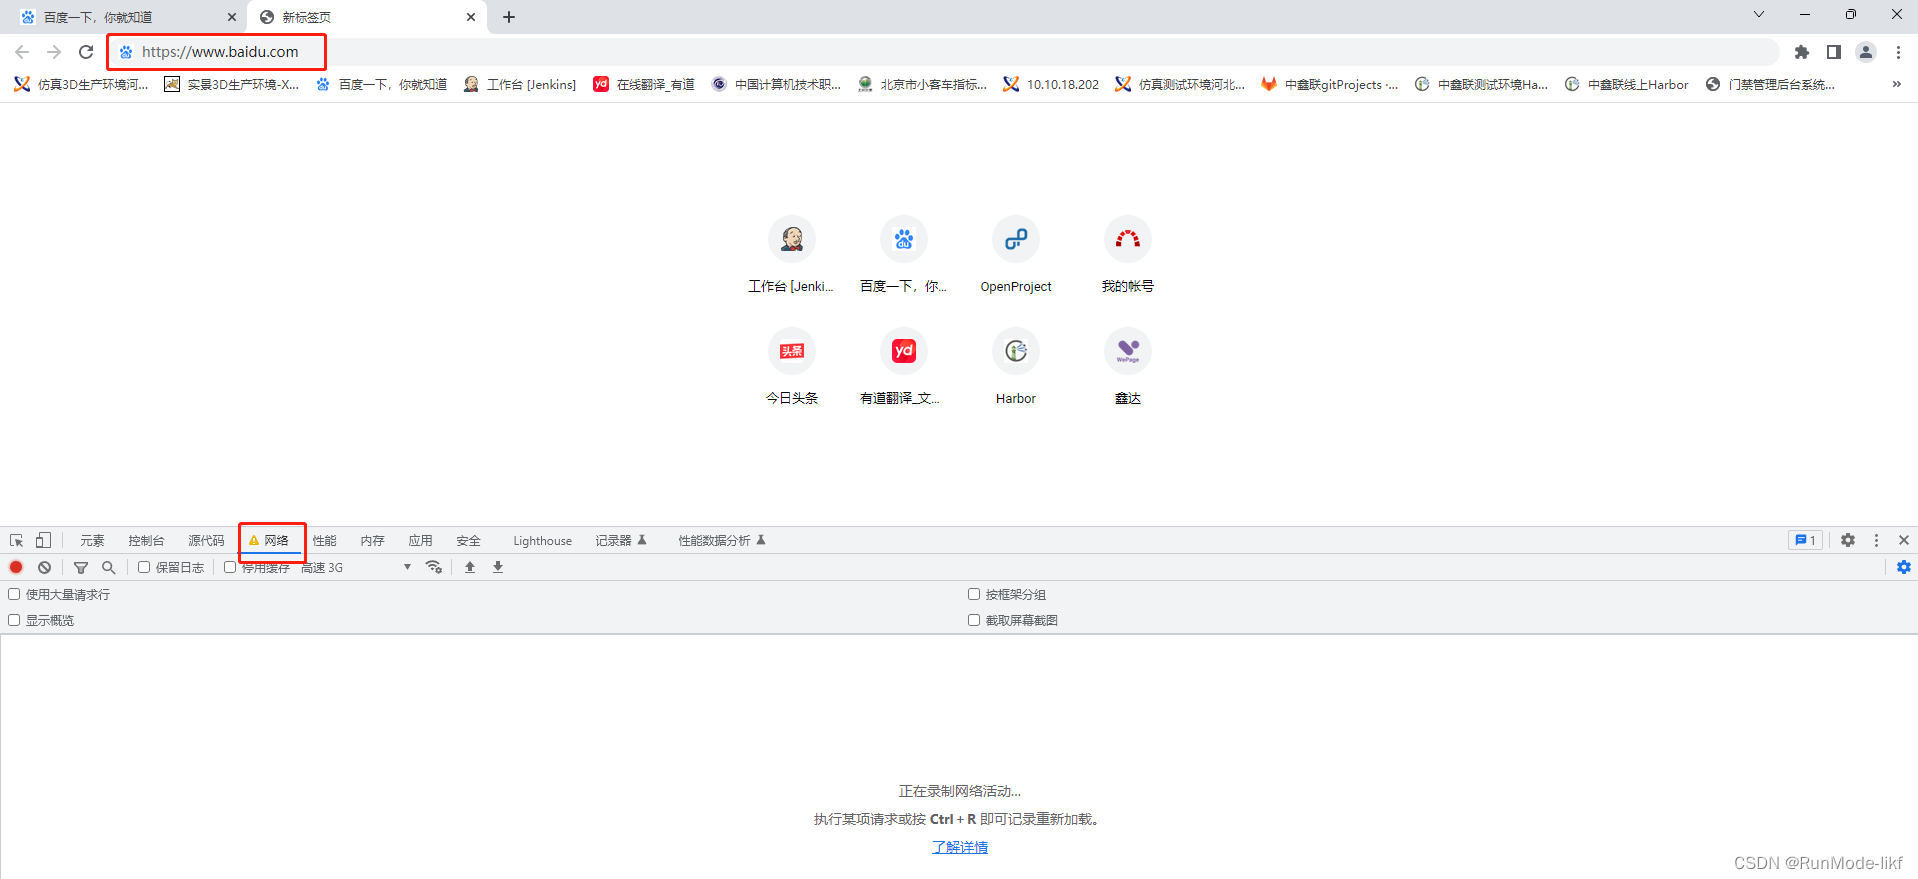
打开Google浏览器,按Ctrl+Shift+I,打开开发者工具,选择“网络”。在搜索框中输入https://www.baidu.com,回车后查看记录表。
进入百度网页,选择点击记录www.baidu.com选项,然后选择右侧的请求头。请求头显示对的是HTTP请求和响应的详细信息。
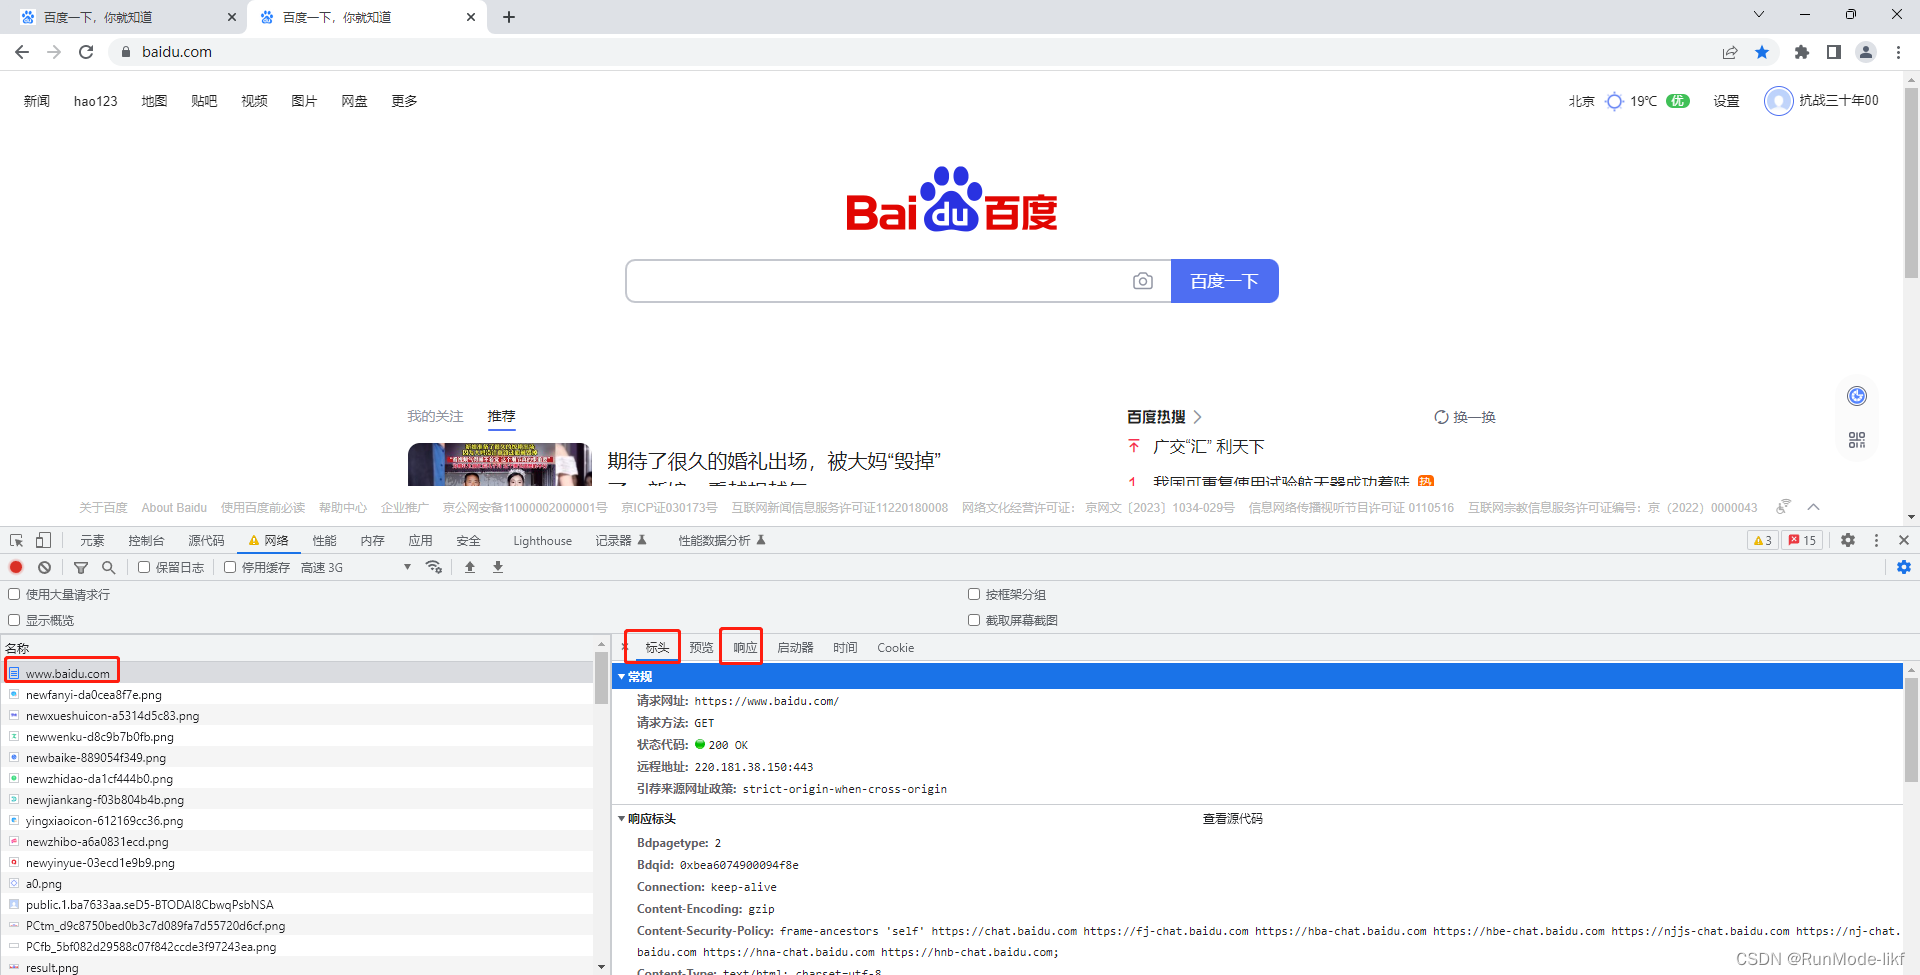
 HTTP请求分为以下四部分内容:

1请求的网站(Request URL)

URL可以唯一确定请求资源。例如:https://www.baidu.com/

2请求方法

 请求方法:HEAD、PUT、DELETE、CONNECT、OPTIONS、TRACE、GET、POST等,其中GET和POST最常用。
GET方法:请求指定的网页信息,并返回网页内容,提交的数据最多只有1024字节。

 POST方法:向指定资源提交数据并进行请求处理(提交表单、上传文件),数据包含在请求体,提交没有字节限制。

3请求头Request Headers

以下是常见请求头和说明
Accept::指定客户端可识别的内容类型;
Accept-Encoding:指定客户端可识别的内容编码;
Accept-Language:指定客户端可识别的语言类型;
Cookie:网站为识别用户身份进行会话跟踪而存储在用户的本地的数据,主要功能是维持当前访问会话;
Host:指定请求的服务器的域名和端口号;
User-Agent:使用服务器识别客户端使用的操作系统及版本、浏览器及版本等信息,实现爬虫时加上此信息,可以伪装为浏览器;
Content-Type:请求的媒体类型信息;
Content-Length:请求的内容长度;
Referer:包含一个URL,用户以该URL代表的页面出发访问当前页面。

Content-Type和Post的关系:
application/x-www-form-urlencoded:表单数据
multipart/form-data:表单文件
application/json:序列化JSON数据
text/xml:XML数据

4请求体

GET的请求体为空,POST的请求体为表单数据

5HTTP响应

响应状态码
分为三部分内容:
第一个:Response Status Code (响应状态码):服务器的响应状态
以下是常见的响应状态码 、对应的英文名称和说明
100 Continue 服务器已收到请求的一部分,正在等待其余部分,应继续提出请求;
200 OK 服务器已成功处理了请求;
302 Move Temporarily 服务器要求客户端重新发送一个请求;
304 Not Modified 此请求返回的网页未修改,继续使用上次的资源;
404 Not Found 服务器请求不到的网页;
500 Internal Server Error 服务器遇到错误,无法完成请求。
响应头

以下是常见的响应头及其说明
Content-Encoding:Web服务器支持的编码类型;
Content-Language:响应体的语言;
Content-Length:响应体的长度;
Content-Type:返回内容的媒体类型;
Date:原始服务器消息发出的时间;
Expires:响应过期的日期和时间;
Last-Modified:请求资源的最后修改时间;
Set-Cookie:设置HTTPCookie;
Location:重定向接收到请求的URL位置。

了解了http基础知识,我们在后面用python请求http时就比较清楚了。每周学习一点知识,记录总结归纳。

python使用HTTP方法 以上示例就是以 JSON 格式的数据发送 POST 请求,其中 `json` 参数指定了数据类型为 JSON,`headers` 中的 `Content-Type` 则指定了数据格式为 JSON。当然,如果需要更加细粒度的控制,还可以使用 `urllib` 和 `httplib` 等标准库来进行 HTTP 请求。还有其它常用的参数,如 `params` 用来传递 URL 参数,`timeout` 指定请求超时时间,等等。如果想要以 JSON 格式的数据发送请求,可以使用 `json` 参数。 阅读详情

相关推荐

【基础】【Python网络爬虫】【2.请求与响应】常用请求报头和常用响应方法

爬虫基础 请求与相应 HTTP/HTTPS 协议 HTTP/HTTPS的优缺点 HTTP 的缺点 HTTPS的优点 请求与响应概述 请求 请求目标(url) 请求体(response) 常用的请求报头 查看请求体(requests 模块) 响应 HTTP响应体 响应行 响应头 常见的响应头字段含义 响应内容 常见的响应方法 响应状态码

weixin_43612602的博客 1709

(一)python发送HTTP 请求的两种方式(get和post )

引入 requests 包 import requests 注:发送请求(包括请求行、方法类型、头、体) & 常见的请求方式有get、post、put、delete 一、发送get请求 格式:requests.get() (内容: url必填; params选填:url参数字典) # ~ 不带参数的get请求 res = requests.get(url='http://ws.webxml.com.cn/WebServices/WeatherWS.asmx/ge...

lemon_lrj的博客 3万+

使用Python发送HTTP请求:http.client和urllib.request

http.client提供了基本的HTTP客户端,而urllib.request则是更高级的API。http.client模块用于低层次的HTTP通信,而urllib.request模块是高层次的API,并且具有更强大的功能。urllib.request模块提供了更高级的API来发送HTTP请求,同时还提供了更多的选项和功能。除了发送简单的GET请求之外,urllib.request还支持更多的HTTP方法和选项。http.client模块提供了一个基本的HTTP客户端,用于发送HTTP请求。

qq_39605374的博客 874

Python Http 请求

Linux

weixin_73725158的博客 1698

别再乱点U盘里的.exe了!手把手教你清除‘Usb Disk.exe’病毒并恢复隐藏文件

本文详细介绍了如何识别和清除U盘病毒(如Usb Disk.exe),并提供从终止病毒进程到恢复隐藏文件的完整步骤。通过禁用自动播放、清理注册表和使用命令行工具,帮助用户彻底清除病毒并预防未来感染,确保数据安全。

weixin_42530732的博客 592

SARscape的DInSAR全流程-以西安市隋大兴唐长安城遗址为例

通过DInSAR对西安市隋大兴唐长安城遗址开展的年度周期性监测,发现成因是地质内部构造断裂带活动所导致的地面产生物理空间上的形变,而地面的沉降与抬升是直接影响城市发展与文化遗产保护最为常见的缓变型不可逆地质灾害。西安市地处汾渭断陷盆地中部,受临潼-长安断裂带影响,导致区域内构造活动较为强烈。由于早年西安市地表水资源匮乏,从上世纪50年代末开始大量开采地下水资源以满足城市人口不断扩张的需求,从而导致地下承压含水层水位急速下降,形成多个局部沉降中心(八里村、西工大、电子城等)。

2301_77687129的博客 5815

Python网络爬虫入门基础 _发送HTTP请求【3】

本次我们简单地介绍如何用Python Requests模块来发送HTTP请求并得到响应内容。这下有人可能会说:就这?这不在浏览器就能搞的源码吗?但我想说的是:这只是爬虫的第一步,小试牛刀而言。我也是学一步,写一步。我相信后面一定会更精彩。后面讲解突破反爬虫机制。内容为本人学习笔记,难免有不足之处,恳请大家批评指正。

追求细节,成就完美 555

西门子S7-1200模拟量的使用

模块类型核心参数输入信号处理输出信号配置转换原理数值范围TIA Portal配置编程要点 转换公式: 输出模拟量: 五、校准与线性化 硬件校准非线性补偿抗干扰措施数字滤波温度控制压力监控流量调节信号异常精度不足实践操作参考文档项目案例借鉴博客

weixin_51020122的博客 4771

Python 爬虫基础——http请求和http响应

解析:先把IP地址分为两部分一部分是123.123.123. 另一部分是123,又因Ip最大值为255,所以先使用分组,然后在组里边再进行选择,组里也有三部分,0-199,200-249,250-255,分别和上述的表达是对应,最后还要注意分组之后还要加上一个.,因为是元字符所以要转义故加上. 然后再把这部分整体看做是一个组,重复三次,再加上仅有数字的一组也就是不带.的那一组即可完成IP地址的校验。我在问自己要不要写这篇东西,关于相似的内容网上多如牛毛,而且还不乏珍品,况且,就算我写了也不一定能写的好。

笨笨轻松熊的博客 4099

DELL SC存储扩容避坑指南:6Gb vs 12Gb扩展柜混插的真相

本文深入解析DELL SC存储扩容中6Gb与12Gb扩展柜混插的核心规则与性能影响。文章指出,从SCOS 7.3版本起允许混插,但整个SAS环路速率将降至最低设备水平,尤其在12Gb控制器上接入6Gb扩展柜会严重拖累性能。指南提供了清晰的兼容性矩阵、实战操作流程及关键避坑清单,帮助管理员安全、高效地完成存储扩容。

weixin_28314575的博客 459

PyTorch 面试题及参考答案(精选100道)

模块是 PyTorch 中用于自动求导的核心模块。它为张量上的所有操作提供了自动求导的功能。在深度学习中,反向传播是一种用于计算损失函数相对于模型参数的梯度的算法。通过梯度,我们可以使用优化算法(如随机梯度下降)来更新模型的参数,从而最小化损失函数。模块的主要作用就是自动计算这些梯度。当我们创建一个张量时,如果将其属性设置为True,那么 PyTorch 会跟踪该张量上的所有操作。在完成前向传播计算出损失函数后,调用方法,模块会自动根据链式法则反向传播计算出所有需要求导的张量的梯度。

大模型大数据攻城狮的专栏 1681

Python网络爬虫入门基础 _HTTP请求与响应【2】

1.HTTP:超文本传输协议(Hypertext Transfer Protocol,简称:HTTP)它是一个简单的请求-响应协议,架构运行在TCP之上。这套协议定义了客户端可发送什么样的请求(Request)信号和服务器可返回什么样的响应(Response)。它的作用是规定www服务器与浏览器之间信息传递规范,是二者共同遵守的协议。2.当用户使用浏览器输入网址访问目标网站时,需要向网站服务器发送HTTP请求,通过发送请求即可从服务器获取页面内容的响应。

追求细节,成就完美 255

YOLOv8损失函数改进大全:从IoU到FocusIoU的20+种变体全解析(附完整适配代码+性能对比)

目标检测边界框损失函数演进与优化 摘要:边界框损失函数是目标检测模型定位精度的关键因素。本文系统分析了从基础IoU到最新FocusIoU的20余种损失函数的演进历程,包括四代主要技术:基于重叠区域的IoU/GIoU,结合距离度量的DIoU/CIoU,优化形状匹配的EIoU/RIoU,以及考虑方向性的SIoU/WIoU/FocusIoU。针对YOLOv8模型,提供了完整的损失函数实现代码和替换方案,实验表明优化后的损失函数在复杂场景下可提升mAP@0.5达3.2%。文章特别对比了不同损失在小目标、遮挡和密集场

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 996

Python3网络爬虫开发--爬虫基础

爬虫基础

2302_80755459的博客 2905

001、NPU是什么?为什么嵌入式设备需要它?

本文通过作者调试工业相机板卡的经历,引出嵌入式设备为何需要NPU(神经网络处理器)的探讨。文章对比了CPU和NPU的设计哲学差异,指出NPU通过专用乘加器阵列和优化的数据流,能高效处理神经网络运算。作者分析了嵌入式设备使用NPU的三大优势:算力提升、功耗降低和实时性保障,并介绍了三类常见NPU形态。通过一个YOLOv5模型调试案例,揭示了NPU使用中的常见陷阱,最后给出五条实用建议,强调理解NPU原理和局限的重要性。文章生动展现了NPU在嵌入式AI应用中的关键作用。

m0_50546716的博客 126

37、免驱动USB双目同步测距3D活体深度检测和RV1126结合V4L开发USB摄像头使用

基本思想:需要使用双目摄像头在rv1126上进行活体检测,然后将画面实时返回到桌面上,记录一下。第二步:刷机rv1126开发板系统和ssh远程连接,见参考目录。第一步:购买可见光的红外摄像头,见参考连接,在PC端测试可用。

sxj731533730 2621

Python网络爬虫零基础入门:从HTTP请求到数据存储的完整路线

网络爬虫是数据采集与自动化处理的重要技能,其本质是对HTTP协议的模拟与解析。理解请求、响应、状态码以及HTML结构是掌握爬虫的第一步,requests库负责高效发送网络请求,BeautifulSoup则能将网页源码解析为可提取的数据树。技术价值在于将重复的人工浏览转化为可复用、可维护的代码流程,广泛应用于数据分析、竞品监控、内容聚合等场景。本文以零基础视角,从环境配置、虚拟环境创建、依赖安装开始,逐步演示一个可翻页、可保存的静态网页爬虫实例,涵盖数据解析、CSV与JSON存储、异常重试与请求频率控制。同时

weixin_32821533的博客 289

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Python3网络爬虫实战 chapter2 爬虫基础快速入门 2.1 HTTP基本原理

Python3网络爬虫实战 chapter2 爬虫基础快速入门 2.1 HTTP基本原理

代码改变世界 368

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

python爬虫文件代码大全-手把手教你利用爬虫爬网页(Python代码)

本文主要分为两个部分:一部分是网络爬虫的概述,帮助大家详细了解网络爬虫;另一部分是HTTP请求的Python实现,帮助大家了解Python中实现HTTP请求的各种方式,以便具备编写HTTP网络程序的能力。01网络爬虫概述接下来从网络爬虫的概念、用处与价值和结构等三个方面,让大家对网络爬虫有一个基本的了解。1. 网络爬虫及其应用随着网络的迅速发展,万维网成为大量信息的载体,如何有效地提取并利用这些信...

weixin_37988176的博客 2708

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

1.认识网络爬虫

1.认识网络爬虫 网络爬虫 爬虫的合法性 HTTP协议 请求与响应(重点) 网络爬虫 爬虫的全名叫网络爬虫,简称爬虫。他还有其他的名字,比如网络机器人,网络蜘蛛等等。爬虫就好像一个探测机器,它的基本操作就是模拟人的行为去各个网站溜达,点点按钮,查查数据,或者把看到的信息背回来。就像一只虫子在一幢楼里不知疲倦地爬来爬去。 你可以这样理解,每个爬虫都是你的分身。就像孙悟空拔了一撮汗毛,吹出一堆猴子一样。 你每天使用的百度,其实就是利用了这种爬虫技术:每天放出无数爬虫到各个网站,把他们的信

weixin_50804299的博客 5万+

python 高级 09 python爬虫基础

爬虫基础 网路爬虫 web spider(又称为网页蜘蛛,网路机器人,在FOAF社区中间,常称为网页追逐者),是一种安装一定的规则,自动的抓取万维网信息的程序或脚本。 网路爬虫的基本操作时抓取网页(html),网页实质是HTML代码构成,通过分析和过滤这些HTML代码,实现对图片、文字等资源的获取。 URL和RUI的简述 URI,Web上每种可用的资源,如HTML文档、图...

qq_42421212的博客 221

【Python】爬虫基础—— HTTP请求

在浏览器中输入URL,按回车键或点击搜索按钮,这是浏览器向Web服务器发送一个HTTP请求,Web服务器接收到这个请求后进行解析和处理,然后返回给浏览器对应的HTTP响应,之后浏览器对HTTP响应进行解析,显示网页内容。请求头显示对的是HTTP请求和响应的详细信息。User-Agent:使用服务器识别客户端使用的操作系统及版本、浏览器及版本等信息,实现爬虫时加上此信息,可以伪装为浏览器;POST方法:向指定资源提交数据并进行请求处理(提交表单、上传文件),数据包含在请求体,提交没有字节限制。

weixin_61972561的博客 1731

(22)100天python从入门到拿捏《【网络爬虫】网络基础与HTTP协议》

URL是互联网上资源的地址,就像网页的“门牌号”。协议://主机名:端口/路径?参数#锚点解读协议:https,是一种通过SSL/TLS对传输的数据进行加密的安全通信协议;主机名:blog.youkuaiyun.com,主机名即服务器的域名,浏览器需要通过DNS域名解析协议把域名转为服务器的IP,才能与服务器进行通信;端口:没有显示指定,此时使用https协议的默认端口443,完整的访问地址应该是;路径:/qq_64736204,指明了在服务器上要访问的特定资源位置,是用户的ID,应着优快云博客平台上的。

zhangxulang 1150

python网络爬虫一课一得

在数据驱动的时代,网络爬虫成为了一种强大的工具,能够帮助我们获取网络上的各种信息。通过本次实践,我们学习了Python网络爬虫的基础知识,并成功爬取了一个新闻网站的首页新闻标题。同时,我们也意识到网络爬虫需要遵守一定的规则和道德准则,如尊重网站的robots.txt文件、控制请求频率等。最后,我想说的是,网络爬虫是一个不断学习和实践的过程。网络爬虫的基本原理是通过模拟浏览器发送HTTP请求,获取网页的HTML内容,然后使用解析库提取所需信息。库发送GET请求,获取首页的HTML内容。

QWQ20050402的博客 881

Python爬虫丨爬虫之前需要什么准备

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理 以下文章来源于腾讯云 作者:村雨遥 ( 想要学习Python?Python学习交流群:1039649593,满足你的需求,资料都已经上传群文件流,可以自行下载!还有海量最新2020python学习资料。 ) 网络爬虫 定义 通过模拟人请求网站的行为,然后能够自动请求网页并将数据抓取下来,再使用一定规则将其中我们所需要的有价值的数据提取出来存储,以便我们进行分析; 分类 通用爬

weixin_49345590的博客 364

Python网络爬虫与数据采集实战——网络协议与HTTP

这部分的内容要做到详细,涵盖从HTTP协议的基础概念到如何在Python爬虫中应用,如何应对常见的错误和状态码,如何优化性能,并处理爬虫反制等。字数目标20000字可以通过逐一展开每个小节,结合理论和实际代码示例,特别是在爬虫的实际操作中,多加一些细节和实战案例,进行详细阐述。我们收集了很多相关的视频开发课程,具体可以访问。

好看资源网的博客 2228
上一篇: mqtt服务搭建及python调用
下一篇: crontab 详细用法 定时任务
RunMode-likf
博客等级 码龄5年 17粉丝 11原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值