FasterTransformer 001 start up

Faster Transformer faster transformer 阅读详情

FasterTransformer

  • Faster Transformer是一个Transformer单层前向计算的高效实现。一个函数由多个OP组合实现。每一个基本OP都会对应一次GPU kernel的调用,和多次显存读写。OP融合可以降低GPU调度和显存读写,进而提升性能。在Faster Transformer,作者将除矩阵乘法以外的所有kernel都进行了尽可能的融合。

NVIDIA 博客在2019-07-15的介绍:

  • 目前优化集中在编码器(encoder)的前向计算(解码器decoder开发在后续特性规划中)。底层由CUDA和cuBLAS实现,支持FP16和FP32两种计算模式,其中FP16可以充分利用Volta和Turing架构GPU上的Tensor Core计算单元。
    Faster Transformer共接收4个输入参数。首先是attention head的数量以及每个head的维度。这两个参数是决定Transformer网络结构的关键参数。
    这两个参数的动态传入,可以保证Faster Transformer既支持标准的BERT-BASE(12 head x 64维),也支持裁剪过的模型(例如,4 head x 32维),或者其他各式专门定制化的模型。其余两个参数是Batch Size 和句子最大长度。
    出于性能考虑,目前句子最大长度固定为最常用的32,64 和128三种,未来会支持任意长度。Faster Transformer对外提供C++ API,TensorFlow OP 接口,以及TensorRT插件,并提供了相应的示例,用以支持用户将其集成到不同的线上应用代码中。
    NVIDIA BERT推理解决方案Faster Transformer开源啦,这篇文章还有单层计算attention的图解,可结合代码查看

Jul 29, 2021 v1.0版本的介绍

  • Faster Transformer 建立在 CUDA 和 cuBLAS 之上。它支持大于 3 且小于或等于 1024 的序列长度。变压器层的两个关键参数,即磁头的数量和每个磁头的大小,在运行时传递。因此,不仅BERT Base(12头* 64头),而且定制型号,如4头* 32/头和8头* 96每头,都得到了很好的支持。我们的实现在小批量和大批量情况下都显示出良好的加速。

v1.0_tag

  • https://github.com/NVIDIA/FasterTransformer/tree/release/v1.0_tag

  • 环境准备

  • 下边的操作有点麻烦,这个链接给出了dockerfile https://github.com/NVIDIA/TensorRT/tree/release/5.1/docker

  • sudo docker run -it --shm-size 8gb --rm --gpus=all -v ${PWD}:/test nvcr.io/nvidia/cuda:10.0-cudnn7-devel-ubuntu16.04 bash

  • cd /test/FastT

  • git clone https://github.com/NVIDIA/FasterTransformer.git

  • apt-get update

  • apt-get install git

  • 下载 FasterTransformer-release-v1.0_tag.zip git clone -b release/v1.0_tag --depth=1 https://github.com/NVIDIA/FasterTransformer.git

  • apt-get install zip

  • unzip FasterTransformer-release-v1.0_tag.zip

  • git submodule init && git submodule update

bulid

  • mkdir -p build && cd build
  • wget https://github.com/Kitware/CMake/releases/download/v3.26.3/cmake-3.26.3-linux-x86_64.sh
  • bash ./cmake-3.26.4-linux-x86_64.sh --skip-licence --prefix=/usr
  • export PATH=“/usr/cmake-3.26.4-linux-x86_64/bin:$PATH”
  • cmake -DSM=86 -DCMAKE_BUILD_TYPE=Release -DBUILD_PYT=ON -DBUILD_MULTI_GPU=ON .. or cmake -DSM=xx -DCMAKE_BUILD_TYPE=Release .. # C++ only
CMake Error at CMakeLists.txt:109 (add_subdirectory):
  The source directory
    /test/FastT/code/FasterTransformer/tools
  does not contain a CMakeLists.txt file.
  • 原因:在https://github.com/NVIDIA/FasterTransformer/blob/release/v1.0_tag/CMakeLists.txt有 add_subdirectory(tools)
  • 所以将其修改成 add_subdirectory(tools/gemm_test)了

make

  • make
  • maybe error : nvcc fatal : redefinition of argument ‘std’
  • https://github.com/facebookresearch/DetectAndTrack/issues/57 : Try to find out all --std=c++11 and removed
这个错误通常是由于您在使用`-ccbin`选项时指定了一个使用了不同的C++标准库的编译器而引起的。

加入`-Xcompiler -stdlib=libstdc++`选项可以明确告诉`nvcc`使用`libstdc++`标准库。例如:

nvcc -ccbin g++-7 -Xcompiler -stdlib=libstdc++ your_file.cu -o your_executable

可以在`-ccbin`选项中指定您需要使用的C++编译器,然后在`-Xcompiler`选项中指定需要使用的标准库,以解决此问题。如果您不知道应该使用哪个编译器和标准库,请参考您的CUDA安装说明文档或咨询CUDA社区。

TEST

  • ./bin/gemm_fp16 100 12 32 64 # 在路径构建下生成gemm_config.in文件,以选择gemm算法以获得最佳性能。
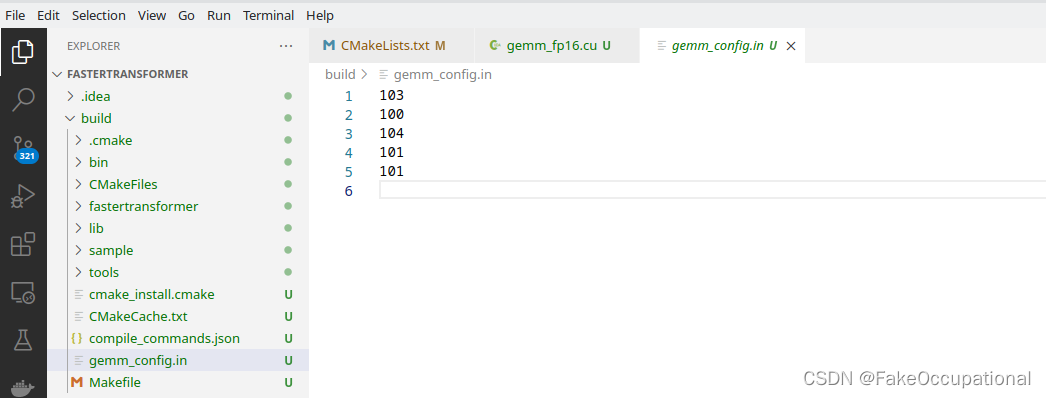
    在这里插入图片描述

  • c++ demos: ./build/bin/transformer_fp16 100 12 32 64 <batch_size> <num_layerse> <seq_len> <head_num> <size_per_head>

Useful sample code

$ 1. sample/tensorflow/transformer_fp32.py: transformer_layer Tensorflow FP32 OP call, time measurement, timeline generation
$ 2. sample/tensorflow/transformer_fp16.py: transformer_layer Tensorflow FP16 OP call, time measurement, timeline generation
$ 3. sample/tensorflow/error_check.py: how to catch custom OP runtime errors
$ 4. sample/cpp/transformer_fp32.cc: transformer layer C++ FP32 sample
$ 5. sample/cpp/transformer_fp16.cc: transformer layer C++ FP16 sample
$ 6. sample/tensorRT/transformer_trt.cc: transformer layer tensorRT FP32/FP16 sample
$ 7. tools/gemm_test/gemm_fp16.cu: loop over all cublas FP16 GEMM algorithms and pick the best one
$ 8. tools/gemm_test/gemm_fp32.cu: loop over all cublas FP32 GEMM algorithms and pick the best one

CG

从FasterTransformer源码解读开始了解大模型(1.0)了解FasterTransformer FasterTransformer(下文简称FT或者ft)是一个用于大语言模型的推理引擎。目前ft的源代码里集成了bart,bert,gpt2(代码中叫multi_gpu_gpt)、t5等模型,如果有一定开发能力,还可以自己在ft里集成llama、chatglm等模型。通过对FT进行源码解读,可以学习到很多大模型的相关知识 阅读详情

相关推荐

FasterTransformer但是ChatGPT

FasterTransformer” 是 NVIDIA 提供的一个库,用于优化 Transformer 模型的推理速度。它是基于 CUDA 和 Tensor Core 技术的深度学习加速库。

xtinggo的博客 302

使用 FasterTransformer 和 Triton 推理服务器加速大型 Transformer 模型的推理

这是讨论 NVIDIA FasterTransformer 库的两部分系列的第一部分,该库是用于对任意大小(多达数万亿个参数)的Transformer进行分布式推理的最快库之一。它提供了 FasterTransformer 的概述,包括使用该库的好处。是一个指南,说明了使用 FasterTransformer 库和 Triton 推理服务器以具有张量并行性的最佳方式为 T5-3B 和 GPT-J 6B 模型提供服务。...

专注于人工智能领域的小何尚 2万+

FasterTransformer编译安装与测试

基础环境:centos7 + cuda10.2+cudnn7显卡:Tesla V100。

weixin_50008473的博客 2466

FasterTransformer 2.0优化——公开课听课笔记

2020.04.09英伟达就FasterTransformer 2.0做了一个线上的公开课分享,由于老板的要求,我也报名听课了。做了一份听课笔记,分享一下。这里的优化主要是由底层的CUDA和cuBLAS编程支撑的,这个代码我是没有去看的,也是看不懂的。听课笔记主要就宏观的原理上进行一个总结。 目录 一、FasterTransformer 1.0版关于encoder的优化 二、F...

HUSTHY的博客 4079

FasterTransformer 框架速览

FasterTransformer 包含 Transformer 块的高度优化版本的实现,其中包含编码器 Encoder 和解码器 Decoder部分。基于 FT 可以运行完整的编码器-解码器架构模型

专注计算机视觉算法训练,算法优化部署以及SDK开发的知识分享。 667

FasterTransformer:变压器相关的优化,包括BERT,GPT

更快的变形金刚 该存储库提供了脚本和配方来运行高度优化的基于变压器的编码器和解码器组件,并且已由NVIDIA测试和维护。 目录 型号概述 在NLP中,编码器和解码器是两个重要的组件,而变压器层成为这两个组件的流行架构。 FasterTransformer为编码器和解码器实现了高度优化的转换器层,以进行推理。 在Volta,Turing和Ampere GPU上,当数据和权重的精度为FP16时,将自动使用Tensor Core的计算能力。 FasterTransformer v1.0为推理提供了高度优化的BERT等效Transformer层,包括C ++ API,TensorFlow op和TensorRT插件。 实验表明,FasterTransformer v1可以在NVIDIA Tesla T4和NVIDIA Tesla V100上提供1.3到2倍的加速,以进行推理。 在FasterT

大模型的好伙伴,浅析推理加速引擎FasterTransformer

来自:吃果冻不吐果冻皮进NLP群—>加入NLP交流群最近几个月,随着ChatGPT的现象级表现,大模型如雨后春笋般涌现。而模型推理是抽象的算法模型触达具体的实际业务的最后一公里。但是在这个环节中,仍然还有很多已经是大家共识的痛点和诉求,比如:任何线上产品的用户体验都与服务的响应时长成反比,复杂的模型如何极致地压缩请求时延?模型推理通常是资源常驻型服务,如何通过提升服务单机性能从而增加QPS,...

zenRRan的博客 2036

使用Jacob实现将Word文件转换为Pdf文件

如果是首次使用 jacob,建议先直接从 github上下载 zip包,因为在实现Word转Pdf的时候,不仅需要用到 jacob.jar,还需要 jacob.dll 库,而zip包中都有。官方使用文档可以参考:https://github.com/freemansoft/jacob-project/blob/main/docs/UsingJacob.md。// 如果安装的是微软的 Office,需要使用 Word.Application。

qq_41672950的博客 750

FasterTransformer 安装

第一:安装TensorRT(FasterTransformer 支持cuda10.0,所以TensorRT也下cuda10.0对应版本) 1、下载TensorRT https://developer.nvidia.com/nvidia-tensorrt-5x-download 2、安装pycuda pip install pycuda 3、安装 TensorRT #在home下新建...

九妖的博客 2165

Windows Server 搭建ftp服务

Windows Server 搭建ftp服务

ch258563的博客 1010

PCB设计必看:铜皮厚度与载流量的黄金比例(附实用对照表)

本文深入探讨了PCB设计中铜皮厚度与载流量的关键关系,提供了实用的对照表和设计技巧。通过分析基础原理、标准选择策略及常见误区,帮助工程师优化PCB设计,确保电路板的可靠性和安全性。特别适用于需要处理大电流或高频应用的电子设计场景。

milk8的博客 511

NLP(十八):LLM 的推理优化技术纵览

目录收起一、子图融合(subgraph fusion)二、模型压缩(Model Compression)2.1 稀疏(Sparsity)2.2 量化(Quantization)2.3 蒸馏(Distillation)三、并行化(Parallelism)3.1 数据并行 (Data Parallelism, DP)3.2 张量并行(Tensor Parallelism, TP)3.3 流水线并行(Pipeline Parallelism, PP)四、Transformer 结构优化。

张伟的专栏 3600

Prometheus常用配置介绍

除了 scrape_configs 外,上部还有 global 和 rule_files 部分, 其中 global 中 是 全 局 参 数 , scrape_interval 指 定 全 局 默 认 的 时 间 间 隔 , evaluation_interval 指定告警规则校验的时间间隔,rule_files 指定了告警规 则文件的位置名称。• annotations(注释):它们被用于存储更长的其他信息,例如警报描述 或者链接,注释值也可以被模板化。• alert:告警的名称。

weixin_42886699的博客 2260

FasterTransformer

考虑到这种广泛使用的是注意力机制,它显着提高了模型的计算效率、质量和准确性。具有数千亿个参数的大型基于 transformer 的模型就像一个巨大的百科全书和大脑,其中包含有关它所学一切的信息。同时,TP 和 PP 可以结合在一起,在多 GPU 和多节点环境中运行具有数十亿和数万亿参数(相当于 TB 级权重)的大型 Transformer 模型。,允许您使用预烘焙pre-baked 的 docker 容器以简单的方式运行 ML/DL 模型的推理,仅使用一行代码和简单的类似 JSON 的配置。

AI生成式技术曾小健 639

LightTools 中LCD投影仿真的checkerboard pattern偏振控制技术解析

本文深入解析了在LightTools软件中进行LCD投影仿真时,利用checkerboard pattern(棋盘格图案)结合偏振控制技术来模拟液晶面板像素开关、提升图像对比度的核心方法。文章从实战角度出发,详细拆解了通过设置波片(如1/2波片)和偏振片来操控S光与P光转换的原理,并分享了在LightTools中搭建仿真模型、使用VBA脚本自动化配置参数以提高效率的实用技巧,为光学工程师优化投影系统仿真流程提供了清晰指导。

weixin_29305313的博客 344

基于CNN对抗嵌入的图像隐写——CNN-Based Adversarial Embedding for Image Steganography

CNN-Based Adversarial Embedding for Image Steganography https://ieeexplore.ieee.org/abstract/document/8603808 这篇论文发表在TIFS( IEEE TRANSACTIONS ON INFORMATION FORENSICS AND SECURITY),TIFS是网络与信息安全领域的国际两大顶级期刊之一,中国计算机学会(CCF)推荐的A类期刊,SCI一区TOP期刊,目前影响因子有7多了。 1 概

weixin_48654804的博客 2279

FasterTransformer解码器组件详解与技术实践指南

FasterTransformer是NVIDIA推出的高性能Transformer推理加速库,其解码器(Decoder)组件在自然语言生成任务中发挥着关键作用。本文将深入解析FasterTransformer解码器的架构设计、优化技术以及实际应用方法,帮助开发者充分利用这一强大工具。 ## 核心组件架构 ### 解码器模块层级 FasterTransformer解码器包含三个关键层级: 1

gitblog_00399的博客 451

20 Embedding 与向量检索:语义为什么能变成距离

Embedding 是 RAG 语义检索的数学基础。本文用工程视角讲清文本如何变成向量,为什么语义相近会表现为距离相近,Top-K 检索如何工作,以及在模型选择、同模型约束、精确匹配和召回评估上的常见坑。

老于的笔记的专栏 6203

FasterTransformer :transformer类模型的三种结构

Transformer是一种基于注意力机制的深度神经网络结构,常用于文本生成、机器翻译等NLP任务:transformer类模型的三种结构,KV Cache in GPT,Kernel fuse

ResumeProject的博客 883

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

FasterTransformer BERT 优化实现详解

FasterTransformer 是 NVIDIA 推出的高性能 Transformer 模型推理加速库,其中 BERT 模型的优化实现尤为出色。本文将深入解析 FasterTransformer 中 BERT 模型的架构设计、优化技术以及使用方法。 ## BERT 模型架构优化 ### 标准 BERT 与 Effective FasterTransformer FasterTransfo

gitblog_01021的博客 437

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

FastTransformer 框架:高性能推理框架

FastTransformer 是一个由 NVIDIA 开发的高性能推理框架,专门针对 Transformer 模型(例如 BERT、GPT、T5 等)进行优化,旨在提供低延迟、高吞吐量的推理能力。它通过一系列底层优化技术和模型并行策略,显著提升了 Transformer 模型在 GPU 上的推理性能,广泛应用于自然语言处理(NLP)、对话系统、文本生成等场景。核心特性包括:高效的 Transformer 层实现、KV Cache 优化、模型并行支持、

彬彬侠的博客 1830

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

上一篇: leetcode1584. 连接所有点的最小费用 最小生成树
下一篇: FasterTransformer 002: cuda调试env
FakeOccupational
博客等级 码龄6年 2万+粉丝 1727原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值