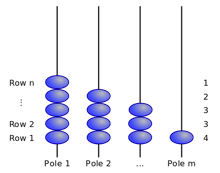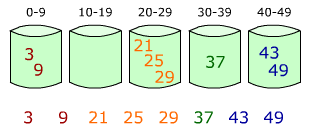排序算法一览(二):归并类排序、分布类排序和混合类排序

归并类排序

归并排序(Merge Sort)

归并排序是一种分治法,它反复将两个已经排序的序列合并成一个序列(平均时间复杂度O(nlogn),最好时间复杂度O(n)):

  • 申请空间,使其大小为两个已经排序序列之和,该空间用来存放合并后的序列;
  • 设定两个指针,最初位置分别为两个已经排序序列的起始位置;
  • 比较两个指针所指向的元素,选择相对小的元素放入到合并空间,并移动指针到下一位置;
  • 重复步骤直到某一指针达到序列尾;
  • 将另一序列剩下的所有元素直接复制到合并序列尾。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
public class Sort {
   public static > void mergeSort( T[] arr ) {
     T[] tmpArr = (T[]) new Comparable[arr.length];
     mergeSort(arr, tmpArr, 0 , arr.length - 1 );
   }
  
   private static >
   void mergeSort( T[] arr, T[] tmpArr,
       int left, int right ) {
     //recursive way
     if ( left < right ) {
       int center = ( left + right ) / 2 ;
       mergeSort(arr, tmpArr, left, center);
       mergeSort(arr, tmpArr, center + 1 , right);
       merge(arr, tmpArr, left, center + 1 , right);
     }
    }
  
   private static > void merge( T[] arr, T[] tmpArr,
       int lPos, int rPos, int rEnd ) {
     int lEnd = rPos - 1 ;
     int tPos = lPos;
     int leftTmp = lPos;
  
     while ( lPos <= lEnd && rPos <= rEnd  ) {
       if ( arr[lPos].compareTo( arr[rPos] ) <= 0 )
         tmpArr[ tPos++ ] = arr[ lPos++ ];
       else
         tmpArr[ tPos++ ] = arr[ rPos++ ];
     }
  
     //copy the rest element of the left half subarray.
     while ( lPos <= lEnd )
       tmpArr[ tPos++ ] = arr[ lPos++ ];
     //copy the rest elements of the right half subarray. (only one loop will be execute)
     while ( rPos <= rEnd )
       tmpArr[ tPos++ ] = arr[ rPos++ ];
  
     //copy the tmpArr back cause we need to change the arr array items.
     for ( ; rEnd >= leftTmp; rEnd-- )
       arr[rEnd] = tmpArr[rEnd];
   }
}

排序算法一览(下):归并类排序、分布类排序和混合类排序

归并排序有许多变种,比如梯级归并排序(Cascade Merge Sort)、振荡归并排序(Oscillating Merge Sort)和多相归并排序(Polyphase Merge Sort)。以多相归并排序为例,它经常用在外排序中,可以减少原始归并排序每次循环需要遍历的元素个数,因为原始的归并排序每次都做二路归并,在文件数量多的时候效率低下。

Strand排序(Strand Sort)

Strand排序不断地从待排序的序列中拉出排好序的子列表,并归并成一个最终的结果。该算法的平均和最坏时间复杂度都达到了O(n2),最好时间复杂度为O(n)。Strand排序高效的条件要求:

  • 以链表(linked list)方式存放的数据排序起来最为有效,因为它需要反复添加和移除元素,而链表添加移除元素的代价很小;
  • 原始数据中已经很大程度上有序了,这样每次可以尽量多地拉出一个有序子列表数据。

举例来说,现在有原始列表(4,5,2,3,1):

  • 遍历元素,第一个元素4,拉出包含4的最长递增子序列:(4,5),原列表变成了(2,3,1);
  • 继续拉出最长递增子序列(2,3),和前面拉出的序列归并得到(2,3,4,5),原列表变成了 (1);
  • 拉出(1),归并得到(1,2,3,4,5)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
procedure strandSort( A : list of sortable items ) defined as:
   while length( A ) > 0
     clear sublist
     sublist[ 0 ] := A[ 0 ]
     remove A[ 0 ]
     for each i in 0 to length( A ) - 1 do :
       if A[ i ] > sublist[ last ] then
         append A[ i ] to sublist
         remove A[ i ]
       end if
     end for
     merge sublist into results
   end while
   return results
end procedure


分布类排序

基数排序(Radix Sort)

相较于前面严格的比较排序,基数排序更多地利用了待排序元素本身的特性。待排序元素需要是整型,基数排序时将整数按照位数切分成不同的数字,然后按每个位数分别比较;但是推广一下,整数也可以表达字符串,和符合特定格式的浮点数,所以基数排序堆元素的要求进一步降低。具体实现步骤:

待比较元素统一成相同格式(例如短数前面补零),然后从最低位开始,依次进行一次排序,接着是次低位……直到最高位也完成排序。

例如有元素(432,546,723):

  • 第一遍按照个位数排序,变成(432,723,546);
  • 接着按照十位数排序:(723,432,546);
  • 最后是百位数:(432,546,723)。

基数排序的时间复杂度是O(k*n),其中n是待排序元素个数,k是数字的位数,它的复杂度理论上要低于O(n*logn),但是如果考虑到实际上k也和n存在关系,那就不是这样了。就以排序n个不同的整数为例,每一位都有0-9这10个不同的数字,所以10的k次方必须大于等于n,所以k≥log10n。所以按照这个角度来说,它的时间复杂度还是在O(n*logn)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
const int base= 10 ;
wx *headn,*curn,*box[base],*curbox[base];
  
void basesort( int t)
{
   int i,k= 1 ,r,bn;
   for (i= 1 ;i<=t;i++)
   {
     k*=base;
   }
   r=k*base;
   for (i= 0 ;inext;curn!=NULL;curn=curn->next)
   {
     bn=(curn->num%r)/k;
     curbox[bn]->next=curn;
     curbox[bn]=curbox[bn]->next;
   }
   curn=headn;
   for (i= 0 ;inext=box[i]->next;
       curn=curbox[i];
     }
   }
   curn->next=NULL;
}
  
int main()
{
   int i,n,z= 0 ,maxn= 0 ;
   curn=headn= new wx;
   cin>>n;
   for (i= 0 ;inext= new wx;
     cin>>curn->num;
     maxn=max(maxn,curn->num);
   }
   while (maxn/base> 0 )
   {
     maxn/=base;
     z++;
   }
   for (i= 0 ;i<=z;i++)
   {
     basesort(i);
   }
   printwx();
   return 0 ;
}

美国旗帜排序(American Flag Sort)

美国旗帜排序是基数排序的一种原地排序变种,和原始的基数排序一样,只能排数字,或者是能用数字表示的对象,而它原地排序的特性,节约了空间消耗和数组拷贝开销。美国旗帜排序把元素归类到若干个桶里面,经常用来给大对象排序,比如字符串(如果给大字符串使用比较排序,时间复杂度过高)。加上一定的优化以后,对于一大组字符串的排序,时间消耗可以接近快排。步骤基本上可以表示为:

  • 根据最高位的基数划分桶并在数组上找到每个桶的边界;
  • 通过交换把元素放置到正确的桶中;
  • 在每个桶中继续使用美国旗帜排序。

伪代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
american_flag_sort(Array, Radix)
   for each digit D:
     # first pass: compute counts
     Counts <- zeros(Radix)
     for object X in Array:
       Counts[digit D of object X in base Radix] += 1
     # compute bucket offsets
     Offsets <- [ sum(Counts[ 0 ..i]) for i in 1 ..Radix]
     # swap objects into place
     for object X in Array:
       swap X to the bucket starting at Offsets[digit D of X in base Radix]
     for each Bucket:
       american_flag_sort(Bucket, Radix)

珠排序(Bead Sort)

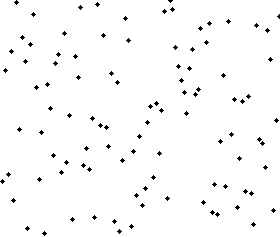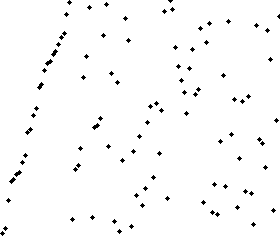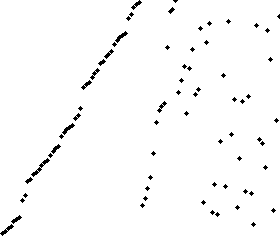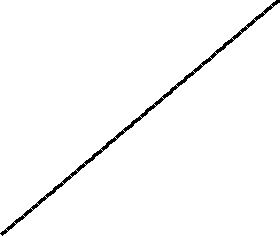
珠排序是自然排序算法的一种,时间复杂度在O(n),缺点是空间复杂度始终需要O(n2),而且,和传统基数排序一样,要求排序对象可以用有限整数来表示。珠排序的过程非常容易理解:
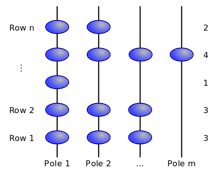
排序算法一览(下):归并类排序、分布类排序和混合类排序 排序算法一览(下):归并类排序、分布类排序和混合类排序

每一行表示一个数,从左往右排列珠子,有珠子的列的个数表示了数的值。排好后珠子随重力下落,获得排序结果。

桶排序(Bucket Sort)

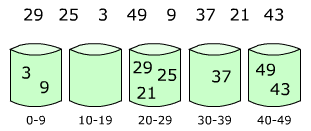
桶排序也叫做箱排序,把待排序元素分散到不同的桶里面,每个桶再使用桶排序再分别排序(和前面提到的美国旗帜排序差不多,只不过这里需要额外的空间来放置桶,而且放置元素到桶中的过程也不采用美国旗帜排序中的元素交换):

1
2
3
4
5
6
7
function bucket-sort(array, n) is
   buckets ← new array of n empty lists
   for i = 0 to (length(array)- 1 ) do
     insert array[i] into buckets[msbits(array[i], k)]
   for i = 0 to n - 1 do
     next-sort(buckets[i])
   return the concatenation of buckets[ 0 ], ..., buckets[n- 1 ]

排序算法一览(下):归并类排序、分布类排序和混合类排序 排序算法一览(下):归并类排序、分布类排序和混合类排序

上面两张图中,左图是第一步,给元素分到不同的桶中;右图是给每个桶中的元素继续排序。

鸽巢排序(Pigeonhole Sort)

鸽巢排序也被称作基数分类,是一种时间复杂度为O(n),且在不可避免地遍历每一个元素并且已经排序的情况下效率最好的一种排序算法。但它只有在差值(或者可被映射在差值)很小的范围内的数值排序的情况下实用。当涉及到多个不相等的元素,且将这些元素放在同一个“鸽巢”的时候,算法的效率会有所降低。


1
2
3
4
5
6
7
8
for i in [ 0 ...length(a)- 1 ]
   b[a[i]] := b[a[i]]+ 1
 
j := 0
for i in [ 0 ...length(b)- 1 ]
   repeat b[i] times
     a[j] := i
     j := j+ 1


以一个例子来解释上述伪代码:

待排序数列a:(2,3,2,4,3,1,5),那么辅助数列b,b[x]表示数列a中值为x的元素个数,于是b就为(0,1,2,2,1,1),最后得到排序后的数列:(1,2,2,3,3,4,5)。

相邻图排序(Proxmap Sort)

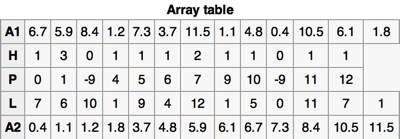
相邻图排序源于基础的桶排序和基数排序,在把待排序元素划分成若干个桶的时候,这个划分规则是通过一个相邻图给出的,并且在将元素放入桶内的过程,是通过插入排序来完成的,如果这个划分得当,排序可以接近线性的复杂度。在数据量增大的情况下这个算法性能表现不错。
排序算法一览(下):归并类排序、分布类排序和混合类排序

以一个例子,借助上面的图,如果待排序数组A,它的key有n个,现在把算法描述一下:

  • 确定有多少个键会映射到同一个子数组,这一步需要使用一个“hit count”(H)的辅助数组;
  • 确定每个子数组在A2中的位置,这一步需要使用辅助数组“proxmaps”(P);
  • 对于每一个key,计算得到将被映射到哪一个子数组中,这个信息存放在辅助数组“locations”(L)中;
  • 对于每一个key,根据它的location,把它放到A2中,A2中已经有这个key了,那就变成一次插入操作,把比它大的元素后移。

排序算法一览(下):归并类排序、分布类排序和混合类排序

计数排序(Counting Sort)

计数排序是一种稳定的排序算法。计数排序使用一个额外的数组C,其中第i个元素是待排序数组A中值等于i的元素的个数。然后根据数组C来将A中的元素排到正确的位置。当输入的元素是n个0到k之间的整数时,它的运行时间是O(n + k)。计数排序不是比较排序,排序的速度快于任何比较排序算法。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
private static void countingSort( int [] A, int [] B, int k) {
     int [] C = new int [k];
     // 计数
     for ( int j = 0 ; j < A.length; j++) {
         int a = A[j];
         C[a] += 1 ;
     }
     // 求计数和
     for ( int i = 1 ; i < k; i++) {
         C[i] = C[i] + C[i - 1 ];
     }
     // 整理
     for ( int j = A.length - 1 ; j >= 0 ; j--) {
         int a = A[j];
         B[C[a] - 1 ] = a;
         C[a] -= 1 ;
     }
}


混合类排序

Tim排序(Tim Sort)

Tim排序是一种结合了归并排序和插入排序的混合排序法,算法首先寻找数据的有序子数组(被称作“run”),并且利用这个知识来提高排序效率(比如低于某个阈值会使用插入排序技术等等),然后要对有序子数组进行归并,持续这样的操作直到条件满足,排序结束。值得一提的是,它在JDK 7中被用来给默认非原语类型的数组排序。

自省排序(Intro Sort)

这个排序算法首先从快速排序开始,当递归深度超过一定深度(深度为排序元素数量的对数值)后转为堆排序。采用这个方法,自省排序既能在常规数据集上实现快速排序的高性能,又能在最坏情况下仍保持O(n*logn)的时间复杂度。

Spread排序(Spread Sort)

Spread排序结合了基于分布的排序(比如桶排序和基数排序),并且引入比较排序(比如快速排序和归并排序)中的分区概念,在实验中表现出来的效果要好过传统的排序方法。快排的主要理念是找到一个中心元素(pivot)然后分成前后两个子列表,一个元素都小于等于pivot,一个元素都大于等于pivot;Spread排序则是划分成n/c的(n是元素个数,c是一个较小的常量)分区(被称为bin),然后使用基于分布的排序来完成,这其中会使用启发式的测试来确定对于bin递归排序的过程使用哪一种排序算法。

UnShuffle排序(UnShuffle Sort)

UnShuffle排序是一种分布排序和归并排序的结合,它在数据的熵值非常低(数据相对有序,比如基本有序或者包含大量有序子串)的时候最有效。排序过程分为两个步骤:

  • 1、分布排序阶段,通过最小次数的比较,待排序元素被分发到一些子列表中;
  • 2、每一个子列表的排序结果会被归并到最终结果中去。
算法引入了一种名为“pile”的数据结构,它其实是一种有序的双端队列,这种数据结构只允许从头部添加最小的元素,或者从尾部添加最大的元素,而不允许从中间插入元素。

J排序(J Sort)

J排序是通过构建两次堆(一次小根堆,一次大根堆)来让数列大致有序,接着再使用插入排序来完成的原地排序算法。

文章系本人原创,转载请保持完整性并注明出自《四火的唠叨》

混合排序(Mixed Sort)的实现(Python) 混合排序是一种将列表中的元素按照不同的排序规则进行排序的方法。在混合排序中,我们可以使用不同的排序算法来对列表的不同部分进行排序。例如,我们可以将列表中的偶数按照升序排序,而将奇数按照降序排序。这样可以在保持排序结果的基础上,对不同类型的元素采用不同的排序方式,从而实现混合排序。你可以根据自己的需求和排序规则的不同,修改代码来实现不同类型的混合排序。最后,我们将排序后的偶数部分和奇数部分合并成一个新的列表,并将其返回作为最终的排序结果。的函数,它接受一个列表作为输入,并返回经过混合排序后的新列表。 阅读详情

相关推荐

多相归并排序算法的深入解析

本文深入解析了多相归并排序算法的原理和操作流程,特别是其在虚拟运行任务分配中的应用。算法D作为研究焦点,详细解释了其初始化、输入到磁带、前进、上一级、合并和下一级的步骤,以及如何通过斐波那契分布和虚拟运行来简化排序过程。文章还讨论了算法中的“遍历”次数,以及在不同磁带数量下多相合并排序的效率和渐近行为。

weixin_36074800的博客 488

尝试一种时间复杂度至多 O(nlogn) 的数组排序

数组排序一种混合排序方式主要思路时间复杂度 max{O(maxa−mina), O(n)}max\{O(maxa - mina),\ O(n)\}max{O(maxa−mina), O(n)} 的排序法混合排序方法算法适用场合 一种混合排序方式 主要思路 时间复杂度 max{O(maxa−mina), O(n)}max\{O(maxa - mina),\ O(n)\}max{O(maxa−mina), O(n)} 的排序法 对于给定数组 arr[n]arr[n]arr

YJY-Simon的博客 3663

多相归并排序的深度解析与级联合并的性能比较

本文深入探讨了多相归并排序算法及其在级联合并中的应用。分析了多相归并排序的完美分布、合并策略和运行时间,对比了多相与级联合并的性能差异,并通过数学分析和实例演示了各自的优缺点。

weixin_36074800的博客 487

从JavaScript二维数组排序说开去(2)

从上一篇文章里面我们已经知道了,需要通过sort函数,定义自己的排序比较函数。sort会回调这个函数,在排序时逐个比较元素。 那么问题来了,如果我想比较多个列,至少比较2列,使得其有效排序, 如果第2列是个字符串,这样写还行吗?不行。字符串相减,结果是NaN,not a number。那怎么办? 当然是写一个字符串排序函数了。先看以下第一版: function strcomp(a,b){ if( !(a instanceof Array) || !(b instanceof Array) ){ret

tjzzy的专栏 9424

如何选择StandardScaler、MinMaxScaler和RobustScaler做标准化的对比解释和示例代码

选择合适的标准化方法取决于数据的特点和需求。如果数据分布接近正态分布且无异常值,可以使用。如果需要将数据映射到特定范围内并保持相对关系,可以使用。如果数据中存在异常值或离群点,可以使用进行鲁棒标准化。在分类、聚类算法中,需要使用距离来度量相似性的时候、或者使用PCA技术进行降维的时候,StandardScaler表现更好(避免不同量纲对方差、协方差计算的影响);在不涉及距离度量、协方差、数据不符合正态分布、异常值较少的时候,可使用MinMaxScaler。

qq_36001281的博客 4940

告别混乱!在Unity中为Best MQTT v3设计清晰的服务层:配置、连接、订阅发布模块拆分指南

本文详细介绍了如何在Unity中使用Best MQTT v3插件构建清晰的服务层架构,包括配置管理、连接服务、订阅管理和发布服务的模块化拆分。通过解耦设计、事件驱动和接口抽象,提升代码可维护性和可测试性,适用于物联网和实时通信开发场景。

weixin_30576827的博客 359

MergeSort算法(混合排序)

#include #include void merge(int *data,int low,int mid,int high) {//将两个有序的子文件data[low..m)和data[m+1..high]归并成一个有序的子文件data[low..high] int i=low;//置初始值 int j=mid+1; int p=0; int *temp;//temp是局部向量 t

RunAtWorld:常常想想自己能解决什么问题 1572

注意力机制详解

注意力机制详解Attention机制由来Attention定义Encoder-Decoder框架存在问题:Attenion机制的引入Attention机制的类别Hard AttentionSoft AttentionGlobal AttentionLocal AttentionSelf AttentionMulti-head Attention附录—Transformer全局视角Tensor视角Encoder部分Self-AttentionSelf-Attention向量计算Self-Attention的矩

weixin_43236310的博客 1万+

各种排序算法

排序算法一览(一):交换类、选择类和插入类排序 地址:点击打开链接 排序算法一览(二):归并类排序、分布类排序和混合类排序 地址:点击打开链接 转载自《四火的唠叨》

luoluozlb 406

YOLOv11损失函数进阶:融合SmoothL1与FocalLoss,让检测精度再涨10%的实战教程

在YOLOv11的这里的beta参数控制“L1与L2的过渡阈值”,默认设为1.0即可兼容多数场景。同样在# 计算动态alpha(基于类别样本数,需提前统计self.class_counts)# 交叉熵基础# FocalLoss权重else:使用前需统计数据集的(每个类别的样本数),并传入的alpha参数。损失函数是YOLOv11精度的“灵魂”——SmoothL1让边界框回归“稳、准、狠”,改进FocalLoss让类别分类“雨露均沾”。从代码改造到实战落地,本教程已为你搭建了一条精度跃升的路径。

m0_64661770的博客 213

1、开启 Microsoft Power Automate 自动化之旅

本文介绍了 Microsoft Power Automate 的基本概念和其在信息时代自动化需求中的重要作用。Power Automate 是 Power Platform 的一部分,能够通过无代码/低代码的方式自动化处理重复性任务,例如邮件处理、文件复制等,从而提升工作效率。文章还详细讲解了 Power Automate 的核心术语、登录方式、创建第一个流程的操作步骤,并通过示例帮助用户快速上手。无论是终端用户还是管理员,都可以通过本文了解如何利用 Power Automate 实现业务流程自动化。

corn8的博客 169

排序算法一览(一):交换类、选择类和插入类排序

最近在复习常用排序算法发现了下面这个罪恶的排序方法列表页面,我被那些有趣的排序方法诱惑了,就把上面介绍的各种排序方法都整理了一遍(我觉得维基百科比其它我看过的算法书都要易懂一些),前半部分可以说还乐在其中,后半部分就有些厌烦了,不过最后总算是坚持看完了。以下是第一部分,包括交换类排序、选择类排序和插入类排序。 交换类排序 - 冒泡排序 鸡尾酒排序 奇偶排序 梳子排序 侏儒排序 快速排序 臭皮...

四火专栏 1005

【中项第三版】系统集成项目管理工程师 | 第 1 章 信息化发展

【中项第三版】系统集成项目管理工程师 | 第 1 章 信息化发展

静谧、淡雅 6577

排序算法一览(上):交换类、选择类和插入类排序

转载于 :http://www.raychase.net/1814 最近在复习常用排序算法发现了下面这个罪恶的排序方法列表页面,我被那些有趣的排序方法诱惑了,就把上面介绍的各种排序方法都整理了一遍(我觉得维基百科比其它我看过的算法书都要易懂一些),前半部分可以说还乐在其中,后半部分就有些厌烦了,不过最后总算是坚持看完了。以下是第一部分,包括交换类排序、选择类排序和插入类排序。

飞翔的熊blabla 1610

Python爬虫:抓取专利数据并分析专利趋势

本文展示了如何使用 Python 爬虫技术抓取中国专利数据,并对数据进行了清洗、分析和趋势预测。通过分析专利数据,企业和科研机构可以了解行业的技术发展趋势,进行技术创新战略规划。未来,我们可以进一步扩展爬虫的功能,抓取更多专利数据,增加多维度的数据分析,如技术领域、地域分布等。同时,可以尝试使用深度学习模型(如 LSTM)进行时间序列预测,以获得更准确的专利趋势预测。

2201_76125261的博客 1787

从工具选型到落地实践:吃透 SAP Fiori Launchpad 配置工具体系

摘要: SAP Fiori Launchpad配置远非简单添加应用和分配角色,涉及技术目录、业务目录、Spaces/Pages等多层管理。官方推荐新工具分工:技术目录用FLPAM维护应用定义,业务目录用FLPCM编排应用组合,Spaces/Pages优化用户体验布局,而传统Groups模式已被标记弃用。这种分层治理模式(定义层-编排层-展示层)能有效解决传输混乱、升级兼容性问题,尤其适合大规模项目实施。关键在于区分技术配置与业务呈现,避免将所有功能堆砌在单一旧工具中。(149字)

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 103

douyin-downloader:5 分钟抖音无水印下载,从单个视频到整个创作者主页

在线下载器保存的视频常常被压到 720p 还带角标水印,原因是它截取的是转码流。douyin-downloader 直接从抖音服务端取原始文件:单个无水印下载、主页级抖音批量下载、图集、合集、音乐、直播存档,都走同一条命令行。 ## 能力速览:5 类内容、3 类产物 | 内容 | 链接形式 | 说明 | |---|---|---| | 视频 | /video/{aweme_id} | 无水印源

gitblog_00408的博客 290

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

排序算法总结

1.排序算法 交换类排序 -冒泡排序鸡尾酒排序 奇偶排序 梳子排序 侏儒排序快速排序臭皮匠排序 Bogo排序 选择类排序 -选择排序堆排序Smooth排序 笛卡尔树排序 锦标赛排序 圈排序 插入类排序 -插入排序希尔排序二叉查找树排序 图书馆排序 耐心排序 归并类排序 -归并排序梯级归并排序 振荡归并排序 多相归并排序 Strand排序 分布类排序 -...

weixin_30596023的博客 130

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

算法:稳定排序与非稳定排序

目的:有两个排序关键字的时候,可以让第一个关键字的排序结果服务于第二个关键字排序中数值相等的那些数 举个栗子:要对班上同学的身高进行排序,同学们已经按照学号从小到大排好了序,则根据身高排序完成后,相同身高的人任然按照学号从小到大的顺序 https://blog.youkuaiyun.com/yeluoxiang/article/details/102661568?depth_1-utm_source=dis...

OceanStar的博客 529

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

std::sort的底层原理(混合排序算法)

std::sort是 C++ 标准库中的高效排序算法,采用了混合排序策略,默认使用快速排序来排序大数据集,对于小数据集则使用插入排序,在需要时会退回到堆排序。std::sort的实现还使用了多种优化策略,包括三数取中法、递归深度控制等,确保在不同情况下都能提供 O(n log n) 的平均时间复杂度。通过这些优化,std::sort在大多数实际应用中表现出色

Z1tai的博客 1869

算法学习系列之排序算法:原理、应用场景与C++实现精解

本博客全面探讨了计算机科学中几种关键的排序算法,包括冒泡排序、选择排序、插入排序、快速排序、归并排序、堆排序、希尔排序、计数排序、基数排序和桶排序。每种算法的原理、优缺点、适用场景以及C++代码实现均进行了详细讨论。文章的目的是为读者提供一份全面的指南,无论是为了加深对算法的理解还是为了在实际项目中选择和实现最合适的排序策略。

m0_51661400的博客 1560

归并排序

归并排序是利用”归并”技术来进行排序。归并是指将若干个已排序的子文件合并成一个有序的文件。常见的归并排序有两路归并排序(Merge Sort),多相归并排序(Polyphase Merge Sort),Strand排序(Strand Sort)。下面介绍第一种:两路归并排序最差时间复杂度:O(nlogn) 平均时间复杂度:O(nlogn) 最差空间复杂度:O(n) 稳定性:稳定两路归并排序(M

《我是你的正能量》 807

归并排序算法-C++

转自 http://blog.youkuaiyun.com/left_la/article/details/8656953 在看 归并排序,感觉这哥们也写很好,就转载过来,只不过他没有加注释,我这里注释一下 归并排序是利用"归并"技术来进行排序。归并是指将若干个已排序的子文件合并成一个有序的文件。常见的归并排序有两路归并排序(Merge Sort),多相归并排序(Polyphase Merge

亮亮的博客 792

外部排序 多相合并

初始化串很有意思。数字以文本模式存放在文件中,每个数字大小不相同,那么字符长度也不一样,想要提前知道一个文件有多少数字只能遍历一遍文件计数,硬盘读写慢的要命,就算是ssd也才读写500M/s,内存(不包括cache命中)20000M/s。但多相合并根据数字数量按照斐波那契列分配到文件中,所以一定要读一个数存一个数。 这个有个问题,文件结尾是空格,就算用feof并不能知道是文件结尾,造成迭

wwj_bupt 1656

三种高阶比较排序算法

时间复杂度的估算 这三种排序算法都是利用在遍历过程中在一定程度上排序的同时记录尽可能多的元素有关位置的信息。 master表达式:用于对采用递归实现的相关算法的时间复杂度的估算 Ο(1)<Ο(log2n)<Ο(n)<Ο(nlog2n)<Ο(n2)<Ο(n3)<…<Ο(2n)<Ο(n!) T(N)=aT(N/b)+N^d log_ab=d时:T(N)=O(N*logN) 1.归并排序 ...

Junpb的博客 2165

一文读懂10种排序算法,你知道几种?

如果数据范围很大,则需要开辟大量的空间来存储桶,这可能会导致空间问题,此外,基数排序还需要遍历数据多次,具体的,需要遍历数据的位数次,如果数据的位数很多,则基数排序的时间复杂度也会变得很高。在桶排序的上面代码中,我们计算出需要的桶数量,然后创建一个桶的列表,接着,我们遍历数组,将每个数据放入对应的桶中,最后,我们遍历桶的列表,对每个桶内的数据分别进行排序,然后将排序后的数据放回原数组中,桶排序的优点在于它可以快速地对数据进行排序,特别是对于数据范围很大,但是数据分布在一个较小范围内的情况。

lubin5580的博客 2006
上一篇: 排序算法一览(一):交换类、选择类和插入类排序
下一篇: java.util.concurrent并发包诸类概览
RayChase
博客等级 码龄20年 71粉丝 87原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值