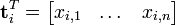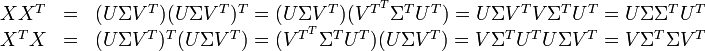LSA潜在语义分析

Explicit Semantic Analysis (ESA) 有别于LSA (Latent Semantic Analysis), 下列文章提出一种ESA (Explicit Semantic Analysis), 并介绍如何使用ESA来进行语义相关性和文本分类工作。 文章的基本思路其实也很简单,就是基于wikipedia网站内容,生成每一个曾经出现在wikipedia文章中的单词的语义表示。 每个单词的语义表示是一个高维向量, 而对应的每一个维就是wiki 阅读详情


在Wiki上看到的LSA的详细介绍,感觉挺好的,遂翻译过来,有翻译不对之处还望指教。

原文地址:http://en.wikipedia.org/wiki/Latent_semantic_analysis


前言


浅层语义分析(LSA)是一种自然语言处理中用到的方法,其通过“矢量语义空间”来提取文档与词中的“概念”,进而分析文档与词之间的关系。LSA的基本假设是,如果两个词多次出现在同一文档中,则这两个词在语义上具有相似性。LSA使用大量的文本上构建一个矩阵,这个矩阵的一行代表一个词,一列代表一个文档,矩阵元素代表该词在该文档中出现的次数,然后再此矩阵上使用奇异值分解(SVD)来保留列信息的情况下减少矩阵行数,之后每两个词语的相似性则可以通过其行向量的cos值(或者归一化之后使用向量点乘)来进行标示,此值越接近于1则说明两个词语越相似,越接近于0则说明越不相似。

LSA最早在1988年由 Scott Deerwester, Susan Dumais, George Furnas, Richard Harshman, Thomas Landauer, Karen Lochbaum and Lynn Streeter提出,在某些情况下,LSA又被称作潜在语义索引(LSI)。

概述

词-文档矩阵(Occurences Matrix)

LSA 使用词-文档矩阵来描述一个词语是否在一篇文档中。词-文档矩阵式一个稀疏矩阵,其行代表词语,其列代表文档。一般情况下,词-文档矩阵的元素是该词在文档中的出现次数,也可以是是该词语的tf-idf(term frequency–inverse document frequency)。

词-文档矩阵和传统的语义模型相比并没有实质上的区别,只是因为传统的语义模型并不是使用“矩阵”这种数学语言来进行描述。

降维

在构建好词-文档矩阵之后,LSA将对该矩阵进行降维,来找到词-文档矩阵的一个低阶近似。降维的原因有以下几点:

  • 原始的词-文档矩阵太大导致计算机无法处理,从此角度来看,降维后的新矩阵式原有矩阵的一个近似。
  • 原始的词-文档矩阵中有噪音,从此角度来看,降维后的新矩阵式原矩阵的一个去噪矩阵。
  • 原始的词-文档矩阵过于稀疏。原始的词-文档矩阵精确的反映了每个词是否“出现”于某篇文档的情况,然而我们往往对某篇文档“相关”的所有词更感兴趣,因此我们需要发掘一个词的各种同义词的情况。
降维的结果是不同的词或因为其语义的相关性导致合并,如:
{(car), (truck), (flower)} --> {(1.3452 * car + 0.2828 * truck), (flower)}
将维可以解决一部分同义词的问题,也能解决一部分二义性问题。具体来说,原始词-文档矩阵经过降维处理后,原有词向量对应的二义部分会加到和其语义相似的词上,而剩余部分则减少对应的二义分量。
推导
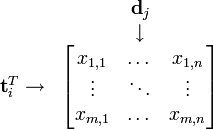
假设X是词-文档矩阵,其元素(i,j)代表词语i在文档j中的出现次数,则X矩阵看上去是如下的样子:
\begin{matrix}  & \textbf{d}_j \\ & \downarrow \\\textbf{t}_i^T \rightarrow &\begin{bmatrix} x_{1,1} & \dots & x_{1,n} \\\vdots & \ddots & \vdots \\x_{m,1} & \dots & x_{m,n} \\\end{bmatrix}\end{matrix}

可以看到,每一行代表一个词的向量,该向量描述了该词和所有文档的关系。

\textbf{t}_i^T = \begin{bmatrix} x_{i,1} & \dots & x_{i,n} \end{bmatrix}

相似的,一列代表一个文档向量,该向量描述了该文档与所有词的关系。

\textbf{d}_j = \begin{bmatrix} x_{1,j} \\ \vdots \\ x_{m,j} \end{bmatrix}

词向量\textbf{t}_i^T \textbf{t}_p的点乘可以表示这两个单词在文档集合中的相似性。矩阵X X^T 包含所有词向量点乘的结果,元素(i,p)和元素(p,i)具有相同的值,代表词p和词i的相似度。类似的,矩阵X^T X包含所有文档向量点乘的结果,也就包含了所有文档那个的相似度。

现在假设存在矩阵X的一个分解,即矩阵X可分解成正交矩阵U和V,和对角矩阵\Sigma的乘积。

这种分解叫做奇异值分解(SVD),即:

\begin{matrix}X = U \Sigma V^T\end{matrix}

因此,词与文本的相关性矩阵可以表示为:

\begin{matrix}X X^T &=& (U \Sigma V^T) (U \Sigma V^T)^T = (U \Sigma V^T) (V^{T^T} \Sigma^T U^T) = U \Sigma V^T V \Sigma^T U^T = U \Sigma \Sigma^T U^T \\X^T X &=& (U \Sigma V^T)^T (U \Sigma V^T) = (V^{T^T} \Sigma^T U^T) (U \Sigma V^T) = V \Sigma^T U^T U \Sigma V^T = V \Sigma^T \Sigma V^T\end{matrix}


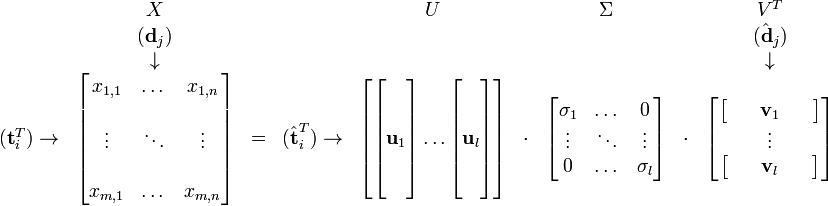
因为\Sigma \Sigma^T与\Sigma^T \Sigma是对角矩阵,因此U  肯定是由X X^T的特征向量组成的矩阵,同理V是X^T X特征向量组成的矩阵。这些特征向量对应的特征值即为\Sigma \Sigma^T中的元素。综上所述,这个分解看起来是如下的样子:
\begin{matrix}  & X & & & U & & \Sigma & & V^T \\ & (\textbf{d}_j) & & & & & & & (\hat{\textbf{d}}_j) \\ & \downarrow & & & & & & & \downarrow \\(\textbf{t}_i^T) \rightarrow &\begin{bmatrix} x_{1,1} & \dots & x_{1,n} \\\\\vdots & \ddots & \vdots \\\\x_{m,1} & \dots & x_{m,n} \\\end{bmatrix}&=&(\hat{\textbf{t}}_i^T) \rightarrow&\begin{bmatrix} \begin{bmatrix} \, \\ \, \\ \textbf{u}_1 \\ \, \\ \,\end{bmatrix} \dots\begin{bmatrix} \, \\ \, \\ \textbf{u}_l \\ \, \\ \, \end{bmatrix}\end{bmatrix}&\cdot&\begin{bmatrix} \sigma_1 & \dots & 0 \\\vdots & \ddots & \vdots \\0 & \dots & \sigma_l \\\end{bmatrix}&\cdot&\begin{bmatrix} \begin{bmatrix} & & \textbf{v}_1 & & \end{bmatrix} \\\vdots \\\begin{bmatrix} & & \textbf{v}_l & & \end{bmatrix}\end{bmatrix}\end{matrix}
\sigma_1, \dots, \sigma_l 被称作是奇异值,而 u_1, \dots, u_l 和v_1, \dots, v_l则叫做左奇异向量和右奇异向量。通过矩阵分解可以看出,原始矩阵中的\textbf{t}_i 只与U矩阵的第i行有关,我们则称第i行为 \hat{\textrm{t}}_i。同理,原始矩阵中的\hat{ \textrm{d}}_j只与V^T中的第j列有关,我们称这一列为\hat{ \textrm{d}}_j。\textbf{t}_i与\hat{ \textrm{d}}_j并非特征值,但是其由矩阵所有的特征值所决定。
当我们选择k个最大的奇异值,和它们对应的U与V中的向量相乘,则能得到一个X矩阵的k阶近似,此时该矩阵和X矩阵相比有着最小误差(即残差矩阵的Frobenius范数)。但更有意义的是这么做可以将词向量和文档向量映射到语义空间。向量\hat{\textbf{t}}_i与含有k个奇异值的矩阵相乘,实质是从高维空间到低维空间的一个变换,可以理解为是一个高维空间到低维空间的近似。同理,向量 \hat{\textbf{d}}_j也存在这样一个从高维空间到低维空间的变化。这种变换用公式总结出来就是这个样子:
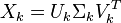
X_k = U_k \Sigma_k V_k^T
有了这个变换,则可以做以下事情:
  • 判断文档 j 与 q 在低维空间的相似度。比较向量 \Sigma_k \hat{\textbf{d}}_j  与向量\Sigma_k \hat{\textbf{d}}_q  (比如使用余弦夹角)即可得出。
  • 通过比较\Sigma_k \hat{\textbf{t}}_i^T  与 \Sigma_k \hat{\textbf{t}}_p^T 可以判断词i和词p的相似度。 
  • 有了相似度则可以对文本和文档进行聚类。
  • 给定一个查询字符串,算其在语义空间内和已有文档的相似性。
要比较查询字符串与已有文档的相似性,需要把文档和查询字符串都映射到语义空间,对于原始文档,由以下公式可以进行映射:
\hat{\textbf{d}}_j = \Sigma_k^{-1} U_k^T \textbf{d}_j
其中对角矩阵\Sigma_k 的逆矩阵可以通过求其中非零元素的倒数来简单的得到。
同理,对于查询字符串,得到其对应词的向量后,根据公式 \hat{\textbf{q}} = \Sigma_k^{-1} U_k^T \textbf{q}将其映射到语义空间,再与文档进行比较。
应用

低维的语义空间可以用于以下几个方面:

  • 在低维语义空间可对文档进行比较,进而可用于文档聚类和文档分类。
  • 在翻译好的文档上进行训练,可以发现不同语言的相似文档,可用于跨语言检索。
  • 发现词与词之间的关系,可用于同义词、歧义词检测。.
  • 通过查询映射到语义空间,可进行信息检索。
  • 从语义的角度发现词语的相关性,可用于“选择题回答模型”(multi choice qustions answering model)。

(原文还说了一些其它方面,感觉不是很重要,不翻译了,放上原文)

Synonymy and polysemy are fundamental problems in natural language processing:

  • Synonymy is the phenomenon where different words describe the same idea. Thus, a query in a search engine may fail to retrieve a relevant document that does not contain the words which appeared in the query. For example, a search for "doctors" may not return a document containing the word "physicians", even though the words have the same meaning.
  • Polysemy is the phenomenon where the same word has multiple meanings. So a search may retrieve irrelevant documents containing the desired words in the wrong meaning. For example, a botanist and a computer scientist looking for the word "tree" probably desire different sets of documents.

Commercial applications[edit]

LSA has been used to assist in performing prior art searches for patents.[5]

Applications in human memory[edit]

The use of Latent Semantic Analysis has been prevalent in the study of human memory, especially in areas of free recall and memory search. There is a positive correlation between the semantic similarity of two words (as measured by LSA) and the probability that the words would be recalled one after another in free recall tasks using study lists of random common nouns. They also noted that in these situations, the inter-response time between the similar words was much quicker than between dissimilar words. These findings are referred to as the Semantic Proximity Effect.[6]

When participants made mistakes in recalling studied items, these mistakes tended to be items that were more semantically related to the desired item and found in a previously studied list. These prior-list intrusions, as they have come to be called, seem to compete with items on the current list for recall.[7]

Another model, termed Word Association Spaces (WAS) is also used in memory studies by collecting free association data from a series of experiments and which includes measures of word relatedness for over 72,000 distinct word pairs.[8]

算法局限性

LSA的一些缺点如下:

  • 新生成的矩阵的解释性比较差.比如
{(car), (truck), (flower)} ↦ {(1.3452 * car + 0.2828 * truck), (flower)}
 (1.3452 * car + 0.2828 * truck) 可以解释成 "vehicle"。同时,也有如下的变换
{(car), (bottle), (flower)} ↦ {(1.3452 * car + 0.2828 * bottle), (flower)}
造成这种难以解释的结果是因为SVD只是一种数学变换,并无法对应成现实中的概念。
  • LSA无法扑捉一词多以的现象。在原始词-向量矩阵中,每个文档的每个词只能有一个含义。比如同一篇文章中的“The Chair of Board"和"the chair maker"的chair会被认为一样。在语义空间中,含有一词多意现象的词其向量会呈现多个语义的平均。相应的,如果有其中一个含义出现的特别频繁,则语义向量会向其倾斜。
  • LSA具有词袋模型的缺点,即在一篇文章,或者一个句子中忽略词语的先后顺序。
  • LSA的概率模型假设文档和词的分布是服从联合正态分布的,但从观测数据来看是服从泊松分布的。因此LSA算法的一个改进PLSA使用了多项分布,其效果要好于LSA。



潜在语义分析(LSA)详解 文章目录单词向量空间话题向量空间算法实现矩阵奇异值(SVD)分解算法非负矩阵(NMF)分解算法基本思想损失函数(1)平方损失(2)散度损失函数算法(1)平方损失函数更新法则(2)散度损失函数的更新法则算法实现 潜在语义分析(latent semantic analysis, LSA)是一种无监督方法,主要用于文本的话题分析,其特点是通过矩阵分解发现文本与单词之间的基于话题的语义关系。潜在语义分析是非概率的话题分析方法,将文本集合表示为单词-文本矩阵,对该矩阵进行进行奇异值分解,从而得到话题向量空间和文本在话 阅读详情

相关推荐

潜在语义分析Latent semantic analysis note(LSA)原理及代码实现

Latent Semantic Analysis (LSA)也被叫做Latent Semantic Indexing(LSI),从字面上的意思理解就是通过分析文档去发现这些文档中潜在的意思和概念。假设每个词仅表示一个概念,并且每个概念仅仅被一个词所描述,LSA将非常简单(从词到概念存在一个简单的映射关系) 不幸的是,这个问题并没有如此简单,因为存在不同的词表示同一个意思(同义词),一个词表示多个

bob007的专栏 1万+

潜在语义分析(Latent Semantic Analysis,LSA)

文章目录 一种无监督学习方法,主要用于文本的话题分析,其特点是通过矩阵分解发现文本与单词之间的基于话题的语义关系。潜在语义分析由Deerwester等于1990年提出,最初应用于文本信息检索,所以也被称为潜在语义索引(latent semantic indexing,LSI),在推荐系统、图像处理、生物信息学等领域也有广泛应用。 文本信息处理中,传统的方法以单词向量表示文本的语义内容,以单词向...

Michael是个半路程序员 1万+

潜在语义分析LSA

一、背景 LSA潜在语义分析和传统向量空间模型VSM 都是使用向量来表示单词terms和文档documents,并且通过向量关系来判断terms和documents之间的关系; 不同的是,LSA将terms和documents映射到潜在语义空间,从而去除了原始向量空间中的一些“噪音”,提高了信息检索的精度。 二、文本挖掘方面的应用 (1)分类 按照意思分类词语;按照主题分类文本。 (2)检索 用户提问(通常由若干个反映文本主题的词汇组成),然后在然后系统在数据库中进行提问式和预存的文本关键词的

lili安的博客 1199

27、潜在语义分析(LSA)

本文介绍了潜在语义分析(LSA),详细介绍了单词向量空间和话题向量空间,潜在语义分析算法,以及非负矩阵分解算法,最后介绍了sklearn中的潜在语义分析的使用。

m0_56642803的博客 2687

潜在语义分析LSA和概率潜在语义分析PLSA

一、潜在语义分析LSA  LSA是一种无监督学习方法,主要用于文本的话题分析。其特点是通过矩阵分解发现文本与单词之间的基于话题的语义关系。  传统的量化文本的方法是用单词向量表示文本的语义内容,在单词向量空间中通过向量的内积或标准化内积(即余弦)衡量文本之间的语义相似度。 而潜在语义分析的目的就是解决这种方法不能准确表示语义的问题,试图从大量文本数据中发现潜在的话题,以话题向量表示文本的语义,在话题向量空间中通过向量的内积或标准化内积(即余弦)衡量文本之间的语义相似度。  在单词向量空间中使用单词-文本.

weixin_43646592的博客 1309

文本数据降维:潜在语义分析(LSA)

文本数据降维:潜在语义分析(LSA) 作者: 禅与计算机程序设计艺术 1. 背景介绍 在当今信息爆炸的时代,人类每天都会产生大量的文本数据,如新闻文章、社交媒体帖子、学术论文等。这些文本数据包含了丰富的语义信息,但其高维和稀疏的特点使得直接利用这些数据进行分析和处理变得非常困难

AI天才研究院 1553

潜在语义分析(LSA)

潜在语义分析(LSA) ​ 潜在语义分析LSA(Latent Semantic Analysis )也叫作潜在语义索引LSI( Latent Semantic Indexing )顾名思义是通过分析文章(documents )来挖掘文章的潜在意思或语义(concepts )。如果每个单词都仅以着一个语义,同时每个语义仅仅由一个单词来表示,那么LSA将十分简单,即简单地将进行语义和单词间的映射。 ​ 不幸的是,LSA并没有这么简单。因为不同的单词可以表示同一个语义,或一个单词同时具有多个不同的意思,这些的模

weixin_45458136的博客 1474

潜在语义分析Latent Semantic Analysis (LSA)

目录 目录 概述 Tutorial LSA的工作原理 How Latent Semantic Analysis Works 实例A Small Example Part 1 - Creating the Count Matrix Python - Import Functions Python - Define Data Python - Define LSA C...

lukabruce的博客 810

LSA算法——潜在语义分析概率潜在语义分析

1.简介 LSA使一种无监督学习方法,主要用于文本的话题分析,其特点使通过矩阵分解发现文本与单词之间的基于话题的语义关系。潜在语义分析通常将文本集合表示为单词-文本矩阵,对单词-文本矩阵进行奇异值分解或非负矩阵分解(non-negative matrix factorizatiion,NMF),从而得到话题向量空间以及文本在话题向量空间的表示。 2.相关概念 2.1 单词向量空间 给定一个含有n个文本的集合D={d1,d2,...,dn}D=\{d_1,d_2,...,d_n\}D={d1​,d2​,...

JeJe_33的博客 2147

潜在语义分析(LSA)原理与代码实战案例讲解

1. 背景介绍 1.1 问题的由来 在信息爆炸的时代,我们面临的一个重要问题是如何从海量的文本数据中提取有用的信息。传统的文本处理方法,如词袋模型,虽然简单易用,但忽视了词语之间的语义关系,导致信息提取的效果不尽人意。于是,人们开始寻找一种能够理解文本语义的方法,这就是潜在语义分析(LSA)的起源。

AI天才研究院 1361

从原理到实践:手把手教你如何校准和使用六维力传感器(附常见问题排查)

本文详细解析六维力传感器的工作原理与校准方法,提供从选型到故障排查的完整指南。重点介绍电阻式与电容式技术对比、六步校准法实战以及温度补偿技巧,帮助工程师精准测量空间力场。适用于机器人触觉反馈、航空航天测试等高精度场景。

weixin_29309475的博客 388

潜在语义分析模型(Latent Semantic Analysis,LSA)

LSA潜在语义分析模型原理解读

2401_88885149的博客 1770

Android各个版本存储权限适配

虽然 Android10 上面提出了外部存储分区的概念,不过之前的版本中,我们只要为应用添加了。1、AndroidManifest添加权限设置。3、拒绝权限时跳转详细设置页面。就可以像之前的方式一样访问手机的外部存储空间。2、请求所有文件管理权限。

sig321的专栏 1845

潜在语义分析 (LSA),概率潜在语义分析 (PLSA)

目录单词向量空间与话题向量空间单词向量空间非负矩阵分解 (non-negative matrix factorization, NMF) 潜在语义分析是一种无监督学习方法,主要用于文本的话题分析,其特点是通过矩阵分解发现文本与单词之间的基于话题的语义关系 单词向量空间与话题向量空间 单词向量空间 文本信息处理的一个核心问题是对文本的语义内容进行表示,并进行文本之间的语义相似度计算 (e.g. 文本信息检索、文本数据挖掘) 非负矩阵分解 (non-negative matrix factorizati

连理o的博客 2236

逆向工程Python爬虫——国税局发票查验平台

前言 这是一篇含金量很高的干货文章,笔者将手把手带领各位一步一步地实现爬取国家税务总局全国增值税发票查验平台(以下简称“查验平台”)。这个想法诞生在19年初,当时在做一款通过扫描二维码就可以查验发票的小程序。 当时由于笔者学艺尚浅,没办法模拟请求爬取查验平台,所以最终采用的技术方案是通过web自动化测试工具selenium控制浏览器去模拟查验步骤,即使这样,开发过程也是困难重重,不过最后笔者和伙伴们成功实现了整套流程,最后开发出的产品口袋发票夺得了包括2019微信小程序开发大赛赛区三等奖在内的多个奖项。 但

weixin_43102379的博客 1万+

DIY便携式PEMF磁脉冲治疗仪:百元成本自制生物物理疗法设备

脉冲电磁场(PEMF)疗法是一种基于生物物理原理的非侵入性技术,它通过特定频率的电磁脉冲作用于细胞层面,影响细胞膜电位和离子通道活动,从而可能调节细胞代谢与功能。其技术价值在于提供了一种物理干预手段,在健康科技和生物黑客领域被探索用于放松、恢复等场景。实现PEMF的核心是通过信号发生与功率放大驱动电磁线圈产生可控磁场。本文以蓝牙音频模块和智能手机App为切入点,详细解析了如何利用低成本电子元件(如DFRobot XY-WRBT模块和漆包线线圈)构建一个可自定义频率的便携式PEMF设备,涵盖了从电路设计、线圈

weixin_31476015的博客 352

LSA(潜在语义分析)

转载https://blog.youkuaiyun.com/fkyyly/article/details/84665361 link LSA最初是用在语义检索上,为了解决一词多义和一义多词的问题: 1.一词多义: 美女和PPMM表示相同的含义,但是单纯依靠检索词“美女”来检索文档,很可能丧失掉那些包含“PPMM”的文档。 2.一义多词:如果输入检索词是多个检索词组成的一个小document,例如“清澈 孩子”,那我们就知道这段

weixin_43977748的博客 2508

LTE信令流程实战:从Attach到Service Request的完整解析(附常见问题排查)

本文深入解析LTE信令流程中的Attach和Service Request关键环节,提供从基础原理到实战排查的完整指南。涵盖鉴权、承载建立等核心步骤,分析常见故障模式及优化方案,并附赠信令跟踪工具使用技巧,助力通信工程师提升网络运维效率。

alpha的博客 319

【机器学习】潜在语义分析LSA和PLSA

666

Mankind的博客 1353

Windows 10/11 零基础配置 SillyTavern 连接 Claude API 完整指南(含 Node.js 环境搭建)

本文提供Windows 10/11系统下零基础配置SillyTavern连接Claude API的完整教程,涵盖Node.js环境搭建、SillyTavern初始化及API连接配置等关键步骤。通过详细的操作指南和实用技巧,帮助用户快速搭建AI聊天界面并优化对话体验,实现与Claude AI的高效交互。

weixin_30642561的博客 134

即插即用系列(代码实践)| 2025 Strip R-CNN:大尺寸条形卷积——遥感目标检测新SOTA,专治细长目标(桥梁、船只)

摘要: 论文《Strip R-CNN: Large Strip Convolution for Remote Sensing Object Detection》针对遥感图像中细长目标(如桥梁、道路)检测难题,提出创新性解决方案。通过设计StripBlock模块,将传统方形卷积核替换为大尺寸条形卷积(水平1×19与垂直19×1组合),有效捕获长距离空间特征,同时减少背景噪声。结合CenterPooling增强目标中心定位,该模块可即插即用至现有网络,显著提升遥感检测任务(如DOTA数据集)的精度。代码已开源,

分享顶会顶刊论文即插即用模块 189

java版LSA(潜在语义分析)

前言 LSA(潜在语义分析)的详细概念我就不做介绍了。此处简单提一下,首先就是要构建单词-文档矩阵,然后关键的是进行SVD奇异值分解,这是核心的一步,最终通过计算向量夹角余弦值就可得到文档与文档之间的相似度。 这里有一位博主我觉得写得非常好,大家可以参考一下他的文章,他也附上了python的实现代码: http://zhikaizhang.cn/2016/05/31/自然语言处理之LSA/ ...

jiebaHZ的博客 746

YOLOv11改进策略【注意力机制篇】| SE、CBAM、ECA、CA、Swin Transformer等注意力机制全面解析与应用

本文详细介绍了五种主流的注意力机制及其在YOLOv11中的应用。通过合理的模块选择和位置部署,注意力机制能够显著提升目标检测性能。

QQ_778132974的博客 876

LSA(潜在语义分析):原理、实现与应用

揭示文本中的潜在语义结构,尽管已被BERT等深度学习方法超越,但其思想仍影响深远(如词嵌入)。,将高维的词语-文档关系降维到低维的“概念空间”。LSA在自然语言处理(NLP)领域广泛应用于。对文档-词项矩阵进行降维,将词语和文档映射到同一语义空间,从而发现隐藏的语义关系。LSA(Latent Semantic Analysis,潜在语义分析)是一种用于。它通过分析大量文本集合,挖掘词语背后的。传统文本表示方法(如词袋模型)假设词语相互独立,无法捕捉。(同一词不同含义)的问题。LSA的核心价值在于通过。

拒绝AI玄学,只聊真技术▲ 1907

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

SVD分解——>潜在语义分析LSA(I)——>概率性潜在语义分析PLSA(I)

SVD分解 正交矩阵:若一个方阵其行与列皆为正交的单位向量,则该矩阵为正交矩阵,且该矩阵的转置和其逆相等。两个向量正交的意思是两个向量的内积为 0。 正定矩阵:如果对于所有的非零实系数向量 zzz,都有zTAz>0z^TAz>0zTAz>0,则称矩阵AAA是正定的。正定矩阵的行列式必然大于 0,所有特征值也必然 > 0。相对应的,半正

十三 3882

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

上一篇: Weka算法Classifier-meta-AdditiveRegression源码分析
下一篇: 贝叶斯网络小结
ROger__Wong
博客等级 码龄14年 250粉丝 78原创
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值