【Python机器学习实战】聚类算法——层次聚类(HAC)和DBSCAN

sklearn聚类算法之HAC 基本思想 层次凝聚聚类算法(Hierarchical Agglomerative Clustering)是一种效果很好的聚类算法,简称HAC,它的主要思想是先把每个样本点当做一个聚类,然后不断地将其中最近的两个聚类进行合并,直到满足某个迭代终止条件,比如当前聚类数是初始聚类数的20%,80%的聚类数都被合并了。总结来说,HAC的具体实现步骤如下所示。     (1)将训练样本集中的每个数据点都当做一个聚类;     (2)计算每 阅读详情

层次聚类和DBSCAN

1.层次聚类

下面这样的结构应该比较常见,这就是一种层次聚类的树结构,层次聚类是通过计算不同类别点的相似度创建一颗有层次的树结构,在这颗树中,树的底层是原始数据点,顶层是一个聚类的根节点。
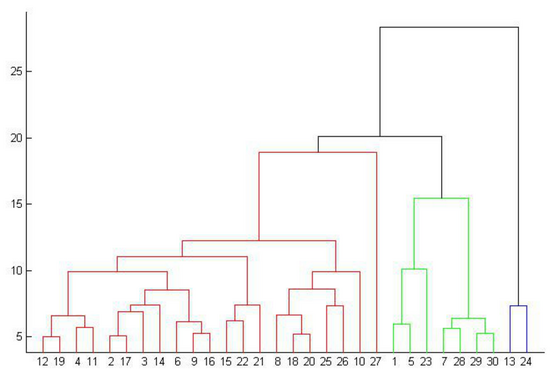
创建这样一棵树的方法有自底向上和自顶向下两种方式。

下面介绍一下如何利用自底向上的方式的构造这样一棵树:

为了便于说明,假设我们有5条数据,对这5条数据构造一棵这样的树,如下是5条数据:
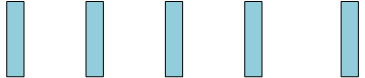
第一步,计算两两样本之间相似度,然后找到最相似两条数据(假设1、2两个最相似),然后将其merge起来,成为1条数据:
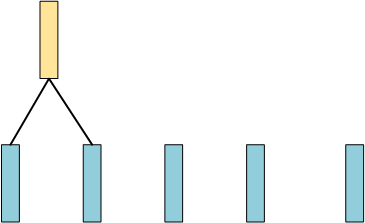
现在数据还剩4条,然后同样计算两两之间的相似度,找出最相似的两条数据(假设前两条最相似),然后再merge起来:
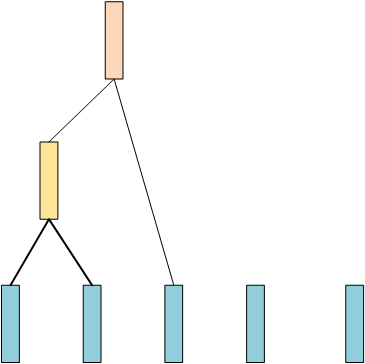
现在还剩余3条数据,然后继续重复上面的步骤,假设后面两条数据最相似,那么:
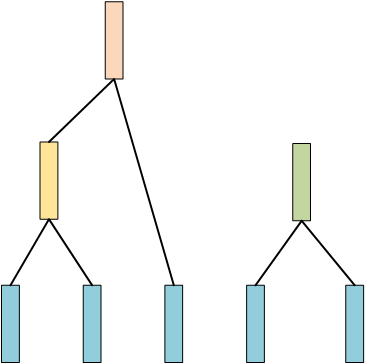
然后还剩余两条数据,再把这两条数据merge起来,最终完成一个树的构建:
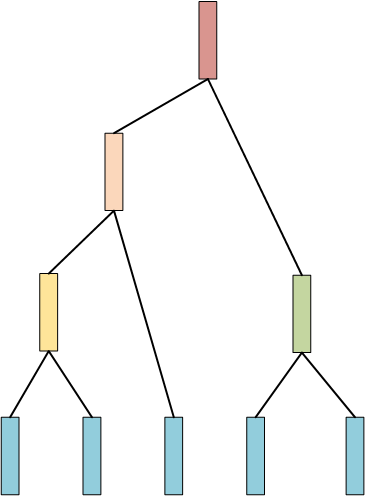
上述就是自底向上聚类树的构建过程,自顶向下的过程与之相似,只不过初始数据是一个类别,不断分裂出距离最远的那个点,知道所有的点都成为叶子结点。

那么我们如何根据这棵树进行聚类呢?

我们从树的中间部分切一刀,像下面这样:

然后叶子节点被分成两个类别,也可以像下面这样切:
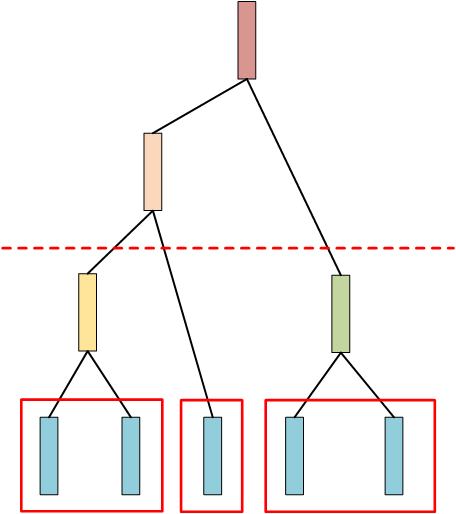
那么样本集就被分成3个类别。 这个切割的线是由一个阈值“threshold”来决定切在什么位置,而这个阈值是需要预先给定的 。

但在实做过程中,往往不需要先构建一棵树,再去进行切分,注意看上面切分,切完后,所剩余的节点数量就是类别个数。

那么在 建树的过程中,当达到所指定的类别后,则就可以停止树的建立了 。

下面看一下HAC(自底向上)的实现过程:

import math
import numpy as np


def euler_distance(point1, point2):
    distance = 0.0
    for a, b in zip(point1, point2):
        distance += math.pow(a-b, 2)
    return math.sqrt(distance)


# 定义聚类树的节点
class ClusterNode:
    def __init__(self, vec, left=None, right=None, distance=-1, id=None, count=1):
        """
        vec: 保存两个数据merge后新的中心
        left: 左节点
        right: 右节点
        distance: 两个节点的距离
        id: 保存哪个节点是计算过的
        count: 这个节点的叶子节点个数
        """
        self.vec = vec
        self.left = left
        self.right = right
        self.distance = distance
        self.id = id
        self.count = count


# 层次聚类的类
# 不同于文中所说的先构建树,再进行切分,而是直接根据所需类别数目,聚到满足条件的节点数量即停止
# 和k-means一样,也需要指定类别数量
class Hierarchical:
    def __init__(self, k=1):
        assert k > 0
        self.k = k
        self.labels = None

    def fit(self, x):
        # 初始化节点各位等于数据的个数
        nodes = [ClusterNode(vec=v, id=i) for i, v in enumerate(x)]
        distance = {}
        point_num, feature_num = np.shape(x)
        self.labels = [-1] * point_num
        currentclustid = -1
        while len(nodes) > self.k:
            min_dist = np.inf
            # 当前节点的个数
            nodes_len = len(nodes)
            # 最相似的两个类别
            closest_part = None
            # 当前节点中两两距离计算,找出最近的两个节点
  
聚类分析|基于层次的聚类方法及其Python实现 层次聚类(Hierarchical Clustering)类似于一个树状结构,对数据集采用某种方法逐层地进行分解或者汇聚,直到分出的最后一层的所有类别数据满足要求为止。 当数据集不知道应该分为多少类时,使用层次聚类比较适合。 无论是凝聚方法还是分裂方法,一个核心问题是度量两个簇之间的距离,其中每个簇是一个数据样本集合。 阅读详情

相关推荐

层次聚类算法及通过python的scipy进行计算

层次聚类算法及通过sklearn调用方式

weixin_46713695的博客 1389

无监督学习 原理与代码实例讲解

机器学习是人工智能的一个分支,其核心目标是让计算机系统能够从数据中学习,并利用学习到的知识来解决实际问题。学习算法从带有标签的训练数据中学习,建立输入和输出之间的映射关系,用于预测新的未标记数据。学习算法从没有标签的训练数据中学习,探索数据的内在结构和规律,例如聚类、降维等。学习算法通过与环境的交互,根据环境的反馈来调整自身的行为,以最大化累积奖励。

AI天才研究院 673

Python之层次聚类/系统聚类(Hierarchical Clustering)、变量聚类

本文介绍了层次聚类/系统聚类、变量聚类的基本原理,以及对应的python代码

whY的笔记 2938

Python实现简单层次聚类算法以及可视化

主要为大家详细介绍了Python实现简单层次聚类算法以及可视化,具有一定的参考价值,感兴趣的小伙伴们可以参考一下

嵌入式开发也玩“全家桶”?手把手教你用CLion+PyOCD调试APM32,比OpenOCD更简单

本文详细介绍了如何使用CLion和PyOCD组合进行APM32嵌入式开发,提供从环境配置到实战调试的完整指南。相比传统工具如Keil和OpenOCD,这套方案更轻量、易用,特别适合现代开发者需求,涵盖CMake配置、PyOCD调试技巧及常见问题解决。

weixin_42543046的博客 463

【NLP】语言模型的发展历程 (1)

N-gram模型是一种基于统计语言模型的文本分析算法,它用于预测文本中下一个词出现的概率,基于前面出现的n-1个词的序列。这里的n代表序列中元素的数量,因此称为N-gram。Unigram:N=1,每个单词的出现概率独立计算,不考虑上下文。Bigram:N=2,基于前一个单词预测当前单词的联合概率模型。Trigram:N=3,考虑前两个单词来预测当前单词的联合概率模型,更复杂但可能更准确。

酒酿小圆子呀~ 1667

Pytorch中CrossEntropyLoss()详解

交叉熵主要是用来判定实际的输出与期望的输出的接近程度。举个例子:在做分类训练的时候,如果一个样本属于第 K 类,那么这个类别所对应的输出节点的输出值应该为1,而其他节点的输出都为0,即 [0,0,1,0,….0,0] ,这个数组也就是样本的 Label,是神经网络最期望的输出结果。我们用交叉熵损失函数来衡量网络的实际输出与正确标签的差异,利用这种差异经过反向传播去更新网络参数。交叉熵:它主要刻画的是实际输出(概率)与期望输出(概率)的距离,也就是交叉熵的值越小,两个概率分布就越接近。

flyingluohaipeng的博客 3861

从CORDIC到DDS:手把手拆解《Verilog传奇》第9章的实战项目(附可跑通的代码)

本文详细解析了如何从CORDIC算法到DDS系统的完整实现过程,基于《Verilog传奇》第9章的实战项目,提供了可运行的Verilog代码。内容涵盖CORDIC算法的硬件实现、DDS系统架构设计、完整系统集成与验证,以及实际部署中的性能调优技巧,适合数字IC和FPGA开发者深入学习。

weixin_42623010的博客 413

GROMACS新手必看:从PDB文件到完整分子动力学模拟的保姆级教程

本文提供GROMACS分子动力学模拟的保姆级教程,从PDB文件处理到完整模拟流程全覆盖。详细讲解结构预处理、系统构建、能量最小化、生产模拟等关键步骤,并分享性能优化和结果分析技巧,帮助新手快速掌握分子动力学模拟的核心操作。

yhn456789的博客 761

别再只看图了!代谢组学OPLS-DA分析,R2Y和Q2Y到底怎么看才不踩坑?

本文深入解析代谢组学OPLS-DA分析中的关键指标R2Y和Q2Y,揭示如何避免过拟合陷阱。通过详细解读模型解释能力(R2Y)和预测能力(Q2Y),结合置换检验方法,提供完整的模型评估流程与实战建议,帮助研究者获得可靠的分析结果。

weixin_42638178的博客 194

从SPI协议到文件系统:手把手教你用HAL库给W25Q16移植FATFS(附扇区管理优化方案)

本文详细介绍了如何在STM32平台上,通过HAL库的SPI接口为W25Q16 Flash芯片移植FATFS文件系统。文章从SPI通信基础讲起,深入解析了FATFS底层驱动(diskio.c)的移植要点,并重点探讨了针对W25Q16的4KB物理扇区特性进行扇区管理优化的两种方案,旨在帮助开发者构建稳定高效的文件存储方案。

happy2的博客 1043

YOLOV26详解 从原理到部署

计算机视觉领域最具影响力的目标检测框架迎来重大里程碑。2026年1月,Ultralytics 正式发布 YOLOv26——这不是一次简单的版本迭代,而是一场面向边缘计算时代的架构重构。本专栏基于 Ultralytics 官方技术白皮书、YOLO Vision 2025 大会首发内容及国际前沿研究成果,系统拆解 YOLOv26 从算法原理到工程落地的全栈技术体系。与常规教程不同,我们聚焦与,帮助你在端侧 AI 部署的实战中掌握核心竞争力。

u012133341的博客 2011

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: 17个常见的Python运行时错误,你中招了没?
下一篇: 快圣诞节了,用Python 送你一棵圣诞树
Python_xiaowu
博客等级 码龄5年 3096粉丝 178原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
