Python爬取漫画(详细教程)

python网络爬虫最细致讲解之漫画抓取【细!!!】 漫画抓取:python网络爬虫与html对应结合抓取讲解 文章目录漫画抓取:python网络爬虫与html对应结合抓取讲解前言一、实现目的二、开始旅程1.明确思路2.下载网页3.寻找下载漫画4.完整代码附上5.运行结果附上三、总结 前言 本次以漫画抓取为例,来一步一步结合浏览器后台与爬虫编程讲解,也可以延伸到应对其他不同的网页抓取 一、实现目的 首先说明一下本次抓取的网站:XKCD, 是一个流行的极客漫画网站。 首页url:http://xkcd.com/ 但是其中的重点在于:它有一个“Prev 阅读详情
AI摘要

本文介绍使用Python爬虫技术抓取在线漫画的方法。从环境搭建到代码实现,详细解析如何模拟浏览器行为,定位并下载漫画图片。

在这里插入图片描述

最近学了一点点python爬虫的知识,面向百度编程爬了一本小说之后感觉有点不满足,于是突发奇想尝试爬一本漫画下来看看。

一、效果展示

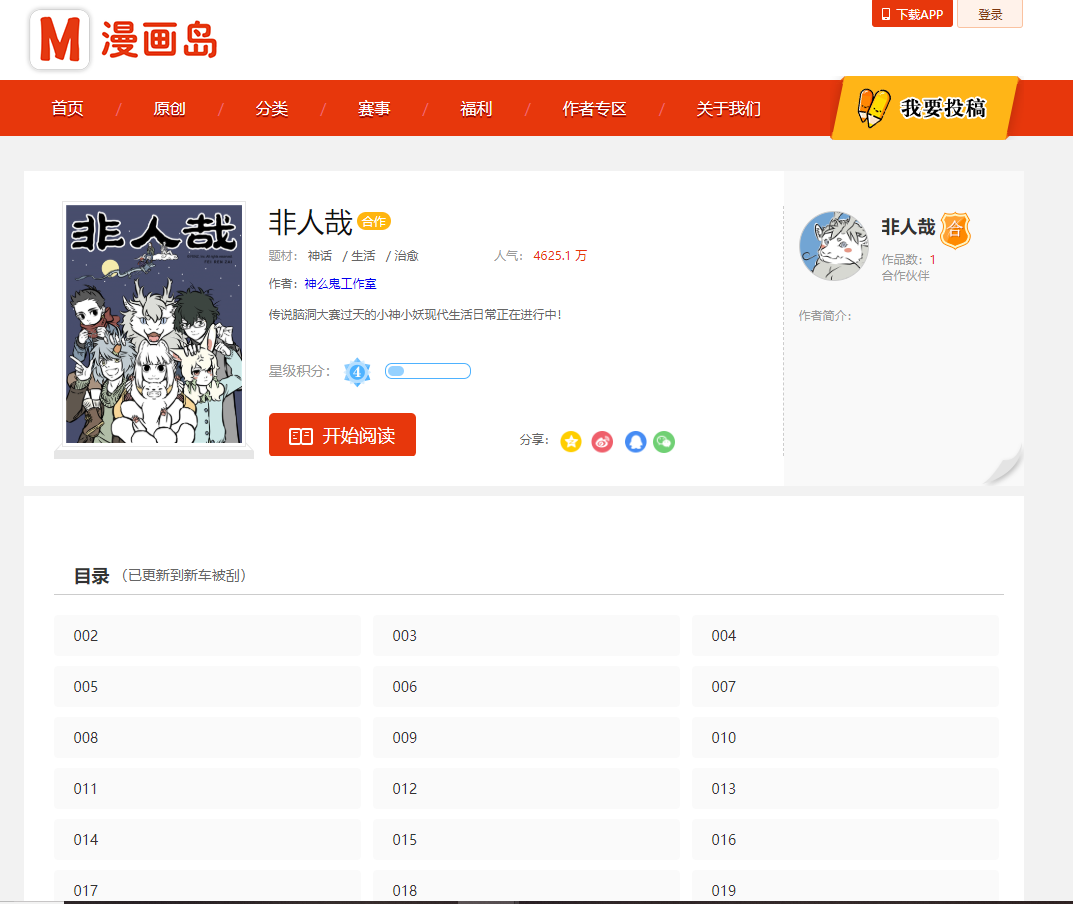
首先是我们想要爬取的漫画网页: http://www.manhuadao.cn/

网页截图:
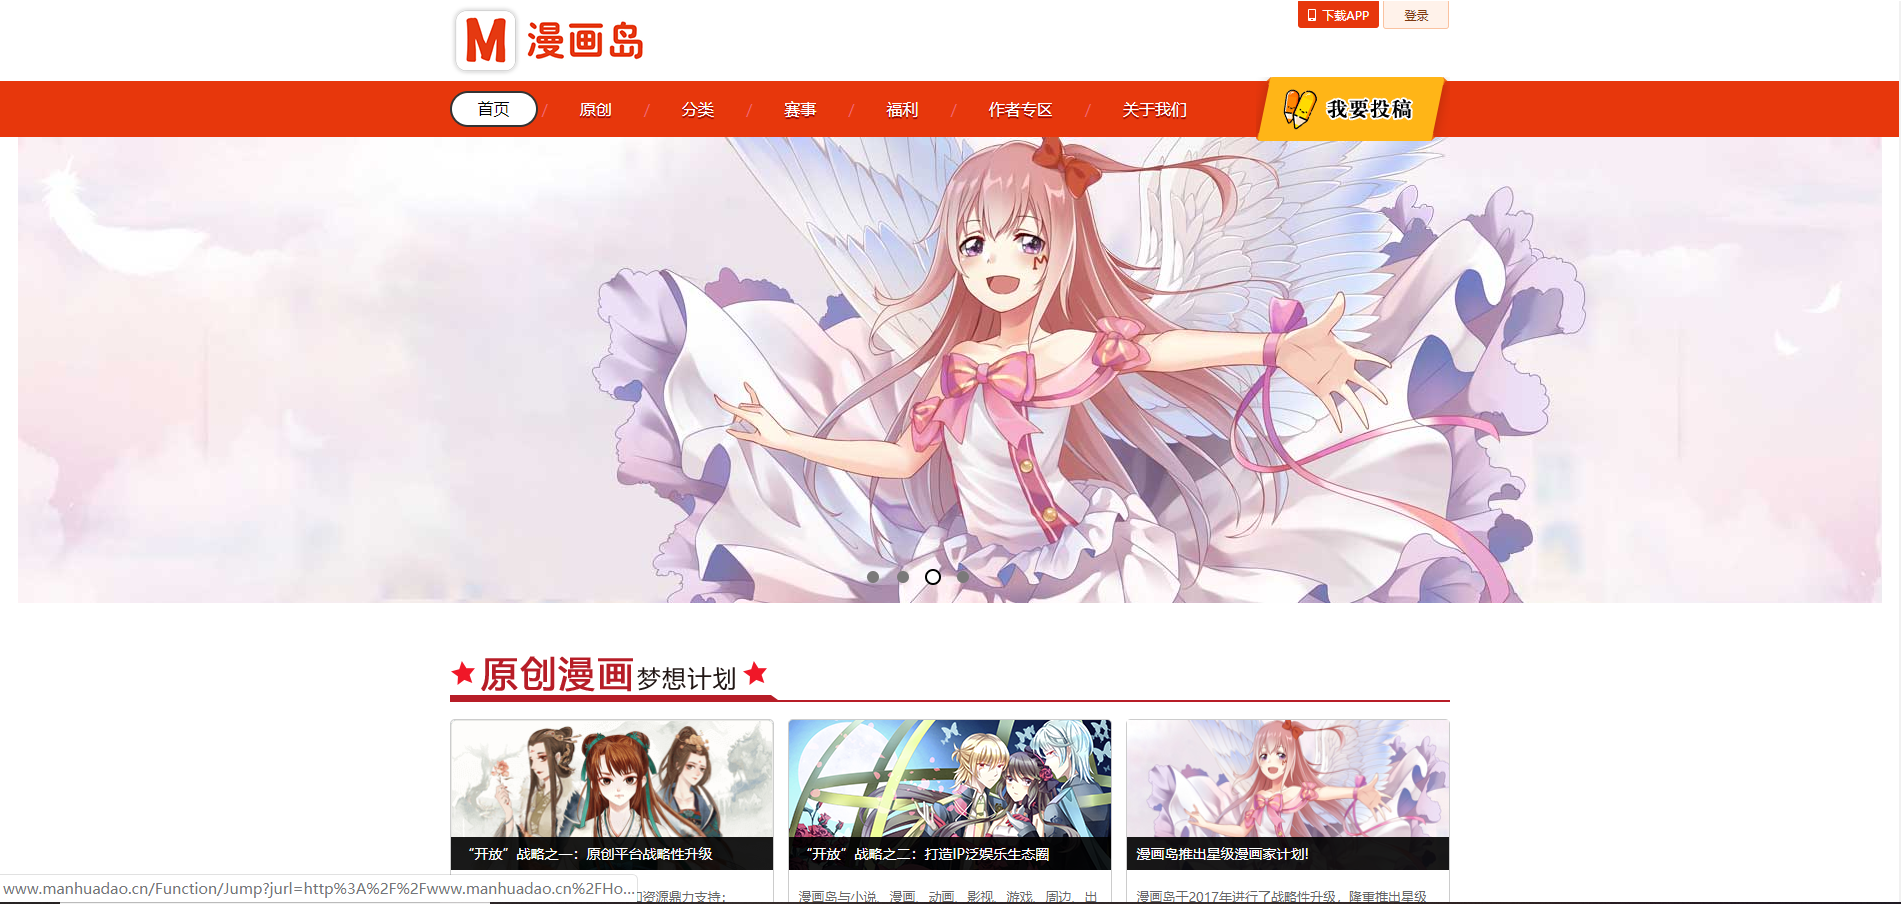
     其次是爬取下来的效果:
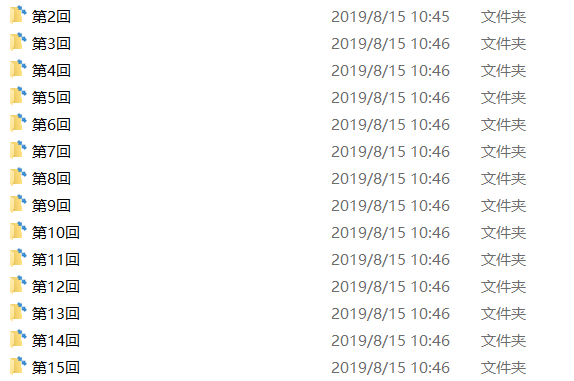
     ![](https://img-blog.csdnimg.cn/img_convert/c86eca45085aeeb6ebe630f5ed7ac290.png)

    每一回的文件夹里面是这样的:  (因为网站图片的问题...所以就成了这个鬼样子)
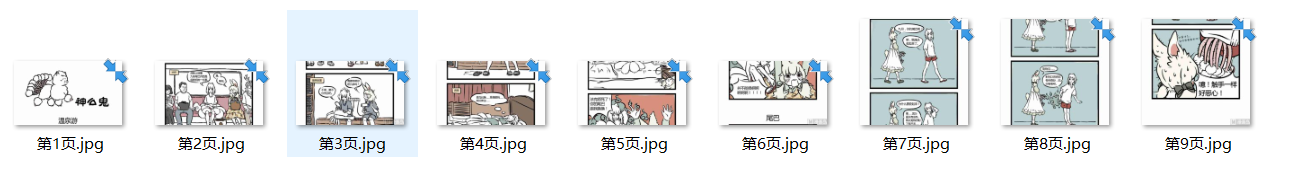
      ![](https://img-blog.csdnimg.cn/img_convert/836d5503eb33b892b6ea79c3562d6ccd.png)

二、分析原理

 1、准备:需要vscode或者其他能够编译运行python的软件,推荐python版本3.X ,否则有可能出现编译问题。

下载所需模块:win+R 进入命令行, 输入 pip install <模块名> 即可下载。例如:

pip install beautifulsoup4
   2、原理: 模拟浏览器点击->打开漫画网页链接->获取网页源码->定位每一章漫画的链接->模拟点击->获取图片页面源码->定位图片链接->下载图片

三、实际操作(代码附在最后)

1、引入模块 (这里不再详述)
2、模拟浏览器访问网页
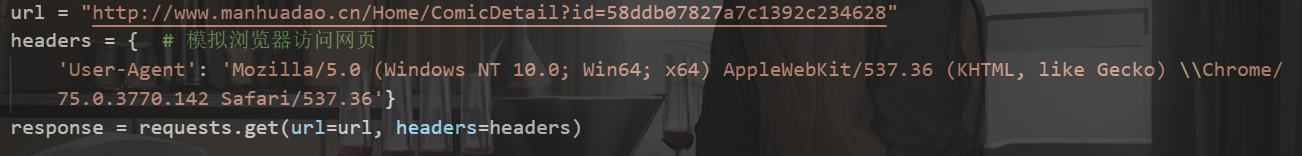
(1)、 这里我们打开漫画的目录页,如下: url = ”http://www.manhuadao.cn/Home/ComicDetail?id=58ddb07827a7c1392c234628“ ,此链接就是目录页链接。
                 ![](https://img2018.cnblogs.com/blog/1769790/201908/1769790-20190815192144415-2081526072.png)

(2)、按F12打开此网页的源码(谷歌浏览器),选中上方NetWork,Ctrl+R刷新。
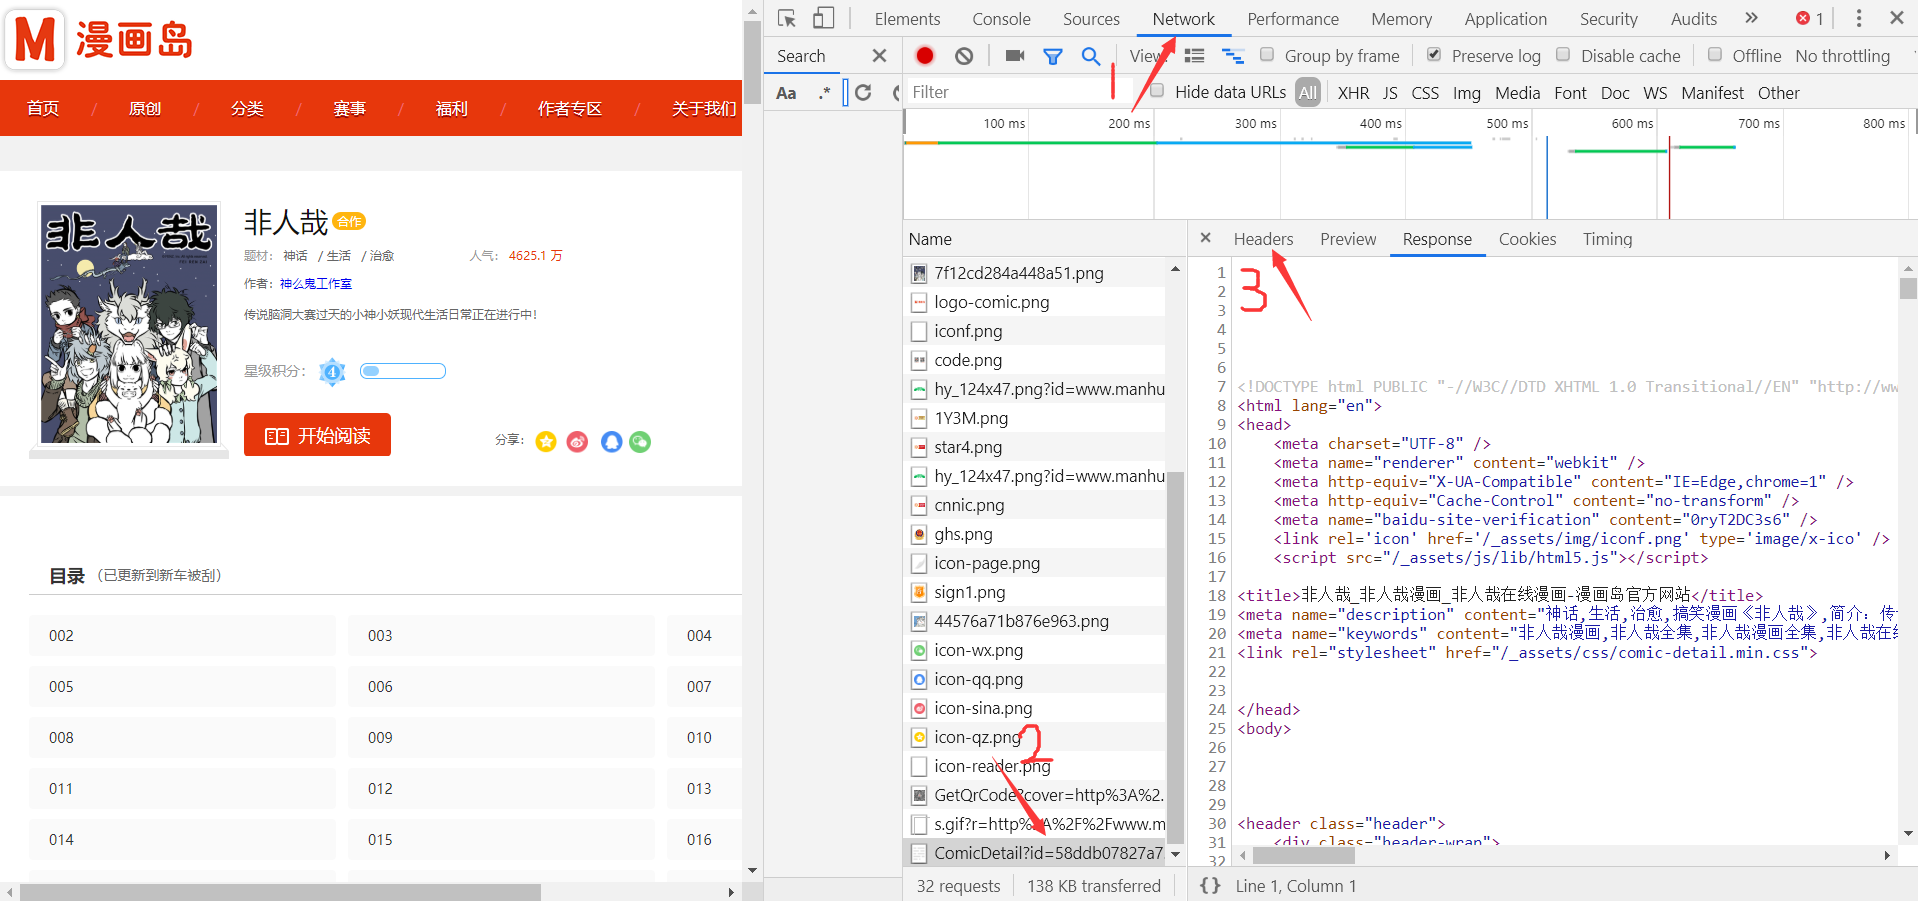
                 ![](https://img2018.cnblogs.com/blog/1769790/201908/1769790-20190815193118846-1527490915.png)

(3)、找到加载网页的源码文件,点击Headers,如下图: Status Code表示网页返回的代码,值为200时表示访问成功。
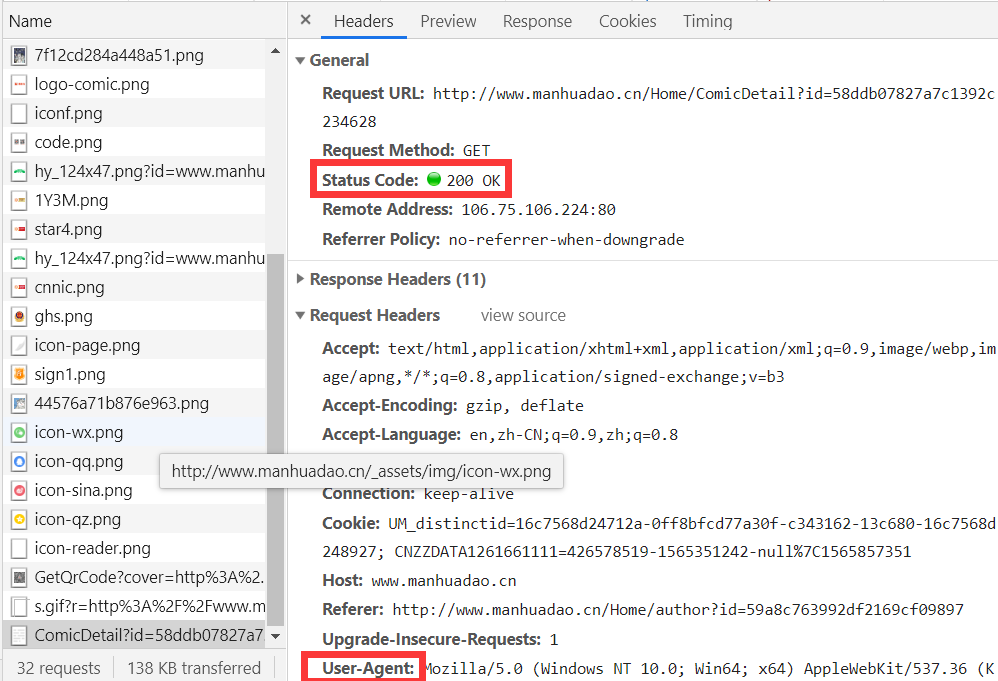
(4)、headers中的参数为下面红框User-Agent。

response = requests.get(url=url, headers=headers)  # 模拟访问网页
print(response)  # 此处应输出   <Response \[200\]>
print(response.text)   # 输出网页源码

两个输出分别输出:
输出返回200表示访问成功。
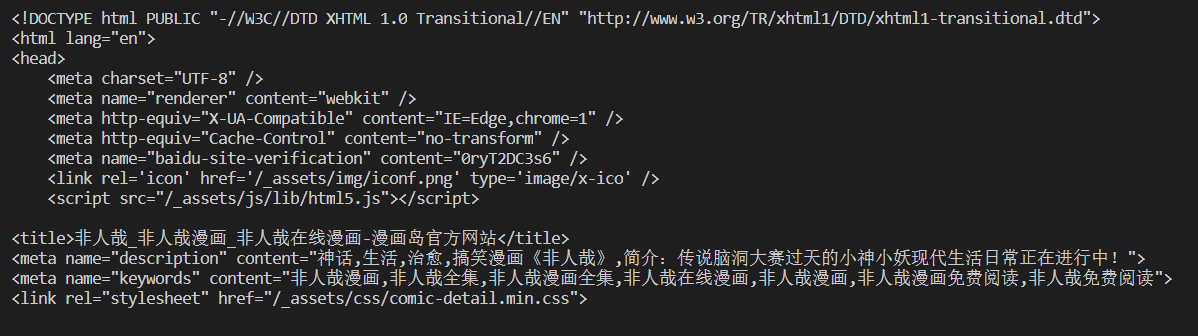
(节选)

(5)、将html代码存入 data 中,xpath定位每一章链接。点击上方Element,点击:
将鼠标移至目录处:
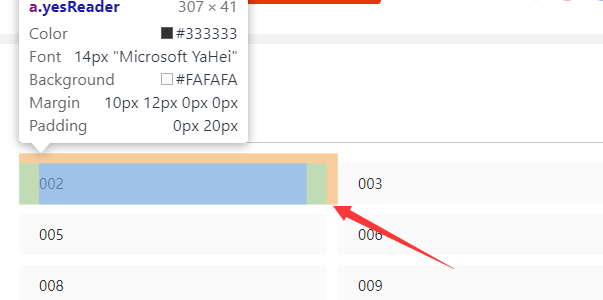
右边代码区域出现每一章链接:
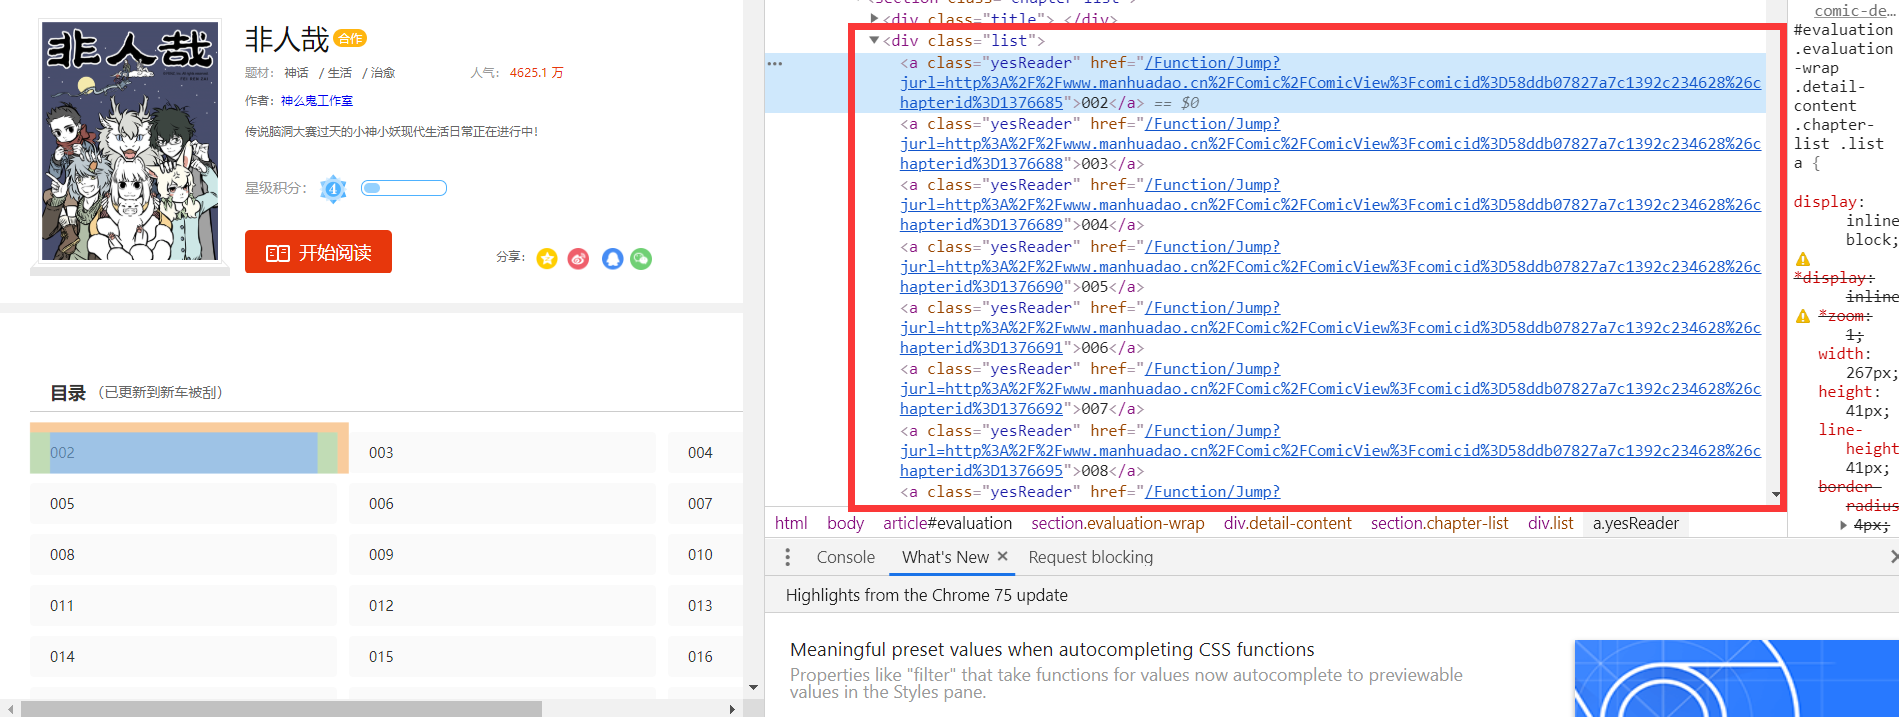
     ![](https://img2018.cnblogs.com/blog/1769790/201908/1769790-20190815210248133-1639770304.png)
data = etree.HTML(response.text)
# tp = data.xpath('//ul\[@class="read-chapter"\]/li/a\[@class="active"\]/@href')
tp = data.xpath('//\*\[@class="yesReader"\]/@href')
zhang\_list = tp   # tp为链接列表
            输出zhang\_list,结果如下:
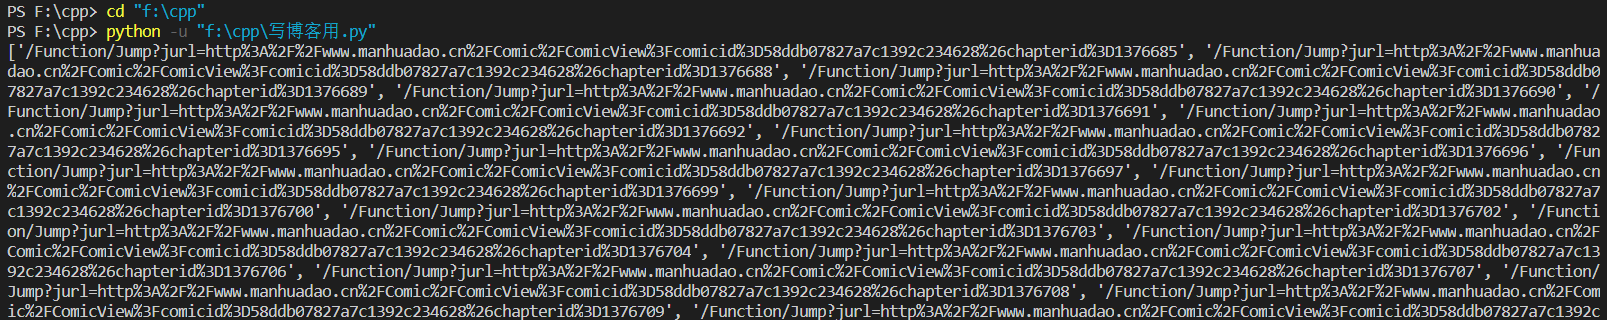
       ![](https://img2018.cnblogs.com/blog/1769790/201908/1769790-20190815195620447-2088650887.png)

(6)、获取图片链接(获取方式同上一步)

点进第一章,同上一步,寻找到图片链接:
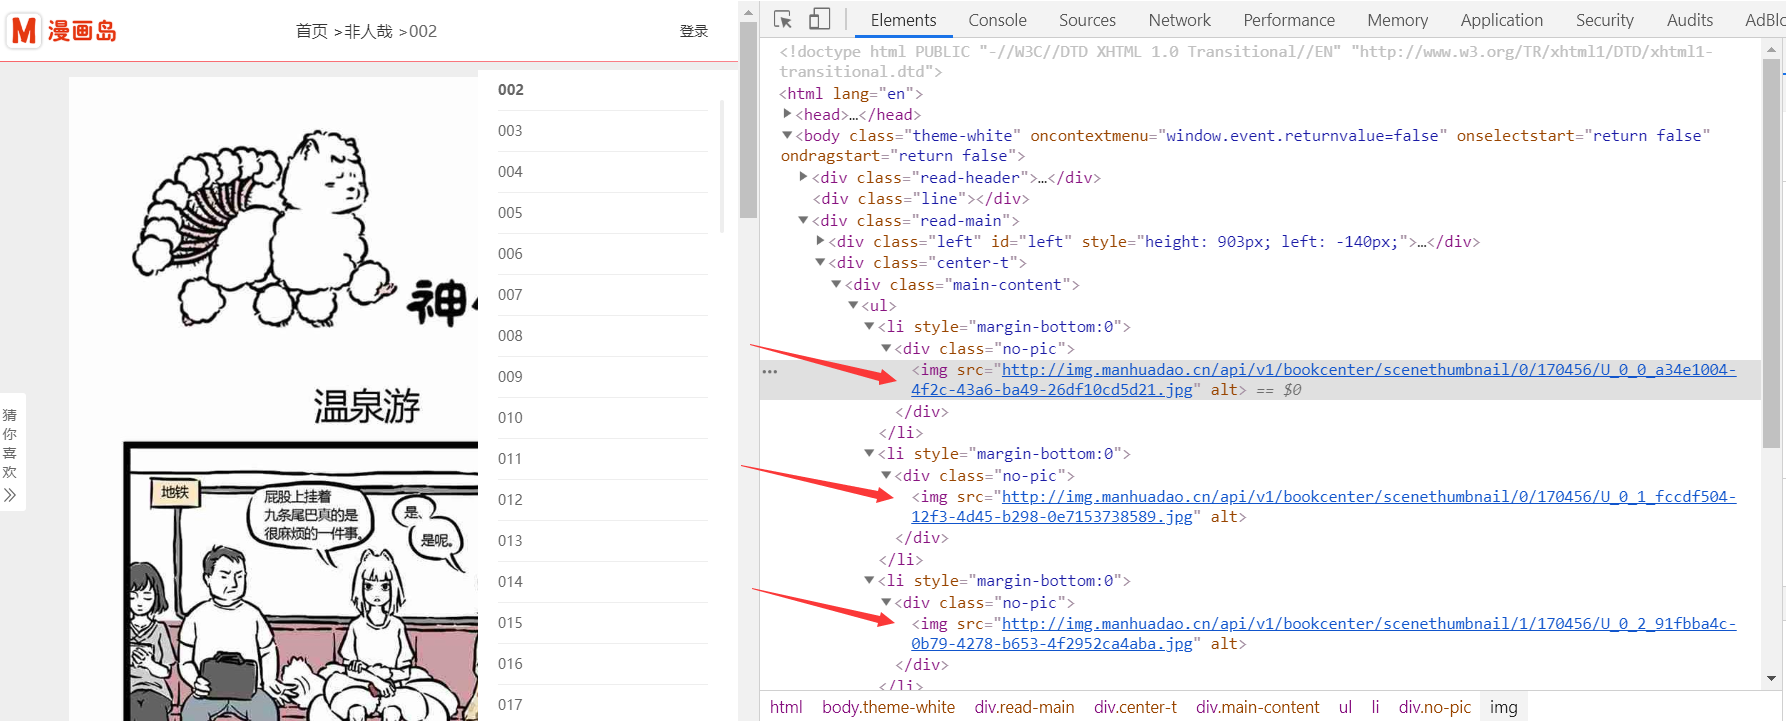
      ![](https://img2018.cnblogs.com/blog/1769790/201908/1769790-20190815210847208-1074894486.png)
 1 i=1
 2 for next\_zhang in zhang\_list:    # 在章节列表中循环 3     i=i+1
 4     j=0
 5     hui\_url = r\_url+next\_zhang
 6     name1 = "第"+str(i)+"回"
 7     file = 'C:/Users/wangyueke/Desktop/'+keyword+'/{}/'.format(name1)   # 创建文件夹
 8     if not os.path.exists(file): 9 os.makedirs(file)
10         print('创建文件夹:', file)
11     response = requests.get(url=hui\_url, headers=headers)    # 模拟访问每一章链接
12     data = etree.HTML(response.text)
13     # tp = data.xpath('//div\[@class="no-pic"\]//img/@src')
14     tp = data.xpath('//div\[@class="main-content"\]//ul//li//div\[@class="no-pic"\]//img/@src')   # 定位
15     ye\_list = tp

(7)、下载图片

1 for k in ye\_list:    # 在每一章的图片链接列表中循环
2     download\_url = tp\[j\]
3     print(download\_url)
4     j=j+1
5     file\_name="第"+str(j)+"页"
6     response = requests.get(url=download\_url)    # 模拟访问图片链接
7     with open(file+file\_name+".jpg","wb") as f:
8         f.write(response.content)

五、代码

 1 '''
 2 用于爬取非人哉漫画
 3 目标网址:http://www.manhuadao.cn/
 4 开始时间:2019/8/14 20:01:26
 5 完成时间:2019/8/15 11:04:56
 6 作者:kong\_gu
 7 '''
 8 import requests 9 import json
10 import time
11 import os
12 from lxml import etree
13 from bs4 import BeautifulSoup
14 
15 
16 def main():
17     keyword="非人哉"
18     file = 'E:/{}'.format(keyword)
19     if not os.path.exists(file):
20 os.mkdir(file)
21         print('创建文件夹:',file)
22     r\_url="http://www.manhuadao.cn/"
23     url = "http://www.manhuadao.cn/Home/ComicDetail?id=58ddb07827a7c1392c234628"
24     headers = {  # 模拟浏览器访问网页
25         'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) \\\\Chrome/75.0.3770.142 Safari/537.36'}
26     response = requests.get(url=url, headers=headers)
27     # print(response.text)   # 输出网页源码
28     data = etree.HTML(response.text)
29     # tp = data.xpath('//ul\[@class="read-chapter"\]/li/a\[@class="active"\]/@href')
30     tp = data.xpath('//\*\[@class="yesReader"\]/@href')
31     zhang\_list = tp
32     i=1
33     for next\_zhang in zhang\_list:
34         i=i+1
35         j=0
36         hui\_url = r\_url+next\_zhang
37         name1 = "第"+str(i)+"回"
38         file = 'C:/Users/wangyueke/Desktop/'+keyword+'/{}/'.format(name1)    # 这里需要自己设置路径
39         if not os.path.exists(file):
40 os.makedirs(file)
41             print('创建文件夹:', file)
42         response = requests.get(url=hui\_url, headers=headers)
43         data = etree.HTML(response.text)
44         # tp = data.xpath('//div\[@class="no-pic"\]//img/@src')
45         tp = data.xpath('//div\[@class="main-content"\]//ul//li//div\[@class="no-pic"\]//img/@src')
46         ye\_list = tp
47         for k in ye\_list:
48             download\_url = tp\[j\]
49             print(download\_url)
50             j=j+1
51             file\_name="第"+str(j)+"页"
52             response = requests.get(url=download\_url)
53             with open(file+file\_name+".jpg","wb") as f:
54 f.write(response.content)
55 
56 
57 if \_\_name\_\_ == '\_\_main\_\_':
58     main()

最后这里给大家免费分享一份Python学习资料,包含了视频、源码、课件,希望能够帮助到那些不满现状,想提示自己却又没用方向的朋友,也可以和我一起来交流呀!

编辑资料、学习路线图、源代码、软件安装包等!【点击这里】领取!
在这里插入图片描述

用python爬取漫画! Hi~ 大家好! 今日教大家用Python爬取某网站的全部漫画,让你想看什么漫画就看什么漫画!本文代码量有的多,请耐心看完!如果不想看分析网页,可拉取到爬取思路和实现代码区域,查看基本思路和代码!经过作者测试,测试过的漫画都可以下载!本文图片以及文本仅供学习、交流使用,要想获得更好的体验,请支持正版! 本文完整代码见文末! 分析网页 受害者: https://www.kanman.com/sort/ 漫画其实是一张一张图片来着,所以我们先找到这些图片的链接在哪里!因为本文是为了实现想看什么漫画就爬取什么漫 阅读详情

相关推荐

用python爬取漫画,代入感太强了

导语: 哈喽,哈喽~当有人给你安利了一部超级好看的漫画时。 你点进去看了一下,这画风,这剧情,代入感太强我现在宣布我就是女主了。 但是看着看着,要vip你又没有,这是什么人间疾苦啊!我的女主光环呢? 正文: 下面小编使用python爬取漫画,此次代码以一个小型的网站来作为练手,其他的和该思路差不多大致相同,仅供参考。 https://m.gufengmh8.com/ 打开这个网址后,让我们点击搜索进行相关的漫画搜索。截图为搜索页面,可以看到网址为: https:/..

a55656aq的博客 4666

Python爬取腾讯动漫全站漫画详细教程(附带源码)

前言 本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。 作者:merlin& 操作环境 编译器:pycharm社区版 python 版本:anaconda python3.7.4 浏览器选择:Google浏览器 需要用到的第三方模块:requests , lxml , selenium , time , bs4,os 网页分析 明确目标 首先我们打开腾讯动漫首页,分析要抓取的目标漫画。 找到腾讯动漫的漫画目录页,简单看了一

人生苦短, 还不用Python? 1万+

2024年Python最新Python爬取腾讯动漫全站漫画详细教程(附带源码)(1),2024年最新Python音频面试题

不知道你们用的什么环境,我一般都是用的Python3.6环境和pycharm解释器,没有软件,或者没有资料,没人解答问题,都可以免费领取(包括今天的代码),过几天我还会做个视频教程出来,有需要也可以领取~给大家准备的学习资料包括但不限于:Python 环境、pycharm编辑器/永久激活/翻译插件python 零基础视频教程Python 界面开发实战教程Python 爬虫实战教程Python 数据分析实战教程python 游戏开发实战教程Python 电子书100本。

2401_84572787的博客 889

关于用python爬虫白嫖漫画这档子事

python使用selenium和requests爬取漫画

qq_35754154的博客 2796

Python爬虫基础教程(93)Selenium&PhantomJS实战:漫画爬虫之爬虫代码:深度分析Python爬虫:Selenium与PhantomJS让漫画爬取So Easy!

在碎片化的时间里,看看漫画是很多人的放松方式。但一本漫画上百话,一话一页地点开下载,简直能让人崩溃。作为一名Python爱好者,当然要让代码来解决这个重复劳动!今天,就带你用Selenium+PhantomJS打造一个漫画爬虫,让收割漫画就像翻书一样简单。

jxf_jxfcsdn的博客 1391

2022年适合初学者的Python书籍推荐

一、前言 2022学Python有哪些高效的方法? 网上有很多书或者视频,种类繁多该怎么选择? 看书全是文字看就了眼睛累,也容易厌倦,看视频有时候又觉得讲的慢,有其他方案吗? 其实,关于自学python,找一本浅显易懂,例程比较好的教程,从头到尾看下去。不要看很多本,专注于一本。把里面的例程都手打一遍,搞懂为什么即可。 这是我最近在看的一本书《看漫画学Python 全彩版》刚好解决了上面的两个问题,通过漫画的方式传授、教学python,让学Python变得不再枯燥: 二、作者简介 关东升 一个在IT领域

m0_60765379的博客 5453

python爬取收费漫画_python爬取收费漫画_Python爬虫,爬取腾讯漫画实战

先上个爬取的结果图最后的结果为每部漫画按章节保存运行环境ide vs2019python3.7chrome、chromedriverchrome和chromedriver的版本需要相互对应先上代码,代码非常简短,包含空行也才50行,多亏了python强大的库import osimport timeimport requestsfrom selenium import webdriverfrom l...

weixin_28810909的博客 1005

无加密实战!Python爬虫爬取漫画网站:自动下载整话高清图片,一键合并PDF离线阅读(2026保姆级教程)

HTML/JSON混合解析技巧。文件流处理与PDF合成技术。反爬虫对抗的基础(Headers, Referer, Delay)。健壮性设计(重试、异常处理)。进阶方向GUI界面:使用Tkinter或PyQt做一个图形界面,输入URL点按钮即可下载。自动推送:下载完成后,自动通过邮件或微信推送到你的Kindle/手机。图像增强:在生成PDF前,使用OpenCV对漫画进行去噪、锐化或超分辨率处理,提升老漫画画质。现在,你可以合法合规地建立自己的离线漫画库,在飞机上、高铁上随时享受阅读乐趣了!

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1890

python网页爬虫菜鸟教程_Python爬虫实战教程——爬取xkcd漫画

0 前言Python版本:3.7.0开发工具:IDLE(Python 3.7 64-bit)、Google Chrome1 网络爬虫(web crawler)?网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取网络信息的程序或者脚本。 ——百度百科简单点,网络爬虫是我们编写的自动从网络上抓取对我们有用的信息的程序2 必备HTML、CSS知识一个基本的网页-example.h...

weixin_39774490的博客 182

漫画

Buscador de comics 在ADA ITW网站上创建并维护您的网站。 HTML5-CSS3-JavaSacript-Sass-API-Diseñoresponsivo 漫画发现者 这是我在ADA ITW的Web开发课程中执行的一个项目。 HTML5-CSS3-JavaScript-Sass-API-自适应设计

Holtek BS45F3833芯片深度剖析:如何用高集成MCU重塑超声波雾化市场格局?

本文深度剖析Holtek BS45F3833芯片如何通过高集成MCU技术重塑超声波雾化市场。该芯片集成了PWM直驱、电容检水、触摸控制等核心功能,显著提升雾化精度和效率,同时降低BOM成本和开发难度。文章通过实测数据和实战案例,展示了其在香薰机、车载设备及工业加湿器等场景的创新应用,为开发者提供了一站式解决方案。

weixin_29192211的博客 413

2024年Python最全Python爬取腾讯动漫全站漫画详细教程(附带源码),2024年最新面试官的灵魂拷问

如果你也是看准了Python,想自学Python,在这里为大家准备了丰厚的免费大礼包,带大家一起学习,给大家剖析Python兼职、就业行情前景的这些事儿。

2301_82243733的博客 1177

保姆级教程:在Ubuntu 20.04上从源码编译Apollo自动驾驶平台(含GPU环境配置)

本文提供了一份详细的Ubuntu 20.04上从源码编译Apollo自动驾驶平台的保姆级教程,包括GPU环境配置、Docker部署和编译构建等关键步骤。通过实战经验和避坑指南,帮助开发者高效完成Apollo平台的编译和验证,适用于自动驾驶技术研究和应用开发。

weixin_30876945的博客 409

网不好,看个漫画加载半天?教你用Python批量下载网站所有漫画(附源码和视频教程)

回老家去了,显得无聊上网看个小漫画,不是那种你们想的~ 结果真的是移不动联不通信不过了,不是一格信号就是无信号,4G变2G了,搞心态! 没办法,只能连夜跑去网吧编程,用Python直接把整个网站的漫画都给爬下来传手机上了。 哎,这回我就不慌了~ 还好我爬的是正经的漫画,不然后面一堆人,在网吧敲代码,真是有点特立独行了。 我回来之后,把这个做了个视频版教程,大家有需要的可以直接在文末拿,我直接把视频链接发出来了~ 好了,简单的介绍下我们今天的内容叭~ 首先咱们用的是这些环境 Python3.6

人生苦短, 还不用Python? 1777

Zynq UltraScale+ RFSoC实战:用XCZU49DR开发板实现雷达信号处理全流程

本文详细介绍了如何利用Xilinx Zynq UltraScale+ RFSoC系列中的XCZU49DR开发板,高效实现雷达信号处理全流程。文章深入剖析了该芯片集成的射频直采ADC/DAC、可编程逻辑与Arm多核处理器的异构计算优势,并通过实战案例展示了从环境搭建、硬件链路设计到软件优化的完整开发路径,为相控阵雷达等高性能应用提供了单芯片解决方案。

weixin_29291863的博客 578

立创开源TinyAWG:基于ZYNQ7010的35MHz带宽200MSa/s任意波形发生器设计与实现

本文详细解析了立创开源TinyAWG的设计与实现,这是一款基于ZYNQ7010芯片的低成本高性能任意波形发生器。项目实现了35MHz带宽和200MSa/s采样率,核心采用ARM+FPGA协同架构,FPGA负责高速DDS信号生成,ARM运行Linux并搭载LVGL图形界面。文章涵盖了硬件选型、电路设计、软件逻辑及性能测试,为复刻和学习ZYNQ系统设计、高速DAC应用提供了完整参考。

weixin_42576467的博客 434

一分钟教会你如何用Python爬取图片,学到就是赚到!

如果你想学习Python帮助你实现自动化办公,或者准备学习Python或者正在学习,下面这些你应该能用得上,有需要可以领取。① Python所有方向的学习路线图,清楚各个方向要学什么东西② 100多节Python课程视频,涵盖必备基础、爬虫和数据分析③ 100多个Python实战案例,学习不再是只会理论④ 华为出品独家Python漫画教程,手机也能学习⑤历年互联网企业Python面试真题,复习时非常方便文末有领取方式哦。

m0_48891301的博客 4007

一文学会Cadence Sigrity PDN仿真——硬件新手小白都能看懂的保姆级教程

电源完整性的仿真,实际上是在仿真以及优化系统中的等效串联电阻。知道了仿真以及优化的目标之后,接下来就是要弄明白这个串联电阻从哪儿来以及怎么优化。整个系统中的串联电阻实际上由三部分组成:没有相位的阻抗,有相位的容抗和感抗,得益于相位,在某个特定的频点,容抗和感抗会大小相等,相位相反而相互抵消,这时候整个系统中就剩下了阻抗,所以整个系统的串联电阻达到了一个最低值,这种现象就是----谐振。当系统处于谐振点时候,整个系统会有一个最小的串联电阻,所以第一个优化电阻的手段就是让谐振来的更频繁一点。

学习帮的博客 2万+

普通人会点Python,真香

普通人会点Python,真香!

Java_bx的博客 182

llama-factory微调qwen2.5-vl

使用llama-factory完成qwen2.5-vl微调

qq_44908396的博客 2933

1、硬件工程师笔面试真题汇总(2025版本)

答:按照使用习惯,电源指示灯用红色,信号指示灯用绿色这两种颜色的LED 灯技术最成熟,价格最便宜通孔是贯穿整个PCB 的过孔盲孔是从PCB 表层连接到内层的过孔埋孔是埋在PCB 内层的过孔。大多数PCB厂家的加工能力是这样的:大于等于8mil 的过孔可以做机械孔小于等于6mil 的过孔需要做激光孔对小于等于6mil 的微型孔,在钻孔空间不够时,允许一部分过打在PCB 焊盘上。

XU157303764的博客 2万+
上一篇: Python+Pycharm下载安装详细教程,一看就会(超详细步骤)
下一篇: Python入门必备知识总结(建议收藏再用)
Python_trys
博客等级 码龄2年 4370粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值