Agent记忆系统的主矛盾:从存储问题到上下文调度

OpenViking上下文数据库Golang集成实践 技术创新文件系统范式:将AI Agent的上下文管理从扁平向量存储提升为结构化文件系统分层检索策略:L0/L1/L2三层加载机制,减少62.1%的Token消耗记忆自迭代:会话提交触发Agent经验沉淀,实现越用越智能工程实践完整Golang实现:提供生产级可用的OpenViking客户端库企业级集成方案:涵盖文档摄入、检索、会话管理等全流程性能优化成果:检索准确率提升24.1%,响应时间减少53.3%可观测性提升可视化检索轨迹:实现检索过程的白盒化,调试效率提升77.1%全面监控指标。 阅读详情

摘要

Agent 记忆系统的核心,不是“要不要向量库”,也不是“该不该上知识图谱”。

它的主矛盾是:

持续生长的历史状态,和有限、脆弱的临场上下文之间的矛盾。

一边是越来越长的交互轨迹、工具结果、用户偏好、网页状态、代码变更和反思记录。另一边是模型一次推理能稳定使用的上下文。窗口可以变长,注意力却不会自动变准。历史越厚,噪声越重;召回越多,干扰越大。

所以,记忆系统不是存储系统的别名。它更接近一套上下文调度机制:

公式读法:记忆不是把历史全收起来,而是按任务、模型和预算挑一份可用材料。
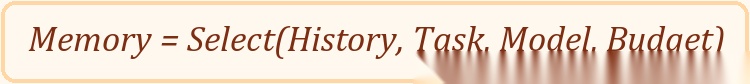
它要在具体任务、具体模型、具体预算下,把过去变成眼下可用的证据。

目录

1.主矛盾:历史增长 vs 临场上下文

2.形式化:记忆系统到底优化什么

3.六个关口:每一环都有主次

4.三类功能:事实、经验、工作

5.方法地图:论文各抓一头

6.设计原则:以场景作总裁判

一、主矛盾:历史增长 vs 临场上下文

设 Agent 的历史为 H,当前任务为 q,模型为 M,上下文预算为 B。记忆系统要做的,不是把 H 原样塞进 M,而是从 H 中构造一份可用上下文 C。

公式读法:C 是最后递给模型的那包材料。R 表示整套记忆机制。
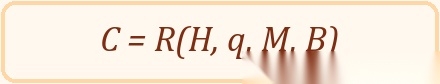
其中 R 不是简单检索。它至少包含抽取、管理、存储、检索、注入几步。

目标也不是“召回越多越好”。更准确的写法应是:

公式读法:系统要让任务收益尽量高,同时守住三个约束:别超窗口,别带太多噪声,别歪曲历史。
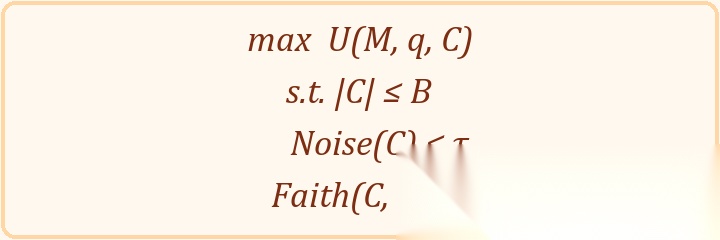
U 表示任务效用。B 是上下文预算。Noise 是噪声。Faith 是对历史的保真。

这几个量彼此牵制。召回多了,Faith 可能升,Noise 也会升。压缩狠了,B 省下来,Faith 又会掉。把记忆写成结构化事实,检索会快;细节、语气、证据链又可能断。

这便是总矛盾。

历史要求完整,推理要求择要。

《Memory in the LLM Era》把记忆系统拆为抽取、管理、存储、检索,并在 LOCOMO 与 LONGMEMEVAL 上复现十种代表方法。一个重要结论是:没有一种方法通吃。长上下文拉大后,不少方法还会掉分。问题不只是找不到,而是找来之后压不住噪声。

《Memory in the Age of AI Agents》则从形式、功能、动态三轴重看 Agent Memory。形式问记忆以什么承载;功能问记忆服务什么任务;动态问记忆如何产生、更新、保留、淘汰和取用。两篇合在一起看,一纵一横:前者给流水线,后者给坐标系。

二、形式化:记忆系统到底优化什么

把记忆系统写成一个四元组:

公式读法:这不是要造新名词,只是把系统边界框出来:抽、管、存、注入,缺一块都不像完整记忆系统。
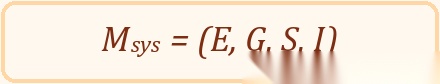
E 是 extraction,负责从轨迹中抽出候选记忆。

G 是 governance,负责更新、合并、遗忘、冲突处理。

S 是 storage,负责把记忆放成文本、向量、图、树、参数或混合形态。

I 是 injection,负责把检索结果组织成模型可吃的上下文。

一个成熟的 Agent 记忆系统,真正优化的是这条链:

History → E → G → S → Retrieve → I → Context → Action

工程上常犯的错,是把 S 当成 M_sys。

向量库只是 S 的一种。知识图谱也是 S 的一种。它们能解决一部分矛盾,不能替代整套调度。

若只谈存储,就会把主矛盾看偏。

三、六个关口:每一环都有主次
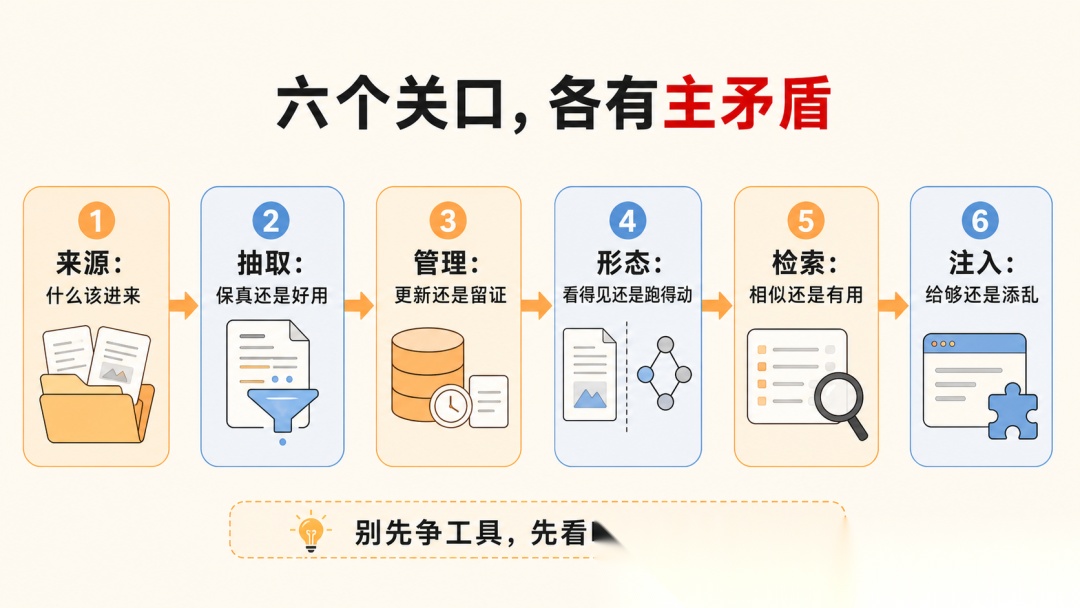
Agent 记忆系统的六个关口

总矛盾往下分,落成六个关口。每个关口都有自己的主矛盾。

关口主矛盾典型取舍
来源未来效用 vs 输入洪水什么该进记忆,什么只留在日志
抽取保真 vs 可操作原文、摘要、事实、事件、规则怎样取舍
管理更新 vs 证据保留新事实覆盖旧事实,还是版本并存
形态可解释 vs 可扩展文本、向量、图、树、参数各担哪一段
检索相似 vs 有用语义近,不等于对任务有用
注入足量 vs 干扰给少了缺证据,给多了乱推理

1. 来源:不是进得越多越好

Agent 的输入源很多。用户消息、系统提示、工具返回、网页 DOM、GUI 截图、终端日志、代码 diff、测试结果、PR 评论、多 Agent 对话,都能变成候选记忆。

来源关口的主矛盾是未来效用。

公式读法:这是一条入账规则。信息 x 的未来收益若大过保存和使用成本,就值得留下。
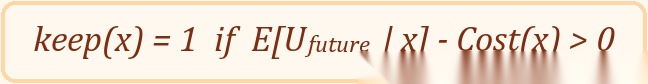
这解释了为什么个性化 Agent 重视用户偏好,编程 Agent 重视错误轨迹,网页 Agent 重视状态变化,多 Agent 系统重视责任链。来源不同,不是风格不同,是场景效用不同。

2. 抽取:不是越短越好

抽取要把轨迹变成记忆单元。可以是原文片段,可以是摘要,可以是三元组,可以是事件,可以是规则。

它的主矛盾是保真与可操作。

公式读法:抽取后的记忆 m 要同时看三项:像不像原历史,有没有用,长不长。
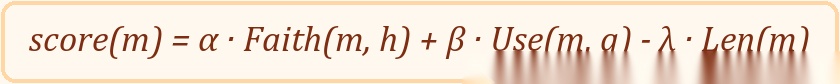
MemoryBank 把长对话炼成用户画像,并用遗忘曲线调权重。MemoChat 让模型先写 memo,再据 memo 回答。Mem0 抽取可检索的长期事实。它们都在回答同一件事:怎样把旧轨迹压成未来可用的条目。

3. 管理:不是新事实直接覆盖旧事实

长期记忆一旦进入现实场景,马上遇到冲突。

用户昨天说爱喝咖啡,今天说胃不舒服。代码仓库昨天测试失败,今天补丁已修。网页状态刚才存在,刷新后消失。

管理关口的主矛盾是更新与证据保留。

公式读法:这里分两层。当前状态要随新事件更新,原始轨迹也要留下,便于追溯和回滚。
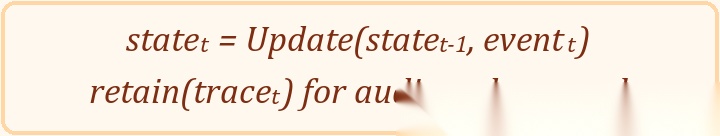
Zep / Graphiti 把事实放进时间知识图谱,让边带时间和版本。A-MEM 把新记忆写成卡片,再反向更新旧卡。Memory-R1 训练 ADD、UPDATE、DELETE、NOOP。它们都不是单纯“记住”,而是在治理记忆。

4. 形态:不是向量和图二选一

记忆形态可以分成明文、向量、图、树、参数、隐状态。

明文好审计,向量好召回,图擅长关系,树擅长层级,参数适合内化,隐状态适合短程工作。

形态关口的主矛盾是可解释与可扩展。

公式读法:这不是数学定理,而是选型准则。R 可以是文本、向量、图、树,也可以是混合结构。选哪一种,要看三笔账:成本、收益、风险。

成本包括写入、检索、维护和 token。收益包括召回、推理、解释和复用。风险包括幻觉、过期、泄漏、难审计。所谓“向量库还是知识图谱”,其实只是这条式子下面的一个分支。

MemGPT 把上下文当内存,把外部库当磁盘,让模型调页。MemoryOS 分短期、中期、长期。MemOS 用 MemCube 管内容、来源、版本和生命周期。MemTree 用树来容纳局部细节与上层摘要。它们是在重写“记忆以什么形态存在”。

5. 检索:相似不是有用

向量检索常把“语义接近”当成“任务相关”。这在短问答里尚可,在长程 Agent 里很容易失手。

检索关口的主矛盾是相似与有用。

公式读法:检索分数不能只看 sim。还要加任务收益,扣掉噪声。
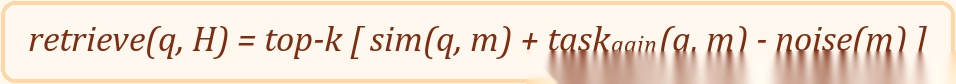
真正有效的检索,往往要混合语义相似、时间新鲜度、实体关系、任务阶段、用户目标和失败经验。图结构记忆、时间图谱、树状记忆、反思记忆,本质上都是在给检索加坐标。

6. 注入:给够,也要不扰乱

检索之后,还要注入。注入不是把结果贴上去。

它要决定顺序、格式、粒度、位置和语气。放在 system、developer、user、tool result 前后,效果并不一样。模型对 prompt 的感知也不一样。

注入关口的主矛盾是足量与干扰。

公式读法:注入要找一个格式 I。它能帮模型完成任务,又不把模型带偏。
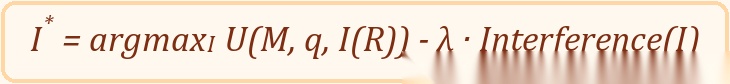
ACON 做上下文压缩,MemAgent 用固定长度记忆跨段读文档,长上下文评测不断显示:窗口大,不等于注入好。上下文工程把 memory 纳入 context engineering,正是看到这一点。

四、三类功能:事实、经验、工作

若按功能分,Agent 记忆至少有三类。

第一类是事实记忆。它回答“世界和用户现在是什么样”。用户偏好、身份、约束、承诺、实体关系都在这里。它的主矛盾是稳定与更新。

第二类是经验记忆。它回答“过去怎么做成,怎么做坏”。失败轨迹、调试经验、反思策略、工具使用套路都在这里。它的主矛盾是泛化与误导。

第三类是工作记忆。它回答“眼下这件事走到哪一步”。计划、待办、临时变量、当前页面、当前文件、当前推理状态都在这里。它的主矛盾是短暂与连贯。

三者不能混放。

公式读法:这里说的是功能分层,不是简单相加。三类记忆可以共存,但治理规则要分开。
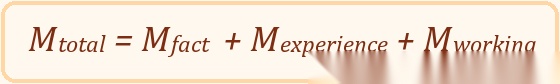
事实记忆要审计,经验记忆要抽象,工作记忆要快进快出。混在一起,检索会乱,注入会脏,更新也会失手。

五、方法地图:论文各抓一头
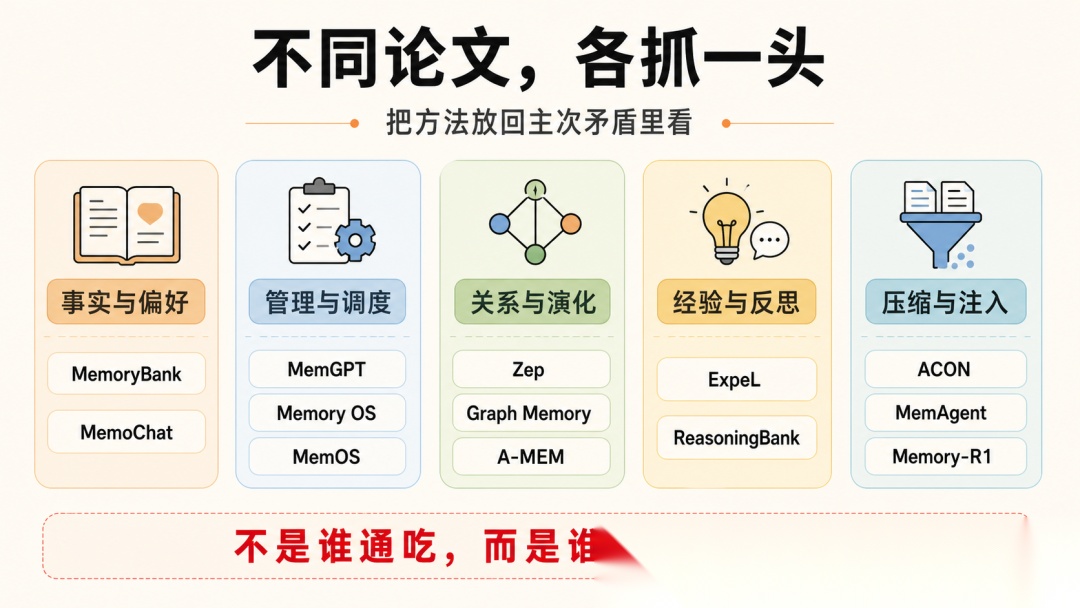
Agent 记忆论文的方法地图

把方法放回主次矛盾里看,脉络会清楚许多。

方法族抓住的关口代表方法核心动作
事实与偏好来源、抽取、更新MemoryBank, MemoChat, Mem0把对话炼成用户事实和可取 memo
管理与调度管理、注入MemGPT, MemoryOS, MemOS把记忆当系统资源调度
关系与演化形态、检索、更新Zep, Graph Memory, A-MEM用图、卡片、时间边组织关系
经验与反思抽取、泛化ExpeL, ReasoningBank从成败轨迹中炼策略
压缩与注入检索、注入ACON, MemAgent, Memory-R1学会压缩、重写、写入和删除

这张表说明一件事:

没有通吃方法,只有场景里的主矛盾。

长对话个性化,事实与偏好居先。软件工程,多轮工具轨迹和失败经验居先。网页 Agent,状态变化和环境可观测性居先。多 Agent,通信记录、责任边界和共享黑板居先。

方法不同,常不是优劣不同,而是主矛盾不同。

六、设计原则:以场景作总裁判

设计 Agent 记忆系统,不宜从组件清单开始。应先问四个问题。

第一,任务失败主要败在哪里?

是忘了用户偏好,是丢了工具结果,是找错旧证据,是上下文太吵,还是模型读不懂注入格式?

第二,哪类历史有未来效用?

不是所有日志都值得升格成记忆。能改变未来动作的,才有资格入账。

第三,记忆的证据链要不要保留?

医疗、法律、金融、代码审查,不能只留摘要。闲聊、推荐、轻量个性化,可以更重压缩。

第四,模型怎样感知 prompt?

同一条记忆,写成表格、JSON、自然语言、项目符号,放在不同位置,效果都可能变。模型变,prompt 感知也变。

一个可执行的设计式如下:

For each scenario s:  find bottleneck b_s  choose memory form R_s  choose update rule G_s  choose retrieval rule K_s  choose injection format I_s  evaluate on task outcome

这里的关键不在“选最先进方法”,而在“找准瓶颈”。

结语

Agent 记忆系统的主要矛盾,不是存储容量不够。

它是历史无限生长,临场上下文有限;世界持续变化,模型一次只能择要推理。

围绕这条主线,来源、抽取、管理、形态、检索、注入各有次级矛盾。再按功能横切,又分事实记忆、经验记忆、工作记忆。论文方法的差别,正是这些矛盾在不同场景中的投影。

最后仍要落到实践。

分类只能给坐标。公式只能给约束。真正的裁判,是任务结果。

记忆有没有用,不看名字响不响。看它是否少犯旧错,是否省 token,是否稳住长程任务,是否经得住模型和 prompt 的变动。

能经得住,才算记住。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Agent记忆与规划系统:分层存储+DAG调度实战 Agent系统中的‘记忆’并非简单缓存,而是支撑长周期任务连续性的核心基础设施;其本质是围绕任务上下文的结构化信息管理与可追溯状态维护。传统全量上下文拼接方式受限于LLM窗口长度与注意力衰减,导致规划错乱与记忆漂移。本文基于中期记忆(MTM)和显式DAG规划两大关键技术,构建物理可落盘、逻辑可审计、语义可检索的记忆体系,并通过SQLite+Chroma双模存储、任务ID隔离、依赖图调度等工程实践,解决多轮对话中实体遗忘、跨任务干扰、规划死锁等高频痛点。适用于金融、医疗等强合规场景下的生产级Agent开发。 阅读详情

相关推荐

从IDE到智能体控制台:OpenClaw与Cursor 3构建AI记忆系统实战

在人工智能与软件开发深度融合的当下,智能体(Agent)正成为提升开发效率的关键技术。其核心原理在于通过大语言模型(LLM)赋予机器理解、推理和生成代码的能力。技术的核心价值在于将开发者从繁琐、重复的编码任务中解放出来,转向更高层次的设计、架构和决策工作。为实现这一目标,让智能体具备“长期记忆”至关重要,这使其能从历史交互中持续学习,成为项目的真正协作者,而非仅能处理单次会话的临时工具。记忆系统通常基于检索增强生成(RAG)架构,通过向量数据库对历史对话、代码变更等知识进行语义化存储与检索,从而为LLM提供

weixin_33862993的博客 387

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1453

LLM智能体记忆系统:构建有认知连续性的AI助手

大语言模型(LLM)天然无状态,每次交互都是‘全新开始’,导致多轮任务断裂、个性化服务失焦、长周期项目难承接——这正是智能体记忆系统的根本出发点。其核心原理在于解耦短期记忆(工作台式实时上下文)与长期记忆(知识档案馆式语义存储),并通过上下文工程实现动态协同,从而在有限token窗口内支撑无限经验复用。技术价值体现在降低LLM落地门槛、提升任务连贯性与用户意图理解深度;典型应用场景包括客服对话延续、口播脚本自动生成、微信AI Agent开发及Wiki知识库构建。当前主流实践已从简单对话缓存,升级为融合Dif

weixin_33728708的博客 476

从Vibe Coding到可控生产力:Harness Engineering的实践启示

摘要:OpenAI提出的Harness Engineering(工程化治理)理念为AI Agent时代的软件工程提供了关键方法论,旨在解决代码高产出下的质量闭环、上下文管理等核心矛盾。其三大目标包括重构工程师角色、将AI纳入可控体系、实现低成本纠错,通过六大举措(如角色重构、机械化约束、反熵机制等)重构工程流程。该理念与vibe coding高度互补,既保留灵感驱动的敏捷性,又通过工程化体系保障稳定性,最终推动工程师从"代码生产者"升级为"工程体系设计者"。

小程故事多的博客 4403

Harness:AI Agent的工程化管家,如何应对上下文限制与生产挑战

在AI应用开发中,上下文窗口(Context Window)是模型处理信息的核心工作区,其长度限制直接影响任务复杂度与性能。面对这一瓶颈,工程实践中涌现出以工具集成、状态管理和流程编排为核心的基础设施层解决方案。这类方案通过将外部数据源、API调用和记忆系统模块化,实现按需加载与智能调度,从而在有限上下文中最大化信息利用效率。其技术价值在于提升AI系统的可靠性、可维护性和可观测性,使Agent能够专注于核心推理任务。典型的应用场景包括复杂客服工单处理、多步骤数据分析以及需要长期记忆的对话系统。本文以Harn

dieqiao8331的博客 446

用AI学习graphify

Graphify是一个AI驱动的知识图谱构建工具,能够将代码、文档、论文、图像和视频等多模态数据转换为结构化知识图谱。其核心技术特点包括: 多模态处理能力: 支持25+编程语言的AST解析 处理PDF、Markdown等文档 集成Whisper进行音视频转录 高效知识提取: 采用确定性AST解析与LLM语义提取结合 相比直接读取源文件,查询token消耗最多减少71.5倍 增量更新机制仅处理变更文件 智能分析功能: 自动识别高中心性的"上帝节点" 发现跨领域的"意外连接&quo

我的专栏 752

从零构建AI Agent记忆系统:解决上下文丢失的工程实践

在人工智能应用开发中,上下文管理是构建智能对话系统的核心挑战之一。其原理在于如何让AI模型在连续交互中保持对历史信息的感知与利用,这直接决定了系统的连贯性和实用性。从技术价值看,有效的上下文处理能显著提升用户体验,使AI助手从单轮问答工具进化为真正的协作伙伴。在实际应用场景中,无论是客服机器人、编程助手还是个性化推荐系统,都需要解决短期记忆与长期记忆的协同问题。本文聚焦于Agent记忆系统的工程化实现,通过拆解存储、编码与检索三大核心要素,提供了一套可落地的解决方案。文中详细探讨了向量数据库与语义检索的技术

weixin_34043301的博客 388

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3291

企业级Agent记忆系统架构:LangGraph与LangChain实战治理

AI Agent在真实业务中面临上下文窗口有限、历史信息难以有效利用的挑战。记忆系统不只是数据存储,更是从“记住”到“能用”的完整链路。本文从上下文管理、长期记忆写入、记忆检索、状态编排和工程治理等基础原理出发,探讨如何基于LangChain、LangGraph和DeepAgent构建企业级Agent记忆架构。结合多轮对话、工具调用等应用场景,剖析从Context到Long-term Me的设计思路,给出存储选型、异步写入、日志排查与端到端评估的实战建议,帮助开发者将Agent从Demo稳健推向生产环境。

weixin_33826609的博客 312

从DIY到实战:手把手教你搭建一个媲美吉时利2450的nA级电流源表(附原理图与避坑指南)

本文详细解析如何从零打造nA级精密电流源,涵盖核心设计原理、PCB布局技巧、热电偶效应应对及校准验证体系。通过低成本替代方案和优化设计,实现媲美商用源表的性能,特别适合硬件爱好者和独立开发者。文章还提供原理图与避坑指南,助你轻松搭建高精度电流源系统。

weixin_42656416的博客 295

ESP32水墨屏日历实战:低功耗自动更新与HTTPS数据解析

本文详细介绍了ESP32水墨屏日历项目的开发实践,重点讲解了低功耗自动更新与HTTPS数据解析的实现方法。通过ESP32的自动休眠功能和水墨屏的零功耗特性,结合HTTPS请求安全获取网络数据,实现了高效节能的桌面日历应用。项目代码开源,适合物联网开发者参考。

xx56789的博客 779

AI Agent记忆系统与数据分支:从概念到工程实现

大语言模型驱动的AI Agent在复杂任务中常面临上下文丢失、多轮对话失忆等问题,单纯依赖RAG检索增强无法解决状态管理。记忆系统作为Agent架构中的关键组件,通过区分短期记忆与长期记忆,实现对话历史、用户偏好、任务状态的分层存储。数据分支是记忆系统的核心路由机制,将不同性质的信息分流至会话、事实、语义等独立通路,确保Agent在决策时只加载最相关数据,从而降低Token成本并提升响应质量。从电商客服到企业知识库,这一设计正成为智能体落地的分水岭。oGMemory作为面向Agent的记忆管理范式,深入实践

weixin_30256901的博客 312

低功耗模式下的看门狗使用

最近用国产芯片AT32在做一个低功耗的项目,为了实现低功耗模式下的定时唤醒,我选择的是使用相对比较简单的看门狗来做,下面就分享一下使用过程~ 为了最大限度的降低功耗,我用的是待机模式,先看看几种低功耗模式以及唤醒的区别: 而看门狗AT32提供了两种,分别是独立看门狗(IWDG)和窗口看门狗(WWDG),其区别大概有以下几点: 1、独立看门狗(IWDG)由专用的低速时钟(LSI)驱动,即使主时钟发生故障它也仍然有效;窗口看门狗由从 APB1 时钟分频后得到的时钟驱动,通过可配置的时间窗口来检测应用程序非正常

dc18883988396的博客 3029

AI Agent长期记忆系统:Rust实现向量存储与智能检索

在人工智能领域,大语言模型(LLM)的上下文限制是构建实用AI Agent的主要挑战之一。其原理在于LLM本质上是无状态的,每次交互仅基于有限上下文生成响应,导致跨会话信息丢失。为解决这一问题,向量数据库和嵌入模型技术应运而生,它们通过将文本转化为高维向量并存储,实现基于语义相似性的智能检索。这项技术的核心价值在于为AI Agent提供了持久化、可扩展的记忆能力,使其能够连贯处理多轮对话和复杂任务。在实际应用场景中,这种长期记忆系统可广泛应用于智能客服、个性化助手、任务规划等需要历史信息参考的领域。本文聚焦

weixin_30367169的博客 365

iOS面试题大全(附带答案)

C语言相关面试题 1.static有什么用途? 答案:在C语言中,static主要定义全局静态变量,定义局部静态变量,定义静态函数。 static 属于静态变量,使用它修饰的变量生命周期是整个源程序。 @1.在函数体内的 static 变量的作用范围为该函数体,该变量的内存只被分配一次,因此其值在下次调用时仍维持上次的值; @2.在模块内的 static 全局变量可以被模块内所有函数访问,但不能被模块外其它函数访问; @3.在模块内的 static 函数只被这一模块内的其它函数调用,这个函数的使用范围被限

IOSNF的博客 2427

服务器测试之网卡性能调优

nvidia下载mlnx_ofed:https://network.nvidia.com/products/infiniband-drivers/linux/mlnx_ofed/intel下载驱动固件:https://www.intel.com/content/www/us/en/download-center/home.html。然而,你可以根据实际情况手动调整中断相关配置。老生常谈了,一些性能相关的设置项打开,节能的关闭,虚拟化相关的VMX/SR-IOV/IOMMU最好也都关掉。

qq_41897488的博客 4912

Agent记忆系统深度解析:从Mem0到MemOS的架构演进与实践

本文深入解析了Agent记忆系统的架构演进与实践,从Mem0到MemOS的三大框架对比与应用场景。Mem0作为通用记忆库,通过两阶段记忆引擎提升AI的连续认知能力;MemU专注于情感化记忆管理;MemOS则将记忆提升为操作系统级资源。文章结合实战案例,展示了这些框架在提升AI个性化服务和任务处理效率方面的显著效果。

zeta9的博客 390

TI DSP的 FFT与IFFT库函数的使用测试

/** * Copyright (C) 2013 Guangzhou Tronlong Electronic Technology Co., Ltd. - www.tronlong.com * * @file dsplib_fft.c * * @brief Example application main file. * This application will run FFT performance test. * * @author Tronlong <support@tron.

ToneChip的专栏,一个传统的嵌入式码农,裸机编程 2678

AI Agent记忆系统:从向量检索到认知架构的工程实践

在人工智能领域,记忆系统是智能体实现持续学习和个性化交互的核心基础。其原理是通过结构化存储和高效检索机制,将离散的交互信息转化为可推理的知识网络。从技术价值看,这不仅解决了传统对话系统上下文丢失的痛点,更是实现AI从工具到协作者跃迁的关键。在应用场景上,记忆系统广泛应用于智能客服、个性化助手、复杂任务规划等场景,通过检索增强生成(RAG)技术将历史记忆与当前任务动态结合。本文聚焦AI Agent记忆系统的工程实现,深入探讨如何利用向量数据库和LLM构建具备持久化、可推理能力的记忆模块,其中Agent框架集成

weixin_34290096的博客 340

告别水印!Vue3项目集成Stimulsoft.Reports.js完整配置与激活指南

本文详细介绍了如何在Vue3项目中集成Stimulsoft.Reports.js,提供从授权策略到性能优化的完整解决方案。通过模块化架构设计和现代化引入方式,帮助开发者高效实现专业级报表功能,同时避免版权风险和水印问题,特别适合中小型项目需求。

weixin_33701294的博客 433

基于STM32设计的太阳能智慧路灯_444

本文设计并实现了一种基于 STM32 的太阳能智慧路灯系统。系统以 STM32F103C8T6 单片机为核心,集成温湿度检测、空气质量检测、环境光照检测、行人检测和路灯故障检测等功能,实现对路灯运行环境和工作状态的实时感知。

465

Agent Zero 如何运作:开源 Agent 框架的完整架构深度解析

Agent Zero 是一个开源 Agent 框架,它的一句话定位很直白:给 AI 一台完整的 Linux 电脑。框架把真实的桌面环境、浏览器装进 Docker 容器,再配上分区记忆系统、30 多个内置插件和子代理协作机制,让代理能干完聊天机器人接不住的那种活儿——查资料、写代码、驱动 GUI 软件、交付一份可编辑的文档。 ## 三个缺口:为什么"会聊天"不等于"能干活" 拆开看,一个只会对话

gitblog_00496的博客 427

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

构建AI Agent记忆系统:从短期记忆到长期知识库的工程实践

在人工智能领域,记忆系统是智能体实现持续学习和个性化交互的核心组件。其原理借鉴了认知心理学的分层模型,通过模拟人类的短期、长期和工作记忆机制,使AI能够跨会话保持上下文连贯性。这一技术的核心价值在于突破传统对话模型的金鱼记忆限制,赋予Agent真正的连续决策与经验积累能力。在应用场景上,无论是个人助理、客服机器人还是复杂流程自动化,健壮的记忆体系都是实现智能化服务的基础。本文聚焦于如何利用向量数据库和LLM技术栈,为AI Agent构建一个类人的记忆宫殿,其中涉及LangChain框架的应用和Embeddi

weixin_30673611的博客 386

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

超越向量库:构建AI Agent分层记忆系统的核心架构与实践

在AI Agent的工程实践中,记忆系统是实现持续、连贯交互的核心。其本质在于对信息的有效存储、检索与利用,而非单一技术方案。从原理上看,一个健壮的记忆架构需模拟人类认知的分层特性,涵盖短期工作记忆、中期语义关联与长期结构化存储。向量数据库通过Embedding技术实现了强大的语义检索能力,成为处理非结构化信息、支撑RAG(检索增强生成)范式的关键技术组件,尤其擅长概念联想与模糊匹配。然而,其技术价值需结合具体应用场景辩证看待:在需要精确匹配、时序逻辑、动态状态管理或复杂关系查询的任务型Agent场景中,单

axfcjwkbi259888707的博客 609

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

腾讯云Agent Memory架构解析:突破LLM上下文限制,构建AI长期记忆系统

在人工智能应用开发中,大语言模型(LLM)的上下文窗口限制是核心挑战之一,它制约了AI处理长对话和复杂文档的能力。其原理在于模型无法持久化存储和精准检索历史信息,导致在多轮交互中出现“遗忘”。为解决这一问题,向量数据库和嵌入模型技术应运而生,它们通过将文本转化为高维向量并实现语义相似度检索,为AI提供了外部记忆扩展能力。这项技术的核心价值在于让AI Agent能够实现结构化记忆、支持复杂推理规划,并保障知识的一致性,从而在智能客服、数字助理、文档分析等场景中实现持续、个性化的服务。本文聚焦的Agent Me

weixin_30571465的博客 409

Agent记忆系统设计:从上下文管理到长期经验复用

本指南旨在构建高可用的 Agent 记忆系统,解决上下文腐烂、信息冲突及成本等问题: 核心架构:分为短期记忆(负责当前任务与会话上下文)和长期记忆(存储跨会话的用户偏好、项目事实与经验)。 读写策略:基于价值、时效与敏感度按需提取写入;通过语义路由、触发规则与自反判断动态检索,避免无脑全量注入。 治理机制:优先响应当前指令,引入置信度、更新机制与结构化记忆卡片解耦冲突,确保记忆可追溯且可治理

sinat_28228747的博客 330
上一篇: RAG 是什么?让大模型读懂私有知识库的关键技术
下一篇: MCP 和 Function Calling 有什么区别?
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值