告别向量盲搜:PageIndex重新定义无向量推理式RAG范式

使用 PageIndex 的简易无向量 RAG 生成文档的树状结构索引通过树搜索执行基于推理的检索无需向量:使用文档结构与大模型推理来完成检索。无需切块:文档按自然章节组织,而非人为切块。类人检索:模拟人类专家在复杂文档中导航并抽取知识的方式。检索过程透明:基于推理的检索——告别近似语义搜索(“vibe retrieval”)。 阅读详情

当大模型的上下文窗口不断扩容,上下文稀释问题却始终存在;当向量RAG成为标配,语义相似≠真实相关的底层缺陷却从未解决。面对财报、法律文书、技术手册这类长结构化文档,传统RAG的瓶颈愈发明显。

顺着此前解读BookRAG的思路,今天想和大家聊聊另一个极具参考价值的技术方案——PageIndex,一款彻底抛弃向量数据库、纯靠推理驱动的新一代RAG框架。它不依赖静态语义嵌入,而是让LLM像人类一样阅读目录、导航结构、推理定位,真正实现从“文本匹配”到“文档理解”的跨越,为复杂长文档RAG提供了全新的无向量解法。

01 研究背景

RAG的初衷是解决LLM上下文长度限制,通过检索外部知识优化生成效果。但传统向量RAG的底层逻辑,从根源上决定了它在专业长文档场景的局限性:

传统向量RAG的流程高度固化:

  1. 文档硬切分为固定长度文本块
  2. 块转为向量存入外部向量库
  3. 查询向量化后做相似度匹配
  4. 召回Top-K块送入LLM生成答案

这套方案在短文本场景简单有效,但面对长文档、强结构、专业域内容时,暴露出五大无法回避的缺陷:

  1. 查询与知识空间不匹配:向量检索只认语义相似,但用户查询表达的是意图。语义相近的文本,未必是逻辑相关的答案。
  2. 语义相似≠真实相关性:专业文档中大量段落语义近似,但只有特定章节包含核心答案,向量检索无法区分关键相关性。
  3. 硬分块破坏语义完整性:固定长度切块会切断句子、段落、章节逻辑,导致信息碎片化、上下文丢失。
  4. 无法整合对话历史:每次查询独立执行,检索器不感知多轮对话上下文,难以处理连贯追问。
  5. 无法处理文档内部引用:文档中“详见附录G”“参考表5.3”这类交叉引用,和目标内容无语义相似性,向量检索完全无法识别。

正是这些瓶颈,让Claude Code等先进系统率先放弃向量RAG,转向推理式检索。而PageIndex,正是将这一思路落地到通用文档的里程碑方案。

02 太长不看版

  1. 彻底抛弃向量库:不做文本切块、不生成向量、不依赖外部向量数据库,实现真正的无向量RAG。
  2. 构建LLM友好的层级目录树:把文档转为JSON格式的层级索引树,保留原生章节结构,放在LLM上下文内。
  3. 模拟人类推理检索:先读目录→选章节→提取内容→判断 sufficiency→循环补全→生成答案,靠推理导航而非相似度匹配。
  4. 原生解决五大痛点:天然支持对话上下文、文档交叉引用、语义完整性保留,精准匹配查询意图。

03 核心问题定义

PageIndex面向长结构化复杂文档问答任务:

给定超出LLM上下文窗口的专业长文档(财报、法律文件、技术手册),在不使用向量数据库、不做硬分块的前提下,让LLM通过推理导航文档结构,精准定位相关内容,生成有据可依的答案。

其核心设计理念:检索不应是静态相似度匹配,而应是动态推理式导航——让LLM主动思考“该去哪里找答案”,而非被动接收“相似的文本块”。

04 PageIndex核心方法

PageIndex的核心创新,是上下文内层级树索引+迭代式推理检索,全程无向量、纯推理,完全模拟人类阅读长文档的逻辑。
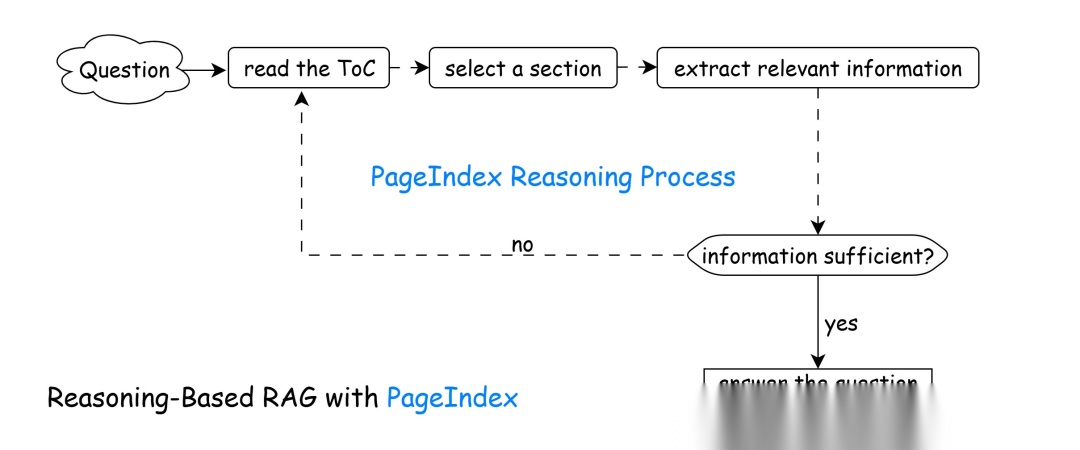
核心底座:上下文内层级树索引(In-Context Index)

PageIndex将文档构建为JSON格式的层级目录树,这不是外部存储的索引,而是直接放在LLM上下文窗口中的可推理索引。

1. 索引树结构

每个节点为一个逻辑章节(章、节、段落、页面),包含核心字段:

  • node_id:唯一标识,映射原始内容
  • title:章节标题
  • start_index/end_index:内容起止位置
  • summary:章节摘要,供LLM快速判断相关性
  • sub_nodes:子节点,递归形成完整目录树
{
"node_id": "0006",
"title": "Financial Stability",
"start_index": 21,
"end_index": 22,
"summary": "The Federal Reserve ...",
"sub_nodes": [
{
"node_id": "0007",
"title": "Monitoring Financial Vulnerabilities",
"start_index": 22,
"end_index": 28,
"summary": "The Federal Reserve's monitoring ..."
},
{
"node_id": "0008",
"title": "Domestic and International Cooperation and Coordination",
"start_index": 28,
"end_index": 31,
"summary": "In 2023, the Federal Reserve collaborated ..."
}
]
}
...
2. 索引核心特性
  • 保留文档原生结构:不破坏章节、段落逻辑,完全贴合文档原始层级
  • 上下文内驻留:索引直接在LLM推理上下文里,模型可实时查阅、导航、推理
  • 精准内容映射:node_id直接绑定原始文本、表格、图片等内容,定位零误差

核心流程:迭代式推理检索

PageIndex的检索完全模拟人类翻阅长文档的行为,分为五步迭代执行:

  1. 阅读目录:LLM先浏览层级索引树,理解文档整体结构
  2. 选择章节:根据查询意图,推理定位最可能包含答案的章节节点
  3. 提取信息:通过node_id获取该章节完整原始内容,提取相关信息
  4. 信息校验:判断当前内容是否足够回答问题
  • 足够→直接生成答案
  • 不足→返回第一步,继续导航其他章节
  1. 生成答案:整合所有收集到的信息,生成完整、有依据的答案

核心能力:破解传统RAG五大瓶颈

  1. 匹配查询意图:LLM通过推理定位章节,而非语义匹配,弥合查询意图与内容位置的鸿沟
  2. 聚焦真实相关:基于文档结构与上下文推理,只获取逻辑相关内容,忽略语义相似的无效信息
  3. 保留语义完整:按章节/页面获取完整内容,动态补充相邻节点,避免硬分块碎片化
  4. 支持多轮对话:检索过程感知对话历史,基于前文上下文修正检索方向
  5. 处理内部引用:通过层级树导航,自动跟随“详见附录”等交叉引用,定位目标内容

05 传统向量RAG vs PageIndex推理式RAG

瓶颈传统向量RAGPageIndex推理式RAG
查询-知识空间不匹配匹配表面相似,丢失真实上下文推理定位最相关章节
语义相似≠真实相关召回语义相似但无关的块获取上下文相关的核心内容
硬分块破坏语义固定切块切断逻辑动态获取完整章节,保留逻辑
无对话上下文每次查询独立隔离多轮推理,利用历史上下文
文档内部引用无法识别与跟随依托层级树自动导航引用

06 总结

PageIndex并未对传统向量RAG做小修小补,而是从底层彻底重构了RAG的检索逻辑,完全跳出“文本相似度匹配”的固有桎梏。

  • 传统向量RAG:被动搜相似——暴力切块、向量嵌入、静态匹配,仅聚焦文本表层语义关联
  • PageIndex推理式RAG:主动找位置——构建结构、推理导航、动态检索,直击文档逻辑与真实相关性

它以无向量的极简架构,破解了传统向量RAG无法逾越的底层缺陷;凭借上下文内层级目录索引,让LLM真正具备读懂文档结构的能力;通过迭代式推理检索,完美还原人类翻阅长文档的自然信息查找逻辑。

同时我们也需客观看待其局限:PageIndex的目录构建需要LLM通读全文,计算与Token成本偏高;且和BookRAG一致,二者仅适用于具备清晰目录层级结构的文档,面对无排版、无章节的非结构化内容,核心优势便难以发挥。

从BookRAG的结构感知,到PageIndex的无向量推理,RAG行业正加速告别“碎片化文本匹配”的初级阶段,迈向结构理解、推理驱动、意图精准对齐的全新时代。PageIndex为长文档专业场景提供了极简的无向量RAG解法,也为结构感知型RAG的落地,提供了更贴近人类阅读习惯的技术路径。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

[特殊字符] 使用 PageIndex 提升文档检索效率,告别向量数据库的局限! PageIndex是一款创新的无向量文档索引系统,采用基于推理的RAG技术,通过构建层次树索引实现上下文感知检索。它模拟人类专家处理复杂文档的思维过程,适用于金融报告、法律文件等专业领域。系统支持PDF/Markdown文件处理,提供精确导航和关键信息提取能力,在金融文档分析中达到98.7%的准确度。PageIndex支持本地部署和云服务,其独特的推理检索机制相比传统向量数据库在复杂文档处理上更具优势。 阅读详情

相关推荐

STM32CubeMX和华为LiteOS Studio开发STM32

传统的STM32的开发通常使用Keil/IAR这类开发软件,随着物联网时代的到来,传统嵌入式的发展不断向物联网方向靠拢,而Keil/IAR这类开发软件无法满足IoT一站式的开发,华为LiteOS Studio结合STM32CubeMX可以快速,高效地进行物联网开发,本文提供一种开发思路及环境的配置方法。...

weixin_45680600的博客 2833

LLMs之RAG:PageIndex的简介、安装和使用方法、案例应用之详细攻略

​ LLMs之RAG:PageIndex的简介、安装和使用方法、案例应用之详细攻略 目录 PageIndex的简介 PageIndex的安装和使用方法 PageIndex的案例应用 PageIndex的简介 PageIndex 是一个“无向量、基于推理的 RAG(Retrieval-Augmented Generation)框架”,目标是针对长篇、专业级文档(例如财报、监管文件、技术手册)提供比传统向量检索更相关、更可解释的检索方法。其核心思想是:先用 LLM 构建文档的层

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 3417

Java对接(BSC)币安链 | BNB与BEP20的开发实践(三)水龙头 WEB3

这一节我们讲一个币安测试链如何获取到BNB、USDT等BEP20数字货币(水龙头)来让我们前期测试开发。如图:我们将创建的地址填入相应输入框,来获取到测试BNB以及其他BEP20数字币。发币可能需要交易等待,请耐心等待即可,交易完成后,币会到达您的地址内。上一节我们用代码来实现BNB转账、BEP20转账、链上交易监控。2.MetaMask(小狐狸)浏览器插件 🪜。使用EDGE浏览器可以在浏览器直接打开。使用Chrome浏览器,请使用🪜打开。基本工作就绪后,即可进行开发测试。3. 测试区块链浏览器 🪜。

大猩猩的专栏 2790

不用向量数据库的 RAG,居然跑得更准了?

PageIndex 并不是要否定向量 RAG。但它清楚地提醒了一件事:当我们处理的文档足够长、足够专业时,RAG 的瓶颈往往不在 embedding,而在模型是否真正理解了文档的结构和逻辑脉络。如果你正在折腾专业文档分析、金融或合规类 RAG,这个项目,非常值得你认真看一眼。项目地址:https://github.com/VectifyAI/PageIndex想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2026 年AI 大模型全套学习资料。

2301_81888214的博客 642

opencv案例实战——银行卡模式匹配识别

在之前的几篇文章中我们已经介绍了opencv的一些基础知识,本篇文章我们将结合一个案例运用之前的知识并且学习opencv中模式匹配的应用,用到的知识点如果有不清楚的可以查看上面列出来的系列文章。具体代码会放在最后。

艾醒的博客 1339

Feature ‘alsa‘ was enabled, but the pre-condition ‘config.unix && !config.qnx && libs.alsa‘ failed解决

这个问题主要是Qt多媒体插件中缺少了ALSA音频库,所以我们需要自行先编译ALSA 在执行./configure的时候,配置项中ALSA为no Qt Multimedia: ALSA ................................... no GStreamer 1.0 .......................... no GStreamer 0.10 ......................... no Video for Linux .............

有问题或资源连接有缺失的可以私信公众号新潮看世界获取 2588

PageIndex完全指南:从零开始掌握无分块文档分析技术

🚀 PageIndex是一款革命性的文档索引系统,专为基于推理的RAG(检索增强生成)设计。在传统向量检索面临"相似性≠相关性"困境时,PageIndex通过树状索引和推理搜索,实现了人类专家级别的文档分析能力。 ## ✨ 为什么选择PageIndex? 传统向量RAG依赖语义**相似性**而非真正**相关性**,在处理专业长文档时常常表现不佳。PageIndex采用**无向量数据库**、*

gitblog_00254的博客 2512

中国工商银行企业架构建设实践最全总结

中国工商银行参考IBM持续价值创新方法并吸收TOGAF等主流企业架构的框架理念,结合业务实际情况形成工行自己的企业架构方法论并实践,为数字化转型提供支撑。本案例通过介绍中国工商银行企业架构之业务架构设计方法,为其他银行企业架构建设提供参考。 企业架构是数字化转型的抓手,可以帮助企业规划、管理和实施数字化解决方案,以实现业务目标并适应不断变化的市场条件。中国工商银行通过战略目标指导业务架构的规划和设计,业务架构建模后指导IT架构建模。

银行信息系统应用架构详解 2732

项目分享|PageIndex:无向量推理式RAG框架,重新定义长文档检索

本文介绍了VectifyAI开源的推理式RAG框架PageIndex,该框架摒弃传统向量数据库与人工分块,通过构建层级化文档树索引与推理式树搜索,实现长文档的精准检索,在FinanceBench基准测试中达成98.7%准确率。文章解析了其无向量无分块、类人推理、视觉文本双支持等核心优势,以及金融分析、学术研究等应用场景,并提供了本地部署步骤、文档索引生成、推理检索的完整代码示例,为开发者快速上手提供参考。

AladdinEdu,你的AI学习实践工作坊。让想法落地,让研究加速。助力高校AI人才成长,点亮创新未来。 1177

DC/DC开关电源学习笔记(一)开关电源技术概述

开关模式电源(Switch Mode Power Supply,简称SMPS),又称交换式电源、开关变换器,是一种高频化电能转换装置,是电源供应器的一种。其功能是将一个位准的电压,透过不同形式的架构转换为用户端所需求的电压或电流。开关电源的输入多半是交流电源(例如市电)或是直流电源,而输出多半是需要直流电源的设备,例如个人电脑,而开关电源就进行两者之间电压及电流的转换。【百度百科】

小幽余生不加糖 1619

DeepSeek赋能公文写作指南(一)

DeepSeek 的出现,为公文写作领域带来了新的曙光。作为先进的人工智能技术,DeepSeek 以其强大的语言理解与生成能力,能为公文写作提供全方位的支持。它可以快速梳理思路,提供丰富的素材参考,辅助优化语言表达,甚至能根据不同的公文类型和场景,生成极具价值的内容框架。《DeepSeek 赋能公文写作指南》正是基于此背景应运而生。本书旨在帮助公文写作者深入了解并充分利用 DeepSeek 这一强大工具,将其融入到公文写作的各个流程中。

通俗易懂学IT 5484

小白程序员轻松入门PageIndex,掌握大模型在长文档推理检索中的新范式

PageIndex框架创新性地解决了传统RAG在专业长文档处理中的痛点,通过构建层级树索引和推理式检索机制,在金融文档问答中达到98.7%的高准确率。该方案摒弃了向量数据库,保留文档自然结构,采用LLM驱动的树搜索方式实现可解释性强的精准检索。文章详细解析了PDF处理流水线、树结构数据模型和推理检索机制三大核心模块,展示了其无需向量计算、支持递归细分和透明检索路径的技术优势。这一架构显著降低了基础设施成本,简化部署流程,特别适合财报、法规等专业长文档场景的应用需求。

2401_85343303的博客 1158

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

PageIndex多语言支持指南:处理中文、日文等多语言文档的最佳实践

PageIndex作为一款基于推理的RAG文档索引系统,在处理多语言文档方面有着独特优势。无论是中文技术文档、日文产品手册还是其他语言的资料,PageIndex都能提供高效的智能检索能力。本文将为您详细介绍PageIndex在处理多语言文档时的最佳实践和配置方法。 ## 🔍 PageIndex多语言处理核心原理 PageIndex采用先进的文档解析技术,能够自动识别不同语言的文档结构。通过智

gitblog_00426的博客 947

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

dub支付集成:Stripe支付系统与订阅管理的技术实现

在数字营销时代,链接管理平台不仅要处理短链接和转化追踪,还需要无缝集成支付系统来处理订阅、交易和收入分成。dub作为开源链接归因平台,通过深度集成Stripe支付系统,为现代营销团队提供了完整的支付解决方案。 你是否曾经面临这样的挑战? - 如何将支付事件与原始点击事件关联? - 如何实现自动化的订阅管理和账单处理? - 如何确保支付系统的安全性和可靠性? 本文将深入解析dub如何通过Stri...

gitblog_00805的博客 920

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1445

从零构建网页内容向量索引:开源工具PageIndex实战指南

向量索引是AI应用实现高效语义检索的核心技术,其原理是将文本转换为高维空间中的向量表示,通过计算向量相似度来匹配相关内容。这项技术解决了传统关键词搜索在语义理解上的局限,为构建智能知识库和问答系统提供了基础支撑。在工程实践中,结合**网页抓取**与**文本分割**技术,可以将非结构化的网页内容自动化转化为结构化向量数据。本文以开源工具PageIndex为例,详细解析如何通过可配置的流水线,实现从内容抓取、清洗、向量化到存储的完整流程,为开发垂直领域AI助手、构建企业知识库等场景提供了一套可落地的解决方案。

weixin_42676876的博客 323

利用快马平台十分钟搭建带pageindex分页的商品列表原型

我输入了类似“创建一个商品列表页面,使用Vue 3和Axios,实现基于pageindex的分页功能,需要模拟分页API接口”这样的描述。前端则需要一个经典的分页器,能显示当前页码、总页数,并提供“上一页”、“下一页”以及直接跳转到指定页码的按钮。最关键的是,所有分页操作,比如点击下一页或输入页码跳转,都要求页面无刷新更新列表,也就是通过异步请求来实现,以提升用户体验。功能完成后,我对分页器进行了一些简单的样式美化,比如给当前页码的按钮一个高亮的背景色,给可点击的按钮添加悬停效果。接下来是前端的视图部分。

BlackironPanther23的博客 208

mysql 分页 pageindex_MySQL高效分页:子查询分页

正 文:一般MYSQL最基本的分页方式:select*fromcontentorderbyiddesclimit0,10在中小数据量的情况下,这样的SQL足够用了,唯一需要注意的问题就是确保使用了索引。随着数据量的增加,页数会越来越多,查看后几页的SQL就可能类似:select*fromcontentorderbyiddesclimit10000,10一言以...

weixin_39664995的博客 701

mysql 分页 pageindex_【MySQL】mysql分页调用

存储过程:CREATE DEFINER=`root`@`%` PROCEDURE `Proc_PageCondition`(p_cloumns varchar(500),p_tables varchar(400),p_where varchar(4000),p_order varchar(100),p_pageindex int,p_pagesize int,out p_recordcount i...

weixin_39960700的博客 339

高危工业场景人员定位系统设计:四类场景的架构选型与部署要点

本文由航飞光电一线工程团队整理,重点讨论高危工业场景下人员定位系统的架构选型思路。覆盖危化、矿山、港口、电力四类场景,拆解技术路线分工、融合引擎跨区切换实现,以及私有化/本地化部署中的工程难点,供架构师与技术负责人参考。

HF17513371855的博客 368

热管理系列之八:终局判断 - 浸没式冷却、混合架构与技术路线图

动力电池热管理三条路径的终局判断:液冷极致优化守住基盘,直冷在中高端渗透,浸没式冷却从概念到量产。附2026-2030技术路线图与关键产业信号分析。

weixin_54917114的博客 1169

【STM32】 ADC 完全指南:从模拟信号采样量化到五大架构原理

本文系统介绍ADC核心概念与五大主流架构。模拟信号具时间与幅值连续性,需经采样(满足奈奎斯特准则防混叠)、量化(引入±1/2LSB误差,SNR≈6.02N+1.76dB)、编码三步转为数字信号。重点解析Flash(并行高速但受限于比较器数量)、SAR(逐次逼近,低功耗适合MCU如STM32)、双积分(高精度抗工频,用于万用表)、流水线(高速吞吐)及Σ-Δ(高分辨率,靠过采样与噪声整形)五类架构原理、优缺点与应用场景。强调分辨率≠精度,选型本质是速度、精度、功耗与面积的权衡。

专注后端与底层技术,分享实战干货与学习笔记,梦想进入字节跳动,步履不停,热爱不止。 500

零信任架构实战:基于天远运营商三要素详版V即时版构建自动化线上授信身份核验网关

破解线上信贷身份核验痛点:从离散证件图片审查到运营商三要素详版数据穿透直连 在互联网消费金融、小额循环信用贷款以及各类纯线上数字化授信平台的业务演进过程中,移动端进件的身份真实性校验是构筑整体合规风控体系的第一道关键屏障。随着移动互联网的高度普及,个人信贷申请全面向移动端 App、微信小程序以及轻量级 Web 门户迁移,“秒级审批、免抵押、纯线上放款”成为了

2501_94041864的博客 161

AI高密度算力推动冷却架构升级,全球数据中心高功率CDU市场CAGR达23.0%

QYResearch调研显示,2025年全球数据中心高功率CDU市场规模大约为2.04亿美元,预计2032年将达到9.97亿美元,2026-2032期间年复合增长率(CAGR)为23.0%。未来几年,本行业具有很大不确定性,本文的2026-2032年的预测数据是基于过去几年的历史发展、行业专家观点、以及本文分析师观点,综合给出的预测。

QYR_11的博客 194
上一篇: OntoKG:Schema-First 知识图谱构建新范式
下一篇: RAGFlow实战指南:轻松将文本转化为SQL查询
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值