纯本地、极速、布局感知!LlamaIndex LiteParse实战指南(非常详细),文档解析从入门到精通,收藏这一篇就够了!

LiteParse v2.0:Rust重构的PDF解析引擎,支持中文OCR与结构化语义提取 PDF解析是RAG、知识库和文档智能的核心前置环节,其本质是将非结构化PDF字节流转化为可计算的结构化语义数据。传统方案依赖Python绑定C++库(如PyPDF2、pdfium),存在启动开销大、内存不可控、跨平台能力弱等固有缺陷;而LiteParse v2.0以Rust重写底层引擎,通过零成本抽象、所有权内存模型和WASM友好编译链,实现CPU原生性能跃升与端到端确定性解析。关键技术价值在于同步输出带坐标、字体、层级与关系的DocumentGraph,支撑精准标题识别、表格重建与OCR协同——尤其针对中 阅读详情

当你的AI智能体还在为一个PDF等待10秒,它已经失去了“思考”的连贯性。

每一个AI智能体,都需要读文档。

无论是分析合同、总结论文,还是从PDF中提取关键信息,文档解析都是智能体工作流中绕不开的一环。

但问题来了:现有的工具,要么快但不准(比如pypdf),要么准但慢——依赖云端GPU、调用VLM(视觉大模型),几秒甚至十几秒才能返回结果。智能体只好在那里干等,甚至超时,而它真正需要的,只是一个“差不多”的输出,来引导推理、继续迭代。

现在,LlamaIndex团队给出了一个答案:LiteParse。

01 LiteParse是什么?

LiteParse是一个纯本地运行、零Python依赖、专为AI智能体设计的文档解析工具。

它通过CLI或TypeScript库的形式,快速从PDF、Office文档(Word/Excel/PPT)和图片中提取 布局感知的文本 ,输出简洁的纯文本,保留空间结构(比如表格用ASCII形式呈现),让大模型“一眼看懂”。

一句话总结: 让智能体用最快的速度,读懂文档的“骨架”。

LiteParse 与 LlamaParse:怎么选?

LiteParse 和 LlamaParse 是同一团队打造的两个工具,定位不同:

LiteParse

  • ⚡ 本地运行,毫秒级响应

  • 📄 输出布局文本 + 截图

  • 🔌 适合智能体实时阅读、快速理解

LlamaParse

  • 🧠 云端高精度解析

  • 📊 输出 Markdown、JSON、表格

  • 🏭 适合文档智能产品、复杂格式处理

一句话:如果你的智能体只需要“扫一眼”文档,用 LiteParse;如果要做专业的文档分析,用 LlamaParse。

02 为什么LiteParse是为智能体“量身定制”的?

团队观察了智能体处理文档的两种常见模式:

  • 写代码模式 :智能体自己写Python代码,调用pypdf或pdfplumber来解析。问题是——每次都要写新代码,不同文档不通用,而且代码容易出错。

  • 截图模式 :智能体先快速提取文本,发现不够时再截图给VLM分析。思路对,但流程复杂,没法复用。

LiteParse正是为了完美适配这两种模式而设计的:

  • 文本提取 :一条命令 lit parse report.pdf 就能输出布局文本,智能体直接grep关键词。

  • 截图辅助 : lit screenshot report.pdf -o ./images --pages "1-3" 快速生成指定页的截图,当智能体需要视觉推理时,可以无缝切换。

而且,LlamaIndex已经把这个能力打包成了 智能体技能 ,可以直接安装到你的Agent框架中:智能体从此拥有“快速阅读+视觉补刀”的双重能力。

03 核心技术:只保留布局,不花哨
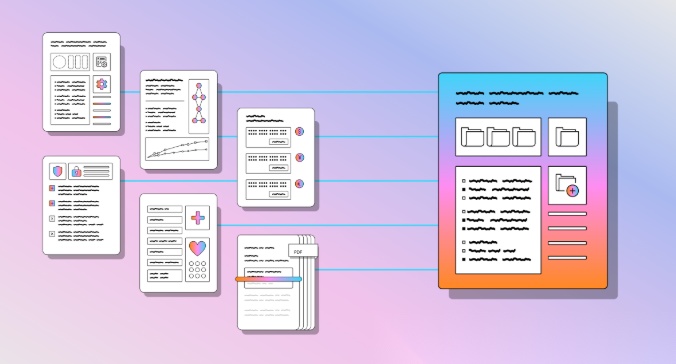
大多数解析器都在努力“理解”文档结构——识别表格、转成Markdown、抽取标题层级……但这对智能体来说,常常是 过度加工。

LiteParse的哲学是: 保留布局,让大模型自己去“看” 。

它把文本投影到一个空间网格上,保留列对齐、缩进、换行。比如一个表格:LLM天然理解这种ASCII风格的表格(因为它们训练数据里全是这种),何必再花功夫转成复杂的Markdown?直接用,更快、更准、更省事。

Name        Age    City

John        25     NYC

Jane        30     LA

实测对比,同样的表格,pypdf输出可能把三列揉成一团乱麻,而LiteParse完美保持对齐。

04 支持的格式:不止PDF

LiteParse能处理:

  • PDF :原生文本提取,自动对扫描页触发OCR(内置Tesseract.js)

  • Office文档 (DOCX/XLSX/PPTX):后台调用LibreOffice转成PDF,再走同一套解析流程

  • 图片 (PNG/JPG/TIFF):通过ImageMagick转PDF后OCR

所有格式统一用一套处理逻辑,未来也容易扩展。

05 灵活的OCR:内置+外接

对于扫描件,LiteParse内置了Tesseract.js,自动并行利用CPU多核处理大文档。同时支持对接外部OCR服务(如PaddleOCR、EasyOCR),适合对准确率有更高要求的场景:你可以自己部署任何OCR模型,只要它返回带边界框的文本,就能无缝接入。

lit parse scanned.pdf --ocr-server http://localhost:8000/ocr

06 性能实测:又快又准

LlamaIndex团队自己做了一套评测,因为现有OCR数据集都不适配LiteParse的输出特点(它们期望Markdown结构,但LiteParse只给文本布局)。

他们用大模型根据截图生成问答对,人工审核后作为测试集,对比了pypdf、PyMuPDF、Markitdown等轻量级解析器。

结果: LiteParse在页面级问答任务上准确率领先,且解析大文档的延迟位于第一梯队。

用团队的话说:这就是给智能体设计的——既要快,又要准,还不能依赖云端。

07 如何上手?

  1. 安装CLI
    npm i -g @llamaindex/liteparse
    
    lit parse anything.pdf
    
  2. 在TypeScript/JS中使用
    import { LiteParse } from'@llamaindex/liteparse';
    
    constparser=newLiteParse({ ocrEnabled: true });
    
    constresult=awaitparser.parse('document.pdf');
    
    console.log(result.text);
    
  3. 在Python中使用(通过CLI封装)
    # pip install liteparse
    
    fromliteparseimportLiteParse
    
    parser=LiteParse()
    
    result=parser.parse("document.pdf")
    
    print(result.text)
    
  4. 技能一键安装
npx skills add run-llama/llamaparse-agent-skills --skill liteparse

08 为什么开源LiteParse?

LlamaIndex团队在打造LlamaParse的过程中,积累了海量关于“快速、轻量级解析”的经验。他们发现,大多数AI智能体其实不需要最顶级的准确率,它们只需要在几秒内得到“足够好”的文本,就能继续推理。

开源LiteParse,就是要把这种能力交给每一个智能体开发者。

“我们在LlamaParse上投入了数年,今天把它的核心能力开源。希望每一个智能体都能更快地读懂文档。”——LlamaIndex团队

09 总结:智能体读文档,从此不再“卡壳”

LiteParse不是要取代LlamaParse,而是为AI智能体开辟了一条新的路径:

  • 快 :本地运行,无网络延迟

  • 准 :布局保留,LLM友好

  • 轻 :零Python依赖,一条命令搞定

  • 灵 :配合截图,视觉推理无缝衔接

如果你的智能体经常因为解析文档而“等待”,不妨试试LiteParse。开源、免费、即装即用。

文档解析,本该如此简单。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

LiteParse:Rust编写的亚秒级文档解析引擎 文档解析是RAG系统中至关重要的预处理环节,直接影响知识库构建效率与检索质量。其核心原理在于从二进制文件(如PDF)中准确提取结构化文本,并保留位置、字体、语义等元信息。技术价值体现在性能跃迁——通过Rust实现零成本抽象、确定性内存管理与无锁并发,将传统Python解析器的数十秒延迟压缩至亚秒级,同时保障高准确率与低资源占用。典型应用场景包括企业级知识库建设、合同/财报等结构化文档处理、以及对延迟敏感的实时问答系统。本文聚焦LlamaIndex生态下的LiteParse实践,深入解析其Rust底层设计与工 阅读详情

相关推荐

LiteParse v2:本地PDF解析提速100倍的Rust工程实践

PDF解析是RAG、知识库与文档智能的核心前置环节,其本质是将矢量绘图指令转化为结构化文本流。传统方案依赖模拟渲染、全局OCR和动态库绑定,导致延迟高、内存大、跨平台难、数据外泄风险高。LiteParse v2以Rust重写+PDFium深度定制为技术支点,实现空间驱动的按需提取与置信度感知的局部OCR,达成毫秒级响应、零网络外联、单二进制分发。它不替代LlamaIndex等上层框架,而是作为高精度、低延迟、强合规的‘文档入口牙齿’,支撑金融尽调、医疗病历、法律合同等敏感场景的本地化落地。

weixin_30621711的博客 361

LiteParse:开源轻量 PDF 解析工具,多格式支持、多语言适配,功能强大!

LiteParse 是独立开源 PDF 解析工具,专注快速轻量解析,提供高质量空间文本解析与边界框,无需大语言模型和云服务,本地处理。复杂文档用 LlamaParse 效果更好。其具有快速文本解析、灵活 OCR 系统、标准 API、截图生成等功能,支持多种输出格式、多语言和多平台。

EveningTalk的博客 205

LiteParse v2.0:面向AI Agent的轻量级PDF解析新范式

PDF文档解析是AI Agent处理非结构化数据的关键前置环节,其性能与可靠性直接影响推理链稳定性。传统工具依赖OCR、字体解析和语义重建,导致高延迟、强环境依赖与部署脆弱性;而LiteParse v2.0另辟蹊径,以空间坐标映射为核心,将PDF视为可编程画布,输出LLM天然友好的对齐文本,实现毫秒级响应与零Python依赖。该方案契合AI原生设计思想——不替代模型理解力,而是构建适配其认知偏好的输入界面。适用于实时编码Agent、本地政务系统及浏览器端SaaS等对确定性、低延迟和离线能力有严苛要求的场景。

congtaixiao7151的博客 407

LiteParse:理解布局的PDF解析器

你见过这种循环上演。一个智能体需要从PDF表格中获取数据,于是它用pypdf编写提取代码,结果只得到错位的列。它切换到pdfplumber,修复了对齐问题,但默默地将两行合并成一行。接着它尝试markdown转换器,这次表头向右移动了一列,将财务摘要中的每个数字都附加到了错误的标签上。三次迭代和几千个token之后,智能体花在解析文档上的计算资源比分析其内容还要多。检测文档结构,将其转换为markdown,并希望转换是准确的。

新缸中之脑 509

LiteParse v2.0:Rust重写的高性能PDF解析引擎

PDF解析是RAG、文档智能等AI应用的关键前置环节,其本质是将非结构化文档转化为LLM可理解的结构化文本。传统方案依赖Python/Node.js子进程与低效序列化,导致高延迟、布局失真与隐私风险。LiteParse v2.0以Rust重构底层,实现零启动开销、零拷贝内存共享与原生布局感知,显著提升解析速度与结构保真度。它支持OCR增强、离线部署与WASM端侧运行,适用于金融合同审查、医疗病历检索、政务公文处理等对性能、隐私和准确性要求严苛的场景,成为现代文档预处理链路的可靠基石。

weixin_33739627的博客 466

使用 LlamaParse (LlamaIndex) 为基于 RAG 的应用程序解析 PDF(文本、图像和表格)

大型语言模型 (LLM) 的快速进步改变了人工智能 I 的格局,在自然语言理解和生成方面提供了前所未有的能力。OpenAI 的 GPT 模型凭借在海量在线数据上磨练出来的卓越能力,在语言理解和生成的新时代占据了领先地位。这些模型扩展了我们的可能性,使我们能够以前所未有的方式与人工智能驱动的系统互动。然而,与任何技术奇迹一样,法学硕士也有其自身的局限性需要考虑。一个值得注意的问题是他们偶尔会提供可能不准确或过时的信息。此外,这些法学硕士不提供其回答的来源,因此很难确定其输出的可靠性。

iCloudEnd的博客 822

LlamaIndex 开源 LiteParse,零云依赖搞定扫描件PDF

LiteParse 是 LlamaIndex 开源的本地文档解析工具,内置 Tesseract OCR,可零云依赖解析扫描件 PDF。本文实测 lit 命令行,记录接入派聪明 RAG 的全过程,并接入阿里云 OCR 把中文识别精度再提一档。

沉默王二 507

Fluent温度超限调试:从能量方程到网格优化的实战指南

本文深入解析Fluent中温度超限问题的诊断与解决方法,从能量方程机制到网格优化策略,提供实战指南。通过分析温度与焓的换算关系,探讨典型场景如能量方程发散、局部网格质量差等,并给出五步调试法及高级命令应用,帮助工程师有效解决温度计算异常问题。

weixin_29045585的博客 530

【免费下载】 推荐开源项目:LlamaParse - 文件解析与高效检索的得力助手

LlamaParse 是一款由 LlamaIndex 开发的API,旨在为开发者提供高效且灵活的文件解析服务,特别适合于文档检索和上下文增强。这款API可以直接与 [LlamaIndex](https://github.com/run-llama/llama_index) 集成,帮助您快速处理并理解大量文本数据。 ### 项目介绍 LlamaParse 提供了一种简单的方式来处理PDF文件,将...

gitblog_00014的博客 1558

从零到一:华为iMaster NCE-Campus部署中的Euler OS与FusionInsight深度解析

本文深入解析华为iMaster NCE-Campus部署中Euler OS与FusionInsight的关键技术要点,包括RAID配置、网络绑定技术、安装避坑指南及性能调优方案。通过实战经验和详细配置示例,帮助工程师提升部署效率与系统稳定性,确保华为企业级解决方案的高效运行。

f6g7h8i9j的博客 549

如何实现SOLIDWORKS阵列的“智能变更”?

有时,我们在设计一个零件时,零件上有一排阵列孔,同时零件有不同的长度,我们又希望可以做到零件长度改变时,这排孔可以按长度等距增减孔阵列的个数;或是零件长度加长或缩短时,这排孔保持个数不变,按零件长度增减孔距。 那具体要怎么做呢?接下来,我们一起来看看怎么用SOLIDWORKS中简单的操作来实现这两种智能的变更: 零件长度加长或缩短时,这排孔要按长度等距增减孔阵列的个数。 零件长度加长或缩短时,这排孔保持个数不变,按零件长度增减孔距。 那接下来,我们一起来看看怎么用简单的操作来实现这两种智能的

SOLIDWORKS艾金米 2078

4个最强本地OCR模型实测对比

这一切始于我需要一个可以高效运行在我的4090笔记本GPU上的快速OCR替代品。我需要一个可以日复一日在后台运行,纯粹在本地处理一批客户文档直到全部完成的东西。我需要一个可以提供文字、格式、表格和图片(就像90%需要OCR的人一样)的东西。我不需要每个单词的确切坐标,但我需要OCR快速且准确。所以……我开始准备我感兴趣的OCR模型清单,并开始开发一些快速简陋的基准测试和实现。

新缸中之脑 545

别再用Excel画波特图了!用LTspice免费仿真软件,5分钟搞定电路传递函数分析

本文介绍了如何利用LTspice免费仿真软件高效绘制波特图,解决传统Excel绘图效率低、精度不足的问题。通过详细的操作步骤和实战案例,展示LTspice在电路传递函数分析中的自动化计算、专业级精度和完整特性展示等优势,帮助工程师快速完成频率响应分析。

weixin_42524226的博客 461

2026年05月30日最热门的开源项目(Github)

本期榜单分析15个热门开源项目,主要集中在AI工具和开发效率领域。MoneyPrinterTurbo(AI短视频生成工具)和Markitdown(文档转换工具)分列前两位,展示AI应用和办公效率工具的热度。项目语言以Python和TypeScript为主,反映开发者对这两种语言的青睐。AI自动化、文档处理是主要技术趋势,如Understand-Anything的代码可视化工具。榜单显示开发者正积极利用AI技术优化工作流程,同时高效文档工具需求旺盛。数据来自hot.me88.top,项目创建时间集中在2024

我只是一个攻城狮 407

3GPP协议解读_NTN系列(一)_38.811_非地面网络(NTN)的背景、应用场景和信道建模

非地面网络覆盖广,对物理攻击和自然灾害有一定的抵抗性。本文根据3GPP协议对NTN网络的背景、应用场景和信道模型进行了整理。

JCMLSY的博客 4927

MLC-LLM框架在安卓设备上的模型编译与部署全流程解析

本文详细解析了如何利用MLC-LLM框架在安卓设备上编译与部署大语言模型。从环境搭建、模型获取与量化编译,到最终的安卓应用打包与调试,提供了完整的实战流程。重点介绍了如何通过MLC-LLM将大型模型优化为适合移动端运行的格式,实现本地、低延迟、隐私安全的AI应用部署。

weixin_29251337的博客 475

新手必读:LiteParse 支持哪些格式?PDF、Office、图片全支持

**LiteParse** 是一款免费、开源的文档解析工具,支持 **PDF、Word、Excel、PPT、图片** 等 30 多种输入格式,可快速把文档解析成 Markdown、JSON 或纯文本,并内置 OCR 识别能力。本文用一篇讲清楚:LiteParse 到底支持哪些格式、Office 文档和图片是怎么被解析的,以及新手如何 3 分钟上手。 ## 📦 LiteParse 是什么? 简

gitblog_00501的博客 941

【华为OD机试真题E卷】514、学生方阵 | 机试真题+思路参考+代码分析(E卷复用)(C++、Java、Py)

【华为OD机试真题E卷】514、学生方阵 | 机试真题+思路参考+代码分析(E卷复用)(C++、Java、Py) 题目描述 学校组织活动,将学生排成一个矩形方阵 请在矩形方阵中找到最大的位置相连的男生数量 这个相连位置在一个直线上,方向可以是水平的,垂直的,成对角线的或者呈反对角线的 注:学生个数不会超过10000

KJ.JK 2492

LlamaParse: 高效的PDF文件RAG解析工具

通过Thomas Reid的深入探索,LlamaParse成为了目前我所见最优秀的RAG实现用PDF解析器。基于AI的技术,尤其在处理像SEC Q10这样的复杂文件时表现出色,这些文件通常包含文本、数字及其组合构成的表格,对AI来说是一大挑战。LlamaParse是由LlamaIndex开发的API,特别适合解析和增强这类半结构化文档的检索能力,让之前难以回答的复杂问题变得可能。

XianxinMao的博客 2161

MyBatis-Plus 实战:敏感字段自动加解密支持模糊查询

本文基于MyBatis-Plus框架提出了一种全链路敏感字段加密方案。通过自定义TypeHandler实现数据入库自动加密和查询自动解密,结合重写LambdaQueryWrapper处理查询条件加密,并适配多种查询方式。方案核心包括:1)AESUtil工具类提供加解密基础能力;2)EncryptTypeHandler实现字段类型转换;3)实体类通过注解配置加密字段。该方案在保证数据安全的同时,对业务代码侵入性小,支持姓名、手机号等敏感信息的全流程加密处理,满足系统开发的安全需求。

蔡定努 596

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Introducing LlamaCloud and LlamaParse

Datastax 已将 LlamaParse 整合到他们的 RAGStack 中,为企业带来一个保护隐私的开箱即用的 RAG 解决方案:“上周,我们的一个客户 Imprompt 推出了一个开创性的'Chat-to-Everything'平台,利用由 LlamaIndex 提供支持的 RAGStack 来增强他们的企业产品,同时优先考虑隐私,”DataStax 首席技术官兼执行副总裁 Davor Bonaci 说。最终结果是,您可以在复杂文档上构建 RAG,这些文档可以回答表格和非结构化数据上的问题。

liferecords的博客 1962

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Py之llama-parse:llama-parse(高效解析和表示文件)的简介、安装和使用方法、案例应用之详细攻略

​ Py之llama-parse:llama-parse(高效解析和表示文件)的简介、安装和使用方法、案例应用之详细攻略 目录 llama-parse的简介 llama-parse的安装和使用方法 llama-parse的案例应用 llama-parse的简介 2024年4月15日正式发布,LlamaParse 是由 LlamaIndex 创建的一个 API,用于高效解析和表示文件,以便使用 LlamaIndex 框架进行高效检索和上下文增强。 LlamaParse 可以直接与 L

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 4605

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

LlamaParse API 使用指南:高效解析与表示PDF文件

LlamaParse 是 LlamaIndex 创建的一个 API,用于高效解析和表示文件,以便通过 LlamaIndex 框架进行高效检索和上下文增强。LlamaParse 直接与 LlamaIndex 集成,目前支持 PDF 文件解析。本文将介绍如何使用 LlamaParse API 来解析 PDF 文件,并提供一些示例代码。

qq_29929123的博客 1323

突破Git Subtree性能瓶颈:splitsh-lite全方位问题解决方案

你是否也曾遭遇过这些场景: - 执行`git subtree split`命令后,服务器CPU飙升至100%,持续数小时无法响应 - 大型仓库拆分时频繁出现"Out of memory"错误,被迫重启操作 - 团队成员因等待拆分操作完成,每日浪费1-2小时在无意义等待上 - 拆分历史不一致导致下游仓库出现诡异的合并冲突 作为解决Monorepo(单体仓库)与Manyrepos(多仓库)架构矛盾的...

gitblog_00542的博客 886

LlamaParse - 文档解析

一、关于 LlamaParse 价格 LlamaCloud 例子 二、使用入门 三、与文件对象一起使用 四、`SimpleDirectoryReader`

AI工程化、开源分享、文档翻译、代码笔记 2489

LlamaIndex 节点分割器全解析:从文本切分到语义理解的终极指南

格式感知层:SimpleFileNodeParser 家族处理不同格式文档文本切分层:CodeSplitter/SentenceSplitter 等处理纯文本语义理解层:SemanticSplitterNodeParser 实现智能分块关系构建层:HierarchicalNodeParser/SentenceWindowNodeParser 建立上下文网络这些工具相互配合,能应对从简单文档到复杂知识库的各种场景。通过今天的分享,我们系统了解了 LlamaIndex 中节点分割的完整工具链。

佑瞻的博客 1575
上一篇: AI Agent长期记忆工程实战(非常详细),踩坑与取舍从入门到精通,收藏这一篇就够了!
下一篇: 企业级Agent怎么落地?OpenClaw架构设计全攻略(非常详细),从小白到架构师,收藏这一篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值