震惊!2025年AI编程开发大变局:Claude逆袭ChatGPT,太空数据中心成真,小白程序员如何抓住“模型套利“风口?

Bright Data ChatGPT 搜索抓取器(Python) 使用 GitHub 登录,然后 fork 该仓库开始进行更改。本项目提供一个使用 Bright Data Web Scraper API 抓取结果的简易 Python 样板代码。 阅读详情
【导读】大模型王座易主Anthropic,太空数据中心成真,「AI泡沫」反成创业红利?2025年底的Y Combinator博客中,谈到了2025 年 AI 领域的四大变局。

从孵化器的角度来看,最显著的变化是Anthropic成为创始人中最受欢迎的大模型。

曾经,OpenAI在很长一段时间里是绝对的领先者,其API使用率高达90%以上。

但到了2025年,Anthropic的使用率超过了OpenAI,达到52%以上。同时Google Gemini(占比约 23%)也迅速崛起。

这并非偶然,Claude在今年大火的氛围编程上表现是最好的。对于很多创业者来说,构建产品时,Anthropic的模型是最佳选择。

不过,绝大多数使用场景其实并非用于编码,而是由于使用者熟悉了一种大模型之后的「溢出效应」。

而且不同的模型,如果与它对话多了后,会觉得模型的回复有个性。播客中提到:ChatGPT有点那「黑猫」(神秘、强大且带有一丝丝诡异),而Claude更像是那种无忧无虑、非常乐于助人的金毛寻回犬。

Gemini介于两者之间。而正是由于大模型带有的不同个性,决定了人们选择哪种大模型。

此外,Gemini正在取代谷歌搜索,成为人们检索信息的窗口,以获取实时信息。Gemini甚至比Plexity(另一款信息检索的AI工具)更好。

Plexity速度很快,但不总是准确,而Gemini虽然没有Plexity那么快,但如果我问它关于当天发生的事情,它的回答通常都很准确。
创业者的机会来自在模型间的套利

接下来对话的嘉宾分享了他的个人经验。 他在今年购买一套房子的时候,他不得不花很长时间与ChatGPT对话,往对话框里面填充了所有的和待购买房子有关的检查报告等信息,就是想让ChatGPT了解的情况和房地产经纪人之间的信息更加对称,从而由大模型帮他出谋划策,分析相关情况。

这样的案例很典型的代表了普通人每天在真实场景中反复进行的与大模型的协作。不仅是文档编辑或表格计算,而是结构化提示、上下文编织,从而与智能体协同。

这些本应被封装为「日常AI工作流」的能力,却仍被塞进一个通用聊天框里手工完成。

这正是留给AI创业者的机会,我们不该让普通人用临时脚本搭建自己的「购房智能代理」,而应当创建一个个可复用、可协作、可沉淀的垂直AI应用。这些应用能自动聚合多源文档、动态构建决策知识图谱、实时比对市场数据、生成合规话术建议等。

这样的垂直AI应用,以真实生活任务为中心,封装提示工程、记忆管理、多模态上下文维护,从而构建辅助人类做判断的一体化智能工作台。

而在面对高价值决策(如房产交易),人们也不会信任单一模型的「独白」,而是同步调用Claude、Gemini、ChatGPT三路输出,再引入第四轮「元辩论」——让Claude对其他模型的结论进行交叉质询。

而这同样是很多B轮阶段的AI原生创业公司正在做的事,他们对多种大模型构建了一个编排层,把所有这些模型都整合起来,这样每当有新模型发布时,他们就可以灵活地替换模型,或者使用那些在某些特定任务上表现更好的特定模型。

理论有一家创业公司使用Gemini 3来进行上下文设计,然后再把结果输入到OpenAI模型中去执行,他们会根据新模型的发布情况不断进行替换,每个类别的智能体工作中表现最佳的模型可能都不同。

而他们之所以能够这样做,是因为他们有独属于自己的模型评估体系。作为一家垂直领域的AI智能体公司,他们的核心壁垒不是自己的模型,而是私有的评测数据集。

有了这个数据集,可以构建「模型调度中枢」,一个实时评估各家新模型、通过组合增强的智能决策路由器。

而这对于消费者在个人层面,实际上是在对各种模型进行套利操作,而创业者将辅助用户更好的用好各种大模型。
基础设施科幻化

能源焦虑逼出「太空数据中心」

2024年夏天吗?有一家公司叫StarCloud,它是最早提出要在太空中建设数据中心的公司之一,当时人们对这个想法的反应是在互联网上嘲笑他们,说这是最愚蠢的想法。

大约18个月后,突然谷歌开始在做这件事,埃隆·马斯克也在做这件事。

为什么会这样呢?其中一个原因是,目前美国正在进行的AI基础设施建设的强度非常大,以至于缺乏足够的电力供应。

有三家YC创业公司,它们正在解决数据中心建设的问题。Boom和Helion正在试图利用核聚变能源。一家创业公司Zephr Fusion正通过建设太空数据中心来解决没有土地的问题。它们的团队成员是国家实验室的工程师,他们整个职业生涯都在建造托卡马克和核聚变能源设施。
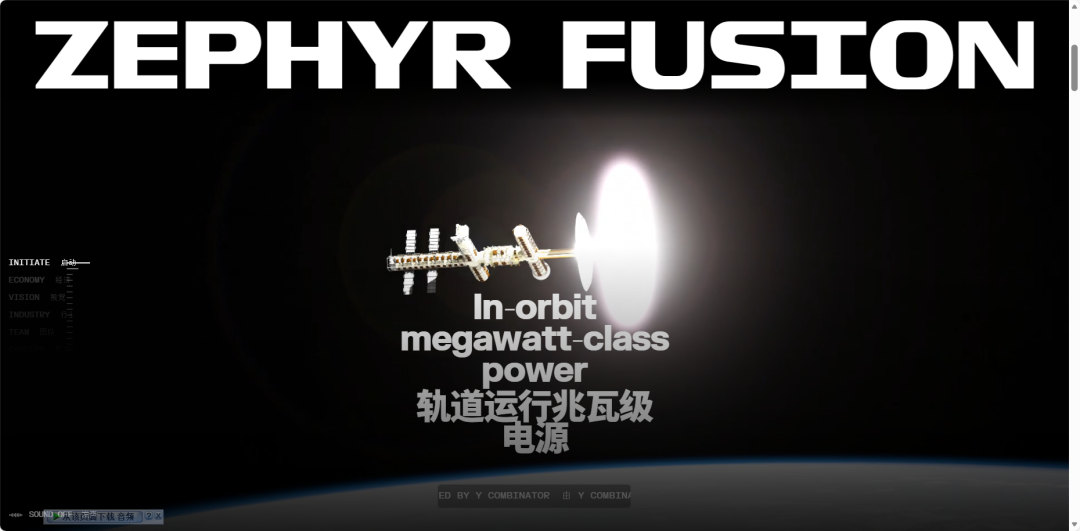
有一天,他们来到实验室,看了看物理原理、数学公式和模型,然后说:「你知道吗?如果我们在太空中进行核聚变,实际上是可行的。」

所以,他们正在进行一项为期5 - 10年的宏伟计划,试图将其变为现实,因为数学计算表明这是可能的,如果他们成功了,这实际上是太空中获得吉瓦级(GW)能源的唯一途径。所以,也许不久之后,我们将拥有一个更完美的三重组合,来解决数据中心建设的问题。
AI泡沫的辩证思考

算力过剩是创业者的福音

播客中嘉宾还谈到,与本科生交谈的时候,都说当下有一个巨大的AI泡沫,例如英伟达和OpenAI之间疯狂的资金循环,但YC合伙人提出了独特的视角:基础设施的「泡沫」往往是应用层的红利。

20世纪90年代的电信泡沫,数千亿美元堆积在电信领域,当时也存在泡沫。但正是因为有大量未使用的、相对廉价的额外带宽,成本足够低,像YouTube这样的东西就能够诞生。

当下正是由于AI泡沫的存在,意味着将会有更多的计算资源。巨头之间的激烈竞争,对大学毕业,试图在AI应用层创业的人也是利好。

就像回到互联网时代,在2000年之前,有大量资金投入到电信基础设施建设中,但那些都是大型项目,大学生不会参与其中。他们能参与的是在宿舍里手搓的脸书或Youtube

AI时代的Facebook或Google还尚未创立。当下竞争激烈的基础模型和GPU属于基础设施范畴。

不过相比2024年,AI领域的创业点子不再唾手可得。

在过去,创业者只要等待几个月,很可能就会有某个重大宣布,让一系列全新的创业点子成为可能,所以当时找创业点子的难度似乎比以往任何时候都容易。而现在,这种轻松找到创意的情况有所改变,找点子的难度回归到了正常水平。

今年有一份名为《AI 2027》报告,这份有点悲观的研究报告说社会将在2027年开始崩溃。但后来他们悄悄地把时间修订了,说不是2027年了,但他们保留了这个标题。

也许这并不令人惊讶。对这种快速起飞,人工智能技术突然出现巨大突破并快速发展的观点应当持怀疑态度,即使按照幂律定律,它也是对数线性的。所以它在之后的增长速度较慢,需要10倍的计算资源,并且仍然会逐渐达到极限。

类似的事也发生在创业者身上,一些AI应用公司在早期取得了快速的收入增长,如部分公司在未雇佣大量人员的情况下就实现了较高的年经常性收入(ARR),但后续的发展并不顺利,未能实现进一步的规模扩张。但也有像Gamma 这样的公司,仅凭约 50 人的团队就实现了 1 亿美元的 ARR,这验证了AI 赋能下可以产生极高的人效比。

然而,随着客户对产品的期望提高了,而且所有公司都在竞争相同的客户群体,这就是导致公司仍然像人工智能出现之前一样招聘大量人员。创业者最终都会受到缺人的限制,而不是受到创意的限制。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

.NET 4.0下HttpWebRequest请求HTTPS报错?试试这个注册表修改方案 本文深入解析.NET 4.0下HttpWebRequest请求HTTPS报错问题,提供注册表修改方案以解决'基础连接已经关闭'错误。通过调整SchUseStrongCrypto注册表项,强制使用TLS 1.2等现代加密协议,确保安全连接。适用于企业环境部署和长期维护建议。 阅读详情

相关推荐

TCP Reno/CUBIC 拥塞控制算法对比:从 Tahoe 到 BBR 的 4 种核心策略演进

本文深入解析了TCP拥塞控制算法的演进历程,从经典的Tahoe、Reno到现代的CUBIC和BBR,详细对比了4种核心策略的实现机制与性能差异。通过分析拥塞窗口、流量控制等关键技术,揭示了不同算法在高带宽延迟网络中的优化方向,为网络协议栈优化提供理论依据和实践指导。

weixin_33725239的博客 442

ChatGPT 广告技术栈架构拆解:多轮意图、LLM 工具编排、ANN 召回与拍卖闭环

基于 OpenAI 官方工程文章,拆解 ChatGPT 广告系统如何用有状态会话理解多轮意图,以独立链路隔离自然回答,再由 LLM 编排召回、过滤、相关性评分、拍卖和最终交付,并给出可复用的超时、观测、安全与反馈闭环设计。

jerry764的博客 402

双屏DPI缩放问题全解析:从原理到实战解决窗口大小突变

DPI(每英寸点数)缩放是现代操作系统在多显示器环境下实现界面适配的核心技术。其原理是通过虚拟分辨率映射,在不同物理像素密度的屏幕上维持一致的视觉尺寸。这项技术的价值在于解决了高分辨率屏幕显示内容过小的问题,保障了跨屏工作流的视觉连续性。然而,在混合DPI环境(如4K屏与1080p屏组合)中,显卡驱动逻辑与应用程序DPI感知的协同问题,常导致窗口跨屏时出现剧烈缩放、尺寸错乱。这直接影响多屏办公、设计协作等需要频繁拖拽窗口的应用场景。本文聚焦于**显卡驱动**配置与**应用程序兼容性**设置,提供一套从系统底

weixin_34364071的博客 388

企业可以通过哪些渠道使用 ChatGPT 和 OpenAI 模型?

正式选型阶段,查阅 GPT-6 Sol、GPT-6 Luna、Claude Opus 5.5 的模型卡,确认 API、Region、功能特性与生命周期状态。在 Amazon Bedrock 体系里,GPT-6 Sol 主打高复杂度开发场景,支持功能开发、故障调试、代码重构、代码审查,也能够联动多款工具、应用完成多步骤业务流程。优先挑选 2-3 个典型场景,例如代码开发、文档处理、高频分类,使用同一套测试集分别跑测 GPT-6 Sol、GPT-6 Luna 和 Claude Opus 5.5。

JINGdigital_的博客 251

步科触摸屏编程

1.首先官网上下载kinco软件,然后再安装驱动,安装的方式是需要两个文件。把两个文件放到driver文件夹下面,然后设备管理器右键更新,手选driver文件夹,自动安装即可。 步科触摸屏驱动文件下载地址 2.按照步科触摸屏使用手册一步一步来建立工程 Kinco HMIware使用手册下载地址 登录界面 涉及到的是页面切换,用的是login window,然后只留下等级输入那个

MAYBE的博客 2万+

新手3dslicer手动肝脏切割及体积测量(详细图文)

刚接手软件的时候,我一直想用自动分割工具,试验了Med sam,依赖安装不了;试验了英伟达的AI,NvidiaAIAssis,传服务器根本没反应,所有只有用了手动切割。不要求所有层面勾画,但是最好是典型层面都勾画一下,特别是有毗邻脏器密度相近的层面。点击3D后可能三维窗口未显示,可以调整一下窗口大小,有可能显示在我们看见的范围之外。早就准备更新这篇了,由于懒癌发作,一直早葛优躺,今天刚好有点时间,就简单写下来。

linjianping513的博客 5932

AI与大模型新闻日报 | 2026-11-11

今日 AI 圈动态速览:OpenAI 扩展 ChatGPT 商业功能:企业可认领资料并创建 AI 智能体,为 Business Agent 投放广告、谷歌最强 VLA 机器人模型:Gemini Robotics 2.5 登场,会系蝴蝶结、已在奔驰生产线上岗、挑战微软 Win11:原生 AI 系统 KORA 登场,将率先适配高通骁龙 X2 Elite 芯片、Meta的人工智能代理Muse登陆Apple Watch和Android Wear OS 等共 24 条新闻。

dozenyaoyida的博客 336

Spine换装系统深度优化:从局部换肤到动态合批的进阶之路

本文深入探讨了Spine换装系统的性能优化策略,从局部换肤到动态合批的进阶技术。通过分析传统方案的性能瓶颈,提出动态合批、GPU Instancing等高级优化方法,显著降低Draw Call和内存占用,提升游戏性能。适用于MMO和大型游戏开发,帮助技术美术和工程师突破大规模换装场景的性能限制。

vulkan6gpu的博客 554

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 161

educoder实训——计算几何形状的表面积与体积

educoder python实训

qq_41234663的博客 1230

WPF实战项目十七(客户端):数据等待加载弹框动画

1、在Common文件夹下新建文件夹Events,新建扩展类UpdateLoadingEvent。2、新建一个静态扩展类DialogExtensions来编写注册和推送等待消息弹框方法。3、在ViewModel中添加实现类NavigationViewModel。5、在View文件夹下新建用户控件ProgressView.xmal。4、在主窗体MainView.xmal中给弹窗界面命名。6、在MainView.xmal.cs中注册消息。

yigu4011的博客 2348

ChatGPT批量导出没有PDF模式?“AI导出鸭”正在重新定义AI内容归档的底层逻辑

摘要(149字) AI导出鸭插件突破性解决了ChatGPT等平台内容无损导出PDF的难题,尤其针对批量处理LaTeX公式、Mermaid流程图等复杂元素。其技术核心通过虚拟DOM比对生成矢量PDF,实现文本可复制、公式不失真、流程图高清渲染,并支持多对话合并导出。相比传统截图式工具,它构建了从AI对话到可交付文件的生产力管道,满足开发、教育等场景的归档需求。工具采用本地处理保障隐私,以“格式网关”架构重新定义AI内容落地的优雅方式。

rteertreerte的博客 112

r3live 使用前提 雷达-相机外参标定 livox_camera_lidar_calibration

港科大livox_camera_calib虽然操作方便,但是使用mid360雷达会有视角问题(投影三维点到相机),尝试了很多场景,标定效果都不理想(推荐场景是楼梯间),看来港大的更适合avia之类窄角度的雷达。如果标定效果不好的话,就使用 getExt2节点,getExt1节点只优化外参,而getExt2节点在计算的时候会将一开始计算的内参作为初值和外参一起优化。一般使用getExt1节点即可,如果在外参初值验证过,并且异常值已经剔除后,优化还是有较大的残差,那么可以使用getExt2试一试。

z1872385的博客 2401

ChatGPT Businesses 与 Business Agents 实战:商家确权、商品 Feed、GEO 洞察和隐私治理

OpenAI 推出 Businesses in ChatGPT Beta。本文不止复述功能,而是从商家资料确权、商品 Feed、聚合洞察、Business Agent 对话边界与隐私治理出发,给出企业可执行的接入架构、数据质量规则、灰度上线流程和核对清单。

jerry764的博客 356

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

ChatGPT 已占 Google 搜索量 20%:搜索的“第二次战争“,买家从人变成模型摘要

OpenAI 官方确认 ChatGPT 搜索量已达 Google 总量的 20%,搜索市场的"买家"正从人转向模型。本文梳理搜索入口迁移、搜索 API 开放带来的价值链重排,以及企业应如何从"优化网页排名"转向"让模型采信"。

2601_96888293的博客 66

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

ChatGPT Images 2.6 更新备忘:GIF、参考图与 API 提速(官方 X 帖截图)

生成、参考图能力,以及 API 提速。我根据官方 X 帖和相关截图,把要点整理成了一篇备忘,方便对照查阅。这次更新,主要提到了更好的。

Maynor的博客 69

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

ChatGPT Images 2.6 商业落地与场景应用指南

本文聚焦电商与设计团队的视觉生产痛点,提出“人机协同”的AI高效工作流。通过十大实战场景,系统拆解商品图生成、海报自动化、风格一致性控制、提示词工程等关键环节,构建可复制、可量化的视觉生产管线。强调以标准化模板、模块化提示词与人机协作闭环,实现从构思到成图的极速落地,显著提升效率与质量,助力各行业实现视觉内容的智能化升级。

frt的博客 293

ChatGPT、Codex并发排查:Spring Boot接口没有报错,为什么线程池队列越来越长,最后整批请求超时?

Spring Boot接口没有报错,CPU和数据库连接池也正常,为什么线程池队列却越来越长?本文从订单服务任务积压故障切入,分析无界队列、最大线程数、CallerRunsPolicy、下游阻塞和任务背压机制,并介绍通过Codex辅助定位线程池瓶颈的方法。

2601_96380027的博客 167

ChatGPT收录优化怎么做:荷里购科技拆解认领与监测

第二,把企业信息填准确,尤其是网站、业务描述、产品类别、退换政策,这些是ChatGPT回答问题时可能引用的素材。抖店后台的“豆包运营”专区按“看数据、找商机、优化商品”三步走,经营数据看曝光、点击、成交、退款等指标,商机词用于选品上新,购前核心决策信息用于完善商品属性与卖点。ChatGPT的提及不是提交出来的,是被引用出来的。据企业介绍,GEO特工队AI覆盖豆包、DeepSeek、Kimi、通义千问、ChatGPT、Gemini、Perplexity等国内外主流AI平台,适合需要双生态布局的出海品牌。

2601_96569777的博客 184

ChatGPT、Codex工程实战:Kubernetes滚动发布时,Spring Boot正在处理的请求为什么还是会被中断?

本文从Java订单系统生产故障切入,分析Readiness Probe、EndpointSlice、preStop、SIGTERM、Tomcat优雅停机和terminationGracePeriodSeconds之间的关系,并介绍通过Codex还原Pod终止时间线、排查502和Connection reset的方法。

2601_96380027的博客 502

企业在哪里使用 ChatGPT 和 OpenAI 模型?

以 GPT-6 Astra 为例,企业既可以直接调用 Amazon Bedrock API 使用该模型,也可以设置 ChatGPT Work、Codex,后端依托 Amazon Bedrock 上的 GPT-6 Astra 完成推理计算。这样 OpenAI 模型不再是独立外部服务,能够和 Amazon Bedrock 上其他厂商基础模型归入同一企业模型池,企业可以结合业务指标持续对比各模型的能力、延迟与成本。ChatGPT、Codex、OpenAI 模型彼此关联,但在企业架构内承担不同职能。

JINGdigital_的博客 204

用ChatGPT把截图表格转成Excel:编号、日期和合并单元格怎么保留?

截图转成Excel后,编号丢零、日期被自动改写、合并区域漏填,往往比识别错一个字更难发现。本文用6条虚构订单演示转录、整理和导出流程,附三段可复制提示词、截图样例与Excel参考表,说明长编号、空值和合计行如何核对

海波的专栏 196

2026年 ChatGPT Plus 国内开通完整教程:Account ID 免密操作

对于国内用户来说,开通 ChatGPT Plus 的难点往往不在选择套餐,而在支付条件和后续交付流程。如果所在地区和支付方式符合要求,建议优先从 OpenAI 官网完成订阅。如果需要了解其他服务方式,可以重点比较账号信息要求、付款流程、订单查询和退款机制。使用 Account ID 时,只应提供必要的标识信息,不要交出账号密码、验证码或完整会话数据。无论通过哪种方式开通,最后都应该回到自己的 ChatGPT 账号,确认套餐确实已经生效。

shennv888的博客 328

[LangChain] 学习笔记(04):手搓 ChatGPT 打字机——流式输出(SSE)与模型初始化选型

流式输出基于SSE协议,实现边生成边推送,消除用户等待焦虑。推荐使用ChatOpenAI+base_url对接兼容OpenAI的国内模型(如DeepSeek),兼容性强、依赖少。同步场景用stream(),Web后端必须用astream()异步处理,避免阻塞。通过configurable_fields和config_prefix可动态配置模型参数,多模型时需加前缀隔离。Windows下需设置WindowsSelectorEventLoopPolicy解决异步报错。关键:print(chunk, flush=

一名在 Linux 与 C/C++ 世界里打怪升级的开发者。持续输出系统编程、网络编程、数据结构与算法的高质量学习笔记与实战总结 414

主流AI编程智能体算力架构实测:8大平台模型费率分析与本地配置避坑指南

本文深度评测华为云、智谱、商汤等8大AI编程平台,剖析其算力配额、模型费率与获取路径。核心结论:构建多平台算力储备池可实现低成本高吞吐开发。推荐策略包括:利用免费模型(如GLM-5.3-Flash)、完成三端协同领9000积分、夜间低峰调用3亿Token、通过学生认证获额外奖励,并善用零费率通道与每日签到积分。实测显示,合理配置可使算力成本降低70%以上,显著提升开发效率。

艺杯羹的博客 203

【AI编程】AI⼯具链全景

✌全网粉丝24W+,优快云博客专家、Java领域优质创作者,掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域✌。

No8g攻城狮的博客 185
上一篇: 【震惊】多模态大模型集体“翻车“!空间智能评测基准揭示AI致命短板,开发者必看
下一篇: 震惊!30B参数碾压GPT-5?MiroThinker 1.5开源大模型杀疯了!小白程序员必学的“交互式智能“新范式,降本增效还能跑赢235B!内卷时代的新出路!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值