手把手给你的视觉大模型“瘦身”!「蒸馏+微调」实战指南,从庞然大物到丝滑YOLO,一篇搞定!

边缘计算机视觉实战:轻量化模型、硬件选型与部署全解析 计算机视觉(CV)技术正从云端向数据产生的源头——边缘侧迁移,这一变革的核心驱动力在于对实时性、隐私保护和带宽效率的迫切需求。其技术原理在于,通过模型轻量化(如知识蒸馏、量化)、专用硬件加速(NPU、边缘GPU)以及高效的软件工具链,将复杂的AI模型“瘦身”并部署到资源受限的终端设备上。这项技术的价值在于实现了数据的本地化即时处理与决策,降低了云端依赖和传输成本。其应用场景广泛覆盖了工业质检、智慧安防、自动驾驶等需要低延迟、高响应的领域。本文聚焦于边缘CV落地的关键技术栈,深入探讨了如YOLO、Mobile 阅读详情

前面我在阿里发布了Qwen3-VL视觉语言大模型之后,我测试了一下Qwen3-VL中对应的2d 对象检测的能力,有不少同行留言,虽然可以做到零样本,但是由于视觉AI大模型部署成本很高,推理很慢,基本上只能用到一些对实时性要求不高的场景中。

但是大家对于「实时视觉模型+视觉大模型」组合都还是非常感兴趣,比如Ultralytics发布的这个使用「YOLO + GPT5-mini」的组合来进行车牌实时跟踪识别的这个场景,通过YOLO来识别车牌框,GPT5-mini则OCR识别具体的车牌号。

当然他们这个大模型也是通过接口来调用的,也没有解决接口调用比较慢的问题,所以现在也有一种趋势就是通过「预训练蒸馏+自动标注微调」的方法来通过大模型提高实时小模型在特定的场景上的精度。

比如最近开源的一个自监督训练框架lightly-train,这个框架通过无标签样本数据的自监督训练实现预训练将类似dino v3这类视觉大模型蒸馏到类似yolo这类小模型中,然后再基于这个基于行业数据的预训练模型再进行有标签的微调训练,也就是我们平时使用yolo都会做的工作,这样使用「预训练蒸馏+微调」的组合之后,可以使得yolo使用更小的微调数据就可以取得更高的精度。

一、预训练蒸馏

8月份Meta发布了最新的dino v3模型,dino v3使用70亿参数和17亿张图片进行训练,远超前代模型,它在不依赖任何人工标注的情况下,仅通过大量未标记图像进行训练,就能生成高质量、通用的视觉表示,而且他还基于遥感数据做了预训练,得到了预训练模型SAT-493M,如下就是针对遥感输入输出的feature similarities的可视化。

但是由于dino v3是一个骨干模型,要实现目标检测还需要借助Grounding DINO这种框架,目前Grounding DINO还没有更新到相应的版本,但是现在也有基于dino v3的EoMT和DEIMv2,分别实现分割和目标检测。

而DEIMv2为了提高实时性的要求就提供了蒸馏的小模型版本,而lightly-train恰好也提供了一个非常简单的通过基于教师-学生网络架构的自监督的方式进行dino v3到yolo或者DETR类模型的蒸馏。

  1. 特征提取:教师模型生成图像的高质量特征表示,学生模型学习生成相似的特征表示。

  2. 损失函数:特征蒸馏损失,最小化教师和学生特征的差异,优化小模型参数。

反映到实际代码层面,主要是这一段代码:

我这边是使用了dinov3_vitl16_pretrain_lvd1689m-8aa4cbdd.pth作为教师模型,使用了yolo11s作为学生模型,使用无标签的VisDrone2019作为训练的数据。

不过现在Meta对于dinov3的预训练权重有限制,必须要邮件申请,很容易被拒,如果是直接使用modelscope也可以下载到,但是不是pth格式的。

在训练部分,可能需要的资源比较大,这部分我是直接使用了modelscope的GPU免费资源来训练的,大家也可以自行申请使用。

这个预训练好了导出的就是一个pt文件,然后再基于这个pt文件再继续做微调就好了,以前我们都是直接下载官方的一些预训练权重,比如基于coco数据集的预训练权重。

二、自动标注微调

当然除了这种预训练阶段我们可以借助大模型的能力,在微调阶段,我们也可以利用目前大模型的零样本目标检测能力,对我们需要标注的数据进行自动化的标注,然后人工进行误检和漏检查的删除和新增,这样也可以大大提升我们在微调阶段制作样本数据的效率。

我这边主要尝试了基于GroudingDINO和Qwen3-VL的自动标注,因为这种自动标注对实时性要求不高,所以应用大模型是完全可以接受的,总的思路是:

1、自动读取视频帧调用大模型检测,配置好视频的输入、数据集输出、要检测的类别、视频帧采样间隔、置信度阈值,yolo数据集train/val/test的划分比例等,就可以执行了,提取检测结果并将转换结果转换成为Yolo数据集的格式;

GroundingDINO版本我使用的是hugging face上的IDEA-Research/grounding-dino-base权重,在实际推理的时候会存在一定的漏识别和误识别的问题,比如针对无人机航拍的视频这边的车辆就会漏掉。

这个部分就需要使用手动的标注工具,将这部分标注上去。

但是Qwen3-VL对一些基本上对正常目标不存在漏识别的问题,对细小的人物识别的也比较准确,这些这些目标不放大仔细看自己都可能会漏掉。

还有这种跑道的的人也都会识别出来。

但是也会有一些异常情况,比如这边的一群人,他不是单独的把每个个体识别出来,而是更倾向于把这一群识别出来,但是感觉这个问题直观感觉是可以通过提示词的优化来改进的,这也是视觉语言模型和单纯的视觉大模型之间的一些区别。

2、针对输出的Yolo数据集进行人工的复合,错误的删除,缺少的再新增标注;

所以如果你有公网环境且不存在数据安全性的问题可以考虑优先使用Qwen3-VL的自动标注版本,如果你是在隔离的环境下可以使用Ground ingDINO的版本。

总体体验下来,这种自动标注模式可以选择目标区域多个航路的视频数据,然后进行自动化标注,人工主要做的活就是相关的复核工作,所以效率和体验都是有所提升的。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
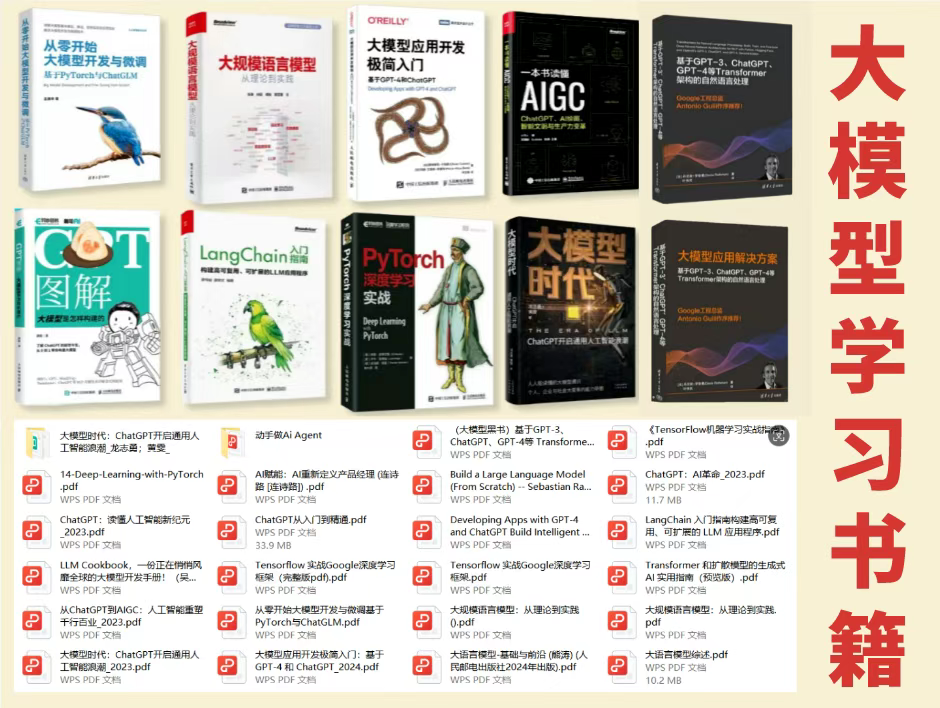
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
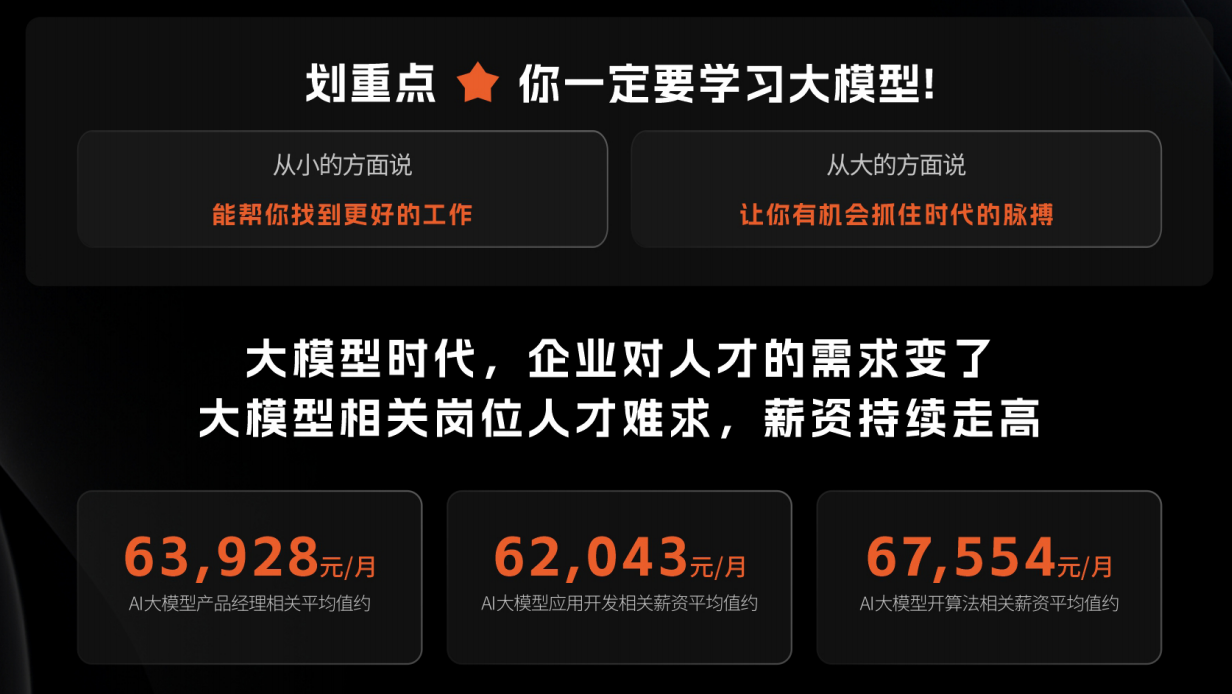
在这里插入图片描述

适合人群

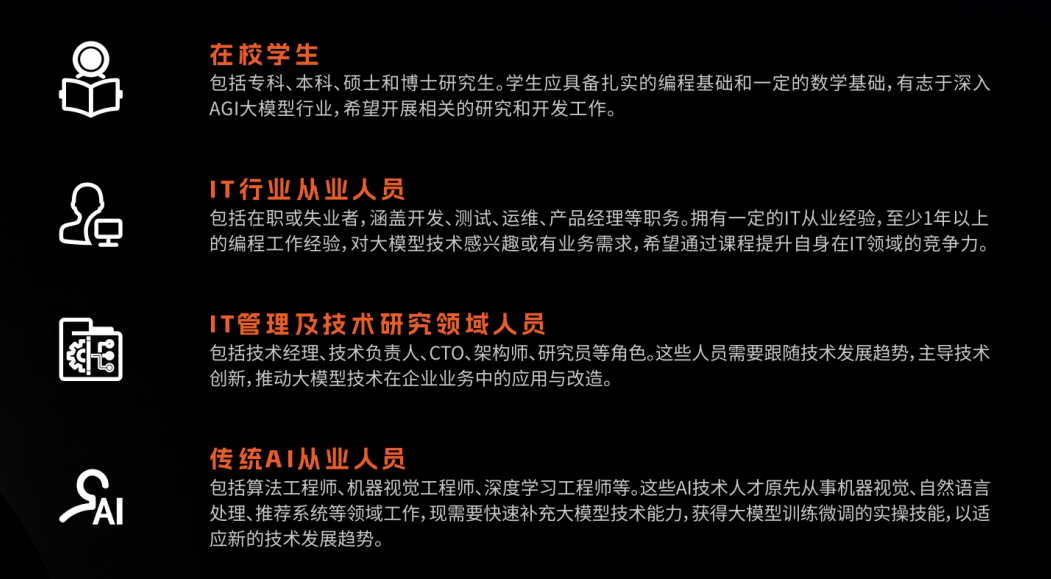
  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

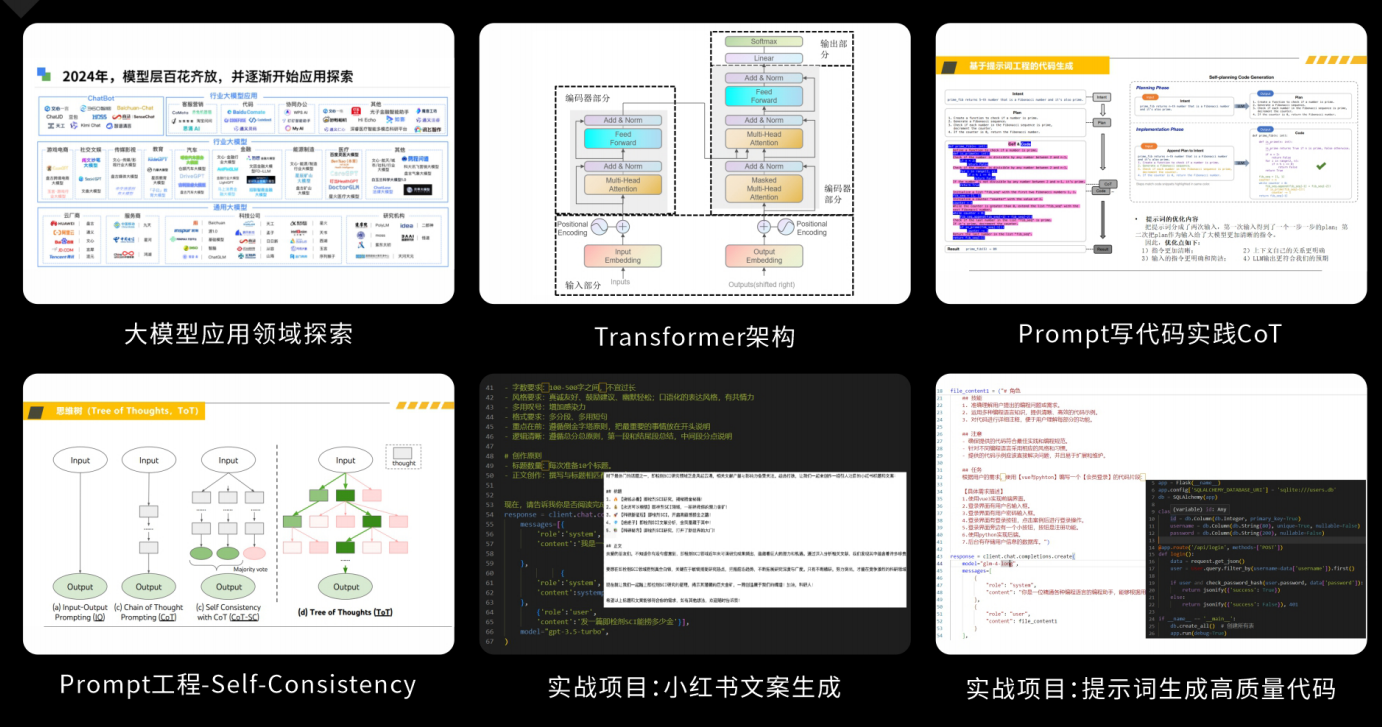
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

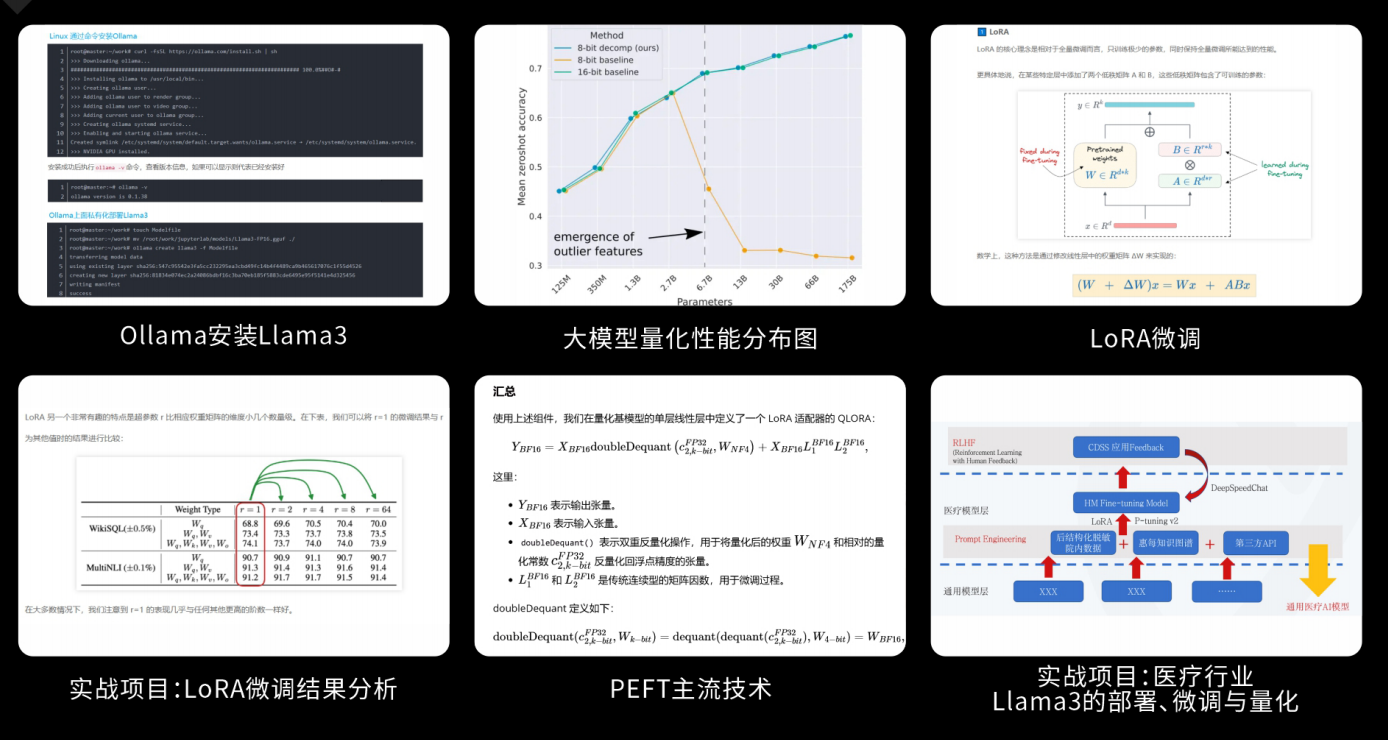
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

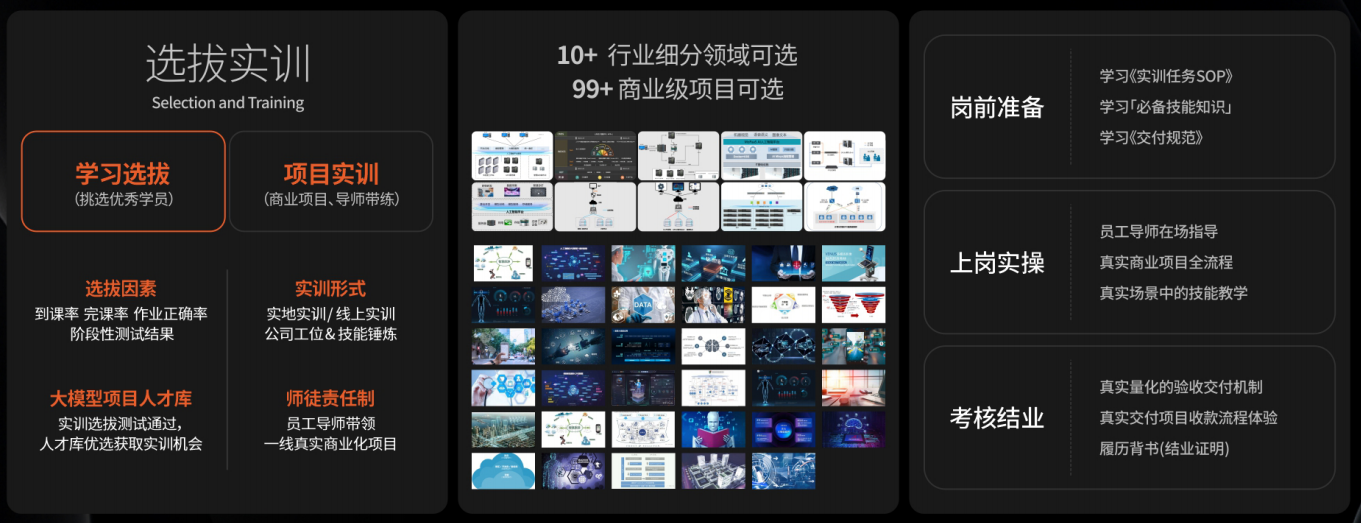
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

AI模型轻量化实战:从架构设计到STM32边缘部署全流程解析 模型压缩与优化是深度学习工程化落地的关键技术,其核心原理在于通过剪枝、量化、知识蒸馏等方法,在保证模型性能的前提下,显著减少其参数量、计算复杂度和存储开销。这项技术的核心价值在于打破算力与能耗限制,使得复杂的AI模型能够部署到资源受限的边缘设备上,从而赋能工业质检、智能安防、移动终端等实时性要求高、数据隐私敏感的应用场景。本文聚焦于AI模型轻量化的完整技术链路,深入剖析了以MobileNet、GhostNet为代表的高效架构设计,并结合模型剪枝、INT8量化等热词技术,详细阐述了从训练优化到在STM32H7 阅读详情

相关推荐

dinov3_vits16plus_pretrain_lvd1689m-4057cbaa.pth

dinov3_vits16plus_pretrain_lvd1689m-4057cbaa.pth

【工具】DINOv3:Meta AI的突破性自监督视觉模型(模型获取、推理)

​DINOv3(Distillation with No Labels v3)是一个最先进的自监督视觉变换器(Vision Transformer,ViT),能够在没有任何人工标注的情况下学习视觉表示。作为Meta AI开发的自监督视觉基础模型,DINOv3显著扩展了早期DINO/DINOv2方法,将模型规模扩大到约67亿参数,训练数据规模扩大到精选的17亿张图像。

潘小蓝的博客 5580

Gaze-LLE-DINOv3:基于大规模学习编码器与 DINOv3 的注视目标估计.zip

Gaze-LLE-DINOv3:基于大规模学习编码器与 DINOv3 的注视目标估计.zip

DINOv3权重文件下载

DINOv3权重文件下载指南 DINOv3是Meta推出的高性能视觉基础模型,包含12种变体(10个基于LVD-1689M数据集,2个基于SAT-493M卫星数据集)。模型采用ViT架构,支持16的补丁尺寸,可处理224x224或更大尺寸的输入图像。目前权重下载可通过两种方式: HuggingFace(当前需权限申请) GitHub仓库(填写申请表单后获取下载链接,建议使用美国IP和Gmail邮箱提高成功率) 相关资源包括GitHub仓库、HuggingFace集合页和arXiv论文。

qq_53644346的博客 1万+

Meta Dino-V3视觉AI[可运行源码]

Meta Dino-V3是一款无需监督标签的视觉基础模型,能够学习图像的密集特征,适用于分割、对象跟踪、深度估计等多种任务。该模型基于70亿参数的Vision Transformer(ViT-7B),通过170亿张Instagram图像进行训练,并采用分层k均值聚类和基于检索的抽样方法整理数据。Dino-V3引入了Gram Anchoring技术,防止特征在长时间训练中退化,并支持高分辨率输入。模型训练完成后无需微调,可直接应用于多种任务,性能优于DINOv2、CLIP等模型。此外,Meta还提供了多个蒸馏版本的小型模型,便于实际应用。Dino-V3的突破在于其无需监督标签、处理密集和全局任务的能力、可扩展性以及广泛的适用性,使其成为自监督视觉领域的重要里程碑。

音频质量评估指标全解析:从主观到客观的全面指南

本文全面解析了音频质量评估的核心指标,涵盖主观评价(如MOS、DMOS)与客观评价(如PESQ、STOI、SDR)。重点介绍了DNSMOS等AI驱动的无参考评估方法,并提供了根据语音通信、噪声抑制、语音分离等不同场景选择指标组合的实战指南,帮助开发者和研究者科学量化音频质量。

rum55的博客 641

嵌入式设备上的深度学习模型轻量化与实时推理优化

本文深入探讨了在资源受限的嵌入式设备上部署深度学习模型的核心挑战与解决方案。重点介绍了模型轻量化的关键技术,包括剪枝、量化和知识蒸馏,并分析了如何结合硬件平台与推理引擎进行协同优化,以实现高效的实时推理。文章以YOLO模型在树莓派上的部署为例,提供了从模型压缩到系统调优的完整实战指南。

w1x2y3的博客 258

IMU卡尔曼滤波方法详细介绍

本文介绍了基于IMU和卡尔曼滤波的状态估计方法。系统采用9维状态向量(位置、速度、加速度计零偏),通过牛顿运动学建立状态方程,并利用外部位置观测进行校正。详细推导了状态转移矩阵和控制输入矩阵的形式,阐述了预测和更新的计算步骤。同时说明了过程噪声Q和观测噪声R的设置原则,其中Q反映模型不确定性,R取决于传感器精度。该方法可有效融合IMU测量与外部观测数据,实现位置、速度和偏置的联合估计。

haing2019的博客 754

Python深度学习:从入门到实战

亲爱的读者,欢迎您翻开这本书。我们即将探索的,是深度学习的宇宙——一个由数据、算法与算力构筑的奇妙世界。它既是严谨的科学,也是创造的艺术,更是一条通往未来智慧的修行之路。本书将带您从最基础的数学原理出发,亲手搭建神经网络,驾驭Transformer等前沿模型,最终将智慧转化为现实世界的价值。请放下畏惧,保持好奇。这不仅是一次知识的学习,更是一场思维的远行。来,随我一起,开启这趟非凡的旅程吧。

YunWisdom 162

如何解决ipa包上传App Store Connect时出现的无效二进制文件问题

本文详细解析了ipa包上传App Store Connect时出现无效二进制文件问题的常见原因及解决方案。从Scheme配置、架构支持到权限声明,提供了全面的检查步骤和实用技巧,帮助开发者快速定位并解决上传问题,确保应用顺利通过审核。

weixin_28833069的博客 314

STM32 HAL库定时器中断里读编码器速度准吗?聊聊MG310电机的测速与防溢出处理

本文探讨了STM32 HAL库在定时器中断中读取编码器速度的精度问题,特别针对MG310电机的测速与防溢出处理提供了解决方案。通过对比定时中断法和编码器模式的性能,揭示了硬件编码器接口在降低误差和CPU占用率方面的优势,并详细介绍了CubeMX配置技巧和防溢出处理的工程实践。

weixin_28720767的博客 400

dinov3+mmdet做目标检测。

dinov3蒸馏出的几个小模型,冻结后用于检测和分割训练效果是不错。不用训练主干,省时、省显存。为社么 base 模型对比 tiny 模型没看到优势呢?难道是我数据太少了?7B模型应该是个好东西,大力出奇迹。

weixin_45537132的博客 4239

手把手教你学Simulink--基于Simulink的高增益DC-DC变换器仿真建模

特点高电压增益:可以在不使用变压器的情况下实现较大的电压升压比。适用于低电压源:如太阳能电池板、燃料电池等提供的低压直流电源。效率问题:设计时需特别注意提高效率,减少能量损失。挑战电路复杂性:通常涉及多个电感和电容,以及复杂的开关模式。元件选择:合适的元件参数对于达到理想性能至关重要。控制策略:确保高效稳定运行的同时,适应负载变化。首先明确要模拟的任务内容。实现特定的电压增益比(例如从24V升至380V)。根据预期的输入输出电压确定合适的电路拓扑和元件值。

MHD0815的博客 172

DINOv3 重磅发布

DINOv3重磅发布,太强了

weixin_51995147的博客 2567

硬件基础知识-电机知识

步进电机存在空载启动频率,所以步进电机可以低速正常运转,但若高于一定速度时就无法启动,并伴有尖锐的啸叫声;在非超载的情况下,电机的转速、停止的位置只取决于脉冲信号的频率和脉冲数。给电机两根线供电,电机就可以旋转,给正电压,电机正转,给相反电压,电机反转;电压越大,电机转得越快,电压越小,转速也变小。是一种直流电机,有刷电机的定子上安装有固定的主磁极和电刷,转子上安装有电枢绕组和换向器。控制器:使用专用的电子控制器来监测和控制电机的转速、电流和方向。线圈电流方向的交替变化是随电机转动的换相器和电刷来完成的。

weixin_46969363的博客 2294

openssl命令数据摘要详解(SM3、sha256、MD5、dss1、mdc2、ripemd160)

SM3是由中国密码学家设计的密码哈希函数,是中国国家密码管理局(National Cryptographic Authority,简称:CNCA)颁布的国家密码算法标准。SM3属于密码杂凑函数家族,它可以计算任意长度的消息并生成固定长度(256比特,即32字节)的哈希值。SM3生成的哈希值长度为256比特(32字节),不管输入消息的长度如何,输出始终是固定的。SM3将输入数据划分为512比特(64字节)的分组,并对每个分组进行处理。

N阶二进制的博客 4460

DINOv3 + YOLO26 实战指南:如何用自监督学习把目标检测精度再拉高 10 个点?

训练过程中,它用 Gram 矩阵来约束特征分布,防止模型"躺平"——学到的特征越来越简单、越来越没有区分度。YOLO 像是提前刷了大量真题(监督学习),它知道"这道题考的是猫"是因为它见过很多张标注了"猫"的图片。但遇到角度刁钻、光线诡异的猫,它就容易翻车。没有花里胡哨的理论,就是一步一步告诉你:怎么把 DINOv3 的特征提取能力嫁接到 YOLO26 上,让你的检测器真正"看得更准"。DINOv3 在海量无标注图像上预训练过,它已经知道"边缘是什么"、"纹理是什么"、"形状是什么"、"遮挡是什么"

datayx的文章 748

Python爬虫实战:高效爬取中国版权登记数据

本文将详细介绍如何使用Python最新技术栈构建一个高效、稳定的中国版权登记数据爬虫系统。我们将使用Playwright+Asyncio实现无头浏览器自动化,结合Redis分布式任务队列和MongoDB数据存储,打造一个能够应对反爬机制的企业级数据采集方案。文章包含完整代码实现、性能优化技巧以及法律合规建议,帮助开发者快速掌握大规模数据采集的核心技术。本文详细介绍了2024年使用Python最新技术栈构建中国版权登记数据爬虫的完整方案。基于Playwright的无头浏览器自动化。

2201_76125261的博客 1897

DINOv3

自监督学习有望消除对人工数据标注的需求,使模型能够轻松扩展到大规模数据集和更大规模的架构。由于不针对特定任务或领域进行定制,这种训练范式具有从各种来源学习视觉表示的潜力,能够使用单一算法处理从自然图像到航空图像的广泛数据。本技术报告介绍了DINOv3,这是通过利用简单而有效的策略实现这一愿景的重要里程碑。首先,我们通过精心的数据准备、设计和优化,充分利用了扩展数据集和模型规模的优势。

AI浩 2984

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

dinov3 foreground_segmentation.ipynb魔改py ,不走torch.hub 训练

pkl。

brepnet uvnet 504

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

上一篇: 让你的AI走向世界!多语种数据集建设终极指南,从原理到实践,收藏这一篇就够了!
下一篇: 智能简历筛选从入门到精通:LlamaIndex+LangChain实战万字长文,从框架到代码全讲透,收藏这篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值