保姆级教程!手把手拆解Transformer:像“万能翻译官“的神经网络,从入门到精通一篇封神

Transformer模型架构的原理和工作方式 Transformer 是一种基于注意力机制的模型架构,最早由 Vaswani 等人在 2017 年的论文《Attention Is All You Need》中提出。它的设计彻底改变了序列数据的处理方式,特别是在自然语言处理(NLP)领域。与传统的循环神经网络(RNN)和长短期记忆网络(LSTM)相比,Transformer 在捕捉长距离依赖和训练效率方面具有明显的优势。 阅读详情

花了一点时间来学习和研究经典的transformer架构及原理,这个是2017年谷歌的一个论文,开拓了AI的新时代,尽量通俗易懂的解释一下,做好笔记把它记录下来。

先看下整体的架构图:

有几个部分,举个例子来说,比如“请介绍一些《孙子兵法》这本”,这13个词,咱们先暂定26个token哈。主要用于后面举例说明。咱们分开来理解,先看左边部分。

1、tokenization原理,对应的是token化,在输入的语句中进行token化,一般而言,一个100token个对应50给汉字,100个token对应75给英文单词,是一个分词拆分法,大家有没有想过,为什么不是一个汉字或者一个英文单词对应一个token呢?如果一个字或者一个单词对应一个token,那么这个token词表会一直变大,因为有一些新的字出现,其次,像,河,海,英文happy,unhappy,happiness,可以复用token的,最后,分词拆分法也是可以增加一些语义的理解。像上面例子一看就知道一些意思。

2、词元嵌入表示,embedding模型,就是将token进行向量化,计算机的世界是识别数字的,万事万物皆可向量化。向量空间即是特征,我们可以从向量中提取特征,所谓的特征工程。向量化里有一个one-hot编码,一个token对应是一个512维的向量(transfomer是512维的向量),一个1和其他维度都是0,这种编码也是有问题的,就是在整个向量空间里第一是太稀疏了,第二没有距离,第三没有数量关系或逻辑关系。

3、位置编码positional Encoding,就是定义一个向量表示词的位置,有了这个向量是增加语义的理解,比如“狗咬了猫”,“猫咬了狗” 字是一样的,但是位置不一样,他们的含义也是不同的。这个向量也是512维。

4、这时候看图才进入编码器Encoding,编码器包含2个部分,一个是多头自注意力机制,另外一个是位置感知前馈神经网络

多头注意力机制,公式是Attention(Q,K,V)=softmax(Q*K(T)/开根号dk)*V 不会弄就中文解释下,这公式的意思是,请把注意力放到重要的信息上。咱们先了解什么是注意力机制?什么是自注意力机制?什么是多头注意力机制?

看如下图来理解注意力机制

这个图是理解为一维的,也增加二维(身高178,腰围38),对应的K也要是二维的(身高,腰围),V值也加,比如预测(体重,腿长),还可以是多维的,大脑里细品哈,只要有数据,任何东西都可以预测。

自注意力机制,核心是做信息的聚合,就是自己跟自己去比较计算,想像一下,前面例子26个token,对应26个向量,对应是26个512维的向量空间,结合上面的图,把所有的数据替换成26个512维的向量值,然后按照图的计算公式进行计算,得到的值也是一个26个的512维向量。(V中智是每个向量的加权求和)

多头自注意力机制,引入多个专家去关注不同的注意点,然后再进行自注意力机制的计算,但是transformer里面引入了神经网络进行了向量的线性的变换。比如原始的26*512维向量,进行向量变换,生成3个不同的Wq,Wk,Wv向量,这个经过神经网络的线性变换后,从而突出某些需要突出的,弱化某些需要弱化的。

纯写文字,可能不太好理解,结合上面图来理解一下。上图分左/中/右

中间输入是26*512维的向量,经过linear线性变换后,看左边的图,Q和K和V变换成26*(512/8=64)维的向量了,通过Scale缩放点积和softmax。后面的concatenate将8个26*64的向量合并,最后输出是26*512维的向量。

然后再说下位置感知前馈神经网络,就是一个全连接的神经网络,输入的26*512维向量 经过线性变换,激活函数变成26*2024维的向量,再转换变成26*512的向量进行输出。

5、右边部分是解码器,从下往上看,前面的输出、token化、词元嵌入表示、位置编码这4部分跟编码器是一样的。不一样的是掩码多头自注意力机制、多头注意力机制

掩码多头注意力机制,原理跟自注意力机制一样,区别在于,可以理解为一个把答案遮住的,看上图,对角线的右边全为白色,对应向量里全部为0.

6、编码器与解码器的区别是编码器输出的是向量,解码器输出的是概率,编码器一般用来做分析,解码器一般用来做生成。

是编码器输出的是向量,解码器输出的是概率,编码器一般用来做分析,解码器一般用来做生成。

7、linear和softmxa概率函数,一个26*512维的向量经过linear后,形成跟最后一个向量的相关度系数,得到的相关系数后进行softmax进行计算到概率,按概率最高的词去预测下一个字。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
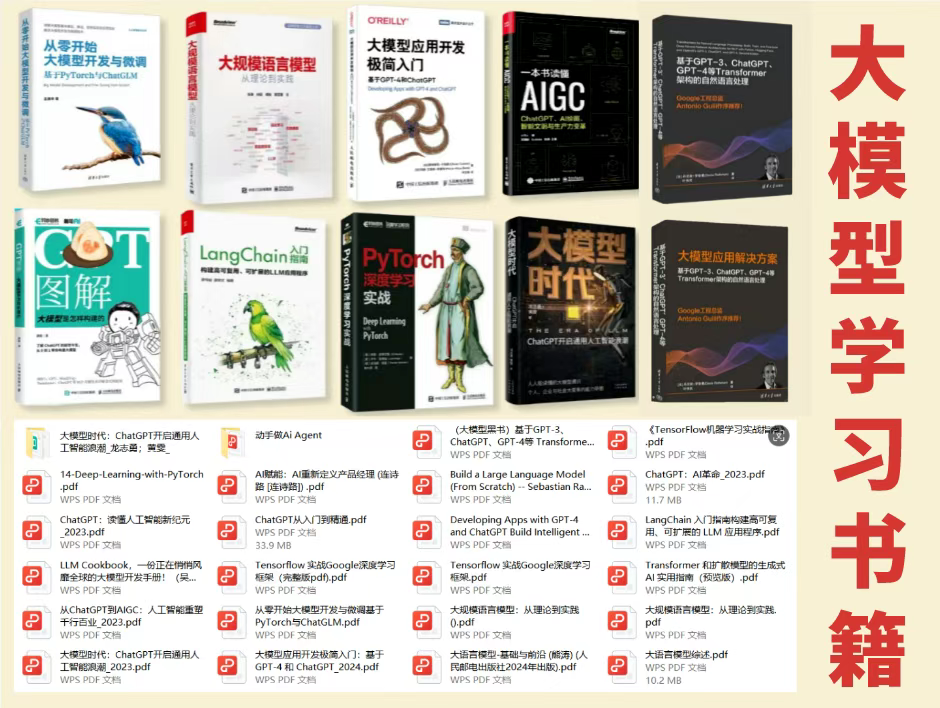
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
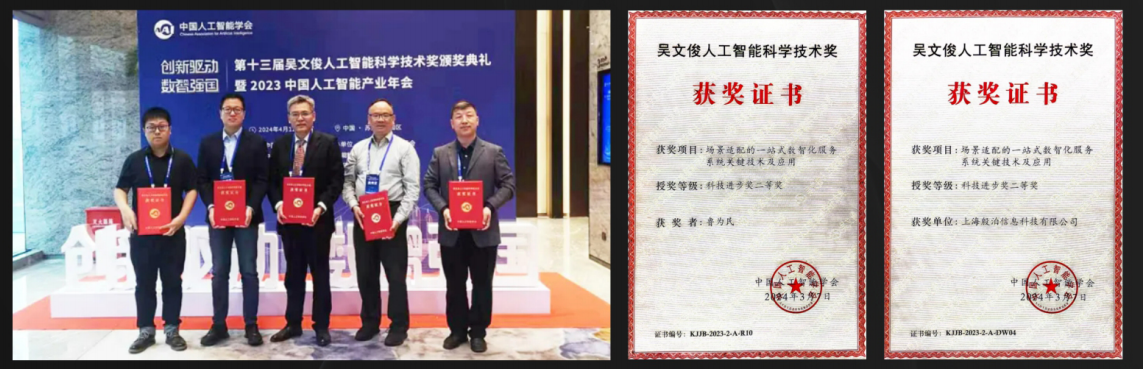
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
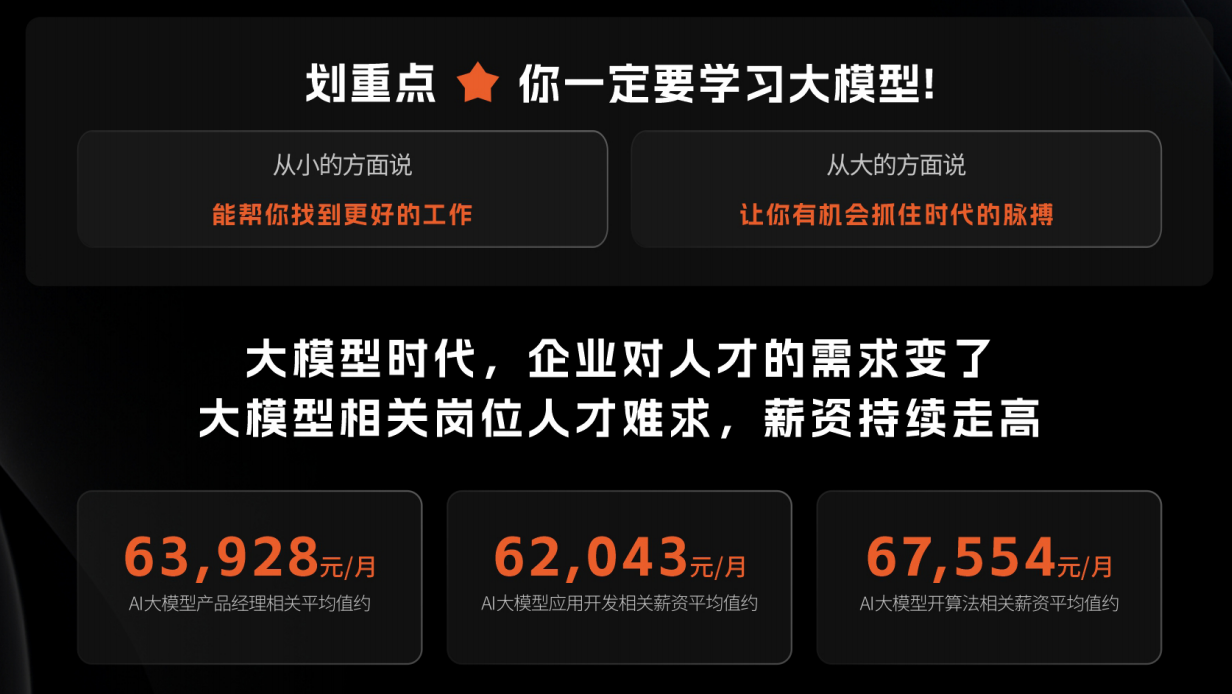
在这里插入图片描述

适合人群

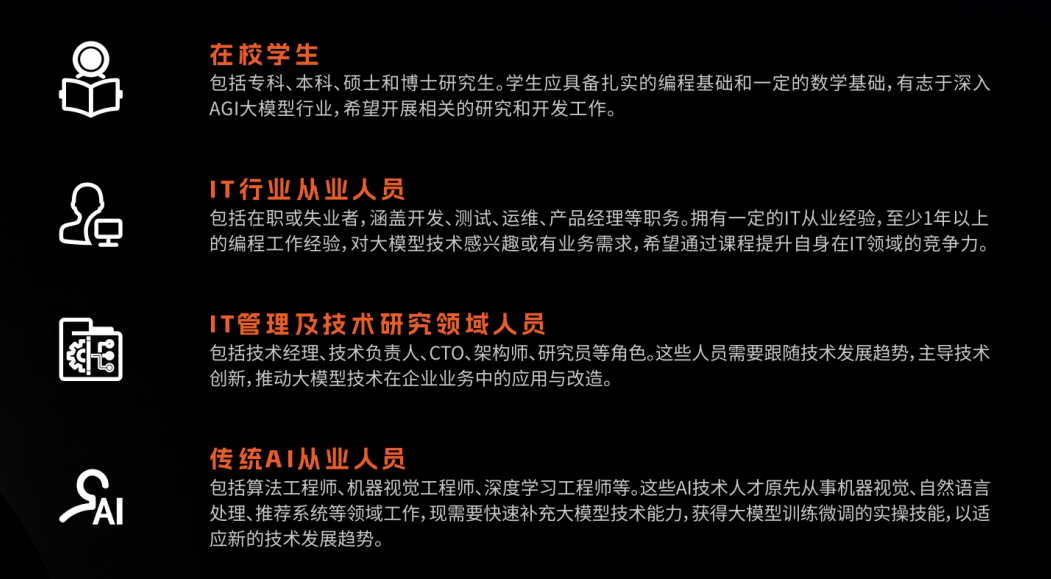
  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

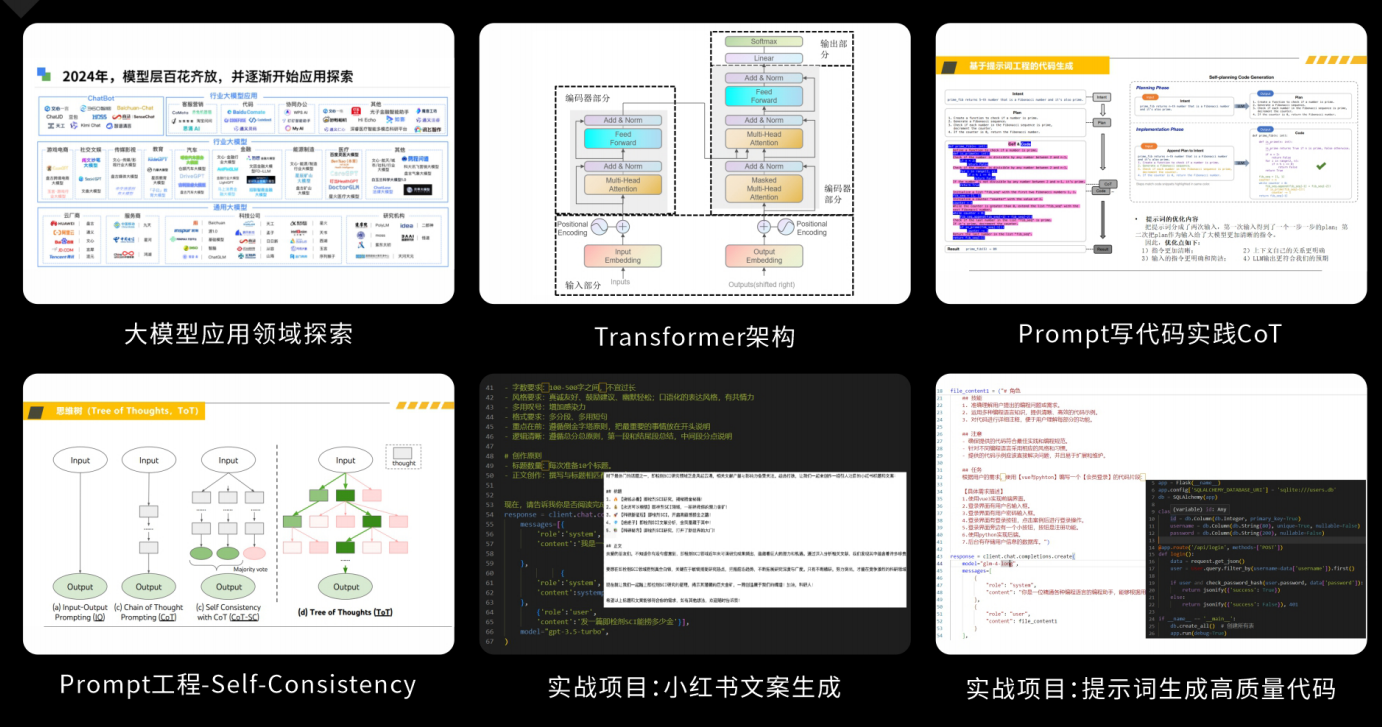
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

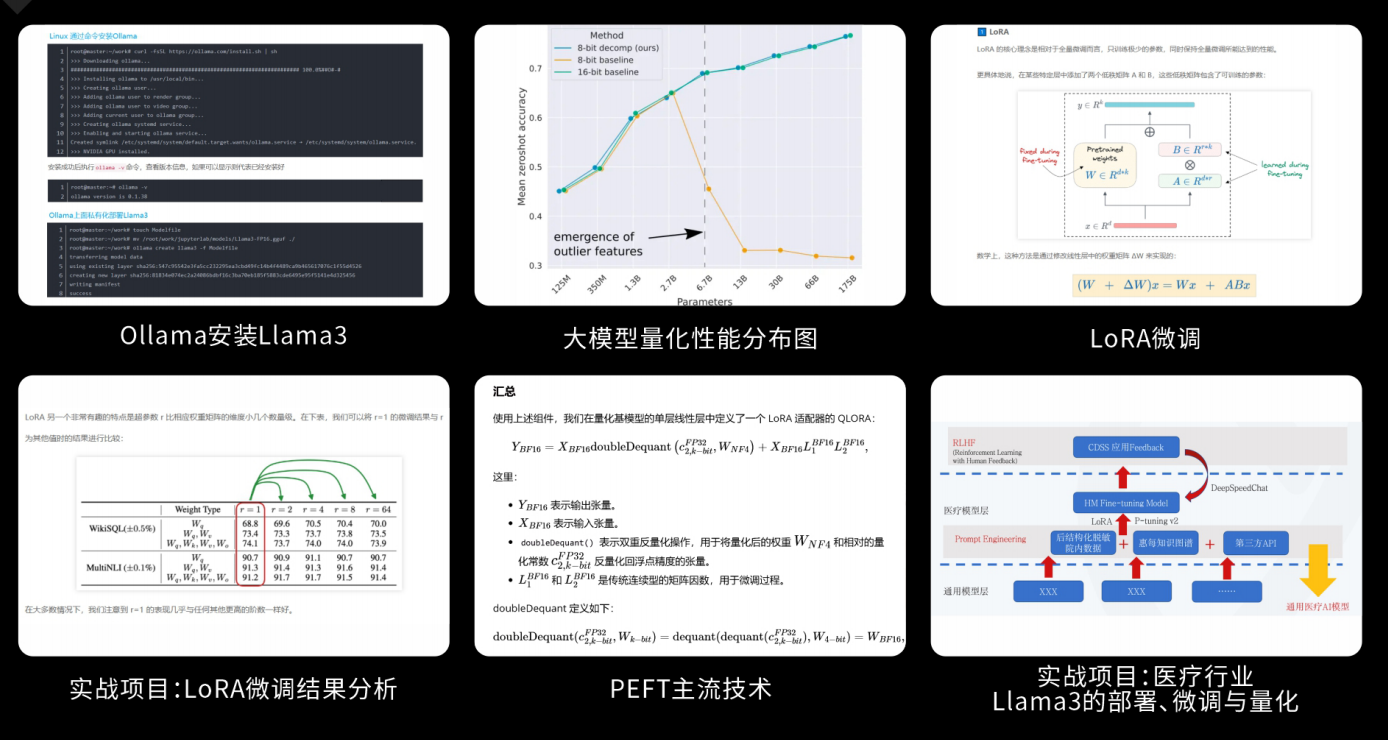
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

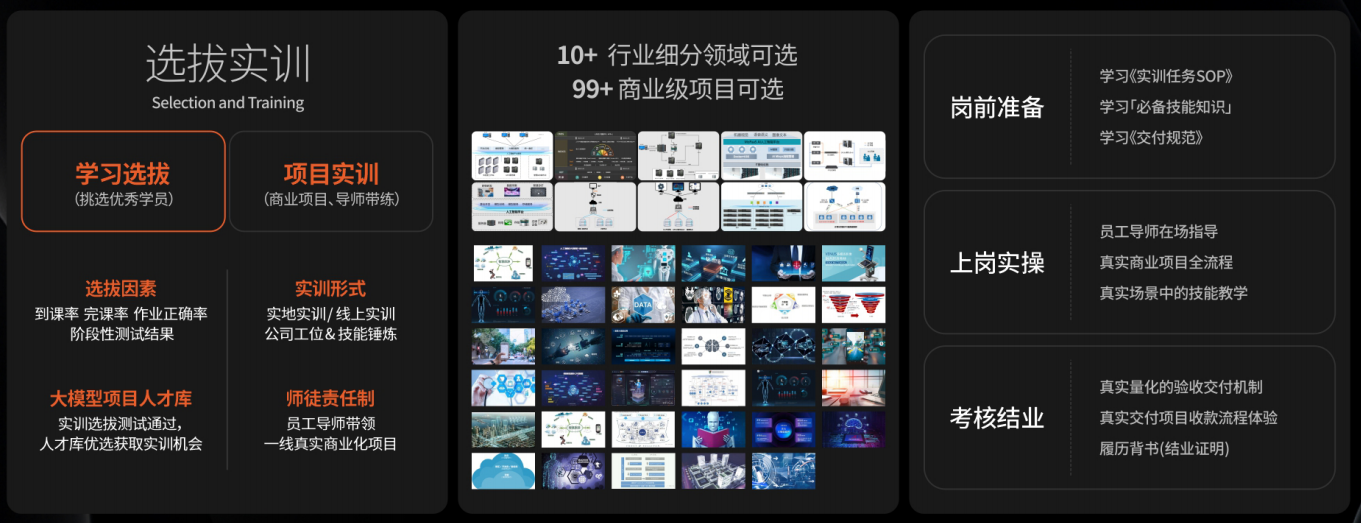
  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Transformer架构深度解析:从原理到实战的全面指南(附架构图与代码图解) 会用:能调用现成模型解决业务问题会改:能修改模型结构适配需求会优:能进行性能调优和部署会创:能研发新型Attention机制- [ ] 能徒手写出Attention公式- [ ] 能解释多头注意力的优势- [ ] 能实现位置编码的可视化- [ ] 能进行模型轻量化改造- [ ] 能处理超长文本输入掌握Transformer技术,就是握住了开启AI新时代的钥匙。现在就开始构建你的第一个Transformer模型吧!🚀。 阅读详情

相关推荐

【SPSS实战】手动实现Quade非参数协方差分析:从数据准备到结果解读

本文详细介绍了在SPSS中手动实现Quade非参数协方差分析的实战方法。当数据不满足正态分布等参数检验假设时,通过将协变量和因变量转换为秩,并利用秩回归残差进行Kruskal-Wallis组间比较,提供了一种清晰、可操作的近似解决方案。该方法有效解决了非正态数据的协变量调整问题,适用于实验研究和调查数据分析。

bean的博客 469

神经网络算法 - 一文搞懂 Transformer(总体架构 & 三种注意力层)

本文将从三个方面,带您一文搞懂**输入嵌入:将输入的文本转换为向量,便于模型处理。位置编码:给输入向量添加位置信息,因为Transformer并行处理数据而不依赖顺序。多头注意力:让模型同时关注输入序列的不同部分,捕获复杂的依赖关系。残差连接与层归一化:通过添加跨层连接和标准化输出,帮助模型更好地训练,防止梯度问题。带掩码的多头注意力:在生成文本时,确保模型只依赖已知的信息,而不是未来的内容。前馈网络:对输入进行非线性变换,提取更高级别的特征。

xxue345678的博客 3万+

GDI文字绘制和windows下opengl文字绘制小结

GDI绘制文字,要设置文字的属性,主要就是通过设置DC中的font对象来实现的。 font对象的创建可以由createfont()、createfontIndirect()来实现。 HFONT CreateFont( int nHeight, // height of font int nWidth, // average

T_W_S的专栏 5324

神经网络算法 —— 一文搞懂Transformer !!

本文将从Transformer的本质、Transformer的原理 和 Transformer架构改进三个方面,搞懂Transformer。一、Transformer的本质1. Transformer架构主要由输入部分(输入输出嵌入与位置编码)、多层编码器、多层解码器以及输出部分(输出线性层与Softmax)四大部分组成。Transformer架构(1)输入部分将源文本中的词汇数字表示转换为向量表示,捕捉词汇间的关系。为输入序列的每个位置生成位置向量,以便模型能够理解序列中的位置信息。

不要给自己设限,尝试更多可能(思所向 皆可往) 1万+

告别以太网瓶颈:手把手教你为AI训练集群搭建InfiniBand网络(以NVIDIA DGX A100/H100为例)

本文详细指导如何为AI训练集群搭建InfiniBand网络,解决以太网瓶颈问题,特别针对NVIDIA DGX A100/H100系统。通过硬件选型、网络架构设计和性能调优,显著提升多机多卡训练效率,适用于大规模模型训练场景。

weixin_30336061的博客 312

运营商技术岗一面面经:从面试流程到回答框架的复盘总结

面试本质上是一场信息匹配与表达能力测试,技术岗一面尤其看重候选人能否在有限时间内清晰展现思考路径。运营商技术岗面试虽涉及网络、系统等专业基础,但核心考察点往往在于结构化表达、抗干扰能力以及面对未知问题的分析逻辑。从自我介绍的项目细节,到项目经历中的回滚方案,再到Linux命令、Python脚本等基础技能,面试官更关注你如何组织思路、如何应对追问。这类一面场景常见于通信运营商、网络运维、IT支撑等岗位的招聘流程中。提前梳理高频问题框架,训练90秒内的高密度表达,并掌握有条件的表态策略,能显著提升面试通过率。这

weixin_28721917的博客 187

【原理篇】小白入门Transformer!一文了解Transformer架构

BART、PEGASUS 模型用于生成新闻摘要。✅。

m0_60302377的博客 8708

视觉Transformer实战 | 将卷积引入视觉Transformer(CvT)

CvT 是一种融合卷积神经网络与 Vision Transformer 优势的视觉模型,旨在解决 ViT 缺乏平移不变性和局部性等归纳偏置的问题。CvT 采用分层结构逐级降采样,使用卷积词元嵌入代替传统 patch 切分,引入卷积投影替代线性投影。这些设计使得 CvT 能够去除位置编码,在高分辨率输入下表现更优。本节深入解析 CvT 的核心原理,并提供完整的 PyTorch 代码实现,演示如何在实际数据集上训练和评估 CvT 模型。

盼小辉丶的博客 728

【超详细】【原理篇&实战篇】一文读懂Transformer

Transformer是一种用于自然语言处理(NLP)和其他序列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism),这是一个关键的创新,使其在处理序列数据时表现出色。

艰难困苦,玉汝于成。 68万+

【4. BSP开发指南 - [4.6. 安全启动使用说明]】

【4. BSP开发指南 - [4.6. 安全启动使用说明]】

Sugar_wolf的博客 276

脉冲变压器电感选型参数,结构原理,工艺与注意问题总结

脉冲变压器电感简称脉冲变压器,是一种特殊类型的变压器,主要用于处理脉冲信号。它的主要特性是能够在短时间内承受高电压和大电流。脉冲变压器主要用于开关电源、脉冲功率放大、雷达脉冲调制等领域。本文对脉冲变压器的工作原理,结构特点,工艺流程,选型参数及设计注意事项进行总结。

fydar的博客 1350

全面解析 Transformer:改变深度学习格局的神经网络架构

Transformer 是一种基于"注意力机制(Attention Mechanism)"的神经网络架构,主要用于处理序列数据。与传统的循环神经网络(RNN)不同,Transformer 通过并行计算和全局注意力机制,极大提升了模型的效率和性能。Transformer 的设计理念基于简单但高效的注意力机制,其并行化特性和强大的表征能力使其成为现代深度学习的核心模型。从 NLP 到 CV,再到多模态任务,Transformer 正在推动 AI 的新一轮变革。

qq_56683019的博客 1万+

OSPF规划两大模型:双塔奇兵、犬牙交错

大家好,今天给大家带来的是OSPF规划两大模型:双塔奇兵、犬牙交错,让我们直接开始吧! OSPF规划之双塔奇兵 说明: OSPF 如果某个区域存在两个 ABR,并且在两个 ABR 上都对 area n 内的路由做了聚合操作。 最佳配置: 两台ABR之间的红线应该使用以太网的子接口技术,一个子接口属于area0,另一个属于 area n;或者该链路规划为 area n,同时配置虚连接; ABR 的 loopback0 规划入 area 0 OSPF 规划之犬牙交错 说明: 有时接入层的设备会以乱序的

网络技术联盟站 2427

Transformer 架构详解:从基础原理到核心组件一文搞懂

Transformer 架构详解:从基础原理到核心组件一文搞懂

weixin_72959097的博客 6404

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Transformer原理讲解

Transformer是谷歌2017年发表的论文《Attention Is All You Need》中提出的,用于NLP的各项任务,其引入了自注意力机制(self-attention mechanism),具有长距离依赖关系建模、并行计算能力和通用性能优点,已广泛应用于系列数据的处理。在本文中,我们将从Transformer的整体框架、Encoder结构和输入输出、Decoder的结构和输入输出等方面,详细讲解Transformer的原理。

LFM3320829529的博客 2694

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Transformer架构原理完全解析:全网最完整专业细致

🚀 Transformer的三大创新:自注意力机制:完全替代RNN,解决长距离依赖问题位置编码:弥补注意力机制缺失的位置信息多头注意力:从多个角度捕捉不同类型的语义关系。

franktaoge的博客 3513

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

【Transformer系列】深入浅出理解Transformer网络模型(综合篇)

【Transformer系列】深入浅出理解Transformer网络模型(综合篇)

IT菜鸟 1万+

神经网络-Transformer

transformer架构主要由输入部分(输入序列和目标序列的向量表示与位置编码相加)、N层编码器、N层解码器以及输出部分(输出线性层与softmax层)四大部分组成。

weixin_44907479的博客 3008

AI技术洞察:从函数到Transformer革命(深度好文)

Transformer 以 “注意力机制为核心” 的创新架构,打破了传统 RNN/CNN 在 NLP 领域的垄断,通过并行计算、长距离依赖捕捉、泛化能力强三大核心优势,重塑了人工智能行业的技术格局。

Peter_Changyb的博客 2053

Transformer是什么?一文读懂Transformer的模型架构和底层原理

‌Transformer‌是一种用于自然语言处理(NLP)和深度学习的神经网络架构,最早由Google研究团队在2017年提出‌。它的核心思想是利用自注意力机制来捕捉序列中元素之间的关系,从而避免了传统RNN难以处理长序列依赖的问题‌。

大模型研究中心 1万+

Transformer网络

Transformer网络最初被设计出来是为了自然语言处理、语言翻译任务,这里解释的也主要基于这一任务展开。在 Transformer 出现之前,递归神经网络(RNN)是自然语言处理的首选解决方案。当提供一个单词序列时,递归神经网络(RNN)将处理第一个单词,并将结果反馈到处理下一个单词的层。这使它能够跟踪整个句子,而不是单独处理每个单词。但是这种方法只能顺序的处理单词,同时对于长序列的文本无法有效处理,当两个单词距离过远时会出现梯度消失的问题。

weixin_41169280的博客 1万+

transformer理解

Transformer 是 Google 的团队在 2017 年提出的一种 NLP 经典模型,现在比较火热的 Bert 也是基于 Transformer。Transformer 模型使用了 Self-Attention 机制,不采用 RNN和LSTM 的顺序结构,使得模型可以并行化训练,而且能够拥有全局信息。 1.Transformer 结构 首先介绍 Transformer 的整体结构,下图是 Transformer 用于中英文翻译的整体结构。 ...

qq_22613769的博客 8005

大模型必知基础知识:5、Transformer架构-前馈神经网络(FFN)原理详解

前馈神经网络(FFN)是Transformer架构中的核心组件之一。本文详细介绍了FFN的基本原理及其在Transformer中的应用。FFN通过"先展开再压缩"的结构设计(通常包含两个线性变换层和ReLU激活函数),实现了对输入数据的非线性变换和复杂特征提取。在Transformer中,FFN位置独立地作用于每个token的表示,并与自注意力机制协同工作,为模型提供更强的表达能力和泛化能力。文章还探讨了FFN的变体和发展趋势,如门控线性单元(SwiGLU)和混合专家模型(MoE)等创新

4871

这样图解Transformer应该没人看不懂了吧——Transformer工作原理

与任何自然语言处理(NLP)模型一样,Transformer需要了解每个单词的两方面信息——单词的含义及其在序列中的位置。 嵌入层:负责编码单词的含义。 位置编码层:负责表示单词在序列中的位置。 Transformer通过将这两个编码相加来结合这两方面的信息。

bugyinyin的博客 6411

Transformer详解

Transformer详解 1. 简介 Transformer是一个面向sequence to sequence任务的模型,在17年的论文《Attention is all you need》中首次提出。Transformer 是第一个完全依赖自注意力(self-attention)来计算输入和输出的表示,而不使用序列对齐的递归神经网络或卷积神经网络的转换模型。

weixin_44762713的博客 1万+

Transformer(用于自然语言处理的神经网络架构)

而在自注意力机制中,每个时间步的隐藏状态是根据所有时间步的输入进行计算的,使得模型可以同时关注到输入序列的所有位置。位置编码是一种特殊的嵌入,将序列中的每个位置映射为固定维度的向量,然后将位置编码加到输入嵌入中,使得模型能够感知到输入序列中不同位置的相对距离。由于Transformer模型较为复杂,通常使用现有的深度学习框架(如TensorFlow、PyTorch)中的预训练模型来加速模型的训练和应用。请注意,上述示例只是一个简单的文本分类示例,实际应用中可能需要根据具体任务和数据进行更多的调整和优化。

kankan_s的专栏 4614
上一篇: 保姆级教程!自媒体获客AI Agent搭建全流程,LangChain框架+开源模型实战详解
下一篇: 革命性突破!GraphRAG技术全解析:从原理到实战重新定义智能问答(附医疗案例)
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值