“SAM+多模态图像融合”这个idea一出,就有人用它发了CCF-A

图像分割之SAM(Segment Anything Model) 该模型有别于传统的分割模型。传统分割模型只能输入原图输出固定的分割结果,SAM在设计上可以同时输入原图和特定提示(点、框、阴影、文本),然后根据不同的提示输出不同的分割结果图,并且SAM支持不同提示的交互式分割。SA-1B覆盖了更广泛的图片区间,比第二大分割数据集多了11倍的图片400倍的mask。随着提示点的数量的增加,SAM的分割效果越来越高,随着提示点从1到9的增加,SAM方法和其他分割方法之间的gap越来越小。在论文的交互式分割任务中,有的提示信息,比如点的提示,存在模棱两可的情况。 阅读详情

SAM自推出以来,已经广泛应用于CV各任务,各种创新层出不穷。到了2025年,SAM仍然有相当大的优化空间,尤其是通过结合多模态图像融合,可以进一步提高分割精度和效率,增强适应性,大幅拓宽应用场景。

对论文er来说,这也意味着创新空间更大了。目前在CVPR、IJCAI等顶会上已经出现了不少相关成果,比如性能超越SOTA的SAGE方法、鲁棒多模态3D目标检测框架RoboFusion。感兴趣的论文er抓紧时机!

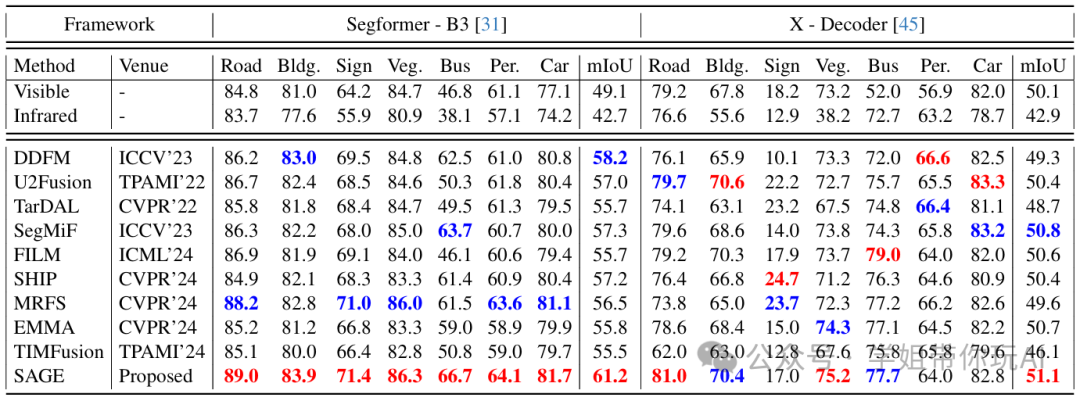
Every SAM Drop Counts: Embracing Semantic Priors for Multi-Modality Image Fusion and Beyond

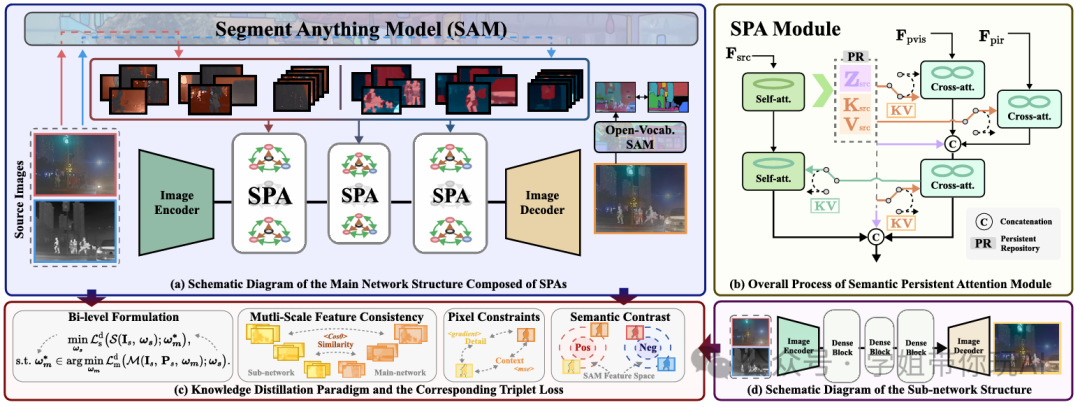
**方法:**论文提出了一种名为SAGE的多模态图像融合方法,通过结合 SAM 的语义先验知识和双层优化蒸馏机制,实现了高质量的图像融合和下游任务的适应性,同时降低了计算复杂度,提高了部署效率。
img

创新点:

  • 提出了一种新的多模态图像融合框架SAGE,利用SAM的语义先验知识,提升融合图像的质量和下游任务的适应性。
  • 设计了SPA模块,通过持久存储库保留源图像信息,同时从 SAM 中提取高级语义先验。
  • 引入了双层优化驱动的蒸馏机制,将SAM的知识转移到轻量级子网络中,减少推理阶段的计算复杂度,同时保持高效的部署能力。
img

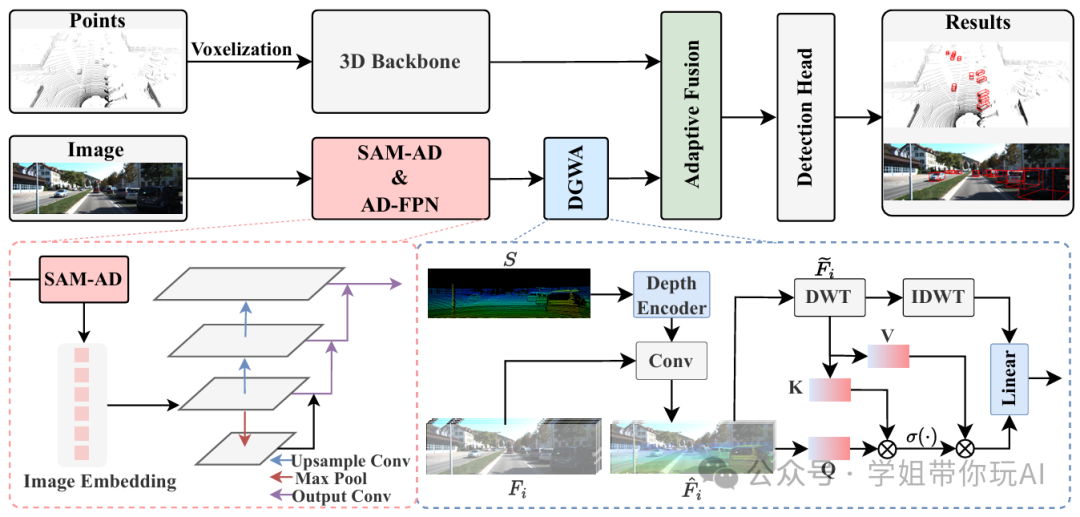
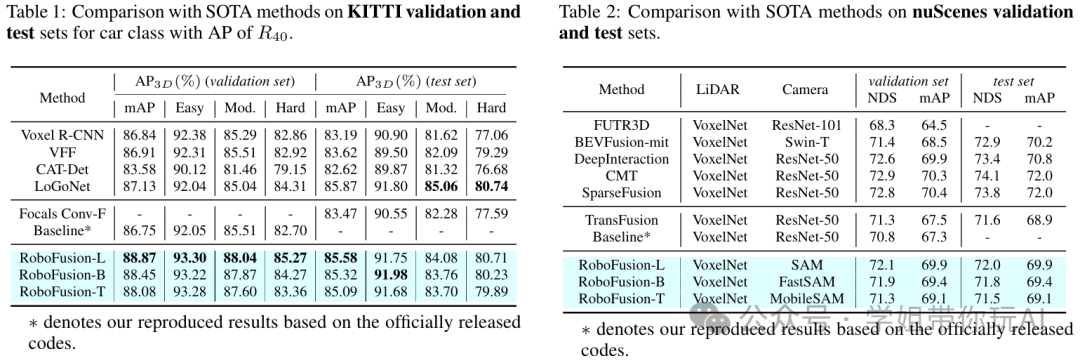
RoboFusion: Towards robust multi-modal 3D object detection via SAM

**方法:**论文提出了一种名为RoboFusion的鲁棒多模态 3D 目标检测框架,通过将视觉基础模型与多模态图像融合相结合,利用SAM的强大泛化能力以及深度引导的小波注意力和自适应融合技术,有效减少噪声和恶劣天气条件下的干扰,从而显著提升自动驾驶场景中目标检测的鲁棒性和泛化能力。
img

创新点:

  • 提出了 SAM-AD 和 AD-FPN,将 SAM 预训练适应自动驾驶场景,并通过特征上采样与多模态 3D 目标检测对齐。
  • 设计了深度引导的小波注意力模块,利用小波分解对深度引导图像特征进行去噪,减少噪声干扰。
  • 引入自适应融合模块,通过自注意力机制动态调整点云和图像特征的权重,增强特征鲁棒性。
img

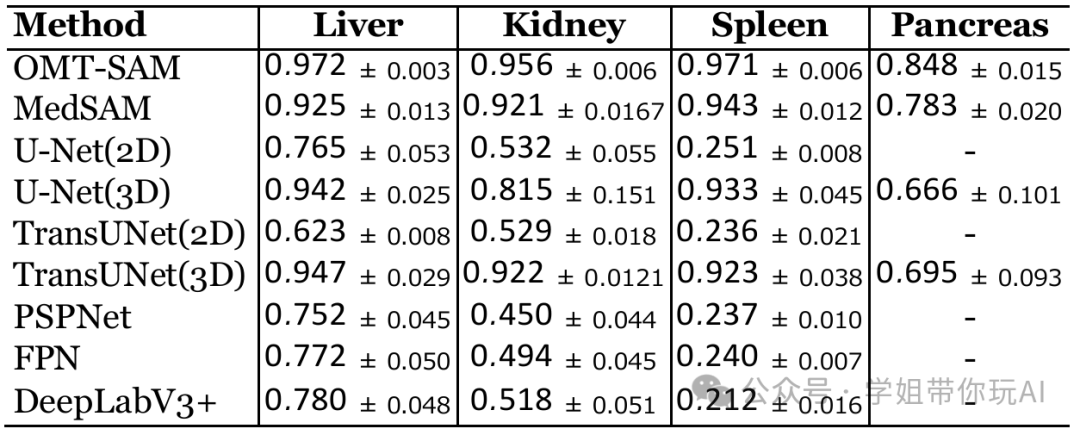
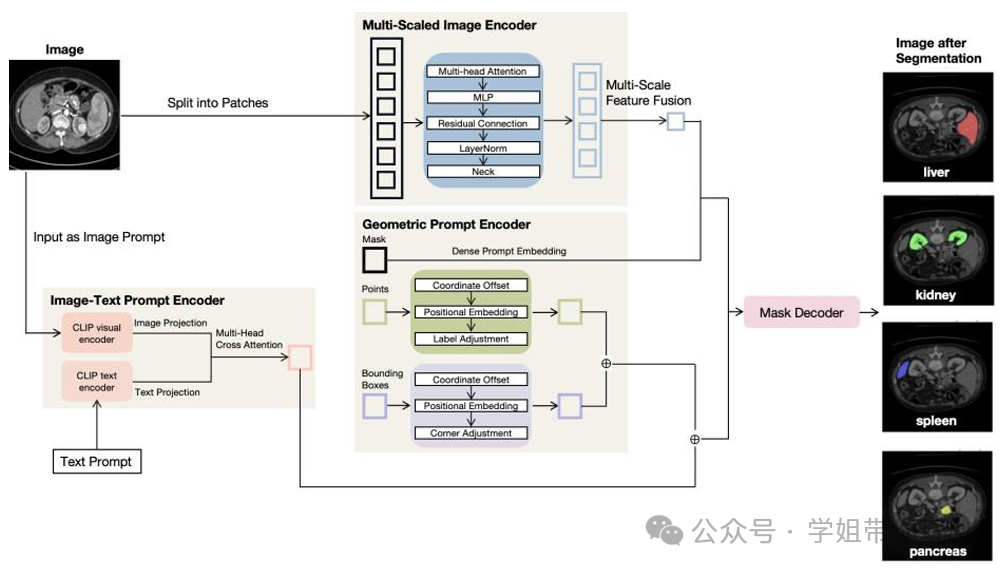
Organ-aware Multi-scale Medical Image Segmentation Using Text Prompt Engineering

**方法:**论文提出了一种基于SAM的医学图像分割模型OMT-SAM,通过结合CLIP模型实现图像与文本提示的融合,并利用多尺度特征提取来提升分割精度,尤其在复杂器官的边界识别上表现出色。
img

创新点:

  • 引入CLIP模型作为图像-文本提示编码器,融合文本描述与医学图像特征,通过交叉注意力生成图像-文本嵌入,提升对复杂解剖结构的理解。
  • 提出多尺度视觉特征提取方法,从MedSAM中提取不同粒度特征,细致捕捉器官边界和细节,提高分割精度。
  • 在FLARE 2021数据集上表现优异,尤其在复杂器官分割中超越现有模型。

img

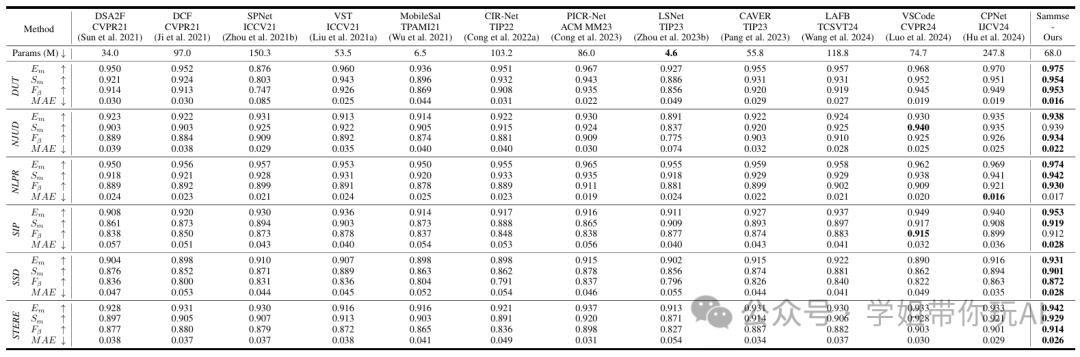
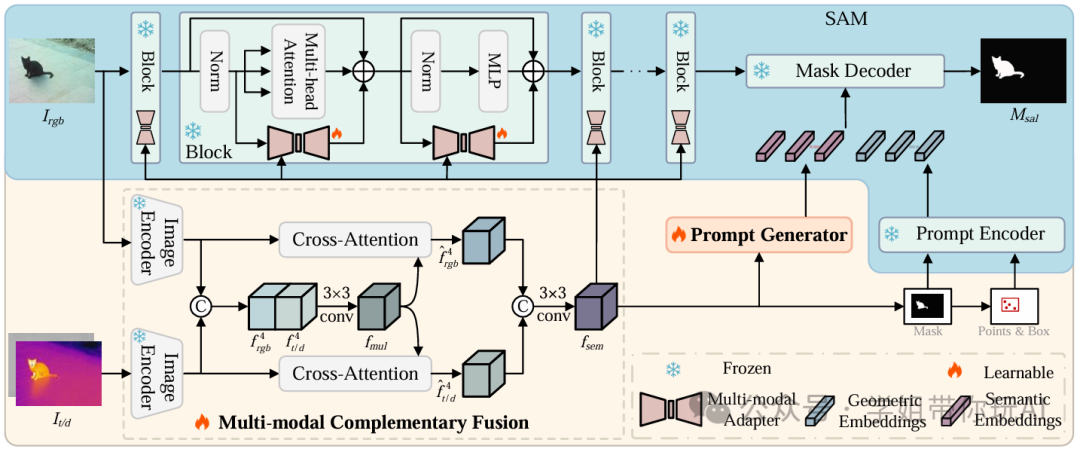
Adapting Segment Anything Model to Multi-modal Salient Object Detection with Semantic Feature Fusion Guidance

**方法:**论文提出了一种基于SAM的多模态显著目标检测框架Sammese,通过融合多模态图像的语义特征,增强SAM对显著目标的检测能力,显著提升了多模态数据下的检测性能。
img

创新点:

  • 多模态融合模块整合可见光与热成像/深度图像的语义特征,增强模型输入信息。
  • 多模态适配器嵌入SAM图像编码器,使其适应多模态数据,提升复杂场景处理能力。
  • 提出语义-几何提示生成策略,自动生成提示嵌入,提高显著目标检测精度。

img

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

NeurIPS24 Oral!多模态融合+目标检测全新里程碑! 最近发现实在太热了!顶会频出!像是NeurIPS24 Oral上端到端算法E2E-MFD;ECCV24上性能提升30.8%的FRN;TPAMI24上推理效率狂飙270%倍的FSF……主要在于:一方面,其能充分利用不同模态数据的互补性,克服传统单一模态数据易受噪声、遮挡、光照变化等影响的缺陷;再结合特定的融合策略,便能显著提升检测的准确性和鲁棒性。另一方面,其应用非常广泛,自动驾驶、智能监控、医疗影像分析等都离不开它。但其也面临数据异构、标注复杂、模态对齐困难等挑战,对其的研究成为了迫切需求。 阅读详情

相关推荐

多模态:图像分割SAM

图像生成领域爆发性的技术增长让传统计算机视觉技术再次崛起,如目标检测,图像分割,这些技术引入图像生成相关技术的pipeline中,可以设计出更多创新性的算法。而这些基础技术也有了一些大模型,如目标检测的GroundingDINO,图像分割的SAM(segment anything model)。本文主要对SAM进行介绍。SAM是一个交互式分割模型,可以根据提示词对目标进行分割。可有效解决通常自然图像的下游分割任务。整体上来说,SAM的模型结构说不上十分复杂,但其令人竟然的数据工程和训练方式实在让人赞叹。

WiSirius的博客 3551

“SAM+多模态图像融合”这个idea一出,就有人用它发了CCF-A!

SAM自推出以来,已经广泛应用于CV各任务,各种创新层出不穷。到了2025年,SAM仍然有相当大的优化空间,尤其是通过结合多模态图像融合,可以进一步提高分割精度和效率,增强适应性,大幅拓宽应用场景。对论文er来说,这也意味着创新空间更大了。目前在CVPR、IJCAI等顶会上已经出现了不少相关成果,比如性能超越SOTA的SAGE方法、鲁棒多模态3D目标检测框架RoboFusion。感兴趣的论文er抓紧时机!

学姐带你玩AI的博客 1109

MICCAI 2024 每日一篇论文 纯纯直读 CUTS:用于多粒度无监督医学图像分割的深度学习和拓扑框架

主要贡献包括: CUTS 是一种新颖的无监督框架,采用双阶段方法:首先,它生成图像像素块的嵌入图像,通过卷积编码器训练嵌入,然后使用数据凝聚技术将这些像素块聚类为不同粒度的分割。 针对每个阶段的优化目标,结合图像内重建和局部路径重建。 使用基于多尺度、拓扑引导的数据粗粒度匹配方法,通过图像自适应聚类,生成多粒度分割。 应用我们的框架来分割由视网膜图像和脑部MRI图像组成的医学图像数据集。我们通过定性和定量的度量方法评估CUTS的性能,并将其与其他无监督方法和监督方法进行比较。

@Elaine 3920

具身智能 2024 年终盘点:具身科技前沿进展汇总全解析

论文及开源代码:可参考 NVIDIA 官方文档和开发者资源,如 [https://developer.download.nvidia.cn/assets/Isaac - Sim/Isaac - Sim - User - Guide.pdf](https://developer.download.nvidia.cn/assets/Isaac - Sim/Isaac - Sim - User - Guide.pdf)。未来,随着技术持续进步与融合,具身智能有望在更多领域发挥关键作用,推动社会向智能化转型。

lovely_yoshino的博客 9875

K210视觉项目上位机避坑指南:解决C#解析ESP8266 TCP图像流的乱码、卡顿与连接中断

本文详细解析了K210与ESP8266在视觉项目中的上位机开发问题,重点解决TCP图像流解析中的乱码、卡顿与连接中断问题。通过自定义协议、JPEG流重组、TCP连接优化等实战技巧,提升系统稳定性和性能,适用于嵌入式视觉开发者和C#上位机程序员。

weixin_28730131的博客 402

Python实战:用MNE-Python从脑电数据中提取P300成分(附完整代码)

本文提供了一份使用MNE-Python从脑电数据中提取P300成分的完整实战指南。通过详细的代码示例,系统讲解了从环境搭建、数据加载、预处理(滤波、分段、伪迹剔除)到P300波形提取、可视化与参数量化的全流程。重点介绍了如何利用零相位滤波和叠加平均技术,从EEG信号中精准分离出反映认知加工的P300事件相关电位,适用于脑机接口与认知神经科学研究。

weixin_29240343的博客 339

Sensor-Adaptive Multimodal Fusion for 3D Object Detection in Adverse Weather

SummaryKey ProblemsContributions:

weixin_46202235的博客 499

maxwell 平面变压器仿真(一)

在学习开关电源设计的时候,我们难免要设计变压器,采用有限元仿真软件MAXWELL 可以帮助我们确定变压器的励磁电感,漏感等参数。对于我们的理论分析大有裨益。但是苦于这破软件的教程真的是相当的零散,我相信大家用起来也总是苦于没有系统的教程指导,撰写本文的目的有两个,一个是记录自己使用的一些问题,一个是给大家提供一个可以参考的文档。

qq_45405656的博客 8254

深度学习之-目标检测算法汇总(超全面)

概括了目前YOLO目标检测模型从YOLOv1到YOLOv12的演进,并介绍了多种改进方法。这些改进包括引入注意力机制、多尺度特征融合、模型轻量化、与其他新技术结合(如Mamba模型、扩散模型等),以及优化损失函数和训练策略。文章还探讨了YOLO在农业、医疗、交通等领域的应用,并展示了其在复杂场景中的检测性能提升。此外,文章介绍了基于Transformer和MLP的目标检测改进方法,以及如何将大模型(如SAM)应用于目标检测任务。这些改进不仅提高了检测精度,还增强了模型的实时性和适应性。

一个不怎么正经的算法工程师的博客~不定期更新一些我所覆盖领域的干货~~~包你满意噢~~ 3017

PyTorch实战:手把手教你用QAT量化感知训练拯救模型精度(附避坑指南)

本文详细介绍了如何使用PyTorch进行QAT量化感知训练,以提升模型在边缘设备上的推理精度。通过核心原理讲解、实战代码示例和避坑指南,帮助开发者掌握从环境配置、模型训练到边缘部署的全流程,有效解决传统量化方法导致的精度损失问题。

c7d8e的博客 330

Lumerical FDTD新手教程:5步搞定MMI波导光谱模拟(附避坑指南)

本文提供Lumerical FDTD新手教程,详细讲解5步完成MMI波导光谱模拟的实用方法,包括环境准备、结构建模、光源配置、仿真优化和结果分析。特别针对多模干涉耦合器(MMI)的模拟难点,提供避坑指南和优化策略,帮助光学工程师快速掌握FDTD仿真技术。

kite3的博客 360

超越BEVFusion | RoboFusion:通过SAM实现稳健的多模态3D检测

编辑|自动驾驶Daily点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取点击进入→自动驾驶之心【多传感器融合】技术交流群本文只做学术分享,如有侵权,联系删文论文链接:https://arxiv.org/pdf/2401.03907.pdf多模态3D检测器致力于探索安全可靠的自动驾驶感知系统。然而,尽管在干净的基准数据集上实现了最先进的(SOTA)性能,但它们往往忽略了现实世界...

CV_Autobot的博客 397

视频教程-SAP S4 HANA FICO COPA 获利能力分析-ERP

SAP S4 HANA FICO COPA 获利能力分析 从业超过8年的SA...

weixin_33456805的博客 1444

学院15篇论文被AAAI 2026录用

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【顶会/顶刊】投稿交流群添加微信号:CVer2233,小助手拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料及应用!发论文/搞科研/涨薪,强烈推荐!来源:西电人工智能学院AAAI 2026近日,AAAI 2026(AAAI Conference on Artificial Intelligence)公布了论文录用结果,人工智能学院共15篇论文被录用,第一作者分别是高子涵

阿木寺的博客 587

嵌入式:简单的service框架

在嵌入式中,我们获取一个资源、设置一个变量、更新数据的话最直接的方式就是直接调用一个函数。这样的写法也可以满足基本的功能,前提是这个系统是只要一个任务,只有一个while(1)如图1.1。图1.1当有两个或者两个以上的任务的时候,同时调用一个函数(设置一个状态值、操作同一个资源、操作指针等行为)的流程如图1.2。图1.2当两个任务同时操作一个资源的时候,就会有重入的问题,会导致想不到的异常问题(数据不对、指针异常等)。

stupid的博客 987

Coze 上 OpenClaw 完整使用攻略(零代码 + 24 小时在线 + 飞书 / 微信接入)

Coze(扣子)是目前国内零门槛部署 OpenClaw 最友好的平台,无需服务器、不用命令行,5 分钟即可拥有可执行本地 / 云端任务的 AI 助手,还能一键发布到飞书、微信、钉钉等 IM。

hy行者勇哥的博客 2926

CVPR 2024最佳论文候选!NeRF新突破!用启发式引导分割去除瞬态干扰物,无需额外先验知识...

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!论文第一作者为中山大学计算机学院研二硕士生陈家豪,研究方向为神经渲染和三维重建,导师为李...

阿木寺的博客 480

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【多模态】14、Segment Anything | Meta 推出超强悍可分割一切的模型 SAM

本文主要介绍 segment anything

呆呆的猫的博客 8952

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

SAGE:基于SAM进行二级蒸馏的多模态图像融合新方法,CVPR2025

目前将SAM整合用于低级任务的方法通常需要在推理时使用完整的SAM,这在实际应用中显得过于不切实际。为了解决这些问题,作者提出了融合方法SAGE,该方法完全整合并提炼了来自SAM的语义先验。

sherlockMa的博客 2119

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【CVPR 2024】Towards Robust 3D Object Detection with LiDAR and 4D Radar Fusion in Various Weather Cond

【CVPR 2024】Towards Robust 3D Object Detection with LiDAR and 4D Radar Fusion in Various Weather Cond

weixin_45657478的博客 1844

TransFusion:Robust LiDAR-Camera Fusion for 3D Object Detection with Transformers 论文笔记

TransFusion:Robust LiDAR-Camera Fusion for 3D Object Detection with Transformers 论文笔记

weixin_45657478的博客 1839

AI推介-多模态视觉语言模型VLMs论文速览(arXiv方向):2024.01.01-2024.01.10

多模态三维物体探测器致力于为自动驾驶(AD)探索安全可靠的感知系统。然而,虽然在干净的基准数据集上实现了最先进(SOTA)的性能,但它们往往忽略了真实世界环境的复杂性和恶劣条件。同时,随着视觉基础模型(VFM)的出现,为提高自动驾驶中多模态三维物体检测的鲁棒性和通用性带来了机遇和挑战。因此,我们提出了 RoboFusion,一个利用视觉基础模型(如 SAM)来解决分布外噪声(OOD)问题的稳健框架。首先,我们将原始的 SAM 改用于自动驾驶场景,命名为 SAM-AD。

小小帅 1577

CVPR 2025|SAGE:利用语义先验实现多模态图像融合及拓展任务

记源输入可见光、红外图像IsIvisIirIs​Ivis​Iir​;SAM 生成对应的语义先验块PsPvisPirPs​Pvis​Pir​。主网络记为MM,参数ωm\omega_mωm​;子网络记为SS,参数ωs\omega_sωs​。

2502_93041765的博客 210

点云检测之TransFusion: Robust LiDAR-Camera Fusion for 3D Object Detection with Transformers

多模态融合在自动驾驶领域越来越受欢迎,但是针对劣质图像时(照明不良、传感器未校准)鲁棒性不好,由于通过相机标定矩阵建立的 Lidar 和像素的硬关联,很难解决这种问题。本文提出了 TransFusion,使用软关联机制来处理较差的图像条件。TransFusion使用一种软关联机制 (soft-association) 代替以往融合方法中的硬关联机制,通过这种新的机制使得算法在图像质量退化和传感器没有严格对齐的情况下能更加鲁棒。同时 Image Guidance利用高分辨率的图像提高检测小物体的能力。

Blabala的博客 2604

DeepFusion: Lidar-Camera Deep Fusion for Multi-Modal 3D Object Detection 论文笔记

DeepFusion: Lidar-Camera Deep Fusion for Multi-Modal 3D Object Detection 论文笔记

weixin_45657478的博客 2625

使用混合 LORA 专家定制多模态语义分割的 SAM 模型 !

近期的Segment Anything Model (SAM) 在扩展分割模型方面取得了显著突破,在RGB模态的各种下游应用中表现出了强大的性能。然而,直接将SAM应用于新兴的视觉模态,如深度和事件数据,在多模态分割任务中会导致性能不佳。在本文中,作者首次尝试通过提出一种针对不同输入视觉模态的Mixture of Low-Rank Adaptation Experts (MoE-LoRA) 来适应SAM进行多模态语义分割。

老皮的博客 2199
上一篇: 彻底说清 Human-in-the-Loop:企业级 Agent 系统的关键挑战与LangGraph解法
下一篇: 大模型微调知识与实践分享
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值