从“无法找到答案”到“一问一个准”! Contextual Embedding让chunk自带上下文,精准召回,效果立竿见影!

RAG上下文丢失问题与Contextual Retrieval实战方案 在RAG系统中,‘上下文丢失’是导致检索准确率骤降的核心瓶颈——传统文本切分破坏指代关系与语义连贯性,使模型无法识别‘甲方’‘该条款’等关键指代对象。其本质是检索单元缺乏身份锚点,而非向量表征能力不足。Contextual Retrieval通过LLM生成轻量级上下文摘要并拼接嵌入,为每个chunk注入实体、关系与位置信息,显著提升BM25与向量混合检索的精准度。该技术已在法律合同、财报分析等强指代场景验证有效,适用于LangChain+Chroma+Claude/BGE生态,无需更换底层架构即可落地。本文 阅读详情

背景

最近,公司的一个项目经理找我聊了个头疼的问题:他们给外部交付的项目POC效果不太理想,他发现从向量库中检索不到想要的信息。起初,我建议他换个更好的embedding模型,别再用text-embedding-ada-002了。结果他反馈说,试了text-embedding-3-large和bge-m3,效果也没啥显著提升。

我仔细看了他们的数据,发现他们上传了大量用户的文档,并对文档进行了切分,分成一个个chunk,然后召回这些chunk送给LLM生成回答。问题就在于他们切分chunk的方式用的是RecursiveCharacterTextSplitter,单独看一个切分后的chunk,根本不知道它在讲什么。比如,有个chunk提到了opening hours,但因为递归切分的原因,缺少了主体信息。结果,即使召回了这个chunk,LLM也会回复“从提供的上下文中无法找到答案”。

我给了他一个建议:可以试试contextual-embedding。引入这个方案不需要太多开发成本,而且配合prompt cache,还能有效减少LLM调用的开销。

什么是contextual embedding

在传统的RAG中,文档通常被分成更小的块以进行有效的检索。虽然这种方法对于许多应用程序都很有效,但当单个块缺乏足够的上下文时,它可能会导致问题。Contextual Embedding 通过使用LLM给每段chunk补充上下文信息,用户更精准召回和更高质量的回答。

举个简单的例子,比如有段chunk的内容如下:

The company's revenue grew by 3% over the previous quarter.

当我们提问:“What was the revenue growth for ACME Corp in Q2 2023?”,虽然这段chunk是真实答案,但是却检索不到。这是因为原始chunk,是两个"The"对象,导致不管使用embedding还是BM25都抓不出来它。但是如果我们通过某种手段,给转换成下面这种contextualized_chunk,把上下文信息给注入到chunk里:

This chunk is from an SEC filing on ACME corp's performance in Q2 2023; the previous quarter's revenue was $314 million. The company's revenue grew by 3% over the previous quarter.

那么还是刚才的问题,就一问一个准了。

原理
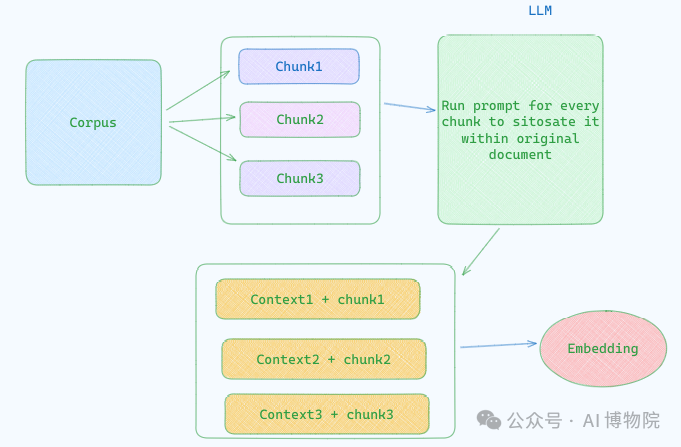
img

我们通过一个特定的提示生成每个分块的简洁上下文,生成的上下文通常为 50-100 个 token,然后 索引之前将其添加到分块中。对应的prompt示例:

system prompt

Here is the whole document: 
<document> 
{{WHOLE_DOCUMENT}} 
</document> 

user prompt

Here is the chunk we want to situate within the whole document:
<chunk> 
{{CHUNK_CONTENT}} 
</chunk> 

Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.

实战案例

这里我们还是以sentosa的一个网页为例:https://www.sentosa.com.sg/en/places-to-stay/amara-sanctuary-sentosa/。

从这个网页中,我们切分出了一段chunk,内容如下:

description: Bed: King 
Room Size: 37 sqm 
Maximum Occupants: 2 Adults or 2 Adults and 1 child age 11 and below 
Room Essentials  
Flat-screen TV with cable channel access  
Individually controlled air-conditioning  
Spacious bathroom with separate bathtub and shower facilities  
Luxury bathroom amenities  
Bathrobes and hair dryer  
Electronic safe  
Tea and coffee making facilities  
Iron and ironing board  
Baby cot is available on request (subject to availability)

name: Couple Suite

name: Courtyard Suite

name: Junior Suite

name: Verandah Suite

Opening Hours: 
Check in: from 3pm  
Check out: until 12pm

单独看这段chunk,我们只能看出它在描述一些房间信息,但具体是哪些房间的信息,却并不清楚。于是,我们使用gpt-4o-mini为这段chunk生成了上下文,结果如下:

This chunk provides detailed information about the room types and amenities available at Amara Sanctuary Sentosa, including the Deluxe Room specifications, other suite options, opening hours, accessibility features, and pet-friendly services, enhancing the overall description of the resort's accommodations.

接下来,我们将原始的chunk和生成的上下文结合起来(使用\n\n 连接chunk),形成一个新的chunk:

description: Bed: King 
Room Size: 37 sqm 
Maximum Occupants: 2 Adults or 2 Adults and 1 child age 11 and below 
Room Essentials  
Flat-screen TV with cable channel access  
Individually controlled air-conditioning  
Spacious bathroom with separate bathtub and shower facilities  
Luxury bathroom amenities  
Bathrobes and hair dryer  
Electronic safe  
Tea and coffee making facilities  
Iron and ironing board  
Baby cot is available on request (subject to availability)

name: Couple Suite

name: Courtyard Suite

name: Junior Suite

name: Verandah Suite


Opening Hours: 
Check in: from 3pm  
Check out: until 12pm


This chunk provides detailed information about the room types and amenities available at Amara Sanctuary Sentosa, including the Deluxe Room specifications, other suite options, opening hours, accessibility features, and pet-friendly services, enhancing the overall description of the resort's accommodations.

这样一来,当我们再询问关于“Amara Sanctuary Sentosa的Deluxe Room”相关问题时,LLM就能准确回答上来了。这种方法不仅提升了信息的连贯性,还大大减少了LLM的误判率。

prompt cache

对于OpenAI模型,当你的提示(prompt)长度超过1,024个token时,API调用将自动受益于Prompt Caching功能。(deepseek也支持prompt cache)如果你重复使用具有相同前缀的提示,系统会自动应用Prompt Caching折扣,而你无需对API集成做任何修改。缓存通常在5-10分钟的不活动后被清除,并且无论如何都会在最后一次使用后的一小时内被移除。

当我们对某个文档进行切分,生成多个chunk时,通常需要为每个chunk生成上下文信息。如果每次调用都传入全部文档信息,会导致重复计算,增加LLM的调用成本。这时,我们可以将全部文档信息放在system prompt中,利用Prompt Cache来节省费用。

以下是我调用LLM的Response中的usage字段,展示了Prompt Cache的实际效果:

CompletionUsage(
    completion_tokens=24, 
    prompt_tokens=1584, 
    total_tokens=1608, 
    completion_tokens_details=CompletionTokensDetails(
        accepted_prediction_tokens=0, 
        audio_tokens=0, 
        reasoning_tokens=0, 
        rejected_prediction_tokens=0
    ), 
    prompt_tokens_details=PromptTokensDetails(
        audio_tokens=0, 
        cached_tokens=1536  # 这里显示有1,536个token被缓存
    )
)

从上面的数据可以看出:

  • prompt_tokens: 1,584个token被用于提示。
  • cached_tokens: 1,536个token被缓存,这意味着这部分token的计算成本被节省了下来。
  • completion_tokens: 24个token用于生成回答。

通过将文档信息放在system prompt中,我们成功利用Prompt Cache减少了重复计算,显著降低了LLM的调用成本。

总结

传统的文档切分方法(如RecursiveCharacterTextSplitter)可能会导致chunk缺乏足够的上下文信息,从而影响检索效果。通过引入Contextual Embedding,我们能够为每个chunk补充上下文信息,显著提升检索的精准度和回答的质量。

总的来说,Contextual Embedding和Prompt Cache的结合,为RAG系统提供了一种低成本、高效率的优化方案。尤其是在项目时间紧张、资源有限的情况下,这种方案能够快速提升系统的表现。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

上下文感知检索:解决RAG中碎片化文本的语义歧义问题 在检索增强生成(RAG)系统中,传统文本分块导致关键语义线索丢失,引发‘柏林vs巴黎’式指代混淆与事实错配。上下文感知检索通过为每个文本块生成精准、简洁、可验证的上下文描述,将模糊片段锚定至明确主体与属性,从根本上缓解向量空间的语义鸿沟与检索盲选困境。该技术不改变RAG整体架构,仅在预处理阶段注入结构化上下文,显著降低幻觉率并提升Top-1命中率,尤其适用于代码库、法律文档、科研文献等强依赖上下文的工程场景。 阅读详情

相关推荐

RAG 2.0实战指南:Contextual Language Models(CLM)核心机制与落地路径

检索增强生成(RAG)作为大模型知识扩展的基础范式,长期受限于语义鸿沟、上下文碎片化和幻觉率高企等系统性瓶颈。Contextual Language Models(CLM)并非简单优化,而是从‘检索+生成’流水线转向‘证据锚定—矛盾验证—动态装配’的可信推理链重构,其核心在于上下文感知建模与版本化知识更新机制。该范式显著提升金融、法律、医疗等高确定性场景的事实准确率与首token响应速度,并天然支持证据溯源与可审计输出。本文深入解析CLM的Contextual Grounding Layer(CGL)与Dy

weixin_34198762的博客 505

word embedding和contextual embedding

embedding可以描述为Many models of source code are based on learned representation called embedding。 word embedding可以看作为word vector contextual embedding可以表述为it captures the context, since the hidden state...

zhuiyunzhugang的博客 992

RAG工程化实战:从文档切块到多路召回与重排的完整指南

检索增强生成(RAG)是当下大模型落地的核心技术范式,它通过将外部知识检索结果注入提示词,让模型在不重新训练的情况下回答专业问题。然而,实际工程中RAG的上限取决于检索质量而非生成能力。本文从基础概念出发,深入剖析索引构建、文档切块、Embedding选型、元数据设计等前置环节,重点讲解多路召回和Rerank重排如何成为检索质量的分水岭,并涵盖生成阶段的Prompt组织、权限卡控以及Graph RAG、Agentic RAG等进阶方向。适合开发者与面试者系统掌握RAG全链路细节,为生产级应用提供可落地的工程

weixin_33924220的博客 336

上下文文本嵌入方法研究阅读笔记

这里写自定义目录标题欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 欢迎使用Markdown编辑器 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Mar

weixin_45225032的博客 882

如何更好地利用上下文信息进行序列标注 Contextual Embeddings for Sequence Labeling

在序列标注任务中,在句子或文本中预测每个词所属于的标签是序列标注的一个重要任务。近年来,基于深度学习技术的序列标注模型得到了广泛关注。其中,CRF模型由于其简单、效率高、易于实现等优点被广泛应用。然而,CRF模型对上下文信息的利用较少,而这些信息对于预测序列中的词性、命名实体等有着至关重要的作用。因此,如何利用这些上下文信息来提升序列标注性能是当前的研究热点之一。本文将介绍一种名为Contextual Embedding的新型序列标注模型。

AI天才研究院 1157

从Word2Vec到BERT:上下文嵌入 (Contextual Embedding) 最新综述论文.pdf

词嵌入表示向量是自然语言处理的重要组成部分。最近来自牛津大学和DeepMind等撰写了关于上下文嵌入表示的综述论文,详述了当前预训练模型的代表性工作等。

NLP基础——词表示、文本特征工程

文章目录NLP基础——词表示和文本特征1. Word Representation: 独热编码,tf-idf2. Word2Vec2.1 Word Embedding2.2 Gaussian Embedding2.3 Contextual Embedding3. 文本特征工程 NLP基础——词表示和文本特征 1. Word Representation: 独热编码,tf-idf 词表示:0-1 one-hot encoding --> 句子表示:0-1(Boolean) 构建词库V,对每个句子的表

u012744245的博客 1322

攻防世界 web高手进阶区 9分题 Web_python_flask_sql_injection

继续ctf的旅程,开始攻防世界web高手进阶区的9分题,本文是Web_python_flask_sql_injection的writeup

闵行小鱼塘 1476

Claude Cookbooks 实践指南:用 Contextual Embeddings 构建与优化 Contextual Retrieval 系统

传统 RAG 把文档切成小块后单独嵌入,孤立 chunk 往往丢失文档级上下文,导致检索失败。本篇基于 claude-cookbooks 仓库中的 [Contextual Embeddings 指南](https://link.gitcode.com/i/7891879d7bf789cdf76deb7b62b9716b) 及其主教程 [guide.ipynb](https://link.gitco

gitblog_00478的博客 699

AI大模型驱动Web UI自动化测试:Playwright与RobotFramework智能整合实践

Web自动化测试是软件质量保障的关键环节,其核心原理是通过脚本模拟用户操作,对Web应用界面进行功能验证。传统方法依赖固定的元素定位和脚本逻辑,在应对频繁的UI变更时面临维护成本高、脚本脆弱的挑战。随着AI大模型技术的发展,其强大的自然语言理解和代码生成能力为自动化测试带来了新的技术价值。通过将大模型的意图理解与代码生成能力,与Playwright强大的浏览器自动化执行引擎以及RobotFramework灵活的关键字驱动框架相结合,可以构建出能够理解自然语言指令、动态生成稳定操作脚本的智能测试系统。这种融合

weixin_28718769的博客 415

WRF后处理:python cartopy绘制土地利用/土地分类图//python绘制WRF下垫面类型(以北极为例)

下垫面类型对于WRF的地表过程十分重要,而在我们研究WRF的地表过程之前,需要对输入的土地利用类型进行一些绘制,以便后续的修改。LU_MODIS21函数定义了绘制的土地类型、标签与对应色标,我们使用时,直接引用LU_MODIS21()即可返回。其实很简单,只要将你拥有的土地类型数据提取出来,将原本函数中的labels和C切片,重新定义色标再绘制即可。在这里,我将以北极地区为例,绘制北极地区的WRF下垫面数据,我使用的MODIS21这类。

weixin_43750300的博客 3861

RAG开发中chunk切分策略与参数调优实战指南

在检索增强生成(RAG)与AI大模型应用开发中,文本切分(chunking)是决定检索精度的关键环节。其原理是将长文档按语义或固定长度切分为可控片段,再通过向量化存入数据库,使相似度匹配更聚焦。合理的chunk_size与chunk_overlap能平衡上下文完整性与检索粒度,直接影响知识库问答的召回质量。该技术广泛应用于企业知识库、FAQ、法律条款等场景。本文深入解析chunk概念、切分策略、参数调优及常见陷阱,帮助开发者优化RAG链路中的文本切分逻辑。

weixin_34126557的博客 279

DAC8568实战指南:如何用STM32实现8通道DAC精准控制(附代码)

本文提供DAC8568与STM32结合的实战指南,详细解析8通道16位DAC的精准控制方法。内容涵盖硬件连接、SPI配置、驱动层构建、时序调试及多通道同步输出等关键步骤,并附有经过验证的HAL库驱动代码,帮助工程师快速解决实际项目中的通信与输出稳定性问题。

weixin_29175469的博客 746

RAG分块配置大揭秘:告别70%召回率瓶颈,5种策略助你突破86.7%!

文章摘要: 分块策略是影响RAG(检索增强生成)系统召回率的关键因素,而非后续的Embedding模型或向量库优化。实验数据显示,Document-aware分块策略的Recall@5达86.7%,远超Fixed-size策略的71.3%。文章对比了五种主流分块策略: Fixed-size:简单但效果最差,易导致语义割裂; Recursive character:通用首选,通过优先级分隔符保留语义边界; Semantic:适合非结构化文本,但计算成本高; Document-aware:结构化文档最佳选择,利

2401_84494441的博客 225

【完整梳理验证】企业微信第三方应用接入全流程java版

由企业内部的开发者自己开发部署,相当于是企业自己的资产,调用接口基本没有任何限制。由SaaS服务商的开发者开发并部署在服务商侧,面向所有企业。需要企业授权使用(先试用后付费),服务商仅可获取企业授权部分的权限,相当于白名单控制。由服务商的开发者开发,但部署在企业内部。一般是线下签约采购方式,因此权限几乎与自建应用无异,企业管理员只需要配置不对服务商开放的敏感权限,相当于黑名单控制。服务商后台地址:企业微信服务商官网企业管理后台地址:企业微信管理后台服务商,可以理解为 SAAS 中的运营端。企业管理端,可以理

Hello, New World! 2768

51-14 Retentive Network,RetNet 多尺度保留机制序列建模论文精读

RetNet 提出了多尺度保留机制序列建模,该机制支持三种计算范式,即并行、循环和分块循环。RetNet有更好的全局注意力建模、高效的计算效率、对遮挡的鲁棒性、支持基于注意力的图像生成、与置信度相关的门控机制和多任务学习等特点,对不同视觉任务可以共享历史注意力记忆,可以同时进行分类、分割、检测等任务。RetNet在视觉领域应该有广阔的应用前景。

AIgraphX 1614

新闻搜索API对比与RAG集成实践:Contextual Search核心机制与选型指南

在构建RAG系统时,检索质量往往决定生成答案的可信度。传统关键词搜索无法理解上下文,而Contextual News Search API通过实体、时间、地域等上下文信息,将新闻转换为结构化证据,成为AI应用与知识库的重要数据管道。本文从上下文检索原理出发,分析通用新闻聚合、研究型学术和实时事件流三类接口的评估维度,并演示如何通过Python封装统一客户端,将新闻检索接入RAG管道并服务化。同时,结合真实项目中的时效性、引用溯源等典型问题,给出选型决策清单,帮助开发者平衡召回精度、历史深度与成本,为Agen

weixin_30323631的博客 315

MIPI D-PHY TX 一致性测试实例解析 Part 01 续

本文为MIPI D-PHY TX一致性测试实例解析part01章节的第二部分

一只豌豆象的博客 6048

Chunking-Embedding-Rerank

OpenAI 官方 file search 在默认策略下就采用固定大小 chunk 和重叠窗口,默认 chunk size 为 800 tokens、overlap 为 400 tokens,这说明即便是成熟平台,也认为稳定、可控的基础切块仍然是默认选项之一。在多数企业场景中,RAG 出现答非所问引用看起来相关但并不关键明明知识库里有答案却检不出来的根因,常常不是 LLM 太弱,而是 chunk 破坏了信息边界,或者 embedding 无法表达领域概念,又或者首阶段召回把高质量候选压在了很后面。

2401_82819240的博客 368

Opencascade 保存点云为 .stp 和 .step 格式

总结一下,OpenCascade提供了强大的功能和工具,使我们能够方便地将点云数据保存为 .stp 和 .step 格式。通过使用类似于上述示例代码的方法,你可以使用OpenCascade库将点云数据保存为.STP和.STEP格式。总结一下,使用OpenCascade库,你可以方便地将点云数据保存为.STP和.STEP格式。通过使用类似于上述示例代码的方法,你可以将点云数据转换为OpenCascade的几何模型,并将其保存为所需的文件格式。请注意,上述代码仅涵盖了将点云数据保存为.STP格式的基本步骤。

CwzCode的博客 1158

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上下文感知检索终极指南:如何让AI Agent拥有真正的“记忆“与“知识“

在当今AI Agent开发领域,构建真正智能的对话系统面临两大核心挑战:如何让Agent记住用户的历史交互,以及如何让Agent理解复杂的专业知识。《深入理解AI Agent:设计原理与工程实践》项目通过创新的上下文感知检索技术,为这两个问题提供了系统性的解决方案。本文将深入解析这一革命性技术架构,展示如何通过双层记忆系统和智能知识组织,构建真正"有记忆"、"有知识"的AI Agent。 ##

gitblog_00424的博客 975

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

小白程序员必看:轻松掌握RAG技术,让大模型不再“一本正经地胡说八道”!

大模型常常因为缺乏私有数据而“幻觉”,给出看似合理却错误的答案。本文将深入解析RAG技术原理,带你从零开始构建一个“开卷考试”式的大模型,有效解决幻觉问题。文章包含离线建索引和在线查询的完整链路,并介绍了多种检索方式优化技巧,适合想要学习大模型开发的小白程序员。你有没有遇到过这种情况:问大模型一个公司内部的问题,它一本正经地胡说八道?比如问它"我们公司的退款流程是什么",它给你编一套看起来很合理的步骤——但跟你公司的实际制度完全对不上。你追问它,它还能继续编,编得越来越像真的。

2301_76168381的博客 586

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

大模型学习指南:告别幻觉,开卷考试式检索,小白也能轻松掌握RAG技术!

RAG 就一件事:在模型答题前,替它把对的资料翻出来。第一章讲了为什么需要 RAG——大模型有幻觉、知识过时、不认识私有数据三个毛病,RAG 用开卷考试的思路解决。第二章走了完整链路——离线四步把知识变成可检索的向量,在线四步把问题变成最相关的答案,用电商客服的例子从头到尾走了一遍。第三章解决了"检索得准"——向量检索管语义,BM25 管关键词,RRF 融合两路结果,Rerank 把对的排前面。

m0_48891301的博客 337

一文讲透 RAG:原理、优化与落地

你有没有遇到过这种情况:问大模型一个公司内部的问题,它一本正经地胡说八道?比如问它"我们公司的退款流程是什么",它给你编一套看起来很合理的步骤——但跟你公司的实际制度完全对不上。你追问它,它还能继续编,编得越来越像真的。这不是模型"笨",是它压根没见过你的数据。大模型的训练数据是公开互联网,你的公司制度、产品文档、私有知识,它一概不知。但它不会说"我不知道",而是编一个概率上最合理的答案——这就是幻觉。RAG 就是解决这个问题的。今天这篇文章,从原理到生产一次讲透,全程不依赖任何框架。

2601_96285276的博客 347

Late Chunking:RAG中解决长文档语义断裂的关键技术

在RAG系统中,传统‘先切分后嵌入’的分块方式常导致指代断裂、因果链截断和术语歧义等结构性失真,尤其在法律文书、学术论文、技术报告等强上下文依赖的长文档场景中表现突出。Late Chunking通过让全文首先进入embedding模型获取全局token表示,再对chunk内token embedding进行mean pooling,从根本上重建语义锚点,提升chunk embedding的文档级一致性与上下文感知能力。该技术不替代滑动窗口或contextual retrieval,而是与其形成互补协同,显著

weixin_29704001的博客 300

RAG效果评估:4个指标量化每个环节,不评估你永远不知道AI在胡说(踩了4个坑)

1. 评估落地:优先用Ragas进行快速原型评估,量化核心质量指标与能力指标;用TruLens进行生产级全链路评估与监控,定位问题并迭代优化。2. 应用选型:个人/小团队入门用FastGPT,快速部署验证;企业级场景用RAGFlow或Dify,兼顾扩展性与协作需求;需高度自定义用纯代码开发(LangChain+评估工具)。3. 核心优化方向:围绕“上下文相关性、答案忠实度”优化检索策略(切片、向量库、检索算法);围绕“能力指标”优化LLM配置与Prompt设计,提升复杂场景适配能力。

专注 Java / Python 开发,AI 大模型应用学习,持续输出源码教程,实战项目案例,学习笔记,拒绝空话,只写能直接跑的代码与可落地方案,关注我,一起少走弯路。 688
上一篇: AI提示词设计:一篇文章带你从入门到精通,轻松掌握高效提示词技巧!
下一篇: AI赋能,普通员工向“超级个体”进化的路径
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值