人工智能在病理组学领域的最新研究进展|顶刊速递

逆向工程视角:MFI芯片通信协议在Linux环境下的行为分析 本文从逆向工程角度深入分析了MFI芯片在Linux环境下的通信协议行为,重点探讨了树莓派与MFI芯片通过I2C接口交互的技术细节。文章详细介绍了信号捕获、协议栈逆向、动态调试技巧以及安全机制分析,为开发者提供了在Linux驱动层面实现MFI认证的实用方法。 阅读详情

背景补充

  1. 早期激素受体阳性/人表皮生长因子受体2阴性(HR+/HER2-)乳腺癌的研究流程
  2. 乳腺癌病理分析及建模预测复发评分的过程
  3. 利用自监督学习算法Barlow Twins从癌症基因组图谱(TCGA)结肠腺癌数据集中提取特征的流程
  4. 基于 TCGA 训练集、AVANT 临床试验集的结肠腺癌图像分析流程
  5. 基于组织病理学图像的癌症相关模型流程

一、Orpheus:基于 H&E 图像预测乳腺癌复发评分的新利器
https://doi.org/10.1038/s41467-025-57283-x

作者类型姓名单位
第一作者Kevin M. Boehm Omar S. M. El Nahhas Antonio Marra1. 计算肿瘤学服务部,纪念斯隆凯特琳癌症中心,美国纽约州纽约市东61街323号 2. 放射肿瘤学系,纪念斯隆凯特琳癌症中心,美国纽约州纽约市约克大道1275号 3. 德国德累斯顿工业大学卡尔·古斯塔夫·卡鲁斯医学院,Else Kroener Fresenius数字健康中心,德国德累斯顿费切尔大街74号,邮编01307
通讯作者Sarat Chandarlapaty Sohrab P. Shah Jakob Nikolas Kather1. 计算肿瘤学服务部,纪念斯隆凯特琳癌症中心,美国纽约州纽约市东61街323号 2. 人类肿瘤学和发病机制项目,纪念斯隆凯特琳癌症中心,美国纽约州纽约市约克大道1275号 3. Marie-Josée和Henry R. Kravis分子肿瘤学中心,纪念斯隆凯特琳癌症中心,美国纽约州纽约市约克大道1275号 4. 德国德累斯顿工业大学卡尔·古斯塔夫·卡鲁斯医学院,Else Kroener Fresenius数字健康中心,德国德累斯顿费切尔大街74号,邮编01307 5. 德国海德堡大学医院国家肿瘤疾病中心(NCT),医学肿瘤学,德国海德堡新海德堡菲尔德460号,邮编69120

文献概述

“Multimodal histopathologic models stratify hormone receptor - positive early breast cancer”发表于Nature Communications,通过开发多模态深度学习工具Orpheus,利用苏木精和伊红(H&E)全切片图像推断Oncotype DX复发评分(RS),为激素受体阳性早期乳腺癌的风险分层和治疗决策提供了新方法。

  1. 研究背景:激素受体阳性、HER2阴性(HR + /HER2-)的早期乳腺癌是最常见亚型,Oncotype DX®复发评分(RS)在预测和预后评估方面价值显著,但成本高、检测周期长限制其应用。已有基于临床病理特征的预测模型效果不佳,因此研究旨在用深度学习算法分析H&E全切片图像预测RS。

  2. 研究方法

    • 数据组装:收集三个机构6172例HR + /HER2-早期乳腺癌患者数据,包括H&E染色、免疫组化分析、RS计算及部分基因组数据,分为训练验证集和外部验证集。
    • 模型训练:构建基于transformer的模型,通过自监督学习和适应transformer架构训练,预测RS。分别训练视觉、语言和多模态模型,多模态模型融合图像和文本信息。
    • 模型评估:用Pearson相关系数、一致性相关系数等评估模型预测RS的能力,对比Orpheus与临床病理列线图及RS识别远处转移复发的能力。
  3. 研究结果

    • 模型性能良好:视觉模型在不同队列稳健推断RS并识别高风险疾病;语言模型有一定预测能力;多模态模型性能最优,识别高风险疾病(RS > 25)的AUC达0.89,优于列线图(0.73)。
    • 预测复发优势明显:对于RS ≤25的患者,Orpheus + 模型预测远处转移复发的能力强于RS,MSK - BRCA队列中,Orpheus + 的平均时间依赖性AUC为0.75,RS仅为0.49。
    • 可解释性与生物学一致:通过注意力机制可视化,发现模型关注肿瘤相关区域和关键病理信息。高风险疾病肿瘤微环境有显著特征,与基因特征相关。
    • 临床应用有潜力:Orpheus识别低风险患者敏感性高,识别高风险患者有一定特异性,可减少基因检测,指导辅助化疗决策。
  4. 研究结论:Orpheus可从常规H&E全切片图像近似RS,多模态方法优势明显,为乳腺癌精准医疗提供支持,有助于扩大精准医学覆盖范围、优化治疗和随访策略。


早期激素受体阳性/人表皮生长因子受体2阴性(HR+/HER2-)乳腺癌的研究流程
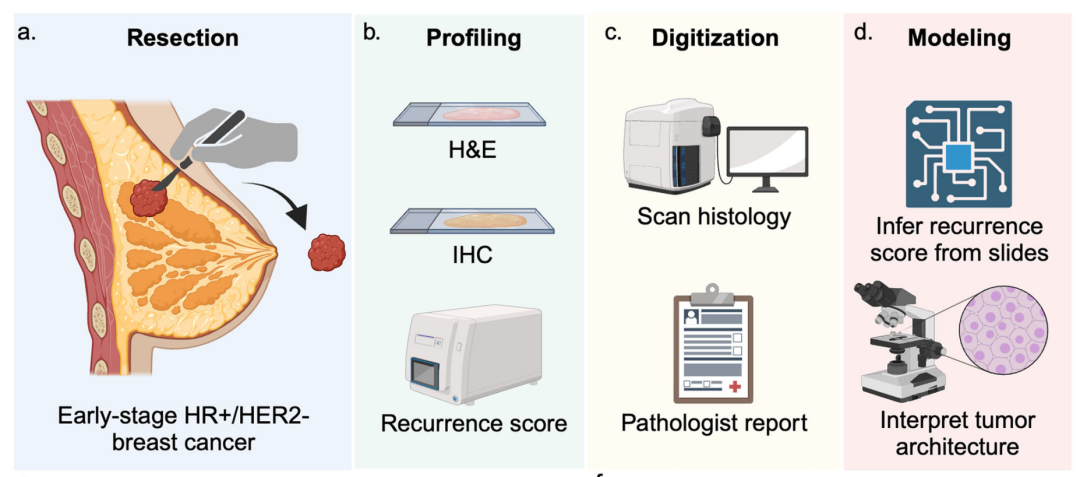
image-20250312082348464image-20250312082348464

共分为4个步骤:

  • a. 切除(Resection):切除早期HR+/HER2-乳腺癌组织样本。
  • b. 分析(Profiling):对样本进行苏木精 - 伊红(H&E)染色和免疫组织化学(IHC)分析,计算复发评分。
  • c. 数字化(Digitization):对组织学切片进行扫描,并生成病理报告。
  • d. 建模(Modeling):通过切片推断复发评分,并解读肿瘤结构。

乳腺癌病理分析及建模预测复发评分的过程
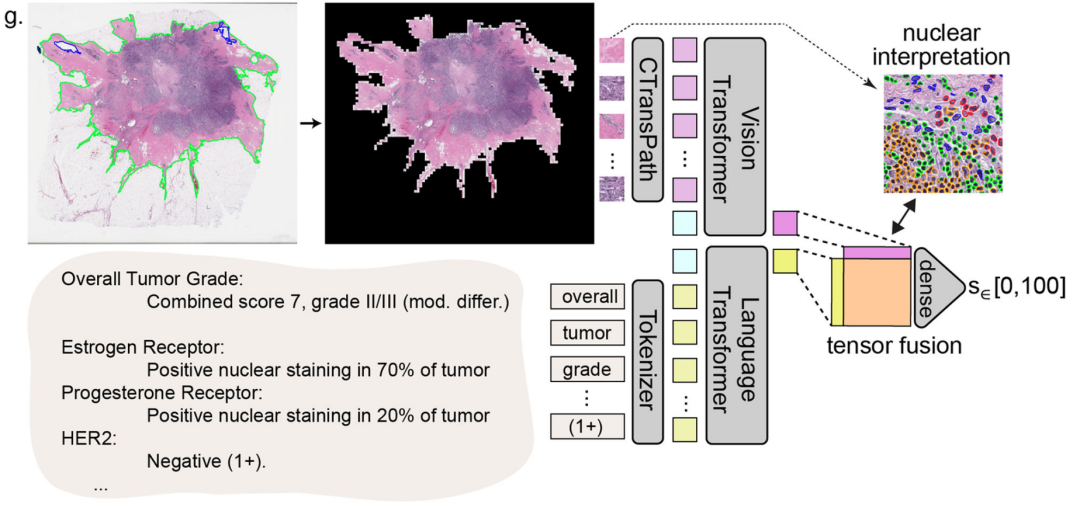
image-20250312082519834image-20250312082519834

  • 病理信息:肿瘤综合评分7,等级II/III(中度分化);雌激素受体在70%的肿瘤细胞核中呈阳性染色;孕激素受体在20%的肿瘤细胞核中呈阳性染色;HER2为阴性(1+)。
  • 分析流程:左侧是苏木精 - 伊红(H&E)染色的组织切片图像,经处理后提取图像特征(CTransPath)进入视觉Transformer模型进行细胞核解读;同时,病理文本信息经标记器(Tokenizer)处理后进入语言Transformer模型,最后将视觉和语言模型的输出通过张量融合(tensor fusion)得到一个在0到100之间的分数(s),用于预测复发评分。

二、自监督学习挖掘结肠癌治疗相关的组织形态学模式
https://doi.org/10.1038/s41467-025-57541-yhttps://doi.org/10.1038/s41467-025-57541-y

一作&通讯

作者身份姓名单位
第一作者Bojing Liu、Meaghan PolackBojing Liu:1. 卡罗林斯卡学院医学流行病学与生物统计学系;2. 纽约大学格罗斯曼医学院应用生物信息学实验室 Meaghan Polack:1. 莱顿大学医学中心外科;3. 纽约大学格罗斯曼医学院病理学系
通讯作者Aristotelis Tsirigos2. 纽约大学格罗斯曼医学院应用生物信息学实验室;6. 纽约大学格罗斯曼医学院病理学系

文献概述

文章《Self-supervised learning reveals clinically relevant histomorphological patterns for therapeutic strategies in colon cancer》发表于Nature Communications,*利用自监督学习(SSL)从结直肠癌苏木精 - 伊红染色全切片图像(WSIs)中提取和分析组织形态学特征,构建了与临床治疗及预后相关的组织形态表型簇(HPCs),为结直肠癌个性化治疗提供依据*。

  1. 研究背景:传统结直肠癌诊断依赖病理学家镜检,且预后预测复杂。深度学习(DL)虽有帮助,但存在可解释性难题。SSL可自动从无标注数据提取图像特征,本研究旨在用SSL从WSIs提取临床相关组织学模式并探究其与患者结局及分子表型的关联。

  2. 研究方法

    • 数据处理与特征提取:用TCGA结肠腺癌(TCGA - COAD)数据集训练SSL Barlow Twins算法,将WSIs处理为小图像补丁(图块),提取128维特征向量。
    • 构建HPCs:运用Leiden社区检测算法对特征向量聚类,构建HPCs,并在AVANT试验数据集验证。
    • 评估与分析:对HPCs进行组织病理学评估和特征描述,从定性和定量评估其一致性和稳健性。用Cox回归构建HPCs与总生存期(OS)的预测模型,结合SHAP值分析重要HPCs。通过计算Spearman相关性和基因集富集分析(GSEA),探究HPCs与免疫特征、致癌通路的联系。
  3. 研究结果

    • HPCs构建与验证:成功构建47个HPCs,可分为8个超级簇,在TCGA和AVANT队列中表现出良好的一致性和稳健性。
    • HPCs与OS的关系:HPCs分类器在预测OS方面表现出色,是独立预后因素,不同治疗组中与OS相关的HPCs具有不同组织学特征。
    • HPCs与免疫及致癌通路的关联:与OS相关的HPCs与肿瘤微环境免疫特征相关,AVANT - 实验组中,HPCs与致癌通路联系紧密,部分HPCs与贝伐单抗治疗反应相关。
  4. 研究结论:研究识别并验证了结直肠癌中与预后相关的组织病理学特征,强调肿瘤微环境重要性,提出影响患者治疗敏感性的机制。HPCs有临床应用前景,但研究存在局限性,未来需提高预测准确性并验证相关机制。


利用自监督学习算法Barlow Twins从癌症基因组图谱(TCGA)结肠腺癌数据集中提取特征的流程
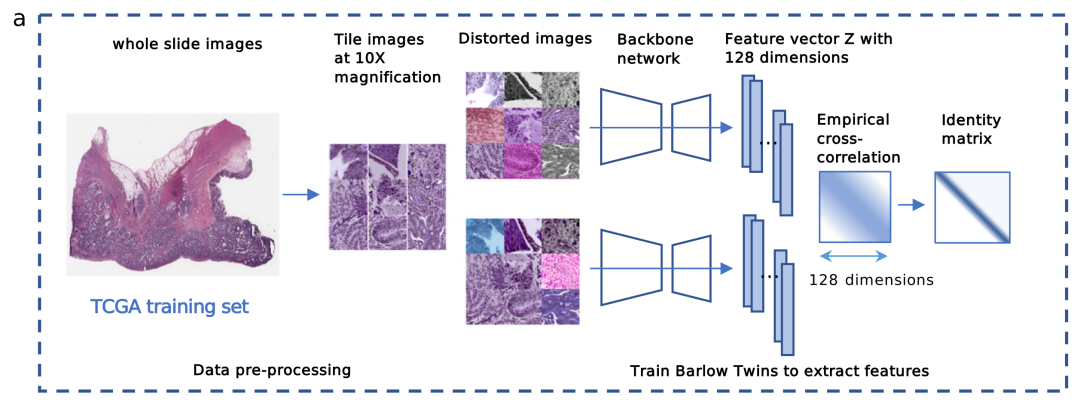
image-20250312083102215image-20250312083102215

  1. 数据预处理:以TCGA训练集的全切片图像(whole slide images)为起始数据,将其处理成10倍放大的图块图像(Tile images at 10X magnification),然后生成畸变图像(Distorted images )。
  2. 特征提取:将畸变图像输入主干网络(Backbone network),得到128维的特征向量(Feature vector Z with 128 dimensions),计算经验互相关(Empirical cross-correlation),并与单位矩阵(Identity matrix)对比,训练Barlow Twins算法来提取图像特征。

基于 TCGA 训练集、AVANT 临床试验集的结肠腺癌图像分析流程

这张图展示了基于TCGA训练集和独立的AVANT临床试验数据集,利用训练好的主干网络对结肠腺癌组织图像进行处理和分析的流程:
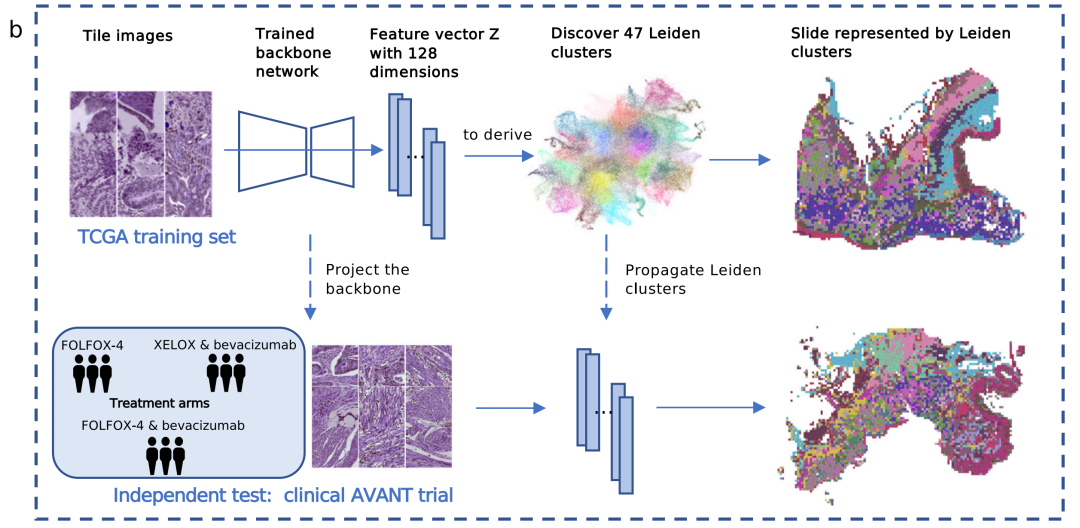
image-20250312083154216image-20250312083154216

  1. TCGA训练集处理:将图块图像(Tile images)输入训练好的主干网络(Trained backbone network),生成128维的特征向量(Feature vector Z with 128 dimensions),通过这些特征向量发现47个莱顿簇(Leiden clusters),并将全切片用莱顿簇表示。
  2. 独立测试(AVANT临床试验):该试验有FOLFOX - 4、XELOX & 贝伐单抗(bevacizumab)、FOLFOX - 4 & 贝伐单抗等治疗组(Treatment arms)。对试验中的图像同样经过主干网络投影(Project the backbone),再利用莱顿簇分析,得到相应的图像表示结果,以此验证相关分析结果的有效性 。

三、BEPH 模型:从组织病理图像实现癌症诊断与生存预测的新基础模型
https://doi.org/10.1038/s41467-025-57587-yhttps://doi.org/10.1038/s41467-025-57587-y

一作&通讯

姓名身份单位(中文)
Zhaochang Yang第一作者上海交通大学生命科学与生物技术学院生物信息学与生物统计学系
Yue Zhang、Zhangsheng Yu通讯作者1. 上海交通大学生命科学与生物技术学院生物信息学与生物统计学系 2. 上海交通大学 - 耶鲁大学生物统计学与数据科学联合中心 3. 上海交通大学医学院转化科学研究所生物医学数据科学中心(Yue Zhang、Zhangsheng Yu) 4. 上海交通大学数学科学学院(Zhangsheng Yu) 5. 上海交通大学医学院临床研究院(Zhangsheng Yu)

文献概述

研究提出基于自监督学习的基础模型BEPH,利用1100万张未标记的组织病理学图像进行预训练,在多种癌症检测任务中表现出色,为癌症诊断和生存预测提供了有效工具,推动了计算病理学在临床和研究中的应用。

  1. 研究背景:计算病理学利用全切片图像进行病理诊断,但现有方法受标注数据稀缺和组织学差异限制。基础模型通过对大量无监督数字病理图像预训练,学习图像潜在结构和关系,有监督学习和自监督学习是主要训练策略。

  2. BEPH模型构建:从TCGA收集32种癌症的11760张病理图像,构建1177万个224×224像素的预训练补丁数据集。*基于BEiTv2,利用自监督学习技术在自然图像和病理图像上预训练,学习病理图像的通用表示,再针对不同任务微调* 。

  3. 实验结果

    • 补丁级分类:在BreakHis数据集上,BEPH的患者级和图像级平均准确率比最新CNN和弱监督模型高5 - 10%;在LC25000数据集上,对肺癌亚型分类准确率达99.99%±0.03,优于其他模型,表明其泛化能力强。
    • WSI级分类:在肾细胞癌、非小细胞肺癌和乳腺癌亚型分类任务中,BEPH的10折宏观平均测试AUC表现优异,虽在部分结果上略逊于UNI和GigaPath,但整体稳定性和泛化能力强,且零样本能力出色。
    • 标签效率:训练数据减少时,BEPH性能仍优于多数模型,使用约50%训练数据时,性能与其他用大量数据训练的模型相当,能有效应对数据稀缺问题。
    • 生存预测:在六种癌症类型的生存预测中,BEPH的C指数最高,在区分高风险和低风险患者方面表现出色,且无需病理图像注释或额外基因组信息。
    • 模型可解释性:通过UMAP降维分析和注意力热图可视化,发现BEPH能有效提取特征,注意力热图与病理学家注释高度一致,消融实验证明病理图像预训练和MIM的重要性。
  4. 研究展望:未来计划构建更大规模、更多样化的预训练数据集,探索多模态基础模型整合多领域数据的价值,以推动病理学人工智能发展。


基于组织病理学图像的癌症相关模型流程
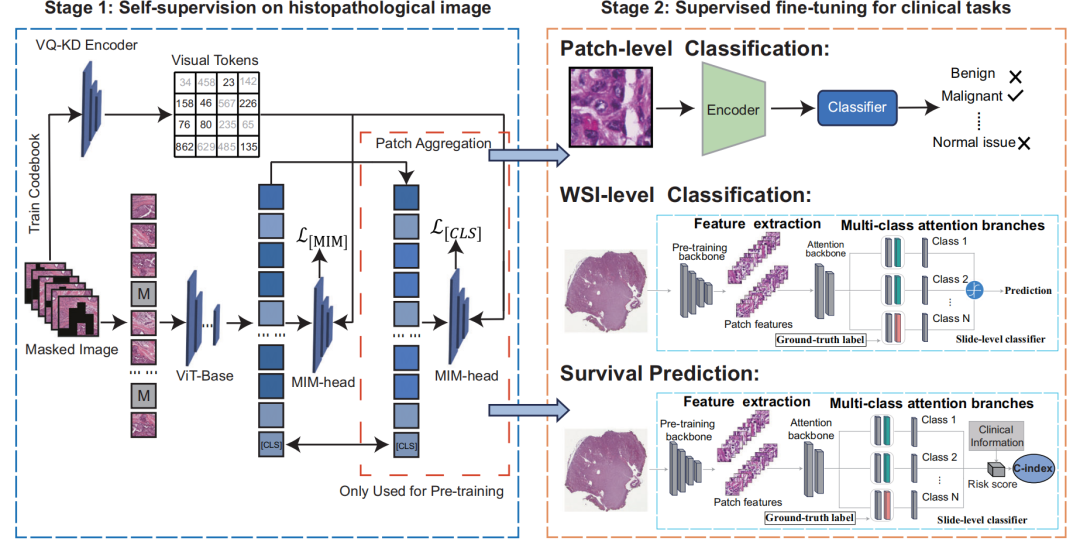
image-20250312083501382image-20250312083501382

第一阶段(Stage 1: Self-supervision on histopathological image)

对组织病理学图像进行自监督学习。

使用VQ-KD编码器将图像转换为视觉标记,通过掩码图像(Masked Image)输入到ViT-Base模型中,利用MIM-head(Masked Image Modeling head)计算损失函数 L [ M I M ] L_{[MIM]} L[MIM]​和 L [ C L S ] L_{[CLS]} L[CLS]​,进行预训练。

此阶段的一些组件如Patch Aggregation等用于处理图像块。

第二阶段(Stage 2: Supervised fine-tuning for clinical tasks)

针对临床任务进行有监督的微调,包含三个任务:

  • Patch-level Classification(图像块级别分类):将图像块输入编码器,再经过分类器,判断图像块对应的组织是良性、恶性还是正常组织。
  • WSI-level Classification(全切片图像级别分类):先进行特征提取,通过预训练的主干网络得到图像块特征,再经过多类注意力分支和切片级分类器,结合真实标签进行预测。
  • Survival Prediction(生存预测):与全切片图像级别分类类似,先提取特征,然后通过多类注意力分支和切片级分类器,结合临床信息计算C-index和风险分数,预测患者生存情况 。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

企业如何利用群晖 NAS 构建高效数据备份与容灾体系 群晖 NAS 不仅是一个企业级文件存储设备,更是一个完整的数据保护平台。通过 Active Backup for Business、快照技术和多层次容灾方案,企业可以在确保数据安全的同时,实现业务的高可用与持续性。在当今充满不确定性的环境下,企业应将数据备份与容灾体系作为 IT 战略的重要组成部分,而群晖 NAS 则是一个值得信赖的核心基石。 阅读详情

相关推荐

做量化没有实时数据怎么行?我找到一个超级好用的Python库,速度还贼快!

今天咱们介绍了 pytdx 这个神奇的库,重点包括:✅ 安装 pytdx✅ 连接 TDX 服务器✅ 获取实时行情数据✅ 获取 K 线数据✅ 获取分笔成交数据总之,pytdx 是一个速度快、免费、易用的量化利器,适合 A 股量化交易的同学们使用。如果你还在为数据发愁,赶紧试试吧!🚀顺手再看就是对花姐最大的支持,期待你的关注。

奔跑的蜗牛 5711

人工智能在病理组学领域的最新研究进展|顶刊速递·25-03-12

第一篇文章通过整合三个机构的 6172 例激素受体阳性早期乳腺癌病例数据,开发出多模态深度学习工具 Orpheus,能从 H&E 全切片图像推断 Oncotype DX 复发评分,在识别高风险病例和预测远处转移复发风险方面表现优异,为乳腺癌精准治疗决策提供了新依据 。第二篇文章通过对 435 例来自癌症基因组图谱(TCGA)的结肠腺癌全切片图像进行自监督学习,构建 47 个组织形态表型簇(HPCs),在独立临床试验中验证其可重复性和预测能力,揭示其与患者生存、治疗反应、免疫景观及致癌通路的关系,为结肠癌治疗

罗小罗同学的博客 1465

STM32CubeMX+FreeRTOS+CAN总线+传感器实战:多任务系统与通信融合开发详解

本文详细介绍了基于STM32CubeMX和FreeRTOS的CAN总线与光电传感器融合开发实战。通过多任务系统设计,实现传感器数据采集与CAN通信的协同工作,提供完整的配置例程和调试技巧,适用于工业控制与机器人感知等应用场景。

n2o3p4的博客 734

Self-Path:Self-supervision for Classification of Pathology Images with Limited Annotations

【挑战】得到病理学高分辨率的注释数据非常难。本文提出一种自监督CNN,称为Self-Path,利用没有标注的数据来学习病理图像中的泛化(generalizable) 和领域不变表示 (domain invariant representations)。Self-Path是一种多任务学习方法,主任务是分类,辅助任务(pretext task)是各自带有标签数据的自监督任务。pretext task:自监督学习中的概念;本文引入新的领域特定(3个)和非领域特定(5个)的自监督任务。

just 534

大话西游2单机版V8一键架设教程:从下载到GM权限全流程(附仙玉修改技巧)

本文详细讲解了大话西游2单机版V8的一键架设全流程,包括环境准备、服务端配置、客户端安装及GM权限获取等关键步骤。特别提供了仙玉修改技巧和高级资源管理方法,帮助玩家快速搭建个性化游戏环境并掌握核心控制功能。教程涵盖Windows系统兼容性设置、常见问题解决方案以及数据备份策略,适合各类怀旧玩家和技术爱好者。

weixin_29254673的博客 1033

从零到一:基于Docker与OSM数据构建Valhalla路径规划服务及Mapbox风格可视化

本文详细介绍了如何从零开始,基于Docker容器技术快速部署开源的Valhalla路径规划服务。通过获取免费的OSM地图数据并构建路网,最终实现服务调用与Mapbox风格的地图可视化,为出行应用原型开发或本地化路径规划服务提供了一套完整、高效的实践方案。

weixin_29297127的博客 161

【论文阅读】Multi-layer pseudo-supervision for histopathology tissue semantic segmentation using patch-le

使用patch级别的分类标签来实现对组织病理图像的组织语义分割,最终减少了标注的工作量。提出了一个包括分类和分割两个阶段的两步模型。在分类阶段,我们提出了一种基于CAM的模型,通过patch级别的标签来生成伪掩模。在分割阶段,我们提出了多层伪监督算法Multi-Layer Pseudo-Supervision实现了组织语义的分割。介绍了一种新的肺腺癌弱监督语义分割(WSSS)数据集(LUAD-HistoSeg)。我们提出的模型比五种最先进的WSSS方法性能更好。

Magnolia_He的博客 1112

基于LLaMA-action模型的文档摘要任务微调

文档摘要是指从长文档中提取关键信息,生成简短而准确的总结。抽取式摘要:从原文中直接抽取关键句子或短语组成摘要。生成式摘要:通过生成新的句子来表达原文的核心内容。混合式摘要:结合抽取式和生成式方法,既保留原文的关键句子,又生成新的内容。新闻网站:自动生成新闻摘要,帮助用户快速了解新闻要点。社交媒体:为用户提供新闻摘要,便于分享和传播。学术搜索引擎:为用户提供学术文献的摘要,帮助用户快速筛选相关文献。学术写作辅助:帮助研究人员快速生成文献综述部分。企业内部文档管理:自动生成文档摘要,便于员工快速了解文档内容。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1430

Patch-based Convolutional Neural Network总结

Patch-based Convolutional Neural Network for WholeSlide Tissue ImageClassificationabstract总结:为了自动识别癌症的亚型,在千亿像素级的WSI(Whole Slide Tissue Images)上训练一个CNN是不可能的。癌症亚型的差异是基于细胞级的视觉特征,在图像patch上被观察。所以,作者强调在图像pa...

编辑尼撑 7034

详细指南:如何在TI C2000基于C28x的微控制器上部署FreeRTOS_C语言实现

FreeRTOS是一个小型、开源、实时的嵌入式操作系统内核。它为多种微控制器和处理器提供了支持,包括ARM、AVR、MSP430和PIC等。小型和轻量级:适合资源受限的嵌入式系统。实时性:可以满足严格的实时要求。多任务支持:支持多任务并发执行。内存管理:提供了多种内存管理策略。模块化设计:用户可以根据需要选择所需的功能模块。TI C2000系列微控制器是专为实时控制应用设计的。高性能C28x核:提供了高速的浮点运算能力。丰富的外设:包括PWM、ADC、DAC、通信接口等。低功耗。

qq_38334677的博客 1606

深度强化Q学习-基于微软AirSim仿真环境的自动驾驶案例(原理代码详解简易可行)

最近在学习《强化学习原理与Python实现》,肖智清著。参考第十二章的自动驾驶案例,写一篇总结,尽量做到简单可行,让有志于自动驾驶的小伙伴可以通过此篇博客可以管中窥豹,初步了解自动驾驶的强化学习训练过程。 本篇将自动驾驶问题转化为回合制的强化学习任务,设计以车辆观察图像和运行状态为输入的自动驾驶算法,并在AirSim仿真环境中进行训练和测试。本篇使用带经验回放和目标网络的基于深度Q网络算法设计并实现智能体,对经验回放、目标网络和深度Q学习算法进行简单介绍,并用代码实现。

shao918516的博客 8599

人工智能在病理组学领域的最新研究进展|顶刊速递·24-08-05

这篇文章介绍了Virchow,一个用于临床级计算病理学和罕见癌症检测的新型大型基础模型,它通过自监督学习在大量病理图像数据上训练,在多种癌症检测和生物标志物预测任务中展现出高性能。Virchow是目前最大的计算病理学基础模型,它不仅能够预测生物标志物和识别细胞,还能实现泛癌种检测,包括九种常见和七种罕见的癌症类型。研究显示,即使在训练数据较少的情况下,基于Virchow构建的泛癌种检测器也能够达到与特定组织临床级模型相似的性能,并且在某些罕见癌症变体上表现更优。

罗小罗同学的博客 1841

GD32F4xx MCU ADC+DMA 多通道采样

1、GD32F4xx ADC GD32F4xx 的12位ADC是一种采用逐次逼近方式的模拟数字转换器。 1.1 主要特征 可配置12位、10位、8位、6位分辨率; ADC采样率:12位分辨率为2.6MSPs,10位分辨率为3.0 MSPs。分辨率越低,转换越快; PS: MSPs (模拟混合信号转换速率),是指完成1次从模拟转换到数字的AD转换所需的时间的倒数。常用单位是ksps和Msps,表示每秒采样(千)/(百万)次(kilo / Million Samples per Second)。 1msps

madao1234的博客 8117

人工智能在病理组学领域的最新研究进展|顶刊速递·24-07-23

这篇文章是关于一种新的医学图像分类方法,名为ALFREDO(Active Learning with FeatuRe disEntanglement and DOmain adaptation),它结合了主动学习(Active Learning)和领域适应(Domain Adaptation)技术来提高模型在分布偏移情况下的泛化能力。研究背景与动机:深度神经网络(DNNs)在大量标记数据集上表现出色,但难以将学到的知识泛化到新的领域在现实世界中,重新训练网络以适应新应用的大规模数据集收集是不切实际的。

罗小罗同学的博客 1643

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

人工智能在病理组学和影像组学中的最新研究进展|顶刊速递·24-06-28

文章介绍了一个名为nuclei.io的数字病理框架,该框架结合了主动学习和实时的人机交互反馈,用于快速创建多样化的数据集和模型。研究通过两项交叉用户研究验证了该框架的有效性,这些研究利用了AI与病理学家之间的协作,包括在子宫内膜活检中识别浆细胞以及在淋巴结中检测结直肠癌转移。在两项研究中,nuclei.io都显著提高了诊断性能。文章详细讨论了人工智能(AI)和机器学习(ML)算法在数字病理学中取得的显著成就,这些成就包括细胞或组织分割、图像分类、患者预后预测以及淋巴结转移识别等。

罗小罗同学的博客 1885

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

人工智能在【肿瘤生物标志物】领域的最新研究进展|顶刊速递·24-06-08

这篇文章是关于一种新型的深度学习辅助监测技术,该技术基于表面增强拉曼光谱(SERS)免疫分析法,用于监测HER2(人表皮生长因子受体2)过度表达的乳腺癌患者接受曲妥珠单抗(Trastuzumab,也称Herceptin®)治疗的效果。曲妥珠单抗是一种靶向HER2的药物治疗,对于转移性乳腺癌非常有效,但一些患者可能对该药物产生抗性,因此监测其疗效至关重要。研究团队开发了一种基于SERS的免疫分析法,通过检测患者尿液中肿瘤衍生的外泌体生物标志物来监测曲妥珠单抗的疗效。

罗小罗同学的博客 1683

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

医学人工智能必读顶刊综述推荐|顶刊速递·24-09-09

本期主题:医学AI综述最近应该很不少小伙伴在准备硕士/博士的开题,如果你的课题是与医学AI相关的,那么这期推文建议你好好读一读,共计13篇顶刊综述——病理组学7篇,影像组学6篇。虽然我只分了两类,但是里面包含了多模态的综述,也就是说你可以在这些文献中获取与基因组学、代谢组学相关的研究。能发在顶刊的综述,文章的配图都是非常精美的,并且归纳总结的特别好,非常适合用来做答辩的PPT。此外,每一篇文献都附带了我之前发表的文献精析,可以帮助大家快速的了解文献内容。

罗小罗同学的博客 2300

人工智能在数字病理切片虚拟染色以及染色标准化领域的研究进展|顶刊速递·24-06-23

这篇文章介绍了一种用于数字病理学的端到端平台,该平台利用高光谱自荧光显微镜和基于深度学习的虚拟组织学染色技术。研究团队开发了一种定制的高光谱显微镜,用于无损成像未染色组织切片的自荧光。然后,他们训练了一个深度学习模型,使用自荧光生成虚拟的组织学染色,避免了化学染色过程的成本和变异性,并保留了组织样本。通过随机非酒精性脂肪性肝炎(NASH)评分比较研究,展示了虚拟图像在重现真实染色图像中的组织学特征方面具有中等到良好的一致性。

罗小罗同学的博客 3508

人工智能在肿瘤预后预测领域的最新研究进展|顶刊速递·24-08-06

这篇文章是发表在《自然免疫学》2024年4月的一篇研究,题为"An immunophenotype-coupled transcriptomic atlas of human hematopoietic progenitors"。该研究通过单细胞多模态方法,特别是细胞索引转录组和表位测序(CITE-seq)技术,对人类造血祖细胞进行了深入分析。CITE-seq技术允许同时对细胞表面的蛋白质和转录组进行分析,揭示了控制祖细胞状态的基因组程序。

罗小罗同学的博客 1788

人工智能在肿瘤免疫微环境领域的研究进展|顶刊速递·24-08-07

这篇文章综合运用多组学技术和机器学习手段,深入解析肿瘤免疫微环境(TIME)的复杂性,并探索了提高CAR-T细胞免疫疗法在实体瘤中疗效的潜在策略。肿瘤免疫微环境(TIME)由肿瘤内部的免疫细胞和相应组分构成,对肿瘤的启动、发展、转移以及对治疗的反应起着至关重要的作用。TIME的免疫细胞多样性和其与肿瘤细胞的相互作用对癌症治疗尤为关键。CAR-T细胞疗法在血液恶性肿瘤治疗中取得了显著成功,但在实体瘤治疗中仍面临诸多挑战。TIME的异质性被认为是影响CAR-T细胞疗法效果的主要因素。

罗小罗同学的博客 1969

人工智能在多组学领域的最新研究进展|顶刊速递·25-02-13

Artificial intelligence links CT images to pathologic features and survival outcomes of renal masses”发表于,通过开发深度学习模型,利用术前CT影像预测肾肿瘤的良恶性、侵袭性及患者生存结局,为肾肿瘤的诊断和治疗决策提供了重要依据。研究背景:医学影像技术的发展使肾脏偶发瘤的检出率增加,但肾癌特异性死亡率未明显下降,提示可能存在良性肾肿瘤的过度治疗。

罗小罗同学的博客 1623

人工智能在空间转录组学领域的最新研究进展|顶刊速递·24-06-22

这篇文章是一项关于晚期透明细胞肾细胞癌(aRCC)患者接受免疫检查点阻断(ICB)治疗的多组学研究。研究团队通过综合分析肿瘤的多组学数据,开发了一种新的肿瘤转录组特征,即低人类白细胞抗原(HLA)抗原肽结合特异性(HLAprLOW)的肿瘤特征,这种特征能够预测患者对ICB治疗的临床反应。研究包括了对超过1000名患者的肿瘤转录组数据的分析,并通过单细胞和空间分辨率的验证,揭示了患者特异性的炎症性肿瘤相关巨噬细胞和(前)耗竭的CD8+ T细胞之间的相互作用。

罗小罗同学的博客 1900

人工智能在多模态多组学领域的最新研究进展|顶刊速递·24-06-29

这篇文章介绍的一种专门为病理学领域设计的,名为PathChat的多模态生成性人工智能(AI)辅助系统。PathChat由一个基础视觉编码器、一个预训练的大型语言模型以及一个多模态投影模块组成,通过在超过456,000条视觉语言指令上的微调来构建。这些指令包括999,202个问答转换,覆盖了多种组织来源和疾病模型的多项选择诊断问题。研究者们比较了PathChat与其他几种多模态视觉语言AI辅助系统以及GPT4V(驱动商业化多模态通用AI助手ChatGPT-4的模型)的性能。

罗小罗同学的博客 2472

人工智能在病理切片分割领域的最新研究进展|顶刊速递·25-01-17

Graph neural networks in histopathology: Emerging trends and future directions》由Siemen Brussee等人撰写,全面综述了图神经网络(GNNs)在组织病理学中的应用,探讨了新兴趋势并展望了未来发展方向。引言研究背景:组织病理学分析对疾病诊断等意义重大,随着全切片图像数字化,其计算分析愈发关键。深度学习兴起后,卷积神经网络(CNNs)广泛应用,但难以捕捉图像中复杂空间依赖关系。

罗小罗同学的博客 1679

人工智能在淋巴瘤中的最新研究进展|顶刊速递·24-06-27

这篇文章是一项多中心的概念验证研究,探讨了基于深度学习的方法在术中区分原发性中枢神经系统淋巴瘤(PCNSL)与非PCNSL(包括胶质瘤等其他病变)的应用。研究团队开发了一个名为LGNet的深度学习模型,通过分析苏木精-伊红(H&E)染色的冷冻全切片图像,实现了对PCNSL与胶质瘤等病变的精确区分。该模型的性能与不同经验水平的病理学家进行了比较,并尝试了一种人机融合方法,将模型和病理学诊断结合起来。

罗小罗同学的博客 1811

顶刊速递|医学AI在乳腺癌中的最新研究进展·24-09-06

这篇文章利用人工智能和组学技术发现了针对三阴性乳腺癌的焦亡疗法药物组合,为开发新型抗癌药物提供了创新策略。焦亡是一种由Gasdermin (GSDM)蛋白家族介导的细胞死亡方式,可以引发强大的抗肿瘤免疫反应。研究者们利用大数据分析和药物数据库,建立了一个生物因子调控的神经网络(BFRegNN),用于快速筛选和优化焦亡药物组合。他们特别关注了米托蒽醌(mitoxantrone, MIT)和藤黄酸(gambogic acid, GA)的组合,并制备了仿生纳米晶体(MG@PM),以实现合理药物递送。研究发现,

罗小罗同学的博客 2106
上一篇: 从裁员到年薪百万:程序员靠RAG技术逆袭的“核心密码”
下一篇: 用于化学数据提取的大型语言模型
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值