【论文日报】LLM合集:百度推出集体蒙特卡洛树CoMCTS推理框架,打造具备逐步推理能力的MLLM

详细解释大模型逻辑推理中的mcts蒙特卡洛搜索树 蒙特卡洛搜索树是一种强大的搜索算法,在大模型逻辑推理中可以用来处理复杂的多步推理问题。通过结合大模型的生成能力和 MCTS 的决策优化能力,我们能够在不确定性和复杂性较高的问题中生成更准确、更高质量的答案。 阅读详情

1. Mulberry: Empowering MLLM with o1-like Reasoning and Reflection via Collective Monte Carlo Tree Search
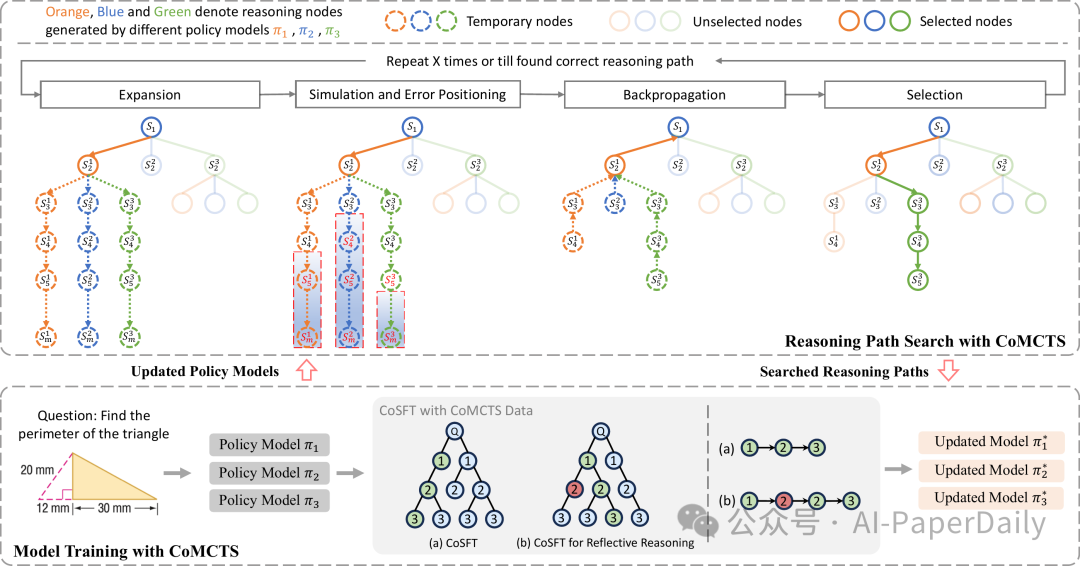
在本文中,我们开发了一个MLLM,使其能够通过学习生成推理过程中的每一个中间步骤来理解和回答问题,直到最终答案。为此,我们提出了集体蒙特卡洛树搜索(CoMCTS),这是一种新的MLLM推理学习方法,它将集体学习的概念提出“树搜索”,以实现有效的推理路径搜索和学习。CoMCTS的核心思想是利用多个模型的集体知识,通过四次迭代操作(扩展、模拟、错误定位、反向传播和选择)协同猜测、搜索和识别通向正确答案的有效推理路径。使用CoMCTS,我们构建了Mulberry-260k,这是一个多模态数据集,其中每个问题都有一个丰富的、明确且定义良好的推理节点树。借助Mulberry-260k,我们进行了集体的自监督训练(SFT),训练出了Mulberry这一系列具有类似o1的逐步推理和反思能力的MLLM。实验结果表明,我们提出的方法在各种基准测试中具有优越性。代码将在https://github.com/HJYao00/Mulberry 。🎉【文末福利送书】🎉

论文: https://arxiv.org/pdf/2412.18319

2. Token-Budget-Aware LLM Reasoning
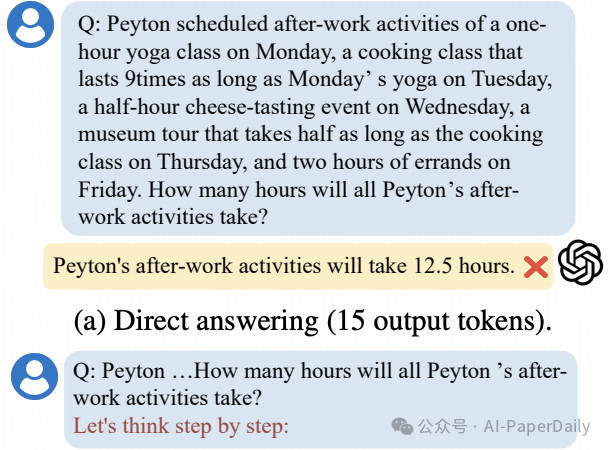
推理对于大型语言模型(LLMs)在广泛任务上的表现至关重要。虽然像链式思考(CoT)推理这样的方法通过将问题分解成中间步骤来提升大型语言模型(LLMs)的表现,但也导致了显著的Token使用量增加,从而增加了成本。我们发现当前的大型语言模型(LLMs)的推理过程过于冗长,可以通过在提示中包含合理的Token预算来压缩推理过程,但Token的选择在实际压缩效果中起着关键作用。我们随后提出了一种Token预算意识的大型语言模型(LLMs)推理框架,该框架根据推理复杂度动态估计不同问题所需的Token预算,并使用估计的Token预算来指导推理。实验表明,我们的方法在CoT推理中仅轻微降低性能的情况下有效减少了Token成本,提供了一种平衡大型语言模型(LLMs)推理效率和准确性的实用解决方案。代码:https://github.com/GeniusHTX/TALE。

论文: https://arxiv.org/pdf/2412.18547

3. Video-Panda: Parameter-efficient Alignment for Encoder-free Video-Language Models
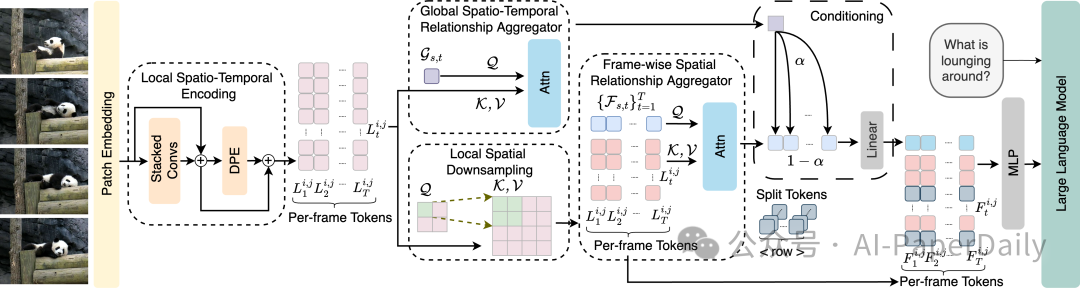
我们提出了一种高效的无需编码器的方法,用于视频-语言理解,该方法显著减少了计算开销。当前的视频-语言模型通常依赖于图像编码器(300M-1.1B 参数)或视频编码器(1B-1.4B 参数),这在处理多帧视频时会带来巨大的计算负担。我们的方法提出了一种新的空间-时间对齐块(STAB),可以直接处理视频输入,无需预先训练的编码器,同时仅使用45M 参数进行视觉处理——与传统方法相比至少减少了6.5倍。STAB 架构结合了局部空间-时间编码以进行细粒度特征提取,通过学习的注意力机制进行有效的空间下采样,并分别用于建模帧级和视频级关系。我们的模型在标准基准上实现了与基于编码器方法相当或更优的开放性视频问答效果。精细粒度的视频问答评估显示了我们模型的有效性,在正确性和时间理解方面超越了基于编码器的方法Video-ChatGPT和Video-LLaVA。广泛的消融研究证实了我们的架构选择,并展示了我们空间-时间建模方法的有效性,同时实现了比之前方法快3-4倍的处理速度。代码可在https://github.com/jh-yi/Video-Panda 获取。

论文: https://arxiv.org/pdf/2412.18609

4. PepTune: De Novo Generation of Therapeutic Peptides with Multi-Objective-Guided Discrete Diffusion
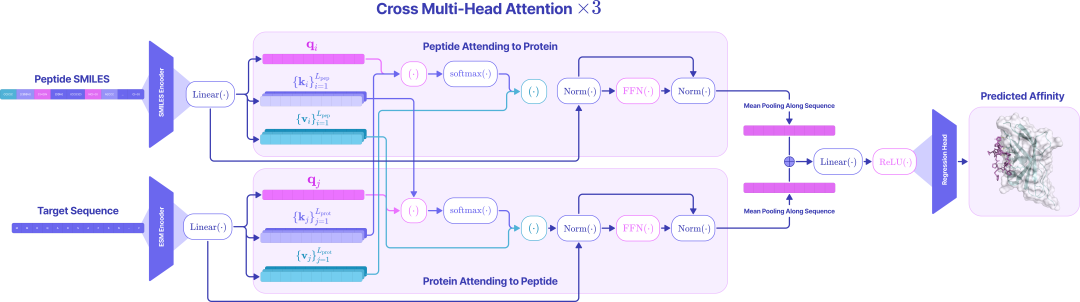
肽治疗药物是一类重要的药物类别,已经在糖尿病和癌症等疾病中取得了显著的成功,例如GLP-1受体激动剂已经彻底改变了2型糖尿病和肥胖症的治疗方法。尽管取得了成功,但设计同时满足多个相互矛盾的目标(如靶点结合亲和力、溶解性和膜渗透性)的肽仍然是一项重大挑战。传统的药物开发和基于结构的设计对于此类任务无效,因为它们无法优化对于治疗效果至关重要的全局功能特性。现有的生成框架大多局限于连续空间、无条件输出或单目标指导,使其不适合在多个属性上的离散序列优化。为了解决这个问题,我们提出了PepTune,这是一种基于多目标离散扩散模型,用于同时生成和优化治疗肽的SMILES。PepTune基于掩码离散语言模型框架,通过状态依赖的掩码调度和基于惩罚的目标确保有效的肽结构。为了指导扩散过程,我们提出了一种基于蒙特卡洛树搜索(MCTS)的策略,该策略平衡探索和利用,以逐步细化帕累托最优序列。MCTS将分类器基于的奖励与搜索树扩展相结合,克服了离散空间中的梯度估计挑战和数据稀疏性。使用PepTune,我们生成了多种多样、化学修饰的肽,优化了多个治疗特性,包括靶点结合亲和力、膜渗透性、溶解性、溶血性和对各种疾病相关目标的非附着特性。总的来说,我们的结果表明,MCTS引导的离散扩散是一种强大且模块化的多目标序列设计方法,在离散状态空间中。

论文: https://arxiv.org/pdf/2412.17780

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

百度坐标批量采集:Excel 地址列到 WGS84 经纬度 空间智能实验室 Vol.20:百度坐标批量采集:Excel 地址列到 WGS84 经纬度 公安、综治类台账里最常见的一张表,往往只有一列「单位地址」,没有坐标。这篇文章拆解我自建的一个小工具:上传 Excel、选一列地址 阅读详情

相关推荐

大模型论文 | 百度推出集体蒙特卡洛树CoMCTS推理框架,打造具备逐步推理能力的MLLM

在本文中,我们开发了一个MLLM,使其能够通过学习生成推理过程中的每一个中间步骤来理解和回答问题,直到最终答案。为此,我们提出了集体蒙特卡洛树搜索(CoMCTS),这是一种新的MLLM推理学习方法,它将集体学习的概念提出“树搜索”,以实现有效的推理路径搜索和学习。CoMCTS的核心思想是利用多个模型的集体知识,通过四次迭代操作(扩展、模拟、错误定位、反向传播和选择)协同猜测、搜索和识别通向正确答案的有效推理路径。

star_nwe的博客 1383

采用超级电容设计的UPS不间断电源,用于掉电数据保存,可续航10-60秒

关键词:树莓派 CM4 UPS 不间断电源 掉电保存 超级电容 SuperCap 充电 升压 续航 10F 法拉电容 Mcuzone 野芯科技 概述:我们经常会遇到系统意外掉电的情况,对于一些可靠性要求很高的工业现场设备或者运行过程中有重要数据需要保存的平台就需要UPS电源了。常规的UPS采用后备锂电池设计,具备无缝切换、续航时间长、稳定可靠等特点,但同时也有价格过高、体积过大的缺点。对于不少仅需在检测到系统掉电后对数据进行保存即可的应用而言,这些标准的UPS电源就不太合适,为此我...

6606

Mulberry:多模型合作MCTS,让MLLM进入o1推理时代

Huanjin Yao, Jiaxing Huang 等本文提出集体蒙特卡洛树搜索(Collective Monte Carlo Tree Search, CoMCTS)方法,利用多模型协作搜索和反思推理路径,并使用生成的推理数据对多模态大语言模型(MLLM)进行微调,从而提升其推理能力。

xx_nm98的博客 1775

solidworks vba二次开发配合问题

solidworks vba二次开发配合问题二次开发装配的步骤 二次开发装配的步骤 solidworks可以使用宏录制配合过程从而得到配合的vba代码,步骤如下: 1.选择两个配合的面(点、线等) 2. 建立配合 例如将两个圆柱面同心(图中高亮): 配合后 我们看一下宏录制的代码: Sub main() //激活solidworks接口 Set swApp = Application.SldWorks Set Part = swApp.ActiveDoc //选择两个圆柱面,注意此处是根据坐标选择,不

Alejandro123的博客 3406

YOLOv8实战:用Labelme标注自定义数据集并训练分割模型(附完整代码)

本文详细介绍了使用Labelme标注自定义数据集并训练YOLOv8实例分割模型的完整流程。从环境搭建、数据标注与格式转换,到模型训练、调优、验证及部署,提供了实战代码和调优建议。文章还探讨了如何结合追踪目标技术,实现视频流中的实例分割与目标追踪,为计算机视觉应用提供了一套可复制的解决方案。

552

Token-Budget-Aware LLM Reasoning

作者发现,当给大模型输入的提示词内,加入思考不超过xxx个token,可以很好的控制模型思考的长度,并且给出正确的答案,但是同时也存在问题。如上图所示:当不断压缩这个上限的时候,模型开始不遵守这个上限,因此我们需要找到一个:模型可以遵守并且可以得到正确答案的思考上限。最简单的方法就是二分法,将原始CoT作为右边界,不断的二分,取中点,如果回答正确,并且思维链长度被压缩,就继续下一个二分,直到:模型无法正确回答,或者思维链长度已经不被压缩。

volcan的博客 543

Web端百度离线地图3.0实战:从零搭建到私有化部署

本文详细介绍了Web端百度离线地图3.0的完整实战流程,从核心SDK本地化、功能模块下载到地图瓦片部署。通过逐步修改代码与配置,实现在无外网环境下的私有化部署,解决了内网或网络不稳定场景下的地图应用需求,并提供了关键的避坑指南。

n7o8p的博客 715

从话痨到省流大师,效果堪比双十一满减:TALE让LLM学会“断舍离”

你以为只有人类会为了省钱精打细算?大语言模型(LLM)也开始学会“抠门”了!传统思维链(CoT)推理虽然让模型表现更聪明,但代价是生成一长串中间步骤,活像个话痨,输出令牌数飙升,烧钱又费电。比如一个问题原本直接回答只要10个令牌,用了CoT直接膨胀到258个令牌,钱包瞬间缩水????。下面看个经典对比:无CoT直接翻车,带CoT正确但啰嗦,加预算后既省令牌又答对论文:Token-Budget-Aware...

zenRRan的博客 1061

北斗导航 | 基于matlab的卫星导航单点定位算法

单点定位(Single Point Positioning, SPP)通过接收机观测至少4颗卫星的伪距(含误差的距离测量值),解算接收机位置(经度、纬度、高度)及钟差。HDOP < 2 为高精度定位条件。

尘世冰封的专栏 972

YOLOv8改进策略【损失函数篇】| 2024 引进Focaler-IoU损失函数 加强边界框回归 (Focaler-DIoU、Focaler-GIoU、Focaler-CIoU)

本文记录的是改进YOLOv8的损失函数,将其替换成。现有研究通过利用边界框之间的几何关系来提高回归性能,但忽略了困难样本和简单样本分布对边界框回归的影响。不同检测任务中困难样本和简单样本的分布不同,对于简单样本占主导的检测任务,关注简单样本的边界框回归有助于提高检测性能;对于困难样本比例较高的检测任务,需要关注困难样本的边界框回归。,提高检测器在不同检测任务中的性能。实现的。

Limiiiing的博客 1223

【AI论文】草案链:少写多思,提升思考速度

大型语言模型(LLMs)在通过思维链(Chain-of-Thought,CoT)提示等机制解决复杂推理任务方面展现出了卓越的性能,该机制强调详细、逐步的推理过程。然而,人类通常采用一种更高效的策略:起草简洁的中间思路,仅捕捉必要信息。在本文中,我们提出了一种受人类认知过程启发的新型范式——草案链(Chain of Draft,CoD)。在该范式中,LLMs在解决任务时生成极简但信息丰富的中间推理输出。

m0_66899341的博客 1128

系统架构设计师重难点知识脑图

大家都知道现在的软考自从变成机考后,越来越难了,教程上的内容不仅全还细,几乎任何内容都有可能考,出题老师主打一个出其不意,比如2024年5月考试,连UML时序图的片段都考,这。软件工程、系统架构基础知识、系统质量属性与架构评估、软件架构的演化和维护、信息系统架构设计、层次式架构设计、云原生架构设计、面向服务架构设计、安全架构设计、大数据架构设计等。所以对于教程上的任何知识点,都需要去记忆。因此我在这里制作了一个脑图,将所有知识点集中在一个脑图中,通过首词组句法,记忆背诵,通过一个个的展开节点,加强记忆。

分享技术干货和灵感、推荐新书和好玩的项目、分享Java面试题 1105

2024年6月上半月30篇大语言模型的论文推荐

特征工程和数据预处理是任何机器学习中的关键步骤。它们可以通过确保数据干净、结构良好和信息丰富来显著提高模型的性能。本文介绍了如何处理异常值和缺失值、编码分类变量、缩放数值特征和创建新特征——为准备机器学习任务的数据奠定了坚实的基础。我们这里也只是介绍一些简单常见的技术,使用更复杂和更具体技术将取决于数据集和试图解决的问题。作者:Kursat Dinc。

deephub 9015

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

利用蒙特卡洛树搜索自我精炼算法提升大模型的数学解题能力

尽管LLMs在处理语言相关任务时表现出色,但在数学问题解决等需要精确推理的领域,它们的输出往往容易出错。这些错误输出虽然表面上看似合理,但实际上与事实不符,对理性过程有害。为了提高模型在这些领域的性能,来自复旦大学和上海人工智能实验室的研究团队提出了MCT Self-Refine(MCTSr)算法,该算法通过系统的探索和启发式自我精炼机制,改善了LLMs中的决策框架。留言“参加”即可来叶老师的直播间互动,

人工智能讲师分享前沿技术 1136

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

目前MLLM的研究有哪些比较好的切入点?

MLLM确实是当下的研究热点,从Meta最近在多模态模型上下的功夫就能看出来。如果有想法切入,现在入场也不算晚,长尾问题还有模态扩展问题一堆。这方向门槛比较低的切入点可以考虑小目标推理增强、多模态指令调优优化、工业异常检测,方便快速出成果。想冲CVPR/AAAI/NeurIPS,就试试效率提升、认知机制、啃视频/具身、伦理合规等。比起单模态LLM,MLLM现在还处在“蓝海混战”阶段,想发论文的抓紧把握窗口期。我这回准备了70篇MLLM前沿论文,包含近三年代表性模型,开源代码已附,需要参考的自取。

学姐带你玩AI的博客 1320

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【论文日报】LLM合集:腾讯推出AlphaLLM-CPL,采用蒙特卡洛树搜索提升LLM的推理能力

我们使用两种家族的VLMs,即双编码器(例如,CLIP)和编码器-解码器(例如,LLaVa)模型,在16个不同的数据集上全面评估了我们的GLOV,结果显示发现的解决方案可以将这些模型的识别性能提高多达15.0%和57.5%(平均提高3.8%和21.6%)。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。天道酬勤,你越努力,就会成为越优秀的自己。

m0_59164304的博客 963

百度开源文心5.5 Flash Base:280B MoE 只激活 14B,4 步部署 + 3 个坑,微调还是等指令版

百度开源文心 5.5 Flash 基座权重:280B MoE 每 token 激活 14B,1M 上下文,同尺寸开源 Base 30 项基准多数领先。4 步部署(vLLM/SGLang completions 链路)+ 3 个高频坑 + 动手前 6 点核对清单,并给出微调 Base 还是等指令版的判断线。

weixin_50937681的博客 351

百度 ERNIE Evolve 自动研究系统:NanoGPT 速通 38.9 秒,P800 推理速度达基线 623.6%

百度文心团队 11 月 9 日在技术博客发布《ERNIE Evolve:让自动研究走进真实 AI 研发》,介绍一套自动研究系统:给它一个真实代码仓库、一个优化目标和一套评测标准,它自己提出研究方向,在隔离环境里改代码、跑实验,靠独立评测决定哪些改动留下,再把每轮的发现存成后续可复用的经验。百度把这件事放在“递归自我迭代”(RSI)的框架里讲,也就是让自动研究去改进做 AI 研发的系统本身。 文章先在三项公开任务上检验它,分别对应训练算法、训练速度和 GPU 算子;随后把它接进还在开发中的 ERNIE 5.5

2601_95836219的博客 368

【百度拥抱开源】ERNIE-5.5-Flash-Base 重磅开源:280B-A14B 稀疏 MoE,1M 上下文,多项基准超越同级对手

ERNIE-5.5-Flash-Base 是百度推出的280B参数稀疏MoE语言模型,每token激活14B参数,支持最大128K训练上下文及1M微调/推理上下文。基于33.5T tokens预训练,采用高效架构设计如HCA+MLA注意力、Multi-Router MoE、VHA与ECHO机制,结合流形约束残差与MultiMax输出头,在知识、推理、代码、多语言及长文本任务中表现优异。提供FP8与BF16版本,可于Hugging Face与ModelScope获取,适用于领域适配与智能体开发。

weixin_41446370的博客 372

WordPress发布/编辑文章自动推送给百度和必应的方法

本文介绍如何通过WordPress主题的functions.php文件,实现文章发布或编辑时自动推送URL至百度和必应。只需添加代码,配置网站地址、必应与百度API密钥,并启用后,系统将自动提交链接,成功则标记为“1”,便于后台查看推送状态,有效提升收录效率。

boke112的博客 240

文心 5.5 Flash Base:百度把“效率“写进了预训练

百度于2026年11月5日开源文心5.5FlashBase(ERNIE-5.5-Flash-Base),一款280B总参数、每token仅激活14B的预训练基座模型,支持最长1M上下文推理。其核心创新在于通过37层压缩注意力(HCA)与6层精读注意力(MLA-DSA)结合,实现长文本高效处理;采用多路由潜空间MoE提升专家利用率;引入ECHO机制强化主干规划能力。在代码、推理、长上下文等任务中达同尺寸SOTA,但需8卡H100起步,适用于领域微调、SFT与Agent训练,不支持直接对话。

【可全包】本人程序员,不需要做任何吹嘘,只是实在写点程序,写点文档,熟悉各类主流框架,SSM,SpringBoot,Flask,Djiango,Mysql,Sqlite,VUE,Uniapp等,各类程序设计专家,优质作者 513

高德、百度、腾讯、维智地图服务深度对比:从参数到选型的完整指南

相比之下,维智虽然以企业合作为主,但对中小团队的商务灵活度更高,POI 搜索、室内外定位、IP 定位、正逆地理编码、距离计算、行政区域、水域、天气等接口矩阵齐全,可以随着业务成长平滑扩展。它并不是只能补室内短板的“增强型服务”,而是已经具备完整位置服务接口矩阵,并在此基础上叠加室内外一体化、数据主权、定制化能力,以及 Android、iOS、小程序、Flutter、uni-app 多端 SDK 与 UNI 定位插件,构成的是完整的企业级位置服务底座。高德、百度、腾讯的室内地图更多是"锦上添花",覆盖有限;

weixin_36931768的博客 504

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 305

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 153

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 239
上一篇: 万字解读 LLMs+RL 综述!| open AI 引领LLMs结合强化学习新范式,开源代码还不赶快学起来?
下一篇: 探秘基于LLM的自主智能体:构建、应用与挑战全解析
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值