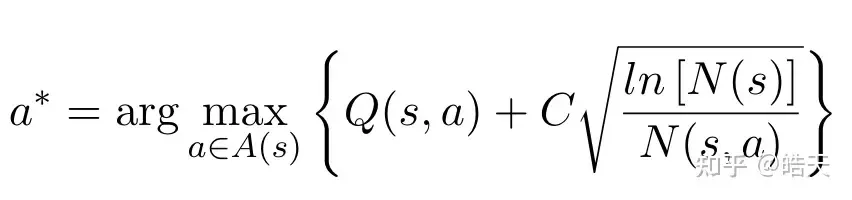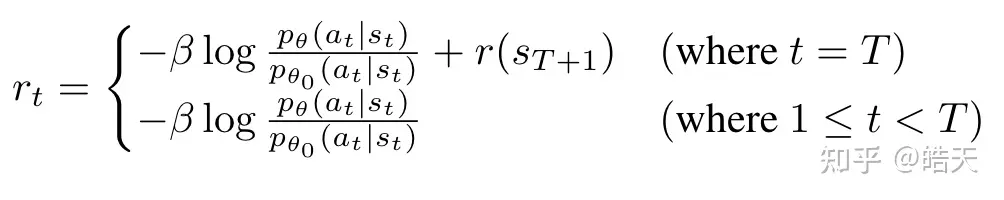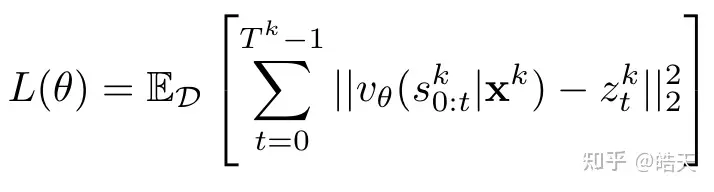OpenAI o1背后的技术:LLM的快思考与慢思考路线之MCTS

强化学习中的策略梯度方法(游戏AI、机器人、自动驾驶) 选择一个参数化的策略函数,通常用神经网络来表示,该函数将状态映射到动作的概率分布。 阅读详情
AI摘要

本文介绍了MCTS及其与大语言模型(LLM)结合的应用,如PPO - MCTS等,探讨了LLM - MCTS在任务规划中的应用及相关问题。还给出了大模型AI的学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段,并提供了免费学习资料获取方式。

MCTS

Monte-Carlo-Tree-Search[2] 主要用于解决复杂序列决策问题,基于policy-model和evaluation-function,找到reward最大的决策序列。evaluation-function评估基于policy-model生成的partial sequences,实现更好的exploitation和exploration的平衡。该方法在棋类游戏中应用广泛。其核心包含四个步骤: selection, expansion, simulation和backpropagation。在这里插入图片描述
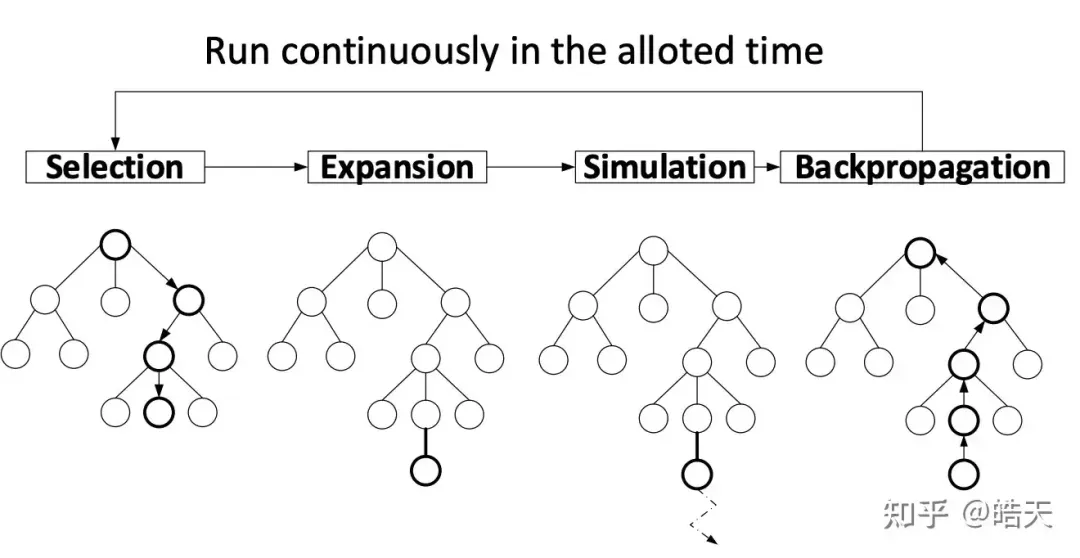
  • Selection: 根据一定准则在叶子节点中选择一个节点。为了保证exploitation(visit-count/reward)和exploration(未被访问的节点),通常使用UCT[2]作为叶子节点:在这里插入图片描述
    近期,文献[3]提出了使用PUCT(引入了policy的prior-probability):
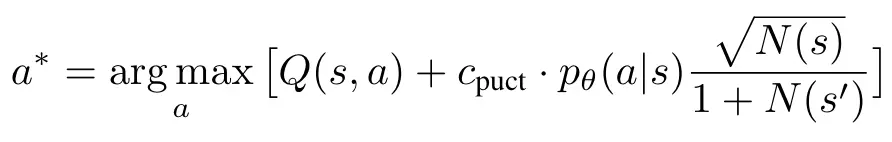
  • Expansion: 上一步中选择的节点被标记为已探索并与其父节点建立链接关系。

  • Simulation: 从root节点到被expanded的节点作为prefix-sequence,应用policy-model生成后续的序列。通常基于一定的终止条件终止simulation,如生成结束符号、达到指定的rollout长度等。

  • Backpropagation: 在simulation中产生的sequence,应用evaluation-function评估reward(如质量分、输赢)等,并将reward从结束节点反传回根节点,更新路径节点的访问次数和节点reward。

从MCTS的基本原理,我们可以看到,MCTS可以看成某种慢思考,即通过policy-model快速生成路径,并通过MCTS不断评估和更新中间过程,最终产生更准确的决策输出。

LLM-MCTS

随着ai-agent的兴起,LLM带来了更多的可能性,不仅限于传统NLP/NLG任务以及作为核心系统的子模块,其本身可以作为复杂系统的决策中枢,改变传统软件、复杂系统的工作模式。当LLM作为ai-agent的决策中枢时,核心问题是在用户给定的指令下,自动将指令分解(复杂问题分解为若干子问题)、指令泛化(子问题的关联问题泛化)、复杂子问题的工具调用以及最终的解决方案生成。

类比人类解决问题,通常在某一领域有丰富经验的专家,对于领域问题具备一定的一步到位解决能力,俗称‘肌肉记忆’。通过大量的刻意练习,将中间思考步骤逐渐固化为本能,不需要刻意思考也能快速提出最终的解决方案。这种方式可以粗略理解为“greedy-decoding”,即通过大量刻意练习(包括但不限于SFT(mentor手把手教)和RLHF(外部反馈)等),将技能固化为本能即模型的快思考。

当面对新的复杂问题时,快思考往往难以一步到位给出好的解决方案,还可能局限于已有的领域知识,给出错误但confident的解决方案—陷入快思考陷阱或者定势思维。这个时候,慢思考往往能带来新的思路,帮助我们不断评估中间过程和结果,最终从‘first-principle’的角度解决新的复杂问题。这一范式可以对应到MCTS,即不断提出问题、中间解决方案和评估,最终,根据中间过程的“价值”(访问次数/reward)输出最优的解决方案。

当我们将LLM与MCTS结合时,赋予LLM慢思考的能力,一般需要解决以下问题:

  1. 高效的rollout

  2. evaluation-function

  3. node-representation and edge-representation

下面,我们主要分析三篇文章[3][4][5],均是将LLM与MCTS结合,提升模型的生成、planning能力。

MAKING PPO EVEN BETTER: VALUE-GUIDED MONTE-CARLO TREE SEARCH DECODING

PPO-MCTS巧妙地利用了PPO训练过程的产出物:value-function: 估计当前 (state, action) 下的 reward,而不需要完整地 rollout (rollout 的计算复杂度较高)。为了估计 ,PPO-MCTS 作了如下近似作为 的初始化:使用 state-value-function 近似 state-action-value-function。

即在当前的状态 (MCTS 的 prefix-sequence)下,select 节点 的累计期望 reward 即 仅与状态有关,而与 select 的节点 无关(相当于 action 的分布为均匀分布)。

当进行 backpropagation 时,通过以下方式更新 state-action-value-function(state-action-value-function 的标准更新方法):在这里插入图片描述
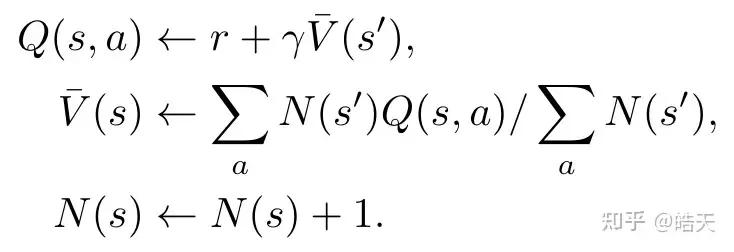
这里,的计算方法为:然而,实际应用时,存在几个约束:

  1. reward-model无法获取。此时,我们可以使用value-function近似reward-function,即用 近似 。

  2. reference-model无法获取。此时,我们无法根据step-level-reward估计state-value-function,所以,我们只能粗略的近似 。这种情况相当于去掉了policy-model和reference-model的kl-divergence,可能存在退化以及reward-hacking。

由于PPO优化过程存在诸多trick,如Reward normalization,Reward whitening,KL term clamping 以及 Adaptive KL coefficient。当使用这些trick时,step-level-reward的计算不准确,所以,我们需要使用 。(当然,如果有消融实验,对比 step-level-reward 和 的结果,对于实践会更有帮助)。

Large Language Models as Commonsense Knowledge for Large-Scale Task Planning
在这里插入图片描述
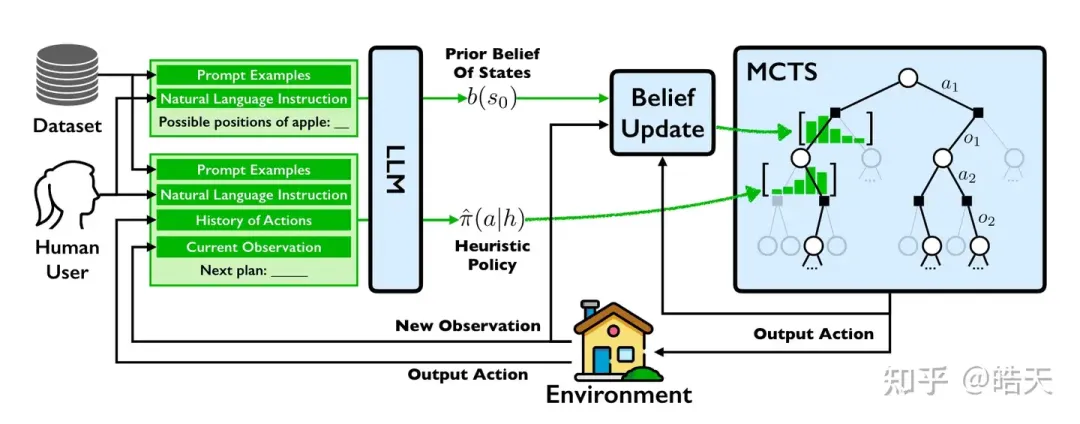
该方法的核心思路如上图所示。该文章主要处理language-instructed object rearrangement tasks。核心在于:

  1. state-representation。该文章主要解决object rearrangement,其状态包括 object、robot-position、moveable-items和moveable-containers。

  2. action-representation。object picking, object placing, moving, opening a container, and closing a container。

  3. MCTS的node和edge。将objects建模为node,将物体之间的关系建模为edge。

该文章将MCTS与ChatGPT结合,MCTS的使用较为常规。但在MCTS的加持下,ChatGPT具备了更强的任务规划能力,相比ChatGPT-policy,提升了10个点以上。具体细节可参考对应文章。

ALPHAZERO-LIKE TREE-SEARCH CAN GUIDE LARGE LANGUAGE MODEL DECODING AND TRAINING

该文章探讨了我们提到的三个基本问题:MCTS中的node、edge表示、evaluation-function以及rollout。

  • node表示:

  • 将word作为节点。适用于短输出。

  • 将句子作为节点。适用于长文。(EBM-MCTS中,也是类似的考虑,将句子作为node)

  • edge表示:当我们有语言模型后,node之间的转移可以通过LLM计算。某种程度上,可以看成一种model-based-RL。所以,edge表示了node之间的转移概率且可以通过LLM计算。

  • evaluation-function:将value-function作为MCTS的evaluation-function。value-function的损失函数为(这部分内容也在PPO中有类似计算过程,详见[3]):其中, 可以通过MC-estimate或者 估计。

此外,这篇文章介绍了三个MCTS的变种:

  1. MCTS-:该方法主要应用于alphazero。在当前state下,做N次simulations(select, expand, backup)。node的value使用value-function估计。然后根据node访问次数,选择一个node并进入下一个state。直到达到terminal-node。由于有value-function,不必rollout也能估计节点reward并backup。

  2. MCTS[2]:相比MCTS-,经典MCTS需要select、expand、rollout、backup。而且,只能从terminal-node的reward回溯更新路径上的中间节点reward。并且,总是从initial state node出发。在空间较大的时候计算复杂度更高。

  3. MCTS-Rollout:结合了以上两个方法的优点。能够基于value-function估计中间节点的reward并进行backup(而不需要rollout到terminal-node)。并且,每次从root-node开始模拟。

这里,是否需要rollout取决于evaluation-function。如果evaluation-function能够估计 或者 ,则可以使用 MCTS-,反之,则需要rollout并基于terminal-node的reward(只能利用最后输赢的reward更新节点reward)。

未来

  • LLM-based的MCTS高效实现,在复杂任务或者OOD上取得更理想的效果。

  • Rollout一般需要更多的计算量。为了避免rollout,我们需要估计一个较好的value-function,用于评估当前state下的reward。一般而言,需要通过RL估计 或者。[3]使用了PPO的value-function(critic-model)做一些近似或者直接训练一个value-function[5]。也能借鉴Q-learning如Implicit-language-q-learning[6]等,使用offline-method等提升样本效率。

  • 当SFT进行到一定程度后,可以借鉴multi-agent-RL的方法,进行多智能体的训练,提升LLM解决复杂问题的能力,实现更好的alignment。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

强化学习MCTS中的Q(Q-Value)和p(Policy) Q值(预期回报)和P(概率分布)在强化学习和MCTS中共同作用于指导搜索过程和制定策略以最大化预期回报。 阅读详情

相关推荐

RK3576平台部署NanoTrack:边缘AI视觉跟踪实战指南

边缘AI部署是将深度学习模型在资源受限的嵌入式设备上高效运行的关键技术,其核心在于模型压缩、硬件适配与软件栈优化。通过INT8量化、算子融合与内存优化等原理,能显著降低模型计算量与内存占用,从而在嵌入式NPU上实现实时推理。这项技术的价值在于为安防监控、无人机视觉、工业检测等场景提供低功耗、高响应的智能感知能力。以瑞芯微RK3576平台部署轻量级视觉跟踪模型NanoTrack为例,其过程涉及模型结构分析、RKNN工具链转换、C++推理程序开发及多线程性能优化,完整展现了从算法到产品的工程化路径,为开发者提供

weixin_31887307的博客 428

PPO-MCTS

在控制文本情绪中,PPO-MCTS 在不损害文本流畅度的情况下,目标完成率比 PPO 基线高出 30 个百分点,在手动评测中的胜率也高出 20 个百分点。在一项最新的研究中,来自 UW 和 Meta 的研究者提出了一种新的解码算法,将 AlphaGo 采用的蒙特卡洛树搜索算法(Monte-Carlo Tree Search, MCTS)应用到经过近端策略优化(Proximal Policy Optimization, PPO)训练的 RLHF 语言模型上,大幅提高了模型生成文本的质量。whaosoft ai

whaosoft143ai的博客 1428

【ROS】ROS局域网下多机通讯方法

最近工作中需要用到多机通讯,这里稍微总结一下使用方法。一、网络配置ifconfig这里举个例子,主机的IP地址为192.168.1.127,从机的IP地址为192.168.1.126;之后可测试一下能否互相ping通,成功后进行下一步。

weixin_43326110的博客 3362

AI 大模型Paper Reading: 结合LLM + MCTS 合成新的数据集fine-tune大模型,提高LLM 推理能力

今天来看一篇新的文章,是由腾讯AI LAB的写的,我的同学也是该文章的一作!所以非常感兴趣看了下!感觉非常impressive!之前我看过几篇文章关于MCTS 结合LLM的paper, 但是总体来说是一种拿来即用的模式,没有把MCTS 去进一步优化模型参数从而进一步提升模型推理,但是这篇文章用MCTS 去进一步fine-tune 大模型,从而会不断的迭代大模型。

m0_59235699的博客 2113

头歌 DNS协议分析第3关----DNS 报文分析

DNS 报文分析

qq_67667368的博客 4349

18、偏微分方程数值计算:粘性不可压缩流与电磁学的有限元方法

本文系统介绍了偏微分方程数值计算在粘性不可压缩流与电磁学中的应用,重点探讨了稳态与非稳态Navier-Stokes问题的混合有限元方法及求解技术,包括弱形式构建、半离散与时间离散格式、牛顿迭代法等。同时,详细阐述了电磁学中Maxwell方程的有限元与时域有限差分法(FDTD)求解方法,涵盖时间谐波与时域波方程、边界条件处理、稳定性分析与误差估计。结合MATLAB代码示例和实际案例,展示了速度场、压力、电场与磁场的数值模拟过程,并通过流程图与表格对比了两类问题的方法原理、应用场景与收敛性特性。最后展望了多物理

lemon的博客 89

LLM + MCTS

LLM + MCTS 是一种强大而灵活的组合,适合需要多步推理、全局规划和复杂决策的任务。通过利用 LLM 的生成和评估能力,以及 MCTS 的探索和优化能力,可以解决许多传统方法难以高效解决的问题。

程序认生 1748

uniapp [全端兼容] - 实现省市区选择器三四级联动组件,uniapp选择地址自定义省市区三级联动插件,弹框式多级联动选择器区域选择(全平台兼容苹果安卓App、支付宝微信小程序、移动端H5网页)

uni-app省市区选择器,省市区街道三级四级联动选择器,uniapp自定义多列选择器省市两级联动,uniapp picker组件实现多级联动,h5移动端网页,微信小程序,支付宝小程序,Android安卓,苹果ios,app,nvue,uniApp选择器省市区县街道乡镇,uniapp实现省市区选择联动,uniapp城市三级联动(自定义组件)_uniapp三级联动,picker插件省市区联动,uniapp小程序省市区选择器,uni-app 省市区街道的四级联动选择,uniapp怎样实现省市区地址三级联动uni

🏆 前端领域优质创作者 1万+

2024年大模型Alignment偏好优化技术PPO,DPO, SimPO,KTO,Step-DPO, MCTS-DPO,SPO

知乎:是念链接:https://zhuanlan.zhihu.com/p/710021282学术分享,侵删今年做过一段时间的alignment工作,做得有点不开心,各种social的原因,觉得自己的发挥受到了限制,最近又闲下来了,所以看了一些相关的论文,但是对这个方向还是挺感兴趣的,这里来分享一下我对alignment的一些理解。对齐一般使用的是chat或者instruct模型,而不是base模型...

zenRRan的博客 4042

华为OD技术面八股文_C++_01

汇总华为OD技术面C++方向八股文真题,并提供详细解答。

qq_45776114的博客 1889

AgentScope 2.0 扩展开发完全指南:从中间件到模型适配器的深度实践

本文系统讲解 AgentScope 2.0 框架的五大扩展机制,涵盖中间件系统的洋葱模型与钩子设计、ChatModelBase 基类与多供应商适配器开发、工作空间(本地/Docker/E2B)的抽象接口与生命周期管理、凭据工厂与 MCP 协议集成、以及工具协议与存储后端扩展。文中提供完整的架构图、代码示例与故障排查指南,帮助开发者快速掌握 AgentScope 的插件化扩展体系。

program哲学 298

万字长文揭秘o1技术路线,强化学习增强LLM深度推理能力

过去两年中,人工智能领域见证了大语言模型前所未有的探索和进步。大语言模型已经逐步发展到能够处理越来越复杂的任务,如编程和解决高级数学问题。OpenAI o1 代表了 AI 的一个重要里程碑,它可以生成非常长的推理过程,并进行类似人类的推理动作,如澄清和分解问题、反思和纠正以前的错误、在遇到故障模式时探索新的解决方案。o1 模型显著超越了前代大语言模型的推理能力,达到了与博士水平相当的性能。其卓越的推理成就显著推动了 OpenAI 在其五阶段路线图中向通用人工智能第二阶段(“推理者”)的进展。

m0_59164520的博客 1517

WPF实现圆形菜单动态展开折叠效果

实现效果如下: 思路:根据子菜单个数计算旋转角度动态生成子菜单,并设置展开折叠动画。 步骤: 1、自定义按钮MyButton,建立展示图像属性DisplayImage public class MyButton : Button { public static readonly DependencyProperty DisplayImageProperty = DependencyProperty.Register("DisplayImage", typeof(

dnazhd的博客 3152

Reverse-o1:OpenAI o1原理逆向工程图解

我们可以从o1的价格入手分析。目前已知:o1 Preview比GPT 4o的输入价格贵3倍,输出价格贵4倍,o1 mini输入和输出价格都是GPT 4o mini的20倍(参考上图)。这里插入一段,解释下为何大模型的输入价格和输出价格是不同的,这是因为在大模型推理(inference,相对模型训练来说的,不是指逻辑推理)阶段,分为Prefill和Decoding两个阶段(参考上图)。

2401_84204413的博客 2178

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

OpenAI最大秘密,竟被中国研究者破解?复旦等惊人揭秘o1路线图

值得一提的是,斯坦福和谷歌在2022年的「STaR: Self-Taught Reasoner」论文中提出,可以利用LLM在回答问题之前生成的「推理过程」来微调未来的模型,从而提高它们回答此类问题的能力。对此,有网友表示,这项研究的意义绝不仅仅是发表了一篇论文,它还为大多数模型打开了大门,让其他人可以使用RL来实现相同的概念,提供不同类型的推理反馈,同时还开发了AI可以使用的剧本和食谱。相比之下,强化学习通过与环境的交互进行学习,避免了高昂的数据标注成本,并有可能实现超越人类的表现。

AIBigModel的博客 1016

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

OpenAI发布最强推理模型o1,大模型升级版来了

北京时间9月13日凌晨,美国OpenAI公司发布全新模型技术产品o1,包括两种版本o1-preview 和 o1-mini,前者具有高级推理功能,在推理数学、编程、科学等问题的能力上有显著提高,性能接近理化生博士水平;后者则是一款更小巧、专为代码生成优化的模型。OpenAI表示,对于复杂推理任务而言,新模型代表着 AI 能力的崭新水平,因此值得将计数重置为1,给它一个有别于“GPT-4”系列的全新名号。同时,这也预示着,AI时代迎来崭新的起点——能够进行通用复杂推理的大模型重要到来。

2401_85390073的博客 1310

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

从强化学习的角度理解O1【kimi解读】

这些开源o1项目在不同的方面对路线图中的关键组件进行了探索和实现。它们通过不同的方法和策略,尝试复现o1模型的推理能力和性能。这些项目不仅验证了路线图中各个组件的有效性,还提供了具体的实现细节和实验结果,为未来的研究和开发提供了宝贵的参考。通过这些项目的实践,研究者可以更好地理解如何在实际应用中结合策略初始化、奖励设计、搜索和学习,以构建具有强推理能力的大型语言模型。将o1适应到一般领域需要解决的关键挑战包括构建通用奖励模型、处理多模态数据和构建世界模型。

xiaoxiaoyu290的博客 1272

OpenAI的真正对手?DeepSeek-R1如何用强化学习重构LLM能力边界——DeepSeek-R1论文精读

2025年1月20日,DeepSeek-R1 发布,并同步**开源**模型权重。截至目前,DeepSeek 发布的 iOS 应用甚至超越了 ChatGPT 的官方应用,直接登顶 AppStore。DeepSeek-R1 一经发布,各种资讯已经铺天盖地,那就让我们一起来精读一下论文,看看引爆AI圈的 DeepSeek-R1 是如何炼成的?

zag666的博客 3772

推理模型:内置思考引擎与推理令牌的技术原理

推理模型是一种突破传统生成式AI局限的新范式,其核心在于将‘分步思考’从外部提示词诱导升级为模型内置的、可审计的计算过程。它基于搜索算法与形式化验证思想,通过构造带状态标签的思考链数据、引入思考预算机制,实现多路径推演与自我验证。技术价值体现在元认知能力增强、幻觉抑制提升及决策可解释性强化,广泛应用于数学证明、代码审查、金融风控等需高可靠性推理的场景。本文深入解析其‘思考令牌’隔离机制与蜂群式协同架构设计。

weixin_30652491的博客 404

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2319

腾讯:LLM结合快慢思考求解复杂问题

如何提升大语言模型(LLM)在需要多步骤思考和多种技能的复杂推理问题上的表现?论文提出了一个名为HDFlow的框架,通过混合思维和动态工作流来增强LLM解决复杂问题的能力,并展示了在多个基准数据集上的显著性能提升。

大模型任我行的博客 3433

大模型LLM | OpenAI o1 技术:使用MCTS增强推理能力(基于代码实践的解读)

在本文中,我们以rStar为例,从代码级别的角度,给出了o1(可能的)实现框架中Inference这块积木的一个实现方法。有了对MCTS如何运用在nlp任务上的一些初步理解,接下来我们就可以按自己的兴趣,广泛探索这块黄色积木的各种实现方式啦(其实本质上都做得差不多)。AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。

老皮的博客 3206
上一篇: 基于AI知识库RAG的综合窗口智能助手
下一篇: 解决时间序列预测中的预测延迟问题,实现更精准的金融和天气趋势预测
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值