


集群线上扩容如何达到自动化?线上扩容,规模正常都以 10+以上,如果都以课堂所示,人肉操作,时间投入与产出比不匹配,人力造成很大的不必要浪费,想学习老师线上集群实际扩容的方案。
A:课堂所示兼顾了小白同学,所以是手把手纯人肉搭建,产线环境扩容数量少则几十多则上百,人肉肯定不行,我们公司的运维分为 IAAS 运维、大数据运维、应用运维,大数据运维工程师在扩容集群时,需要向 IAAS 运维工程师以工单的方式申请服务器并提出自己的需求, IAAS 运维工程师在提供服务器时不管是新采购服务器还是其他集群退役的服务器都需要重装系统,重装系统的镜像是针对大数据定制的,镜像包含了大数据运维工程师的通用需求以及安装操作系统后的网络、磁盘以及其他设置,比如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用 YUM 源、禁用 SELinux 等模式化操作,大数据运维工程师收到服务器后准备工作基本准备完毕了,进行少量准备工作就可以直接进入了 CM 可视化批量安装模式,比如脚本批量设置hostname、脚本同步/etc/hosts 文件等;当然如上所说的 IAAS 操作,如关闭防火墙、时钟同步、同构磁盘挂载、关闭大透明页、关闭 SWAP、公用YUM 源、禁用 SELinux 都可以脚本化,无非就是使用 SSH 通讯方式设置,这就需要大数据运维同学熟练使用 shell 了。
Q
已知一个 HDFS 的目录,想知道此目录下的文件数,而且存储于哪些DataNode 节点上。
A:1.查看文件数使用 count 命令,如下查看/ops 目录,目录数为 9606,文件数为 1353 万+,总文件大小为 9.7P
2.查看/ops/test 目录下的文件存储的位置hdfs fsck /ops/test -files -blocks -locations -racks
Q
DataNode 单节点,存储容量大小与当前节点上的 CPU,内存硬件之间有什么样的关系,磁盘扩容很容易,但这不意味着单节点上数据盘就可以无限地扩容,因此在这方面,有什么实际线上的经验分享,即这三者间可以遵循怎样合适的关系
A:从我们内部实践来说没有发现三者之间的规律,因为大数据业务每个公司都不一样,有的计算是 CPU 密集型的,有的计算是内存密集型的、有的计算是IO 密集型的;我们的服务器都是中高配置,每个服务器的磁盘是 4Tx10、 CPU24core、 128G 内存
Q
老师线上 6000+规模集群,抛开一些其它组件集群,仅讨论 HDFS 数据存储集群,保守理应也在有 3000 节点左右,想知道这些存储节点只是单集群NameNode 集群来维护吗?还是多集群独立维护的,如果是多集群存储数据,它们之间数据是如何打通进行关联的?如果仅是一个集群的话,我想知道这个集群的 NameNode 上的配置,是如何 Hold住这些数据 DataNode的?
A:我们的集群也是用的 Cloudera 公司的,我们付了费用, Cloudera 没有保障说 CM 能够纳管 1000 节点以上的集群,再加上我们的机房有容量限制,所以我们是建了多套集群,最大集群有 800+节点,最小集群也有 300+节点;800+datanode 下, namenode 是可以支撑的,像一些互联网大厂,字节跳动、京东等他们的单集群规模有上万节点,此时就需要对 hdfs 进行深度定制了,他们改了很多源码,而且有 200+高级技术维护人员;4多集群建设要考虑业务情况,比如我们公司有 10 个以上业务, 5 大核心集群,按业务相关情况划分集群,不过也难免有跨集群的作业,目前公司内部自研发了大数据采集交换平台,你也可以使用 distcp 进行数据对拷,目前我们也正在准备自研发多集群并行混算平台。
Q
HDFS 存储节点上的数据,存储压缩格式是如何选取的,默认采用哪种文件存储类型与存储格式,冷热数据如何界定的?
A:我们产线环境用了 gz 和 snappy 压缩格式, gz 用于不常用的冷数据,snappy 用于热数据;冷热数据是跟业务相关的,后续集群治理的课程中也有冷热数据的区分。
Q
课堂上看到 HDFS 集群的 DataNode 与 HBASE 是集成在一起部署的,我好奇, HBase 面向的都是高频率读写的业务,老师确定部署一起后,线上业务没有出现过问题吗?
A:你应该是理解错了, HBase 不能跟 YARN 在一起部署;HBase 需要跟HDFS 部署在一起的,这样可以利用数据本地性提升 IO 性能,并且可以降低网络延迟,降低带宽负载。
Q
Yarn 集群计算层,目前集群面向用户使用群体少,故白天仅是数据写入,集群 CPU 资源都较为存在大量冗余状态,但对于凌晨执行集中高频提交跑批作业计算任务时,集群的 CPU 资源明显不够,甚至引起节点 CPU 负载过高导致节点的宕机,从而造成集群雪崩。简单来说,白天集群资源使用率在5%,凌晨执行高频跑批作业任务时,资源使用率上到 100%,引起集群宕机。在不增加资源的前提下,资源老师会如何划分队列?
A:这个划分队列无法解决根本问题,建议将业务划分优先级,错开时间执行。
Q
某一台 CDH 物理机 12 块 RAID0 硬盘,如果其中有 4 块 RAID0 硬盘同时损坏,请问接下来大数据运维人员的详细处理流程是什么?
A:HDFS 有个参数
dfs.datanode.failed.volumes.tolerated,值为 0 的时候表示当有任何盘损坏后 datanode 则停止服务,如果 4 快盘同时损坏了,此时datanode 进程已经停止了,你可以修改 hdfs-site.xml 配置文件将损坏的磁盘路径去掉,重启 datanode 即可,然后进入磁盘报修流程,待磁盘更换后,停止 datanode,在 hdfs-site.xml 配置文件中假如新的磁盘,启动 datanode 即可。
第一个方案:修改磁盘后,节点退役,重新服役
第二个方案:同一个节点磁盘间按空闲比率写数据,空闲比率高的有先写
Q
CDH 如果为开发人员提供 HIVESERVER2 服务,可以让开发人员通过beeline 命令访问?
A:是的,beeline 使用 JDBC 协议来连接 HIVESERVER2
Q
在晚高峰期 HDFS 集群会出现某些 datanode 不稳定的情况,频繁有datanode 脱离节点,该如何处理呢?
A:需要找到 datanode 的具体原因, datanode 相对来说还是比较稳定的,需要看下是否是 GC 问题,如果是的话适当调大内存,再看下最大的打开文件数或进程数的限制是否太小
1)查看jvm是否有频繁full gc,如果有调大jvm内存
2)查看datanode是否在做df -sk来统计存储大小,如果管理的block太多的话可能卡死;如果是说集群中小文件过多,需要解决小文件的问题,参考集群治理中的HDFS画像
3)查看此节点上是否运行了过多的作业导致节点负载很高,如果是1>如果整个集群资源是否负载过高,如果能扩容则扩容 2> 优化占资源高的作业,这样会整体降低资源负载,参考集群治理中的作业画像 3> 整个集群资源是否负载不是很高,nodemanage虚拟核数于集群的CPU核数比率调低
4)建议不重要的作业错峰运行
Q
CDH 集群扩容 10 台机器后,新加入的 Datanode 角色数据相对较少,如何处理 HDFS 的数据分布不均衡的现象呢?
A:在内存占用较低的节点上启动 balancer 脚本,将 HDFS 中所有节点的存储值中的最低值和平均值的差值设置为 5%。命令:./start-balancer.sh -threshold 5
Q
CDH 监控项从某种角度来说并不是很细粒度,老师课上可能时间有限等原因只是稍微提了一下监控思路,请问您线上是如何监控的呢,能将详细步骤给我们刨析一下吗?
A:目前我们产线环境还是以 CDH 监控为主, CDH 的指标还是挺多的,只不过保留的周期不长,对于排障来说基本够用了,当然我们会推进一些监控工具,不过在课堂不会展开细讲,后续有 Flink 监控方面的实战。
Q
如何基于 CDH 集群监控大量的小文件的呢?衡量小文件标准,以及出现大量小文件在生产环境该如何解决呢?
A:CM 解决不了大量小文件的监控,需要额外做其他工作,这块在集群治理的HDFS画像里面我们会详细讲;对于怎么衡量小文件的标准,你可以简单认为小于 blocksize 的文件就是小文件,但是在企业真实情况下小文件问题可能更加严重,比如大量 10M、几十 M 以下的文件,单纯技术无法解决问题,需要组织协同,这个在集群治理里面我们会详细讲。
Q
之前上课只是大致提了一下 YARN 资源调度,生产环境使用 CDH 如何配置 YARN 资源队列调度,在咱们后续的课程还会讲吗?
A:这个会讲解的,也会讲解我们产线环境是如何划分队列的。
Q
CDH 如何对 HDFS 各级目录做权限管理,目录的配额(即使用 HDFS 的容量限制)限制呢?
A:HDFS 可通过 ACL 精细控制目标权限,除了 ACL 后续我们也会讲sentry;目前我们产线环境没有做容量配额限制,怕影响生产,我们通过集群治理来解决容量问题,集群治理是我们的课程内容之一,后续会讲解
Q
Hdfs,Yarn,MapReduce,Hive,
Spark,Storm,Kafka,Flink
这些组件您在生产环境的调优参数是如何配置的,后续会为我们分享一些调优参数及说明么?我们也方便对照自己的集群作为参考适当调整。
A:HDFS 可通过 ACL 精细控制目标权限,除了 ACL 后续我们也会讲sentry;目前我们产线环境没有做容量配额限制,怕影响生产,我们通过集群治理来解决容量问题,集群治理是我们的课程内容之一,后续会讲解
Q
后期的大数据组件监控项目是针对课上所有的组件进行监控的么?还是只是分享监控思路,代码能给我们学院吗?
A:大数据组件监控主要在 CM 上进行监控,后续有集群治理案例实战,实战代码可以给学员的。
Q
生产环境中重启 HDFS 集群时时间过程,每次重启都导致 40 分钟左右才能启动成功,需要调优什么参数让 NameNode 快一点变为 Active 呢?为什么调优这些参数后会导致 NameNode 启动加快呢?
A:HDFS重启流程:加载fsimage文件-》加载editlog日志-》根据情况判断是否做checkpoint-》等待block汇报
1、如果fsimage太大也会延长加载时间,导致启动过慢,如果果太大说小文件太多,需要治理小文件
2、checkpont周期太长的话会导致启动的时候重放太多editlog日志,建议checkpoint周期缩短
3、block汇报,这个一般时间较长
1) block过大导致,说明小文件过多,需要进行小文件治理
2) 降低 BlockReport 时数据规模;NameNode 处理 BR 的效率低主要原因还是每次 BR 所带的 Block 规模过大造成,所以可以通过调整 Block 数量阈值,将一次 BlockReport 分成多盘分别汇报,提高 NameNode 处理效率。可参考的参数为:dfs.blockreport.split.threshold,默认为 1,000,000,当前集群DataNode 上 Block 规模数处于 240,000 ~ 940,000,建议调整为 500,000;
3) 当需要对全集群的 DataNode 重启操作,且规模较大(包括集群规模和数据规模)时,建议在重启 DataNode 进程之后将 NameNode 重启,避免前面的“雪崩”问题;
4) 控制重启 DataNode 的数量;按照当前节点数据规模,如果大规模重启DataNode,可采取滚动方式,以每次 15 个实例, 单位间隔 1min 滚动重启,如果数据规模增长,需要适当调整实例个数;
Q
生产环境中我们有必要利用 CM 的"图表生成器"来自定义图标形成仪表盘吗?如果有必要,官方提供的度量值太多了,您在是生产环境中都定义了哪些监控图标呢?
A:这个我们会在正式课中 CM 监控章节进行讲解,主要是主机以及各个组件的核心指标,当出现问题之后再去查看其他指标即可。
Q
在录播视频中安装 Spark,Hive 选择依赖是 HDFS,那什么情况下Spark,Hive 需要依赖 HBase 呢?如果 Spark 和 Hive 依赖关系开始选择的是只依赖于 HDFS,后期想要改成依赖 HBase 该如何操作呢?老师您能用大白话给我们解释一下这个依赖关系是干嘛的吗?
A:依赖就是想要使用 Spark 和 Hive 分析读取谁的数据,依赖 HDFS 就是使用使用 Spark 和 Hive 读取 HDFS 数据进行分析,依赖 HBase 就是使用使用 Spark和 Hive 读取 HBase 数据进行分析。在实际的产线环境中很少使用 Spark 和 Hive 依赖 HBase,大多时候都是依赖 HDFS,即读取 HDFS 的数据进行分析。一般来说Spark 程序读写HBASE的时候,程序中会写zk地址,通过zk的地址找到hbase, 然后进行读写操作。
Hive读写hbase需要在建hive表的是在hive配置文件中增加zk信息写上hbase的连接信息;所以Spark 和 Hive来读写hbase数据的时候不要CDH选择以来。
Q
为什么安装 HDFS HA 模式需要自定义一个 nameservice 的名称呢?为什么 apache Hadoop 不直接以 VIP 地址来解析呢,而是要在 hdfs-site.xml配置中对 nameservice 通过名称解析成相应的地址,如果采用 VIP(比如keepalived)技术不是也可以实现主备切换么,那官方使用 nameservice 的优点在哪呢?
A:因为高可用集群中有两个 NameNode,一个是 Active NameNode,一个是 Standby NameNode,二者可能会发生主从切换,只有 Active NameNode可对外提供服务,所以我们无法确定到底访问哪一个 NameNode,所以需要一个 nameservice 供我们访问,当我们已 nameservice 访问 NameNode 时,客户端会自动判断哪个是 Active NameNode,减轻了用户的成本。VIP 应用运维是高可用方案,对 NameNode 还是太简单了, DataNode 要同时跟两个 NameNode 建立连接,上报数据才能快速切换,而且 NameNode主从切换的时候需要校验很多状态,比如 EditLog 是否同步等,使用 VIP 的话无法判断这些。
Q
HDFS 的上传和下载都是实际上都是 client 自己完成的,在课堂上老师您说删除并不是 client 自己完成的, client 将需要删除的元数据信息发送给NameNode,而后通过 NameNode 和 DataNode 心跳机制实现,前面的增删查的原理您都说了,那修改 HDFS 文件内容时的原理能帮我们分析一些吗?或者带我们查看一下源码可以吗?
A:前面的课程中老师分享过一下源码,同学们觉得太难,后来老师就没有分享,本来源码分享不在我们的课程范围内,老师也不是平白无故阅读源码,需要的时候才看,比如修改 HDFS 文件内容老师就没看过。
Q
MapReduce 严格意义上没有组件名称,我理解它只是一个计算思想,那我们可以在 YARN 中看到 MapReduce 的计算过程的身影吗?具体在哪里看呢?
A:可以在 YARN 的 WEB UI 中查看运行过程以及运行指标,点进第一列可以查看。
Q
现在随着云原生技术越来越普及,以 CNCF 组织为首的开源产品Kubernetes 越发火爆,我们后期课程是否会讲解在 Kubernetes 集群中运行大数据组件呢?可以为我们提前爆料一些内容吗?
A:目前这款有打算讲解 Flink On Kubernetes 的程序,可能会放到最后
Q
生产环境调优 HDFS 集群参数后 CDH 该如何进行平滑重启呢?
A:请参考 Q18。
Q
如果发现现有集群出现数据倾斜,生产环境中 HBase 出现数据倾斜了该如何解决呢?出现数据倾斜的原因到底是什么,换句话说,导致数据倾斜的罪魁祸首到底时开发,运维还是软件自身缺陷呢?
A:导致数据倾斜的原因是因为 rowkey 设计的不合理,跟 HBase 本身关系不大,开发人员涉及的rowkey不合理,导致大量的rowkey写到了少量的regionserver中。如果正确的涉及rowkey需要根据业务情况而定,原则尽量让rowkey打散到regionserver中
Q
生产环境 RowKey 改如何设计才合理呢,合理的设计 RowKey 后就一定能避免数据倾斜吗?
A:这个我们在 HBase 组件运维的时候会讲解。
Q
目前 Hadoop 官方都发布了哪些版本呢?如何区分 Hadoop 所有的发行版本中哪个是稳定版,哪个是测试版,哪个是长期支持版本呢?
A:可以查看官方文档的 Latest news,里面有具体说明,见如下方框中的 stable就是稳定的意思,至于是不是长期支持版本需要看版本的特性,这个可能需要联系官方。
Q
DataXceiver 这个类的和 DataNode 有什么关系呢?网上查阅了相关资料,都说它和文件操作超租期有什么关系,但描述的都模棱两可,老师您能用大白话帮我们解答一下吗?
A:首 先 需 要 知 道 DataXceiverServer 是 什 么 , DataXceiverServer 是DataNode 上一个用于接收数据读写请求的后台工作线程,为每个数据读写请求创建一个单独的线程去处理,这里所说的线程就是 DataXceiver。从源码上看DataXceiver 实现了 Runnable 接口,说明它是一个线程,他包含DataXceiverServer通过查看 DataXceiver 的 run 方法,发现调用的就是 DataXceiverServer 的处理 逻 辑 , 即 接 收 数 据 读 写 请 求 的 后 台 工 作 线 程 就 是 DataXceiver ,DataXceiverServer 封装了处理逻辑。
Q
老师, CDH6 我们已经按照视频搭建完成了,一个 HDFS,HBase 集群能成当多大的压力如何测试呢?
A:HBase 有自带的压力测试工具 PerformanceEvaluation,具体可以查看网上的资料。
Q
HDFS2.X 和 HDFS3.X 的区别有哪些呢?我查看了很多博客写的都是"HDFS3.x 支持纠删码"之类的,但在 Apache Hadoop 的 changelog 中并没有发现该类字样,这样应该在哪里看呢?
A:在官方文档可以看到。
Q
最近大数据运维 JD 上写着"负责公司大数据平台和机器学习平台的运维工作",这两个平台是否就是咱们的 CDH 集群呢?能介绍一下啊机器学习平台的日常运维都有哪些吗?
A:按老师的理解都是 hadoop 平台的运维,不过还要具体看企业自身的情况。
Q
请问一下,可以限制一个队列中 container 的数量吗?
A:假如队列中有 1000 核 CPU, 那么该队列最多可以同时运行 1000 个container,可以通过这个简单的转换进行限制。
Q
老师您遇到 YARN 资源还剩很多(还剩下 50%左右),但是 MapReduce任务就是卡着不动的场景吗?我把 job 并发度降低就好了。但原因在哪我依旧不知道...
A:这个要具体详细查看原因了,卡着不动不代表是整个集群资源的问题,可能是任务本身的数据倾斜,也可能是 GC 问题,也可能是任务所在的服务器负载过高,也可能是所在队列的资源问题。
YARN作业慢问题排查思路:
1.首先看作业所处的资源队列有没有资源
2.查看作业的哪些task运行慢:如果说某个task运行慢
1)是否是数据倾斜,如果有就是数据倾斜引起的,此时如果是hive sql,需求调整sql语句,避免数据倾斜
2)查看task所在集群的系统负载是否很高,如果是则进去这台主机查看高的原因,原因可能是此机器上运行了大量的task导致系统资源负载过高,还有就是某个task的jvm频繁进行垃圾回收导致系统负载过高
3.硬件问题
4.查看最近集群有没有变更(如:我们生产上遇到一个问题,大面积作业运行缓慢,因为最近扩容了50台集群,但是其他集群某些机器的host文件里面配置的这50台集群的host有问题)
5.查看RPC请求是否过慢
Q
CDH 是开源的产品,但是 CM 是付费的呀,我们在生产环境中使用 CM 没有向 cloudera 公司交钱是否会收到律师函呢?但是不用 CM 我们又不知道如何管理(搭建,扩容,监控等)CDH 集群了,如果公司不愿意交钱的话我们大数据运维该如何处理呢?
A:以后都没有免费的了,不原因交钱的话可以使用开源社区版,节点不多的话可以人肉运维,自搭建监控平台,节点多的话自己可以写脚本或借助自助化工具运维,比如 ansible 等。
Q
老师,数据仓库到底是个什么东东呢?能给我们举个例子说明数仓的角色定位及功能吗?还有就是数据仓库是大数据运维工程师搭建还是大数据开发它们自建搭建呢?
A:数据仓库主要是大数据开发搭建的,数据仓库主要是根据采集的数据进行清洗、加工、汇总生成多维度的报表数据,给高层领导看到,运维人员不参与数据清洗、加工等工作,只负责hadoop平台搭建和运维;数据仓库是基于hadoop之上建立的。
Q
之前回复得知,线上集群规模是以集群为粒度划分业务线,跨集群间数据也是需要交互,这种业务是如何根据集群来划分?还是说,它们之前数据的交互实时性不高?跨了集群的数据具体是如何能打通的?DistCp跨集群间的数据迁移也觉得它慢。根本无法满足要求。它可配置的参数也配置了。
A:实时性要求不好,我们机房有万兆带宽的专线,跨集群同步数据不会同步全量数据,在源端集群会先经过数据过滤,只传输需要并进行清洗过滤后的数据。
Q
HDFS SHELL命令方式去监控HDFS文件信息这些,如前边就提问的查询文件数,Block块等,对于专业人士偶尔查询,还行,但对于一个外行的人,连如何登录服务器都不知道,但他就是想知道集群的使用情况,老师是如何将这种资讯汇报他们的,或者是收集方案?
A:我们将收集的数据写入ES,可以使用kibana制作报表。
Q
DataNode节点间数据均衡这
个场景,大规模集群下必定会
存在低配置节点,如:CPU/
内存/数据盘,这里就仅聊数
据盘这个,如:A节点100G,
B节点500G,这种情况下,
是怎样均衡节点数据的?5%
值吗?这里怎么均衡都是无法
达到预期的均衡值呀,是直接
将A节点下线吗?又比如说同
一节点C,挂载了3块数据盘,
分别为, /mnt/a/10G,/mnt/
b/100G,/mnt/c/500G,这种
DataNode节点的均衡数据又
应该如何解决的,1000+规模
的HDFS应该也不会是3.x版本
吧?对于不支持DiskBanancer
的2.X版本,解决方案有吗?
A:首先异构磁盘确实会带来问题,没有绝对的均衡,节点间存储比率不超过5%算是均衡了;HDFS在写入时有两种选择卷(磁盘)的策略,一是基于轮询的策略(RoundRobinVolumeChoosingPolicy),二是基于可用空间的策略
(AvailableSpaceVolumeChoosingPolicy)
将这个配置
dfs.datanode.fsdataset.volume.choosing.policy为
org.apache.hadoop.hdfs.server.datanode.fsdataset.AvailableSpaceVolumeChoosingPolicy
Q
NodeManager节点会将当前节点的DataNode实时上报给RescourceManager,但您之前说HDFS集群的唯一访问入口是NameNode,那是否每台NodeManager在收集本地的DataNode数据时都得访问NameNode获取呢?如果是的话也太浪费HDFS性能了吧,如果不是那是NodeManager是采用什么机制实现不经过NameNode就能获取一个DataNode的数据呢?
A:“NodeManager节点会将当前节点的DataNode实时上报给RescourceManager”,这个说法是不对的,应该是DataNode上报自己的block给NameNode,RescourceManager和NodeManager管的是资源而不是数据。当作业要读取hdfs数据的时候仅仅从NameNode上获取数据的位置,而不会获取数据本身,得到数据的位置后作业再去找DataNode获取数据本身
Q
为什么重启YARN服务后,我们在RescourceManager的WebUI上就看不到之前的历史YARN日志了呢?难道这个日志是保存到内存中的吗?有什么办法重启YARN服务后,依旧可以看到重启YARN服务之前的日志呢?
A:日志不是保存本地磁盘或者HDFS上的,你可以截图来展示你的问题。
Q
ElasticSearch和HDFS都是分布式文件系统,也都可以做数据存储和检索功能,也都是JAVA开源产品,为什么在大数据领域中HDFS比ES更火呢?
A:这两个组件没有可比性,应对的场景不一样,HDFS应用于海量数据存储,ES应用于全文搜索,在电商和搜索引擎用的多
Q
开发人员在hive中创建的元数据表信息该如何实时监控呢?
A:可以使用阿里开源的Canal来实时读取Hive的元数据库mysql的binlog数据,达到实时监控表的变更操作。
推荐:使用Flink CDC来实时获取Hive的元数据库mysql的变化。
Q
HDFS的数据被删除没法直接被监控,企业中该如何避免开发人员误删除数据免得咱们运维背锅呢?
A:打开审计日志,并使用filebeat采集然后写入ES中,可以实时查询所有数据的操作。
Q
大数据安全,权限管理,审计是否有一套完整的解决方案呢?
A:目前老师所知,没有一套完整方案,可能商业化产品有,大数据安全可以大概有边界网关的安全,比如云桌面、VPN等,其次是大数据组件自己的安全。
Q
HDFS 跨集群的数据迁移,针对以下不同场景,都是仅考虑带宽问题吗?如何在跨集群迁移这个是体现出高效率办公呢?这个数据量级暂定在 200T 吧,定太大那不现实,定太小,使用 U 盘就能拷贝了,也没有参考的意义。
2.1:同一运营商,不同机房迁移,如:阿里云北京机房迁移阿里云上海机房
2.2:不同运营商,如阿里云迁移腾讯云
2.3:本地物理机上云
A:老师也无法回答你这个问题,带宽层面只能说建设网络专线。
Q
前面我的问题是想了解,冷热数据文件类型与存储压缩,是两个点,老师仅回复了压缩。压缩层,这个细想,它就仅与 CPU 挂钩,没有过多好探讨的,目前 我 好 奇 的 是 对 于 1000 规 模 的 集 群 文 件 存 储 类 型 的 选 择 。ORC,TEXT,Parquert 等这些,都是基于哪方面设计层的。
A:我们采集的数据格式是 snappy, 可以认为是 ODS 层;沉淀数据用的 gz;
parquet不是不适合数仓,而是对数仓的特定分层来说优势没有体现出来,parquet是当只关注表中的极少的字段的时候优势很明显,在数仓中的ODS、DWD层都是要关注表的几乎所有字段的,这个时候parquet的优势不明显,在DM层和OLAP优势还是比较明显的
Q
集群出现故障如何实现自动修复呢?比如一个 DataNode 在凌晨 2 点半突然挂了 4 个节点,那时候咱们运维人员已经进入深度睡眠状态,如何让其自动将该节点进程自动拉起呢(此处我们假设进程存放则被成功启动)?
A:我们采集了 CDH 的严重事件,更加严重事件盘点是否有 datanode 挂掉了,如果有则调研 CDH API 启动 datanode。此外我们每天都有人轮流值班的。
Q
缺少大一统的开源监控解决方案,各公司都得自行研发相关的大数据监控平台吗?
A:一般是开源加二次开发,很难有完美的方案
Q
datanode上的坏块是如何产生的?
A:当正在写数据时,意外断电,可能会导致数据快损坏或丢失;大于副本数的datanode个数同时停止、宕机时会出现数据快损坏或丢失,如果datanode恢复后警告会消失;
注:所谓坏块就是此block的所有副本都没有了,但是namenode的元数据中还有此block的信息
Q
除了hdfs,像yarn,spark,flink,hbase,kafka(controller)这类集群的高可用原理都是一样的吧
A:hdfs的高可用指的是namenode的高可用,通过zookeeper来选举,通过抢占zk的节点来实现。
Yarn的高可用指的是resourcemanger的高可用,通过zookeeper来选举,通过抢占zk的节点来实现。
hbase高可用指的hmaster的高可用,通过zookeeper来选举,通过抢占zk的节点来实现。
kafka(controller):通过zookeeper来选举,通过抢占zk的节点来实现。
spark,flink:一般运行时在on yarn模式,yarn会提供容错机制
Q
作业出现数据倾斜是运维解决,还是开发解决
A:一定是开发人员解决
35岁+运维人员的发展与出路
经常有人问我:干网工、干运维多年遇瓶颈,想学点新技术给自己涨涨“身价”,应该怎么选择?
聪明人早已经用脚投票:近年来,越来越多运维的朋友寻找新的职业发展机会,将目光聚焦到了网络安全产业。
1、为什么我建议你学习网络安全?
有一种技术人才:华为阿里平安等大厂抢着要,甚至高薪难求——白帽黑客。白帽黑客,就是网络安全卫士,他们“低调”行事,同时“身价”不菲。
根据腾讯安全发布的《互联网安全报告》,目前中国**网络安全岗位缺口已达70万,缺口高达95%。**而与网络安全人才需求量逐年递增局面相反的是,每年高校安全专业培养人才仅有3万余人,很多企业却一“将”难求,网络安全人才供应严重匮乏。
这种供求不平衡直接反映在安全工程师的薪资上,简单来说就是:竞争压力小,薪资还很高。
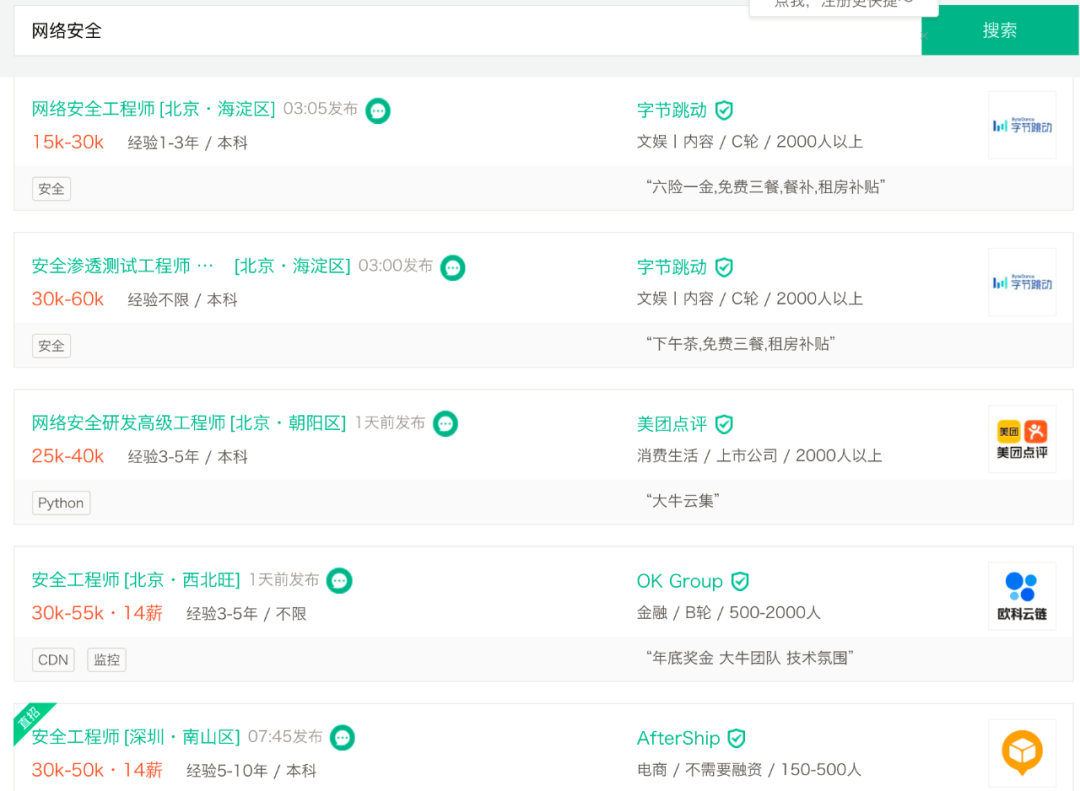
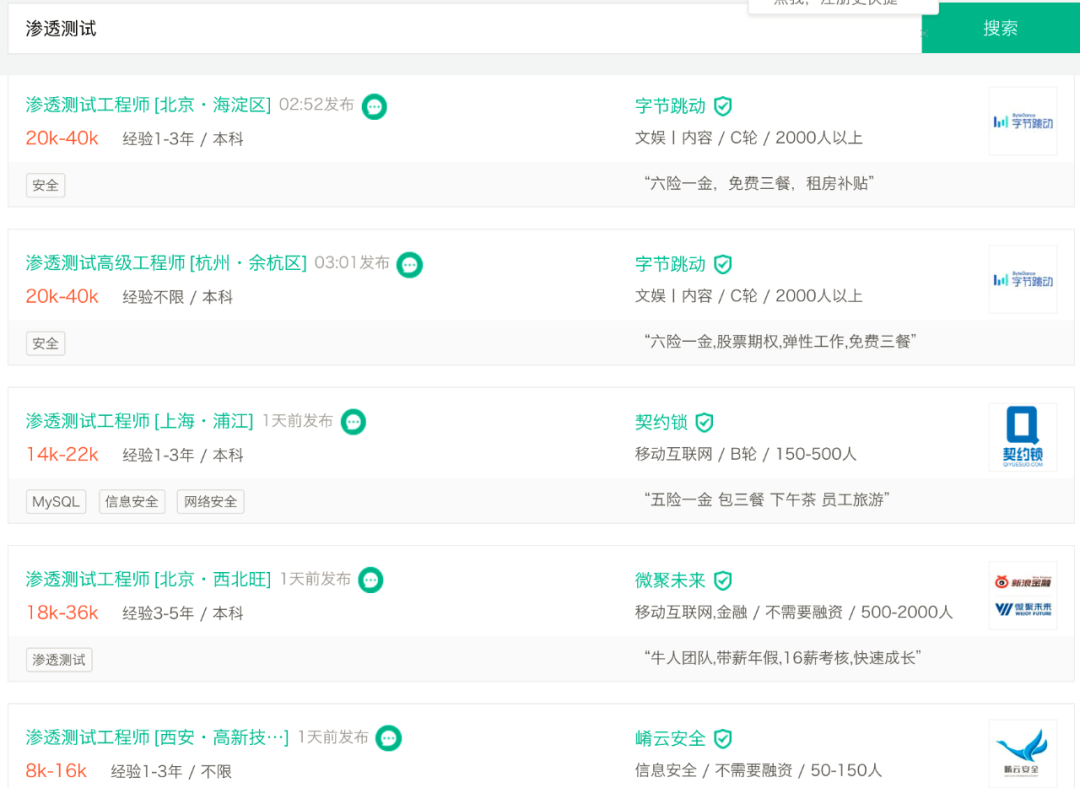
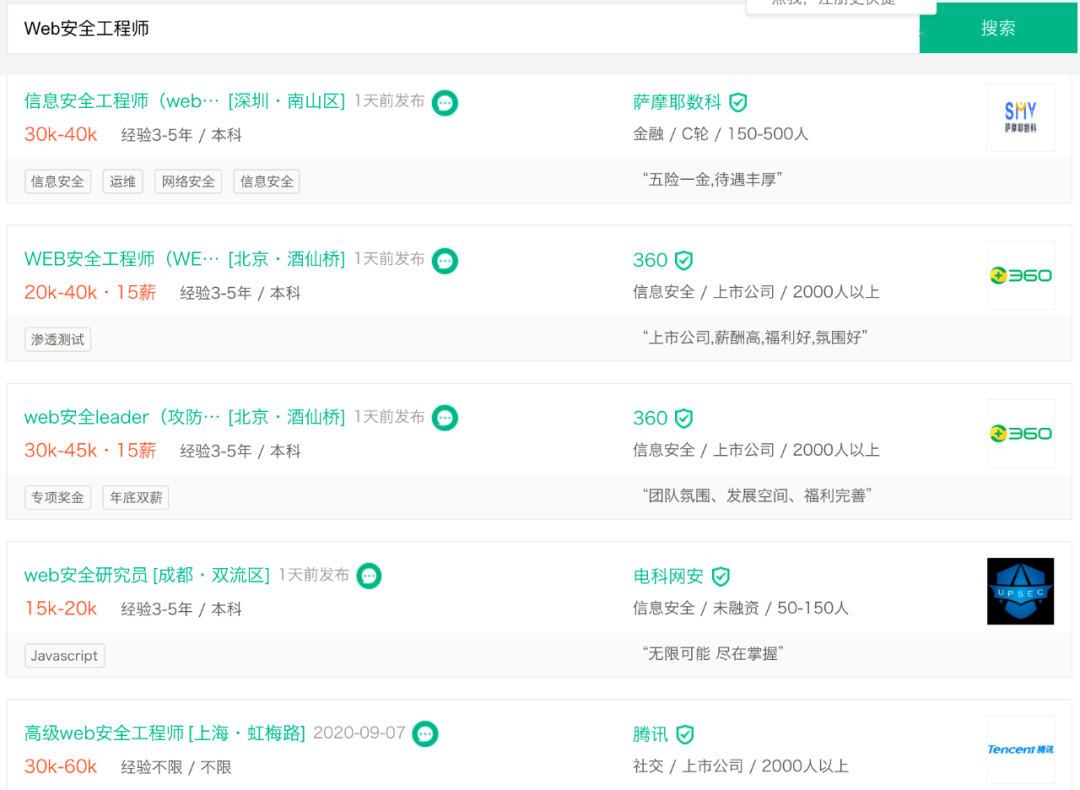
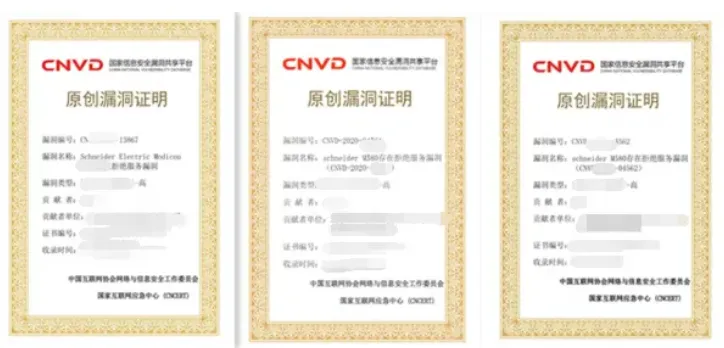
而且安全行业就业非常灵活,既可以就职一家公司从事信息安全维护和研究,也可以当作兼职或成为自由职业者,给SRC平台提交漏洞获取奖金等等。
随着国家和政府的强监管需求,一线城市安全行业近年来已经发展的相当成熟工作机会非常多,二三线城市安全也在逐步得到重视未来将有巨大缺口。
作为运维人员,这几年对于安全的技能要求也将不断提高,现阶段做好未来2到3年的技术储备,有非常大的必要性
2、运维转型成为网络安全工程师,是不是很容易?
运维转安全,因为本身有很好的Linux基础,相对于其他人来说,确实有一定的优势,入门会快一些。
系统管理经验
运维对服务器、网络架构的深度理解,可直接迁移到安全防护场景。例如,熟悉Linux/Windows系统漏洞修补、权限管控,能快速上手安全加固工作。
网络协议与架构知识
运维日常接触TCP/IP、路由协议等,有助于分析网络攻击路径(如DDoS防御、流量异常检测)。
自动化与脚本能力
运维常用的Shell/Python脚本技能,可无缝衔接安全工具开发(如自动化渗透脚本、日志分析工具)。
平滑过渡方向
从安全运维切入,逐步学习渗透测试、漏洞挖掘等技能,利用现有运维经验快速上手。
学习资源丰富
可复用运维工具(如ELK日志分析、Ansible自动化)与安全工具(如Nessus、Metasploit)结合学习,降低转型成本。
3. 转型可以挖漏洞搞副业获取收益挖SRC漏洞
-
合法挖洞:在合法的平台上挖掘安全漏洞,提交后可获得奖励。这种方式不仅能够锻炼你的技能,还能为你带来额外的收入。
-
平台推荐:
补天:国内领先的网络安全漏洞响应平台。
漏洞盒子:提供丰富的漏洞挖掘任务。
CNVD:国家信息安全漏洞共享平台。
关于我
有不少阅读过我文章的伙伴都知道,笔者曾就职于某大厂安全联合实验室。从事网络安全行业已经好几年,积累了丰富的技能和渗透经验。
在这段时间里,我参与了多个实际项目的规划和实施,成功防范了各种网络攻击和漏洞利用,提高了互联网安全防护水平。
为了帮助大家更好的学习网络安全,我给大家准备了一份网络安全入门/进阶学习资料,里面的内容都是适合零基础小白的笔记和资料,不懂编程也能听懂、看懂这些资料!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

黑客/网络安全学习包


资料目录
-
成长路线图&学习规划
-
配套视频教程
-
SRC&黑客文籍
-
护网行动资料
-
黑客必读书单
-
面试题合集
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
1.成长路线图&学习规划
要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。
对于从来没有接触过网络安全的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2.视频教程
很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,其中一共有21个章节,每个章节都是当前板块的精华浓缩。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
3.SRC&黑客文籍
大家最喜欢也是最关心的SRC技术文籍&黑客技术也有收录
SRC技术文籍:

黑客资料由于是敏感资源,这里不能直接展示哦!
4.护网行动资料
其中关于HW护网行动,也准备了对应的资料,这些内容可相当于比赛的金手指!
5.黑客必读书单
**

**
6.面试题合集
当你自学到这里,你就要开始思考找工作的事情了,而工作绕不开的就是真题和面试题。

更多内容为防止和谐,可以扫描获取~

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取



 3085


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


