Python爬虫层层递进,从爬取一章小说到爬取全站小说!

最新Python爬虫层层递进,从爬取一章小说到爬取全站小说 需要爬取很多章小说,最笨的方法是直接使用 for 循环。需要爬取所有的章节,只要获取每一章的网址就行了。requests库的使用(请求网页数据)“”" 数据清除 清除空白字符串 “”"“”“从网页源代码里面拿到信息”“”css选择器的使用(解析网页数据)对请求网页数据步骤进行封装。“”“获取网页源代码”“”“”“爬取一章小说”“”操作文件(数据持久化) 阅读详情

很多好看的小说只能看不能下载,教你怎么爬取一个网站的所有小说

知识点:

  1. requests
  2. xpath
  3. 全站小说爬取思路

开发环境:

  1. 版 本:anaconda5.2.0(python3.6.5)
  2. 编辑器:pycharm

第三方库:

  1. requests
  2. parsel

进行网页分析

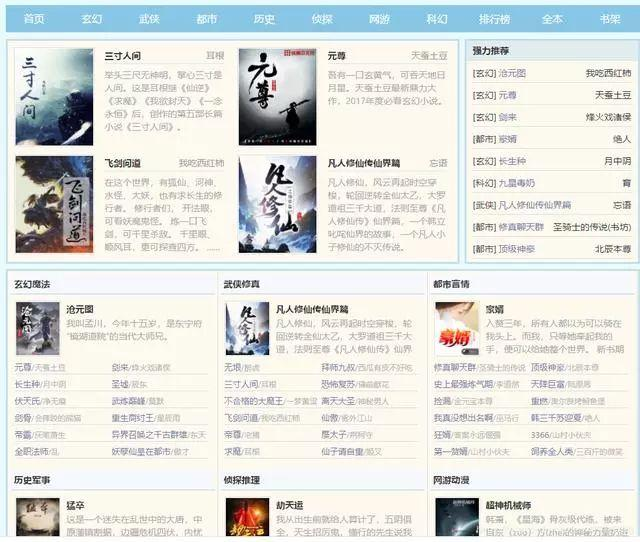
目标站点:


私信博主01 领取完整代码!


  • 开发者工具的使用networkelement


爬取一章小说

  • requests库的使用(请求网页数据)
  • 对请求网页数据步骤进行封装
  • css选择器的使用(解析网页数据)
  • 操作文件(数据持久化)
# -*- coding: utf-8 -*-
import requests
import parsel
"""爬取一章小说"""
# 请求网页数据
headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safa
2021年scrapy一分钟内爬取笔趣阁整本小说存为txt|解决章节排序问题 本人是一个小说迷,喜欢用电纸书看小说,但苦于难以寻找网络小说的txt版本,加之最近学习了一下怎么用scrapy爬取网页数据,所以想到去使用scrapy框架来爬取笔趣阁小说存为txt文件,在爬取过程中对于并发请求的章节排序是一个难点,本代码采用字典来解决这一问题。废话不多说,直接上思路和代码。 首先看一下小说的网页界面,今天爬取的小说是最近比较火的大奉打更人 首先在终端创建一个scrapy项目 scrapy startproject dagengr... 阅读详情

相关推荐

表格数据学习的图神经网络综述

今天学习一篇发表在中科院一区期刊《ACM Computing Surveys》的综述文章《Graph Neural Networks for Tabular Data Learning: A Survey with Taxonomy & Directions》,该刊主要刊载计算机理论方法领域的系统性综述与教程论文,注重跨学科技术融合研究,最新的影响因子为28.0。本文的目的在于通过学习这篇文章,了解关于表格数据学习点图神经网络一些基础知识。

qq_41009600的博客 801

STM32CubeMX定时器进阶玩法:用编码器模式实现电机转速测量(附避坑清单)

本文详细介绍了如何使用STM32CubeMX配置定时器的编码器模式实现电机转速测量,包括硬件连接、CubeMX配置关键步骤、转速计算算法及常见问题解决方案。特别针对工业控制和机器人开发中的高精度需求,提供了实用的避坑清单和优化技巧,帮助开发者高效完成项目。

joy55的博客 204

TBOX(Telematics Box)在智能网联汽车中的核心功能与应用场景解析

TBOX(Telematics Box)是智能网联汽车的“中枢神经”,基于Android或Linux操作系统,并通过CAN总线与车辆深度交互。它实现了远程控制、车辆状态监控、OTA升级及紧急呼叫(E-CALL)等核心功能,是提升用车安全、便利性与实现车辆持续进化的关键技术组件。

weixin_29158413的博客 805

【SCADA】KingSCADA将数据插入SQLServer的方法

1、创建数据库及数据表格;2、配置ODBC数据源。3、通过KingSCADA与数据库建立连接,将数据写入数据库对应表格。

做有价值的事,积累有价值的笔记! 4968

华为OD机考真题 新系统 - 小菊的寻宝之旅(Java/Py/C/C++/Js/Go)

华为OD机试真题 新系统【小菊的寻宝之旅】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【小菊的寻宝之旅】多语言题解。

qq_45776114的博客 631

InvocationException: GraphViz‘s executables not found【BUG已解决】

在机器学习框架中遇到了一个bug:安装了GraphViz模块后,在对着sklearn的决策树文档操作输出决策树模型结果时,还是爆出了如下的错误: 报错位置为: 报错语句为:网上很多答案告诉我们,要我们安装GraphViz模块,然而并不对! 如下,我安装了GraphViz,但是还是报错了。 所以说问题不在这,我查阅质料发现,改正这个bug的方法有一个:下文详细描述。解决bug为: 1.去graphviz.官方下载自己电脑符合的操作系统的安装包:2,安装的时候,记住自己安装在电脑里的位置:以我的电脑为例,我的

一键难忘的博客 3969

2025.06.18【转录组】|Ribo-seq/small RNA数据分析:rRNA和smRNA比对率统计全流程

本文介绍了一种自动化统计rRNA/smRNA比对率的方法,用于评估Ribo-seq或small RNA测序数据的质量。主要内容包括:分析原理(比对率定义、参考序列来源)、实践流程(构建索引、比对统计)以及结果可视化方法。通过Python和R脚本实现自动化处理,可生成汇总表格和柱状图。比对率结果能反映样品污染程度,建议控制在20%以下。该流程有助于快速评估测序质量,为后续分析提供可靠依据。文中还提供了常见问题解决方案和脚本示例,适用于生物信息学标准化质控环节。

1619

R语言中的混淆矩阵(Confusion Matrix)是一种常用的评估多分类模型性能的工具

除了准确率,混淆矩阵还提供了其他有用的指标,如灵敏度(Sensitivity)、特异度(Specificity)、精确度(Precision)和召回率(Recall)。混淆矩阵通过比较模型预测结果与实际标签的一致性,帮助我们了解模型的分类准确性和错误类型。此外,混淆矩阵还提供了各种错误类型的统计信息,如假阳性(False Positive)和假阴性(False Negative)等。通过混淆矩阵,我们可以了解模型的整体性能和错误类型,从而对模型进行评估和改进。最后,为了更好地理解混淆矩阵的结果,可以使用。

HackSquad的博客 972

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: 双十一数据被质疑?教你如何用Python预测未来趋势!
下一篇: 如何优雅滴在手机上跑Python代码!手机市场越来越火热了!
PythonJavaPHP
博客等级 码龄7年 116粉丝 76原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值