


Spark的认识(二)
1、主要内容
-
1、掌握RDD底层原理
-
2、掌握RDD常用的算子操作
-
3、掌握RDD的依赖关系
-
4、掌握RDD的缓存机制
-
5、掌握划分stage
-
6、掌握spark任务调度流程
2、RDD概述
2.1 RDD是什么
RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变、可分区、里面的元素可并行计算的集合。 Dataset:它就是一个集合,集合里面可以存放很多个元素 Distributed:它的数据是分布式存储的,方便于后期进行分布式计算 Resilient:弹性 它表示的含义:rdd的数据是可以保存在内存或者是磁盘中
2.2 RDD的五大属性

(1) A list of partitions 一个分区列表,也就是说一个rdd有很多个分区,分区里面才是真正的数据,而spark任务的执行是以分区为单位,一个分区就对应后期的一个task(线程)。 读取HDFS上数据文件产生的RDD分区数跟block的个数相等, 如果一个文件只有一个block块,它会产生的rdd的分区数是2个(默认最小值就是2) (2) A function for computing each split 作用在每一个分区中的函数 val rdd2=rdd1.map(x=>(x,1)) (3) A list of dependencies on other RDDs 一个rdd会依赖于其他多个rdd,这里就涉及到rdd与rdd之间的依赖关系,后期spark的容错机制就是根据这个特性而来。 (4) Optionally, a Partitioner for key-value RDDs (e.g. to say that the RDD is hash-partitioned) (可选项)对于kv类型的rdd才有分区函数概念(必须要产生shuffle),不是kv类型的RDD它的分区函数是None(就是没有)。分区函数作用:决定了数据会流入到哪里去 spark中有2种分区函数,第一种是基于哈希的hashPartitioner, key.hashcode%分区数=分区号,这个分区函数是默认值。第二种基于范围RangePartitioner (5) Optionally, a list of preferred locations to compute each split on (e.g. block locations for an HDFS file) (可选项)一组最优的块的位置列表 表示数据的本地性和数据位置最优 spark在进行任务分配的时候,它会优先考虑存有数据的节点来计算任务。避免出现大量的网络请求。
3、创建RDD
-
1、通过一个已经存在scala集合去创建
-
sc.parallelize(List(1,2,3,4))
-
-
2、读取外部数据源去创建
-
val rdd1=sc.textFile("/words.txt")
-
-
3、通过一个rdd调用对应的方法生成一个新的rdd
-
val rdd2=rdd1.flatMap(_.split(" "))
-
4、RDD的算子分类
-
1、transformation(转换)
-
可以把一个rdd转换生成一个新的rdd,它是延迟加载,不会立即触发整个任务的运行
-
它会记录下rdd上面的转换操作行为
-
比如
-
flatMap map reduceByKey sortBy
-
-
-
2、action (动作)
-
它会触发任务真正的运行
-
collect saveAsTextFile
-
5、通过spark实现点击流日志分析
5.1 统计PV
package demo
import org.apache.spark.rdd.RDD
import org.apache.spark.{SparkConf, SparkContext}
//TODO:通过spark来实现点击流日志分析案例-----------PV
object PV {
def main(args: Array[String]): Unit = {
//1、创建SparkConf对象
val sparkConf: SparkConf = new SparkConf().setAppName("PV").setMaster("local[2]")
//2、创建SparkContext对象
val sc = new SparkContext(sparkConf)
//设置日志输出级别
sc.setLogLevel("warn")
//3、读取日志数据
val data: RDD[String] = sc.textFile("E:\\data\\access.log")
//4、统计PV
val pv: Long = data.count()
println("PV:"+pv)
sc.stop()
}
}
5.2 统计UV
package demo
import org.apache.spark.rdd.RDD
import org.apache.spark.{SparkConf, SparkContext}
//TODO:通过spark来实现点击流日志分析案例-----------UV
object UV {
def main(args: Array[String]): Unit = {
//1、创建SparkConf
val sparkConf: SparkConf = new SparkConf().setAppName("UV").setMaster("local[2]")
//2、创建SparkContext
val sc = new SparkContext(sparkConf)
sc.setLogLevel("warn")
//3、读取数据文件
val data: RDD[String] = sc.textFile("E:\\data\\access.log")
//4、切分每一行获取ip地址
val ips: RDD[String] = data.map(_.split(" ")(0))
//5、去重统计uv
val uv: Long = ips.distinct().count()
println("UV:"+uv)
sc.stop()
}
}
5.3 统计TopN
package demo
import org.apache.spark.{SparkConf, SparkContext}
import org.apache.spark.rdd.RDD
//TODO:通过spark来实现点击流日志分析案例-----------TopN(获取访问url出现次数最多的前N位)
object TopN {
def main(args: Array[String]): Unit = {
//1、创建SparkConf
val sparkConf: SparkConf = new SparkConf().setAppName("TopN").setMaster("local[2]")
//2、创建SparkContext
val sc = new SparkContext(sparkConf)
sc.setLogLevel("warn")
//3、读取数据文件
val data: RDD[String] = sc.textFile("E:\\data\\access.log")
//4、先过滤出正常的数据,切分每一行,获取url,每一个url计为1
val urlAndOne: RDD[(String, Int)] = data.filter(x=>x.split(" ").length>10).map(x=>(x.split(" ")(10),1))
//5、相同url出现的1累加
val result: RDD[(String, Int)] = urlAndOne.reduceByKey(_+_)
//6、按照次数降序排列
val sortRDD: RDD[(String, Int)] = result.sortBy(_._2,false)
//7、取出出现次数最多的前5位
val top5: Array[(String, Int)] = sortRDD.take(5)
top5.foreach(println)
sc.stop()
}
}
6、通过spark实现ip地址查询
package demo
import java.sql.{Connection, DriverManager, PreparedStatement}
import org.apache.spark.broadcast.Broadcast
import org.apache.spark.rdd.RDD
import org.apache.spark.{SparkConf, SparkContext}
//todo:利用spark实现ip地址查询
object Iplocation {
//ip地址转换成Long 192.168.200.100
def ip2Long(ip: String): Long = {
val ips: Array[String] = ip.split("\\.")
var ipNum:Long=0L
//遍历数组
for(i<- ips){
ipNum= i.toLong | ipNum << 8L
}
ipNum
}
def binarySearch(ipNum: Long, broadCastValue: Array[(String, String, String, String)]): Int = {
//定义开始下标
var start=0
//定义结束下标
var end=broadCastValue.length-1
while(start <= end){
val middle=(start+end)/2
if(ipNum >= broadCastValue(middle)._1.toLong && ipNum <= broadCastValue(middle)._2.toLong){
return middle
}
if(ipNum < broadCastValue(middle)._1.toLong){
end=middle-1
}
if(ipNum >broadCastValue(middle)._2.toLong){
start=middle+1
}
}
-1
}
def data2mysql(iter:Iterator[((String,String), Int)]) = {
//定义数据库连接
var conn:Connection=null
//定义PreparedStatement
var ps:PreparedStatement=null
val sql="insert into iplocation(longitude,latitude,total_count) values(?,?,?)"
conn=DriverManager.getConnection("jdbc:mysql://192.168.200.100:3306/spark","root","123456")
ps=conn.prepareStatement(sql)
//遍历迭代器
try {
iter.foreach(line => {
//给占位符赋值
ps.setString(1, line._1._1)
ps.setString(2, line._1._2)
ps.setLong(3, line._2)
//执行sql语句
ps.execute()
})
} catch {
case e:Exception => println(e)
} finally {
if(ps !=null){
ps.close()
}
if(conn!=null){
conn.close()
}
}
}
def main(args: Array[String]): Unit = {
//1、创建SparkConf
val sparkConf: SparkConf = new SparkConf().setAppName("Iplocation").setMaster("local[2]")
//2、创建SparkContext
val sc = new SparkContext(sparkConf)
sc.setLogLevel("warn")
//3、读取城市ip段信息数据,获取 (ip开始数字、ip结束数字、经度、维度)
val city_ip_rdd: RDD[(String, String, String, String)] = sc.textFile("E:\\data\\ip.txt").map(x=>x.split("\\|")).map(x=>(x(2),x(3),x(x.length-2),x(x.length-1)))
//把城市ip信息数据,通过广播变量下发到每一个worker节点
val city_ip_broadcast: Broadcast[Array[(String, String, String, String)]] = sc.broadcast(city_ip_rdd.collect())
//4、读取日志数据 获取所有的ip地址
val ips_rdd: RDD[String] = sc.textFile("E:\\data\\20090121000132.394251.http.format").map(x=>x.split("\\|")(1))
//5、遍历ips_rdd 获取每一个ip地址,然后转换成Long类型的数字,最后通过二分查找去匹配
val result: RDD[((String, String), Int)] = ips_rdd.mapPartitions(iter => {
//获取广播变量的值
val broadCastValue: Array[(String, String, String, String)] = city_ip_broadcast.value
//遍历迭代器
iter.map(ip => {
//把ip地址转换成Long类型数字
val ipNum: Long = ip2Long(ip)
// 通过二分查询获取long类型的数字在数组中下标
val index: Int = binarySearch(ipNum, broadCastValue)
//获取下标对应的值
val value: (String, String, String, String) = broadCastValue(index)
//把结果数据封装在一个元组中 ((经度,维度),1)
((value._3, value._4), 1)
})
})
//相同经度维度出现的1累加
val finalResult: RDD[((String, String), Int)] = result.reduceByKey(_+_)
//打印
finalResult.foreach(println)
//保存结果数据到mysql表中
finalResult.foreachPartition(data2mysql)
sc.stop()
}
}
7、RDD的依赖关系
-
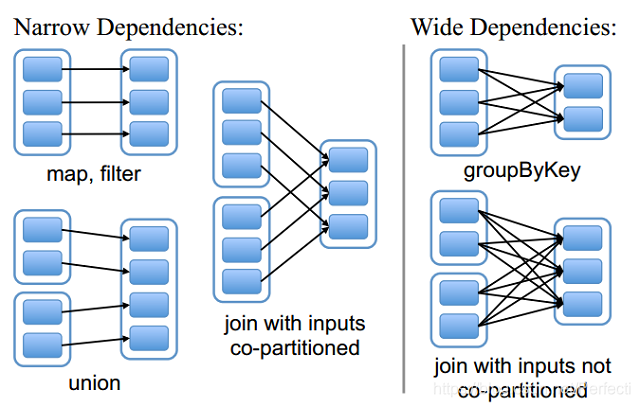
1、窄依赖
窄依赖指的是每一个父RDD的Partition最多被子RDD的一个Partition使用 总结:窄依赖我们形象的比喻为独生子女 比如:flatMap map filter ... 窄依赖不会产生shuffle
-
2、宽依赖
宽依赖指的是多个子RDD的Partition会依赖同一个父RDD的Partition 总结:宽依赖我们形象的比喻为超生 比如:reduceByKey gruopByKey sortBy join 宽依赖会产生shuffle
8、Lineage(血统)
血统:它会记录下在rdd上的一系列操作行为,后期某个rdd的分区数据丢失之后,可以通过血统这层关系重新计算恢复得到。
9、RDD的缓存机制
9.1 什么是rdd的缓存机制
可以把一个rdd的结果数据进行缓存,缓存之后后续有其他的job需要依赖于前面rdd的结果数据,可以直接从缓存中获取得到,避免重新计算。
9.2 如何设置缓存
对rdd设置缓存有2中方式:第一种cache  第二种persist

两者的区别:
cache默认是把数据缓存在内存中,其本质就是调用persist方法,默认的存储级别就是MEMOEY_ONLY
persist中有丰富的缓存级别,可以把数据缓存在磁盘中,这些缓存级别都被定义在StorageLevel object中

这2个方法并不是立即调用就触发缓存操作,后面需要有一个action操作才可以。
9.3 清除缓存
rdd.unpersist方法可以将缓存中的数据移除掉
9.4 什么时候去设置缓存
-
1、一个rdd后期多次使用
val rdd2=rdd1.flatMap(_.split(" ") val rdd3=rdd1.map(_.split(" ")) rdd1使用了很多次,后面就可以对rdd1设置缓存,后面的job就可以直接从缓存中获取得到。避免重新计算 -
2、一个rdd的结果获取得到来之不易
val rdd1=sc.textFile("/words.txt").xxx.xxxx.xxxx.xxxx.xxxx.xxx.xxxx.xxx.....

rdd1经过大量的转换操作或者是计算逻辑比较复杂最后得到不容易,这个时候就可以对rdd1设置缓存
10、DAG有向无环图和划分stage
-
DAG有向无环图
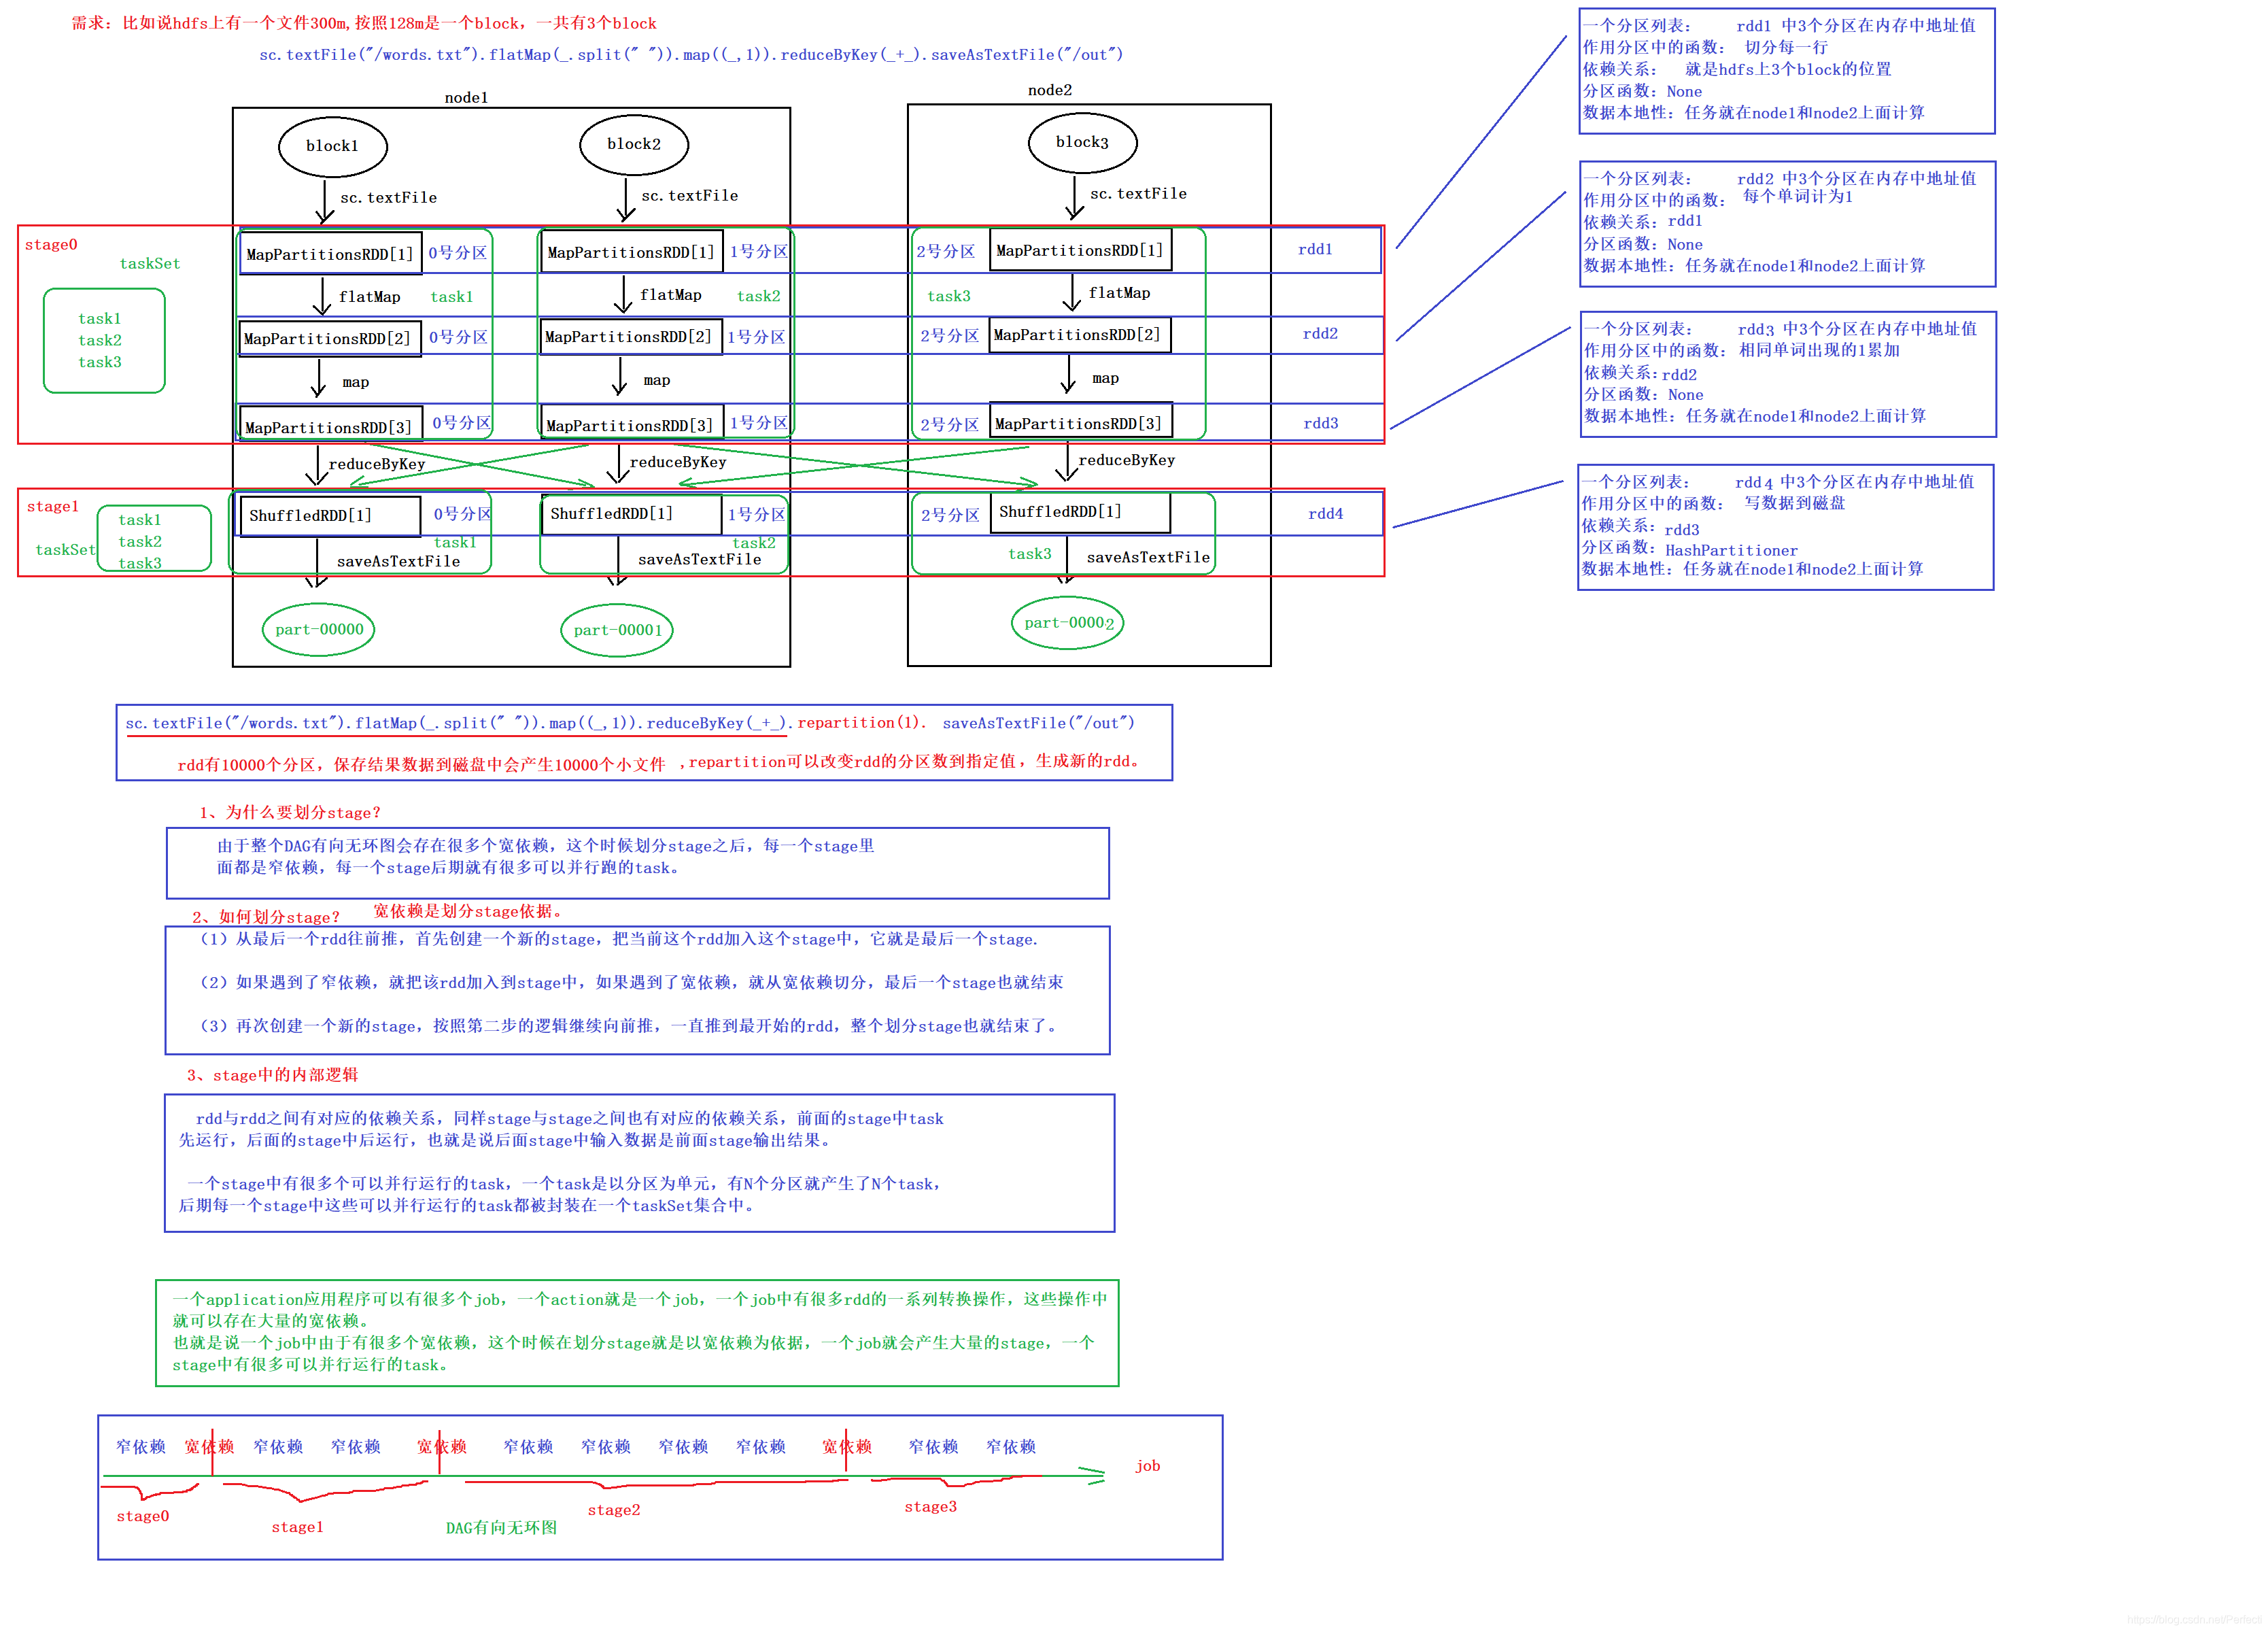
DAG就是按照rdd一系列的操作转换最后就形成一个有方向无闭环的图,这里的方向就是按照rdd的操作顺序,后期可以针对于这个有向无环图进行stage的划分,这里的stage我们成为不同的调度阶段。
11、spark任务调度流程
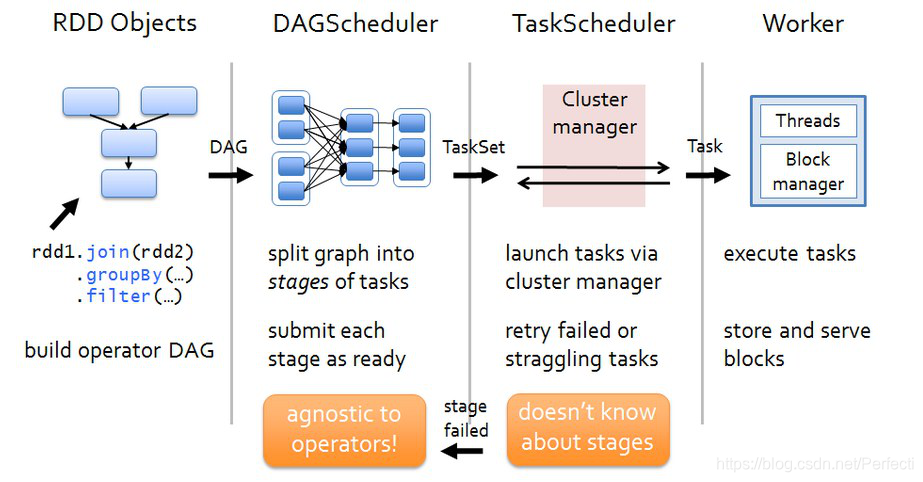
(1)Driver会运行客户端main方法中的代码,代码就会构建SparkContext对象,在构建SparkContext对象中,会创建DAGScheduler和TaskScheduler,然后按照rdd一系列的操作生成DAG有向无环图。最后把DAG有向无环图提交给DAGScheduler。

(2)DAGScheduler拿到DAG有向无环图后,按照宽依赖进行stage的划分,这个时候会产生很多个stage,每一个stage中都有很多可以并行运行的task,把每一个stage中这些task封装在一个taskSet集合中,最后提交给TaskScheduler。

(3)TaskScheduler拿到taskSet集合后,依次遍历每一个task,最后提交给worker节点的exectuor进程中。task就以线程的方式运行在worker节点的executor进程中。
12、spark的容错机制之checkpoint
12.1 什么是checkpoint
rdd设置缓存有2种方式:cache和persist

(1)cache:默认是把数据缓存在内存中,其本质是调用persist方法。后期操作起来速度快,由于一些原因导致进程挂掉了或者是服务器挂掉了,内存中的数据也就丢失。数据的丢失风险的比较高。

(2)persist:可以把数据保存在本地磁盘,后期操作起来比cache要慢一点,但是也不是特别安全,比如说磁盘损坏,或者是某个系统管理员由于误操作把数据删除了,数据也有丢失的风险。

checkpoint:它提供了一个相对而言更加可靠的数据持久化方式,它可以把数据保存在分布式文件系统中,也就是hadoop中的HDFS.可以通过hdfs高容错来最大程度保证数据不丢失。
12.2 如何设置checkpoint
-
1、首先使用sparkcontext对象设置一个checkpoint目录
-
sc.setCheckpointDir("hdfs上目录")
-
-
2、使用rdd调用checkpoint方法
-
rdd1.checkpoint
-
-
3、需要一个action来触发任务的运行
-
rdd1.collect
-
12.3 cache、persist、checkpoint区别
cache、persist可以对rdd的数据进行缓存,后面需要有对应的action操作,才会触发缓存的执行。它不会改变rdd的血统关系。不会产生新的job,你有几个action,就对应有几个job。

checkpoint:对需要做checkpoint操作的rdd调用checkpoint方法,后面需要有对应的action操作。它会改变的rdd的血统关系,对当前需要做checkpoint操作的rdd最后调用了一个action,一个action就是一个job,你在执行action操作的时候,首先会有一个job去运行。这个job运行完成之后,它会再次启动一个新的job来运行checkpoint操作,也就是说这一块它会有2个job去跑任务。
12.4 数据丢失之后恢复顺序
(1)先去cache中看看有没有设置缓存,如果cache中存在就直接从内存中获取得到
(2)如果cache不存在,接下来看看有没有做checkpoint操作,如果有checpoint操作,这个时候就直接从磁盘中获取得到,如果也没有做checkpoint
(3)只能够通过血统重新计算恢复得到。
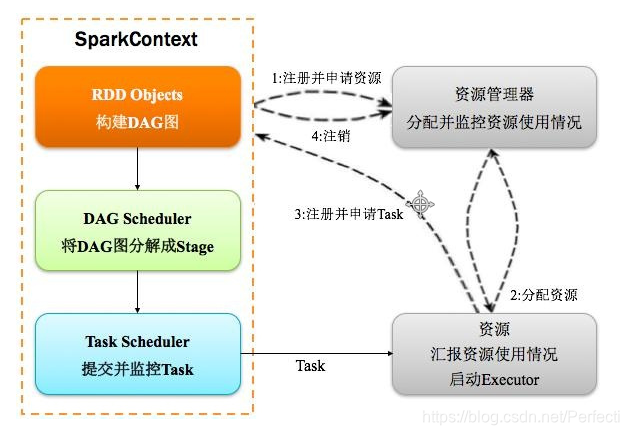
13、spark运行架构
更多内容关注我的个人公众号:


 341


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


