GLM-OCR:轻量级多模态OCR的技术突破

LightTools宏 vs Python API:光学仿真自动化方案选型指南 本文深入对比了LightTools光学仿真自动化中VBA宏与Python API两种方案。VBA宏内嵌易用,适合固定流程批处理;Python API生态强大,尤其在参数优化算法集成方面优势显著,便于构建复杂工作流。文章结合案例,为不同场景下的技术选型提供清晰指南。 阅读详情

在数字化转型的浪潮中,文档智能处理已成为企业提升效率的关键环节。无论是财务部门处理海量发票,还是科研人员数字化学术论文,OCR(光学字符识别)技术都扮演着不可或缺的角色。然而,传统 OCR 技术长期面临着一个两难困境:高精度模型往往参数量巨大、部署成本高昂,而轻量级模型又难以应对复杂场景。智谱 AI 开源发布的 GLM-OCR 模型打破了这一僵局,以仅 0.9B 的参数量实现了业界领先的文档解析能力,在权威榜单 OmniDocBench V1.5 中以 94.6 分取得 SOTA 性能,成为 OCR 领域的一次重要技术突破。
GLM-OCR 官方发布:0.9B 参数登顶 SOTA,文档解析新标杆

小模型,大能力:GLM-OCR 的核心优势

GLM-OCR 最令人瞩目的特点在于其“小尺寸、高精度”的设计理念。相比动辄数十亿参数的大型多模态模型,GLM-OCR 仅需 0.9B 参数,却在文本识别、公式解析、表格提取和信息抽取四大核心领域**展现出卓越性能,甚至在某些维度上接近 Gemini-3-Pro 的表现水平。这种高效的参数利用率得益于智谱 AI 自研的 CogViT 视觉编码器和 GLM-V 架构的深度融合。

从实际部署角度看,GLM-OCR 的轻量化设计带来了显著的成本优势。模型仅需 4GB 显存即可运行,单张 A4 文档的识别时间仅为 100-200 毫秒,PDF 文档处理吞吐量达到 1.86 页/秒,图片处理速度为 0.67 张/秒。在价格方面更是极具竞争力:API 调用成本仅为 0.2 元/百万 Tokens,1 元即可处理约 2000 张 A4 扫描图片或 200 份 10 页简单排版 PDF,成本约为传统 OCR 方案的 1/10。这使得 GLM-OCR 不仅适合云端大规模部署,也能够在边缘设备和移动端灵活运行,真正实现了“普惠 AI”的愿景。

技术架构:多模态融合的创新实践

GLM-OCR 的技术架构体现了多模态大模型设计的前沿思路。整个系统基于编码器-解码器架构构建,核心包含三大组件:在大规模图文数据上预训练的 CogViT 视觉编码器、具有高效令牌下采样机制的轻量级跨模态连接器,以及 GLM-0.5B 语言解码器。这种设计使得模型能够深度理解图像中的视觉信息,并将其转化为结构化的文本输出。
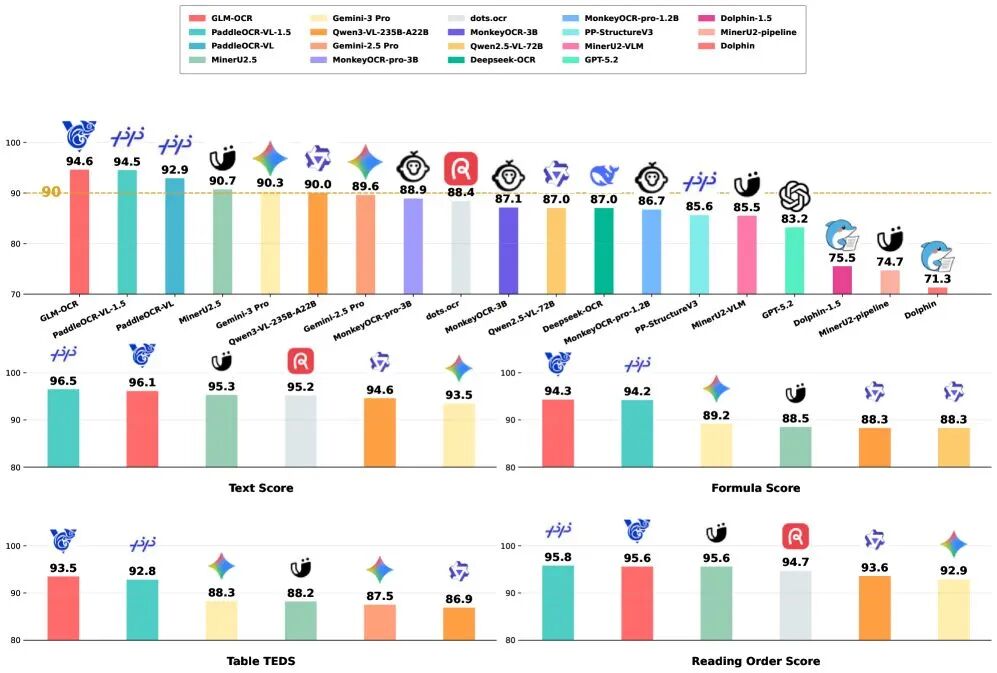
GLM-OCR 权威基准测试 OmniDocBench v1.5 性能对比(官方高清版)

CogViT 视觉编码器是 GLM-OCR 的技术亮点之一。不同于传统的 ViT 架构,CogViT 引入了认知增强模块和多尺度特征融合机制,能够同时捕捉文档中的细粒度文字信息和宏观版式结构。这种多层次的特征提取能力使得模型在处理复杂表格、手写体、印章等场景时表现出色。

更值得关注的是,GLM-OCR 引入了多令牌预测(Multi-Token Prediction, MTP)损失函数和稳定的全任务强化学习机制。MTP 技术能够在推理时预测多个 token,显著提升解码速度;而基于人类反馈的强化学习(RLHF)训练框架则针对 OCR 特定任务进行优化,使模型输出更符合实际应用需求。此外,GLM-OCR 还结合了基于 PP-DocLayout-V3 的“版面分析与并行识别”两阶段流程,先理解文档整体布局,再进行精准识别,大幅提升了训练效率和泛化能力。

全场景覆盖:从手写体到复杂表格

GLM-OCR 的另一大优势在于其出色的场景适应性。在智谱 AI 的内部测评中,模型在六大核心场景中均取得显著优势:代码文档识别准确率达 96.7%,真实场景表格解析准确率为 92.8%,手写体识别准确率达 95.2%,多语言混排识别准确率为 94.3%,印章识别准确率为 91.5%,票据提取表现同样出色。这种全场景覆盖能力意味着企业无需针对不同应用场景部署多个专用模型,一个 GLM-OCR 即可满足绝大多数文档处理需求。
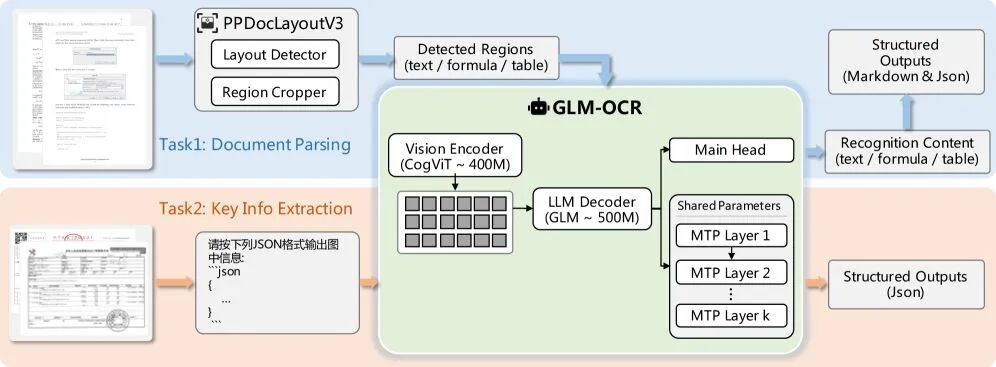
GLM-OCR 核心技术架构:CogViT 视觉编码器与 MTP 多令牌预测

在实际应用中,GLM-OCR 能够精准解析扫描件、PDF、表格及票据,有效解决手写、印章、竖排及多语言混排等传统 OCR 难题。无论是财务人员处理增值税发票,需要提取发票号码、开票日期、购买方信息、金额合计等结构化字段;还是科研人员数字化学术论文,需要识别复杂的数学公式并输出 LaTeX 格式;抑或是法务人员分析合同文档,需要理解复杂的版式布局和条款结构,GLM-OCR 都能提供高质量的识别结果。
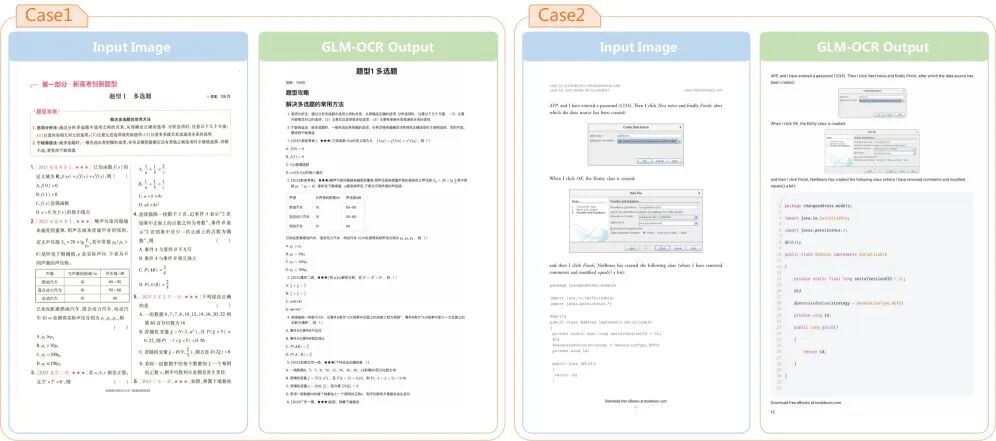
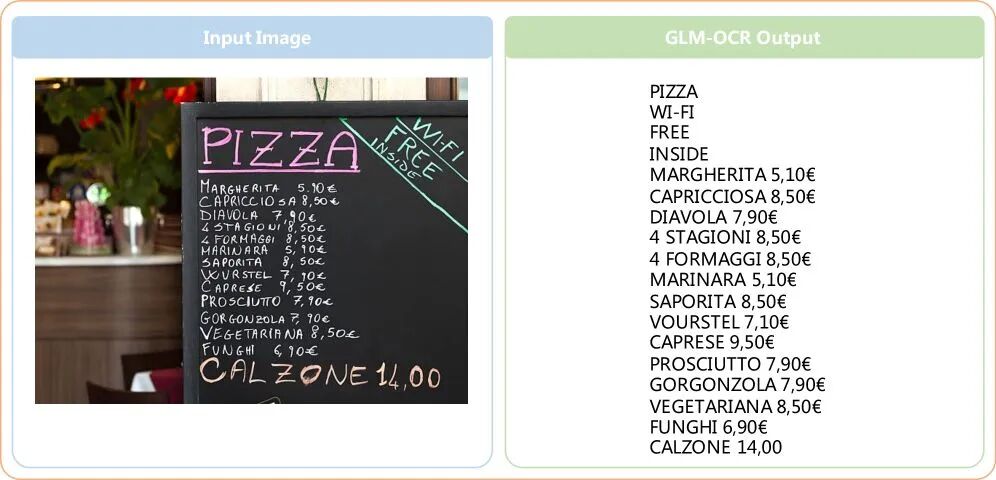
GLM-OCR 真实业务场景实测:手写体、公式与复杂表格解析

从实际部署角度看,GLM-OCR 的轻量化设计带来了显著的成本优势。模型仅需 4GB 显存即可运行,单张 A4 文档的识别时间仅为 100-200 毫秒,PDF 文档处理吞吐量达到 1.86 页/秒,图片处理速度为 0.67 张/秒。在价格方面更是极具竞争力:API 调用成本仅为 0.2 元/百万 Tokens,1 元即可处理约 2000 张 A4 扫描图片或 200 份 10 页简单排版 PDF,成本约为传统 OCR 方案的 1/10。这使得 GLM-OCR 不仅适合云端大规模部署,也能够在边缘设备和移动端灵活运行,真正实现了“普惠 AI”的愿景。

更值得关注的是,GLM-OCR 引入了多令牌预测(Multi-Token Prediction, MTP)损失函数和稳定的全任务强化学习机制。MTP 技术能够在推理时预测多个 token,显著提升解码速度;而基于人类反馈的强化学习(RLHF)训练框架则针对 OCR 特定任务进行优化,使模型输出更符合实际应用需求。此外,GLM-OCR 还结合了基于 PP-DocLayout-V3 的“版面分析与并行识别”两阶段流程,先理解文档整体布局,再进行精准识别,大幅提升了训练效率和泛化能力。

在实际应用中,GLM-OCR 能够精准解析扫描件、PDF、表格及票据,有效解决手写、印章、竖排及多语言混排等传统 OCR 难题。无论是财务人员处理增值税发票,需要提取发票号码、开票日期、购买方信息、金额合计等结构化字段;还是科研人员数字化学术论文,需要识别复杂的数学公式并输出 LaTeX 格式;抑或是法务人员分析合同文档,需要理解复杂的版式布局和条款结构,GLM-OCR 都能提供高质量的识别结果。
GLM-OCR 赋能 RAG:从复杂文档到高质量知识库的端到端闭环

灵活部署:从云端到边缘

GLM-OCR 提供了多种灵活的部署方式,满足不同场景的需求。对于快速验证和小规模应用,可以直接调用智谱 AI 的云端 API,无需配置环境即可开始使用。对于有本地部署需求的企业,GLM-OCR 支持 Ollama、vLLM、SGLang 等主流推理框架,能够在单张消费级 GPU 上高效运行。特别是启用 MTP 加速后,推理速度可进一步提升,更适合高并发场景。

值得一提的是,GLM-OCR 完全开源,开发者可以在 ModelScope、Hugging Face 等平台获取模型权重,根据自身业务需求进行定制化微调。自发布以来,GLM-OCR 在 ModelScope 平台上获得了超过 12000 次下载和 2500+收藏,成为最受欢迎的 OCR 模型之一,这充分反映了开发者社区对轻量级、高精度 OCR 解决方案的强烈需求。

应用场景:赋能千行百业

GLM-OCR 的应用潜力覆盖了众多行业领域。在金融行业,可用于自动化处理发票、票据、银行卡、身份证等各类证照,大幅提升财务审核效率;在教育科研领域,能够数字化手写笔记、学术论文、实验报告,特别是对数学公式的精准识别能力,为知识管理提供了有力支持;在法律行业,可以快速解析合同条款、法律文书,提取关键信息并进行结构化存储;在制造业,能够识别生产文档、技术图纸中的代码和标注信息。

更重要的是,GLM-OCR 与大语言模型的无缝集成能力,使其成为 RAG(检索增强生成)系统的理想前端。通过将文档内容精准转换为结构化文本,GLM-OCR 为下游的知识检索和智能问答提供了高质量的数据基础,真正实现了从非结构化文档到智能应用的端到端闭环。

未来展望:持续演进的技术路线

智谱 AI 团队表示,未来将持续迭代 GLM-OCR,推出更多尺寸版本以满足不同场景需求,并将能力延伸至更多语言和视频 OCR 领域,全面拓宽视觉智能的应用边界。从技术发展趋势看,轻量化、多模态、端到端将成为 OCR 技术演进的主要方向,而 GLM-OCR 正是这一趋势的先行者。

随着模型的持续优化和生态的不断完善,我们有理由相信,GLM-OCR 将推动 OCR 技术从专业工具走向大众应用,从单一场景走向全场景覆盖,真正实现“让机器像人一样理解文档”的愿景。对于开发者和企业而言,现在正是探索 GLM-OCR 应用潜力的最佳时机。

更重要的是,GLM-OCR 与大语言模型的无缝集成能力,使其成为 RAG(检索增强生成)系统的理想前端。通过将文档内容精准转换为结构化文本,GLM-OCR 为下游的知识检索和智能问答提供了高质量的数据基础,真正实现了从非结构化文档到智能应用的端到端闭环。

随着模型的持续优化和生态的不断完善,我们有理由相信,GLM-OCR 将推动 OCR 技术从专业工具走向大众应用,从单一场景走向全场景覆盖,真正实现“让机器像人一样理解文档”的愿景。对于开发者和企业而言,现在正是探索 GLM-OCR 应用潜力的最佳时机。

社区地址

OpenCSG社区:https://opencsg.com/models/zai-org/GLM-OCR

hf社区:https://huggingface.co/zai-org/GLM-OCR

关于 OpenCSG

OpenCSG 是全球领先的开源大模型社区平台,致力于打造开放、协同、可持续生态,AgenticOps是人工智能领域的一种AI原生方法论,由OpenCSG(开放传神)提出。AgenticOps是Agentic AI的最佳落地实践也是方法论。核心产品 CSGHub 提供模型、数据集、代码与 AI 应用的 一站式托管、协作与共享服务,具备业界领先的模型资产管理能力,支持多角色协同和高效复用。

GVINS数据采集(u-blox fp9 + D435i) 1、配置千寻的RTK账号 采集数据当天购买千寻的RTK账号,然后在Window下,输入账号和密码 (具体的步骤如之前面连接所示),查看u-center软件上的信息,确保接收机可以收到RTK信息; 2、查看Linux系统下u-blox是否可以正常接受GPS信号和RTK数据流 1、GPS信号信息 // 打开端口 1 cd ublox_f9p/src // 或者在终端1下也可以 source devel/setup.bash r..................... 阅读详情

相关推荐

运算放大器噪声分析实战:从理论到TINA-TI仿真的完整指南

本文深入探讨运算放大器噪声分析的完整流程,从基础理论到TINA-TI仿真实践。详细解析噪声来源、运放噪声模型建立、手工计算方法,并结合TI工具进行高效仿真验证,提供低噪声电路设计优化策略,帮助工程师提升精密电子系统性能。

Jerry的专栏 949

20:GLM-OCR 深度解析:轻量级多模态OCR的技术突破

GLM-OCR作为智谱开源的0.9B轻量级多模态OCR模型,通过GLM-V架构与自研CogViT视觉编码器的融合,在手写体、复杂表格、代码文档等多场景下实现了卓越性能。本文深入解析其技术架构、核心创新点、性能优势,并通过真实代码示例展示其在文档解析、票据提取、RAG等场景中的应用潜力,最后探讨其对OCR领域的深远影响。

欢迎来到智能安全前线!这里是AI与信息安全交汇之地。我们以代码为武器,深入大模型攻防实战,破解系统漏洞。追踪OpenAI、Meta前沿动态,用红蓝对抗思维,锻造智能时代的坚盾与利矛。 828

利用GBD数据库做未来疾病负担预测

最近看到一篇文献,利用GBD数据库中的数据对疾病负担的发展趋势进行预测。觉得很有趣,就抽空用R语言复盘了一下里面关键的方法。 参考文献: Changing trends in the disease burden of esophageal cancer in China from 1990 to 2017 and its predicted level in 25 years DOI: 10.1002/cam4.3775 1. 相关R包的安装 主要用到的R包有3个,一个一个讲: 1.1 Nordpred

NickyCat的博客 5万+

GLM-OCR惊艳效果展示:手写数字表格识别,支持连笔字与涂改痕迹容错

本文介绍了GLM-OCR镜像在复杂手写文档识别中的惊艳表现,特别是其对手写数字表格、连笔字与涂改痕迹的强大容错能力。用户可在星图GPU平台上实现该镜像的自动化部署,快速搭建服务,并将其应用于财务票据处理、历史档案数字化等需要高精度、高鲁棒性文字识别的实际场景。

weixin_42311427的博客 881

Ubuntu中 vsftpd 的安装与配置 (详细介绍)

简介 vsftpd 是一个 UNIX 类操作系统上运行的服务器的名字,它可以运行在诸如 Linux, BSD, Solaris, HP-UX 以及 IRIX 上面。它支持很多其他的 FTP 服务器不支持的特征。 vsftpd是 UNIX 操作系统中的一个开源的、免费的 FTP 服务软件。具有以下特点: 安全性高 轻小易用 支持系统用户匿名用户和虚拟用户的权限验证和相关操作 安装步骤如下: 1.将此命令复制到终端 sudo apt-get install vsftpd 2.安装完成后启动VSFTP

qq_43299421的博客 1万+

AI智能体Codex实战:外贸客户开发自动化,85家精准客户深度分析

如果你在外贸行业,特别是工业品领域,一定遇到过这样的困境:想开发海外客户,但不知道从何下手。Google搜索出来的要么是B2B平台上的老面孔,要么是信息残缺的过时黄页。手动筛选、整理、验证,一个客户信息就要花上半小时,效率低得让人抓狂。 更头疼的是,好不容易找到一些公司名称,却不知道他们的采购决策人是谁、公司规模如何、业务是否匹配。传统的客户开发就像大海捞针,投入大量时间成本,回报却充满不确定性。 今天要介绍的这个工具,可能会彻底改变你的工作流。它不是另一个CRM软件,而是一个基于AI的智能客户开发与情报分

weixin_29054399的博客 350

银行ATM机功能拓展:GLM-4.6V-Flash-WEB识别存单填写内容

通过轻量级多模态大模型GLM-4.6V-Flash-WEB,银行ATM可实现手写存单的快速精准识别,无需人工录入。该技术结合视觉与语义理解,支持本地化部署,在保障隐私安全的同时显著提升办理效率,推动金融终端迈向无感智能服务。

weixin_35706067的博客 1037

非线性动力学_用MatCont分析非线性动力学方程组(一)

写在前面:笔者打算写两到三篇系列文章介绍MatCont,此为第一篇《用MatCont分析非线性动力学方程组(一)》。MatCont是一个基于Matlab而开发的免费工具包,专门用来做非线性动力学模型分叉、向量场、周期性等分析,符号(连续性)运算和数值(离散性)运算均适用。该工具的开发及研究项目由比利时Ghent大学的Willy Govaerts教授、荷兰Utrecht大学的Yuri Kuznets...

weixin_39700215的博客 2770

微PE官网工具链升级:GLM-4.6V-Flash-WEB识别RAID配置界面

通过GLM-4.6V-Flash-WEB多模态模型,微PE工具可自动分析BIOS界面并识别RAID配置,摆脱传统人工判断的繁琐与误配风险。模型在本地运行,支持快速推理与结构化输出,实现系统安装前的智能驱动预加载,提升自动化装机效率与稳定性。

weixin_29323977的博客 607

密码学小白必看:三大顶级会议论文下载与阅读指南(附完整资源链接)

本文为密码学初学者提供了系统获取和阅读三大顶级会议(Crypto、Eurocrypt、Asiacrypt)论文的实战指南。详细介绍了通过IACR官方渠道、ePrint预印本等权威资源免费下载论文的方法,并分享了高效筛选、精读核心章节及构建个人知识体系的具体策略,帮助读者快速切入密码学研究前沿。

weixin_28363123的博客 418

使用ShaderGraph制作URP各向异性

URP上用shaderGraph实现各向异性效果,解决只能用shader的问题

dreamform的专栏 1100

GLM-OCR开源模型演进:从GLM-V到GLM-OCR的多模态文档理解技术路径

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现高精度多模态文档理解。通过一键启动,用户可快速构建文档智能解析服务,典型应用于扫描合同、发票及科研笔记的结构化文本、表格与LaTeX公式提取,显著提升办公与知识管理效率。

weixin_42591413的博客 303

【北大核心-代码复现】基于 VMD-FFCM-iTransformer 光伏功率短期预测

【北大核心-代码复现】基于 VMD-FFCM-iTransformer 光伏功率短期预测

769

GLM-OCR技术解析:轻量级多模态文字识别实践

OCR(光学字符识别)作为计算机视觉的核心技术,通过深度学习实现图像到文本的转换。其技术原理基于CNN和RNN的特征提取与序列建模,结合注意力机制解决长距离依赖问题。在移动端部署时,模型轻量化成为关键挑战,涉及知识蒸馏、量化压缩等技术。GLM-OCR创新性地融合视觉、文本和结构多模态信息,采用动态通道剪枝实现自适应计算,在保持50MB体积下达到92.3%的F1分数。该技术特别适用于医疗票据识别、视频字幕提取等需要实时处理的场景,其中多模态融合和MobileNetV3架构的设计显著提升了复杂背景下的鲁棒性。

weixin_29044713的博客 59

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

GLM-OCR轻量级OCR方案:3GB显存跑2.5GB模型,中小企业降本提效实录

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现轻量级OCR文字识别功能。该方案仅需3GB显存即可高效运行,特别适合中小企业用于文档数字化、表格和公式识别等场景,显著降低部署成本并提升数据处理效率。

weixin_35749440的博客 300

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

GLM-OCR多模态文档识别技术解析与应用实践

OCR(光学字符识别)技术通过计算机视觉与自然语言处理的结合,实现了从图像中提取文本信息的能力。其核心原理在于多模态特征融合,将视觉信息转化为可理解的文本序列。现代OCR系统采用编码器-解码器架构,通过视觉编码器提取图像特征,再经语言解码器生成文本。GLM-OCR作为开源多模态OCR模型,创新性地结合了GLM-V架构与强化学习训练策略,在复杂文档理解场景中展现出显著优势。该技术特别适用于处理扫描模糊文档、含表格报表及学术论文等非结构化数据,其两阶段处理流程(先分析版面结构再识别内容)有效提升了识别精度。在实

weixin_31499265的博客 215

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

GLM-OCR开源模型优势解析:相比PaddleOCR/Tesseract的泛化能力对比

本文介绍了如何在星图GPU平台自动化部署GLM-OCR开源镜像,实现高效OCR文字识别。该镜像基于先进的多模态架构,能够准确识别复杂文档、表格和公式,适用于文档数字化、表格数据提取等场景,显著提升文本信息处理效率。

weixin_31486261的博客 1020

零基础入门多模态AI:用GLM-4.6V-Flash-WEB实现智能OCR

本文介绍了如何在星图GPU平台上自动化部署GLM-4.6V-Flash-WEB镜像,实现智能OCR功能。该镜像支持对GUI界面截图进行视觉语言理解,可精准识别按钮、图标及操作意图,典型应用于Windows安装界面识别与自动化交互,显著提升RPA和测试脚本的鲁棒性。

weixin_33816734的博客 393

GLM-OCR实战:复杂文档理解一键搞定

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现复杂文档的一键式理解与处理。该镜像能够精准识别文本、表格及数学公式,广泛应用于学术论文数字化、商业报表解析等场景,大幅提升文档处理效率与准确性。

weixin_42600128的博客 92

GLM-OCR多模态OCR教程:图文联合建模如何提升复杂版式理解能力

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现复杂版式文档的智能理解与结构化提取。该镜像支持图文联合建模,可精准识别双栏论文、带公式的物理题及多表财报等场景,自动生成含Markdown表格、LaTeX公式和语义分段的结构化文本,显著提升文档处理效率。

weixin_42513928的博客 95

GLM-OCR一文详解:GLM-V架构下多令牌预测(MTP)如何突破传统OCR瓶颈

本文介绍了如何在星图GPU平台自动化部署GLM-OCR镜像,实现高效OCR文字识别。该镜像基于GLM-V架构和多令牌预测技术,能快速准确地识别复杂文档、表格和公式,广泛应用于文档数字化、表格信息提取等场景,显著提升处理效率和准确率。

weixin_29050829的博客 105

GLM-OCR效果对比:vs PaddleOCR vs LayoutParser,在复杂版式文档中胜出

本文介绍了GLM-OCR在复杂版式文档识别中的优势,并展示了如何在星图GPU平台上自动化部署该镜像。GLM-OCR作为一个多模态OCR系统,能够统一处理文本、表格和公式识别,尤其擅长解析学术论文、财务报表等混合排版文档,实现端到端的文档理解与结构化输出。

weixin_42453228的博客 379

GLM-OCR一文详解:MTP损失函数如何提升复杂文档识别准确率

本文介绍了如何在星图GPU平台上一键自动化部署GLM-OCR镜像,实现高效复杂的文档识别功能。该镜像通过MTP损失函数提升对表格、公式等复杂结构的识别准确率,适用于学术文献数字化、企业报表处理等场景,大幅提升文档处理效率与自动化水平。

weixin_29025501的博客 650

GLM-OCR惊艳案例:数学竞赛试卷OCR→题目+选项+标准答案结构化输出

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现数学竞赛试卷的智能OCR识别与结构化输出。该镜像能精准解析复杂数学公式、题目选项和标准答案,自动生成JSON等结构化数据,大幅提升教育领域试卷批改与题库数字化效率。

weixin_42509507的博客 402

GLM-OCR实战:一键识别扫描文档,3GB显存就能跑,效果惊艳

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现高效文档识别与理解。该平台简化了部署流程,用户可快速搭建服务。GLM-OCR能精准识别扫描文档中的文字、还原复杂表格结构并提取数学公式,显著提升合同、发票等纸质文档电子化的处理效率与准确性。

weixin_34779181的博客 166

GLM-OCR多模态OCR实战:图文联合建模如何提升公式符号识别准确率

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现多模态文档智能识别。该平台简化了部署流程,用户可快速搭建服务,将GLM-OCR应用于学术论文、技术文档中复杂数学公式和表格的结构化识别与提取,显著提升文档数字化效率。

weixin_42596246的博客 418
上一篇: AgenticHub × OpenClaw:把你的 Agent 装进龙虾
下一篇: 从“模型实验”到“AI 生产系统”:企业为什么需要大模型管理平台
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值