


作者 | Piotr Mazurek & Felix Gabriel
OneFlow 编译
翻译|张雪聃
题图由 SiliconCloud 生成
当前 LLM 公司的主要商业模式是通过 API 提供模型访问服务,推理成本结构是决定其盈利能力的关键。本文将从底层原理阐释大模型托管/服务的成本来源、单个 GPU 可生成的词元(Token)数量及其成因,本文以开源模型 LLaMA 3.3 为基础,搭建一个简化版的大模型推理运算世界模型,旨在建立关于 LLM 推理的精确直觉认知。
大模型推理的经济学影响远超过技术范畴本身。随着 AI 能力突飞猛进,推理效率直接决定着行业经济形态与技术普惠程度。对 AI 实验室而言,词元生产成本从根本上决定了利润率与合成训练数据的生成成本——更高效的推理意味着固定硬件投资能获得更高回报,从而为后续研发周期注入动力。对用户而言,更低的词元成本将使这些强大工具更加可及,甚至可能推动 AI 从高端资源转变为处理日常任务的通用工具。理解这些成本结构不仅具有理论价值,随着我们日益接近更强大的 AI 系统,这实际上为我们洞察未来数年塑造 AI 发展的关键经济力量提供了窗口。
单个词元的生成成本可归结为购买或租用 GPU 的计算成本。无论采用哪种方式,GPU 每小时的运行都存在固定成本。而每块 GPU 在一小时内能生成的词元数量是有限的,用每小时生成的词元数量除以每小时的硬件成本,就能得出单个词元的生成成本。这正是大多数 LLM 服务商为其 API 定价的基本逻辑,也是本文将要深入探讨的成本模型。
(本文作者 Piotr Mazurek 是 Aleph Alpha 的 AI 研究工程师;Felix Gabriel 是 Prime Intellect 的 AI 研究工程师,也曾在 Aleph Alpha 从事 LLM 相关研究工作。本文经授权后由 OneFlow 编译。原文:https://www.tensoreconomics.com/p/llm-inference-economics-from-first)
1
模型参数与硬件需求
我们将采用 LLama 3.3 70B 作为推理经济性分析的基准模型。即便在今天,这仍是业内最主流的开源模型之一,其架构已成为整个行业的标杆。虽然基于 Llama 权重衍生出了大量微调模型(这些模型输出结果各异),但由于共享相同的模型架构,其运行所需的计算资源完全一致。因此,Llama 堪称理想的研究范例——既具备行业代表性,又便于理解。
LLM 将“知识”存储在参数中(即决定模型行为的权重)。这些参数既需要存储空间,也依赖算力进行运算。一般而言,模型参数量与其在下游任务中的潜在能力成正比,但也相应推高资源需求。Llama 3.3 70B 名称中的 “70B” 正源于其约 700 亿(70 billion)的参数量。
以 Llama 为代表的纯解码器(decoder-only)Transformer 模型通常包含以下组件:
1. 输入嵌入层——将词元(或单词)转化为向量表示
2. 多层 Transformer 层——每层包含自注意力模块参数与 MLP 模块参数
3. 语言模型头(LM head)——最终输出层
本文默认读者已掌握这些基础概念,故不再赘述其底层原理。若你对 Transformer 架构尚不熟悉,建议先行参阅相关入门教程:
https://jalammar.github.io/illustrated-transformer/
https://www.youtube.com/watch?v=kCc8FmEb1nY&t
https://youtu.be/wjZofJX0v4M

图 1:Llama 3.3 的配置,将在本文中作为参考模型用于吞吐量相关讨论(https://huggingface.co/meta-llama/Llama-3.3-70B-Instruct/blob/main/config.json)

图2:Llama 架构
现在,让我们逐步拆解模型的参数,验证其标称的 700 亿参数是否成立。首先,在图 1 的 Llama 模型配置图中,可以看到其包含多个键值对。这些键值(例如 hidden_size)标明了模型各组成部分的维度大小,我们可据此计算模型的总参数。图 2 展示了模型架构的全局视图,清晰地呈现了我们前文所述的三个核心组件,同时该示意图还包含一些我们将在下一节深入探讨的实现细节。
输入嵌入层的作用是将每个可能的词元位置转换为对应的向量表示。因此该层的参数计算公式为:

接下来是 N 个 Transformer 层(参见图 2)。每个这样的层级通常包含数百万个需要存储在内存中的参数,这些参数的规模可以通过配置文件 config.json 中的超参数来计算得出:

*w_v 和 w_k 的大小仅为 w_q 的 1/8,这是 Llama 架构的特有设计。这源于 Llama 团队采用的“分组查询注意力(GQA)”技术——该技术使键(K)和值(V)的注意力头数量少于查询(Q)的总头数。你可以通过模型配置中的 num_key_value_heads 超参数验证这一点。此外,模型 intermediate_size 设定为 hidden_size 的 3.5 倍,也是 Llama 架构专有值。这些参数均由 Llama 团队设定,我们直接采用这些预设值以简化计算过程。
综合上述要素,最终每个 Transformer block 的总参数为:

最后,在将表征向量输入语言模型头把向量转换为词元的 logits 值之前,我们会执行最后一次 RMS 归一化。

综合以上所有参数,我们最终得到的模型总参数为:

我们可以在图 1 的配置文件中找到以下关键参数的具体数值:vocab_size, hidden_size, num_hidden_layers。
将这些数值代入公式后,最终可计算出:

所有参数均以 bfloat16 浮点格式存储(例如:0.22312、-4.3131)。每个参数占用 16 位(即 2 字节)存储空间。鉴于模型总参数达到 70,553,706,496 个,仅存储模型权重就需要 141,107,412,992 字节(141GB)的 GPU 显存。
值得注意的是,141GB 的显存需求已超出当前主流数据中心 GPU 的配置上限(如 NVIDIA A100 或 H100 的显存容量均为 80GB)。这里的显存(技术上也被称为高带宽存储器 HBM 或全局内存)限制使得模型部署时必须采用多卡并行方案。实际生产环境中,为实现更优的推理性能,通常需要 4 到 8 块 GPU 协同工作。此处我们暂不展开讨论具体原因(将在后文详述),而是先基于此继续分析。
2
计算与内存限制
在评估 GPU 规格时,我们需重点关注两个核心指标:
计算:以 FLOPS(每秒浮点运算次数)衡量,表示 GPU 每秒能执行的浮点运算(加法和乘法)总量*。
内存带宽:表示每秒可从全局内存加载的字节数量。
这两个因素共同决定计算处理速度;它们会影响单次前向传播的速度、决定生成速度(以词元/秒,TPS 衡量)、并最终决定单位词元生成成本。
技术术语澄清:
FLOPs(小写 s):浮点运算次数(与时间无关的概念)
FLOPS(大写 S):每秒浮点运算次数

图3:A100 与 H100 显卡算力及内存带宽对比(来源:https://www.databricks.com/blog/coreweave-nvidia-h100-part-1)
计算机程序(如运行 LLM )的特性可通过其算术强度(arithmetic intensity)来描述。算术强度是指计算操作(如加法或乘法,以 FLOPs 衡量)与内存访问(以字节衡量)的比率。算术强度越高,则程序每从内存获取单位数据能执行更多计算,通常能更好地利用处理器的计算能力,减少内存带宽造成的瓶颈。之所以 LLM 推理的算术强度非常低,是因为它需要反复从内存访问大量模型权重,而每次读取单位数据所对应的计算操作很少。如后文所述,LLM 推理同时包含计算受限阶段(算术强度极高)和内存受限阶段(算术强度极低)。
对于 A100:
FLOPS:每秒可执行 3.12×10¹⁴ 次浮点运算
内存:每秒可从全局内存(HBM)加载 2.03×10¹² 字节
对于 H100:
FLOPS:每秒可执行 9.89×10¹⁴ 次浮点运算
内存:每秒可从全局内存(HBM)加载 3.35×10¹² 字节
如后文所述,LLM 推理包含两个阶段:一个是计算受限阶段(算术强度极高),另一个是内存受限阶段(算术强度极低)。其中内存受限阶段占据了绝大部分实际运行时间,因此高效 LLM 推理的核心目标就是在内存受限阶段将 GPU 算力的利用率最大化。因此,提高内存受限阶段的算术强度是一个根本性优化目标,可直接提升推理经济性。
在 LLM 上下文中,为了生成一个词元,我们需要从全局内存(HBM)加载整个模型的所有参数(这会占用内存带宽),并计算中间激活值(这会占用计算资源)。计算资源与内存带宽的利用率之比至关重要,它决定了哪些方面可以优化以及如何实现更高效的推理经济效益。在下一部分,我们将深入探讨 LLM 推理的两个阶段:
提示词处理 / 预填充阶段(prompt processing/pre-fill phase)
逐词元生成 / 解码阶段(Token-by-Token/decoding phase)
LLM 请求的端到端时延关键取决于这两个阶段的执行效率。
3
矩阵乘法中的浮点运算量(FLOPs)
在深入分析两个阶段之前,我们首先明确一下矩阵乘法的浮点运算量(FLOPs)的计算方法。
当计算矩阵 A(维度 m×n)与矩阵 B(维度 n×o)的乘积 C = A @ B(维度 m×o)时,其运算过程包含:
从 A 中选取每一行向量;从
B中选取每一列向量计算两者的点积来填充
C的每个元素(element)
对于两个长度为 n 的向量间的单次点积运算:
需要进行
n次乘法运算随后执行
n-1次加法运算因此总运算量为
n + n-1 = 2n-1次操作
由于我们需要对结果矩阵 C (m×o elements) 中的每一个元素执行上述点积运算:
总浮点运算量 =
(2n-1) × m × o ≈ 2mno
为简化表述,本文后续将统一采用 2mno 作为矩阵乘法的浮点运算计数标准。
4
提示处理/预填充阶段
LLM 生成文本的第一阶段是提示处理(即预填充阶段)。在此阶段,模型会接收一组输入的提示词元,并预测生成的第一个新词元。该阶段的持续时间即为 API 服务商通常公布的“时延”或“首词元生成时间” (Time to First Token, TTFT)(参见图 4)。

图4:OpenRouter 对时延(即首词元生成时间)的报告(https://openrouter.ai/deepseek/deepseek-r1)
这一阶段是计算受限的,这是好事——我们可以充分利用 GPU 的所有计算资源。我们可以通过估算单次前向传播的 FLOPs 来理解其中的原因。
我们可以手动计算模型在处理 S 个词元时的 FLOPs。作为参考,我们附上了 Llama 架构的示意图(见图 2)。
5
嵌入层
FLOPs 计算:
查找操作: 嵌入查找涉及从嵌入矩阵中检索向量,由于主要是内存访问而非算术运算,通常认为其 FLOPs 可忽略不计。
6
自注意力(单层)
RMS Norm:


简化表达为:

查询投影
张量形状:
输入:

权重:

FLOPS:

键与值投影
如先前所述,由于采用多查询注意力机制(MQA),Llama 架构在此环节存在 1/8 的参数特例(w_v 和 w_k 的大小仅为 w_q的 1/8),具体说明请参阅第一章“模型参数与硬件需求”。
张量形状:
输入:

键权重:

值权重:

FLOPS:

旋转位置编码(RoPE)

图 6:RoPE 的实现方式
张量形状:
查询:

键:

余弦:

正弦:

对于 q(查询)和 k(键)中的每个元素,执行以下操作:
乘法运算:每个张量 2 次
将 q 与 cos 相乘
将旋转后的 q(rotate_half(q))与 sin 相乘
加法运算:每个张量 1 次
将两个结果相加得到嵌入后的 q
由于这些操作同时在 q 和 k 上执行,因此每个元素的总计算量为:
每元素总操作量:每个张量 3 次浮点运算 × 2 个张量 = 6 FLOPs
FLOPS:

Q × K^T
我们假设的是朴素注意力实现方式。但在实际部署时,为了降低内存消耗,我们会采用类似 Flash Attention 这样的算法进行迭代计算。
张量形状:
查询:

键:

转置后的键(经过适当的重塑和转置操作):

结果:

FLOPS:
对于每一个注意力头:

对于所有注意力头:

注意:这种对序列长度的二次依赖(S^2)是导致注意力机制在处理长序列时计算开销巨大的原因。
Softmax
Softmax 的 FLOPs 较难精确估算。我们将每个元素的 Softmax 运算近似为 5 次浮点运算。
张量形状:
输入:

输出:

FLOPS:

这是对 Softmax 实际运算(如指数运算、求和与除法)的一种简化近似估计。
注意力输出 (Q @ K^T) @ V
张量形状:
注意力分数:

值矩阵:

输出:

FLOPS:
对每个头:

对所有头:

O-Projection(O-投影)
张量形状:
输入:

权重矩阵:

输出:

FLOPS:

自注意力机制的总浮点运算量
RMS 归一化:

查询投影:

键、值投影:

旋转位置编码(RoPE):

Q @ K^T (对所有注意力头):

Softmax (对所有注意力头):

注意力输出(Q @ K^T) @ V:

O-Projection:

总 FLOPs:

7
MLP(多层感知机,每层)

8
门控权重 W1
张量形状:
输入:

权重:

其中 intermediate_size 等于 hidden_size 的 3.5 倍(Llama 特有)
FLOPS:

Up W2(上投影权重 W2)
张量形状:
输入:
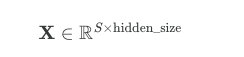
权重:

其中 intermediate_size = 3.5 倍的 hidden_size(Llama 特有)
FLOPS:

Swish/SiLU 激活函数
张量形状:
输入:

其中 intermediate_size = 3.5 倍的 hidden_size(Llama 特有)
FLOPS:
我们将该激活函数近似计算为每个元素 5 次浮点运算

逐元素(Element-wise)乘法
张量形状:
第一次输入:

第二次输入:

其中 intermediate_size = 3.5 倍的 hidden_size(Llama 特有)
FLOPS:

Down W3(下投影权重 W3)
张量形状:
输入:

其中 intermediate_size 等于 hidden_size 的 3.5 倍(Llama 特有)
权重:

FLOPS:

MLP总每秒浮点运算量

9
语言模型头
推理过程中,我们只需关心序列中最后一个词元的下一个词元预测。其他所有“下一个词元”是已知的,它们本身是输入提示的一部分。
张量形状:
输入:

权重:

FLOPS:

10
Llama 模型的总浮点运算量
Llama 模型的总浮点运算量等于每个 Transformer block 的 FLOPs 乘以 block 数,再加上语言模型头的 FLOPs。
Transformer Block
组件:
注意力:

MLP:

每个 block 总量:

总 FLOPs 计算
公式:

以 Llama 3.3 70B 为例:

291 TFLOPs 大致相当于现代 GPU 可提供的浮点运算量级。例如,对于 H100 显卡(见图 3 中的 TFLOPS),理论上处理一个包含 2048 个词元的提示词大约需要 291/989 = 0.29 秒。
提醒一下:从全局内存加载模型参数需要读取约 141 GB 的数据。现代 GPU 的内存带宽大约为 3350 GB/s,这意味着理论上从全局内存加载整个模型需要 141/3350 = 0.04 秒——大约比所有计算所需时间快 7 倍。
这表明:在预填充阶段,我们更多受限于计算资源,而非内存带宽。这是理想的状态,我们希望充分利用所有现有的计算资源。
11
解码阶段
在推理过程中,进行预填充的首次前向传播计算代价非常高昂。通过引入一个特殊缓存,我们可以避免反复执行大量重复计算。这个缓存被称为 KV 缓存,它存储了每个词元位置对应的键和值矩阵。
在注意力机制中,我们需要计算序列中所有词元之间的注意力关系。关键点在于,在第 S+1 步时,预填充阶段已经计算了前 S 个词元之间的所有注意力权重。我们可以将这些中间结果存储在内存(即“缓存”)中,仅计算与最新生成词元相关的新注意力值。
这种优化能够与矩阵运算实现良好配合:
预填充过程中(S 个词元):

其中 d 表示隐藏层维度。
注意力得分及输出的计算方法:

在逐词元生成阶段(第 S+1 个词元):
生成下一词元,我们只需计算:

新的注意力计算公式为:

关键的效率提升来自以下几点:
复用之前计算得到的键矩阵 K^T_cache 和值矩阵 V_cache
仅对最新生成的词元进行新的键-值投影计算
将每个新词元的注意力计算复杂度从 O(S^2) 降至 O(S)

图 8:我们只需为新词元计算查询、键和值。
KV 缓存将前向传播各部分的总浮点运算量减少了大约 S 倍:
在自注意力机制中,我们只需计算新词元与之前所有词元之间的注意力;
在 MLP 和语言模型头模块中,我们也只处理新词元;
语言模型头保持不变,但它在总计算量中所占比例极小,因此在计算中我们可以忽略它。
例如,对于一个包含 2048 个词元的上下文:
在预填充阶段,总计算量约为 291 TFLOPs;
生成第 2049 个词元时的计算量约为 291 / 2048 ≈ 0.14 TFLOPs;
在一张 H100 显卡(峰值性能为 989 TFLOP/s)上,生成这个词元所需时间仅为:

这在纯计算层面上比预填充阶段快了大约 2048 倍,但别忘了,我们仍然需要从全局内存中加载整个模型参数(141 GB)。此外,现在还需要加载 KV 缓存。
KV 缓存的内存占用可以通过以下方式轻松计算:

对于使用 BF16 精度、上下文长度为 2048 个词元的 Llama 3.3 70B 模型,KV 缓存的内存占用大约为:


图9:Llama 3.3 70B 模型的 KV 缓存内存占用随序列长度增加的变化情况(注意:x 轴采用对数(2 的幂次方)表示,这使指数增长在视觉上被压缩)。实际上,内存使用量随序列长度呈超线性增长,而非图中表面看起来的线性增长。
尽管 671 MB 听起来并不算多,但这个数字会随着 batch 规模和序列长度而线性增长(见图 9)。这也是为什么在较长的序列长度下,逐词元生成的速度会比短序列时更慢的主要原因——除了模型权重外,KV 缓存也需要从全局内存中加载,从而增加了每生成一个词元所需的处理时间。
模型权重加上 KV 缓存的总大小约为 141 + 0.6 ≈ 142GB,因此从全局内存加载它们的时间约为 142/3350 = 0.04 秒。而我们在前文中计算得出,完成所有计算只需约 0.00014 秒(假设计算资源 100% 利用)——这意味着加载模型参数的耗时比实际计算多两个数量级。这正是我们所说的“LLM 逐词元生成阶段是受内存限制”的含义:瓶颈主要在于内存传输时间,而不是计算速度。
这是我们希望你从本文中获得的一个重要认识:逐词元生成阶段是内存受限的;此时计算能力是否充足并不是首要问题,我们在等待参数加载的过程中,其实根本没能充分利用可用的计算资源。
*文中“逐词元生成阶段”、“解码阶段”和“生成阶段”这些术语可以互换使用。
12
随输入长度扩展
LLM 推理服务中的一个主要挑战是,理解输入提示长度如何影响端到端性能。尽管影响方式在本质上有所不同,但序列长度会同时影响预填充阶段和逐词元解码阶段。
提示处理阶段的计算复杂度为 O(N^2);随着序列长度的增长,处理时间将呈二次增长。我们之前推导过该过程的浮点运算次数(FLOPs)为:
2 S² hidden_size,用于计算分数矩阵Q @ Kᵗ;2 S² hidden_size,用于计算(Q @ Kᵗ) @ V。
这一点在处理较长序列时尤为重要,此时生成第一个词元所需的时间将随输入序列长度呈二次增长。例如,在使用 long-context Gemini(截至 2025 年 5 月支持最长 200 万词元)时,你可能需要等待长达 2 分钟才能看到第一个回答词元的生成。你应当形成的直觉是:随着输入长度的持续增加,越来越多的耗时将花在提示处理上,其在总耗时中的占比也越来越大——也就是计算受限的部分(参见图 10)。

图 10:随着提示长度的增加,所需计算量(以及相应的耗时)呈二次增长,在请求总处理时间中的占比越来越大。请注意:该图仅用于帮助建立直觉理解,并非基于现实观测数据。
在逐词元生成阶段,生成速度与序列长度之间的关系就不那么直观了。从浮点运算的角度看,计算量是线性增长的:每生成一个新的词元,就需要关注之前所有的词元,计算量为 2 S hidden_size(用于 Q @ Kᵗ)和 2 S hidden_size(用于(Q @ Kᵗ) @ V)。但如前所述,逐词元生成阶段主要是内存受限,FLOPs 并不是关键因素。真正重要的是需要从全局内存中加载的数据量。
提醒一下:每进行一次前向传播,我们都需要从全局内存中加载整个模型参数;此外,还要加载 KV 缓存。正如上文所展示的,随着 KV 缓存的序列长度增长,它所占用的内存也会线性增长,其大小大约为:
2 x bytes_per_param x num_hidden_layers x head_size x num_key_value_heads x S
起初,KV 缓存的大小与需要加载的模型规模相比微不足道,但随着处理的提示词长度增加,KV 缓存将占据越来越大的内存比例(见图 11)。需要注意的是,如果我们选择处理更大的 batch(后续章节将详细讨论),KV 缓存的大小会随 batch 规模线性增长——需要为 batch 中的每个样本独立缓存键和值。最终在某一时刻,KV 缓存的大小甚至会超过模型本身。
这里你需要建立的直觉是:对于小 batch 和短序列,由于此时内存带宽主要用于加载模型权重,序列长度对吞吐量的影响微乎其微。然而,随着 batch 规模或序列长度的增加,加载 KV 缓存所需的时间会逐步累积,最终超过加载模型权重本身的时间消耗。
这种转变形成了两个截然不同的性能阶段:在所谓的“模型主导阶段”(短序列 / 小 batch),即使序列长度增加,吞吐量也基本保持稳定;而一旦进入“KV 缓存主导阶段”,生成速度就会随着序列长度的增长而逐渐下降。这对短序列几乎没有影响,但在处理超长序列(如几万个词元)时,就会成为一个显著问题,此时加载 KV 缓存所需的时间会随着序列长度线性增长。

图11:KV 缓存随序列长度增加的变化趋势。对于 Llama 3.3 70B 模型,当处理 128k 词元的序列时,单个句子的 KV 缓存将高达 40 GB 。
在注意力机制朴素实现中,当我们计算 SxS 分数矩阵时,内存消耗会呈二次方增长。但 Flash Attention 通过迭代计算 (Q @ Kᵗ) @ V 的方式,将内存需求降低至线性复杂度 O(N)级别。
13
多 GPU 推理
你可能已经注意到,Llama 3.3 70B 的参数需要 141 GB 的存储空间,已经超出了单张 Nvidia H100 GPU 的显存容量。H100 配备的是 80GB 的 HBM 显存,因此至少需要两张卡才能将整个模型加载到内存中;但在实际应用中,我们通常还希望预留更多显存用于存放 KV 缓存。如果显存越多,就能为 KV 缓存分配更大比例的空间,较小空间用于模型权重,从而支持更大 batch 进行推理。同时,这也能将可用的内存带宽进行线性提升,不过也会带来跨 GPU 通信的额外计算开销。
如果仅使用两张 GPU 来部署 Llama 3.3 70B,那么用于 KV 缓存的显存会非常有限,这时模型权重已经占用了 88% 的显存(141 ÷ 160 = 88%),只剩下约 19GB(160 − 141 = 19GB)可用于 KV 缓存(由于通常最多只能使用约 95% 的 GPU 显存,实际可用的甚至更少)。这种配置下无法支持较大的 batch 或较长的序列长度,推理效率将会很低。我们在后文还会提到这一点,但提前说明:能否运行更大的 batch 是实现推理成本优化的关键。
此外,GPU 服务器几乎总是以每节点 4 块或 8 块 GPU 的方式部署,因此使用 3 张卡在很多场景下反而会造成一张 GPU 完全闲置,造成资源浪费。所以,在部署单模型实例时,我们通常会直接从 2 张卡跳到 4 张卡。
接下来我们假设用 4 张 H100 卡来运行 Llama 3.3 70B 模型。目前在多 GPU 上运行大型 AI 模型主要有两种方式:
流水并行(Pipeline parallel)
张量并行(Tensor parallel)
这两种方式在吞吐量与时延之间提供了不同的权衡。我们下面简单介绍一下这两种方案。
14
流水并行
在流水并行模式下,我们将模型按照“层(layer)”的维度进行划分,也就是说,每张 GPU 会承载模型中一部分的层。例如,对于 Llama 3.3 70B 模型,其包含 80 层隐藏层。如果使用 4 张 GPU 来进行推理部署,那么 GPU:0 将负责前 20 层,GPU:1 负责接下来的 20 层,依此类推。

图 12:流水并行配合连续批处理的可视化示意图。图源:https://docs.graphcore.ai/projects/tf-model-parallelism/en/latest/pipelining.html
这种方式的优点在于:设备之间的通信量非常小。一次前向传播中,我们只需将激活值从一张 GPU 传递到下一张 GPU,共进行 3 次广播即可。
此外,我们还可以进行流水处理:比如 GPU:0 处理第 0 个 batch 数据,并将结果传递给 GPU:1,随后第 1 个 batch 数据进入,GPU:0 可并行处理第 1 个 batch,而 GPU:1 同时处理第 0 个 batch,依此类推(见图 12)。这种设置能最大限度减少各个设备的空闲时间,从而实现最优吞吐量。但这也有代价:在某一时刻,每个 batch 只能使用 1/4 的计算资源和内存带宽,因此生成速度明显慢于同时使用所有 4 张 GPU 的情况。
在实际部署中,实现这种重叠批(batch)处理的高效协调是非常复杂的,因此本文后续将重点分析在实际中更为常见的张量并行设置。
15
张量并行
当前主流的大模型推理并行策略是张量并行,绝大多数 LLM 推理服务商采用的也是这种方式。在张量并行中,每一层神经网络都会被拆分到多张 GPU 上进行处理,从而充分利用所有设备的计算能力和内存带宽。这种方法能显著缩短每层的推理时间,但也带来了若干关键的权衡问题:
通信计算开销:在固定的节点(例如每个 Transformer block 内需同步两次),所有 GPU 之间必须执行跨设备同步,每次同步可能会带来显著时延(毫秒级)。该时延取决于互联技术(如 NVLink、PCIe 等)以及服务器的网络拓扑结构。
顺序批处理:不同于流水并行,张量并行要求所有 GPU 同时处理同一个 batch。在当前 batch 完成之前,无法开始下一个 batch 的处理。因此,在面对动态工作负载时,张量并行的吞吐效率会有所降低。
在实践中,最高效的并行策略是使用所谓的“列切分-行切分”线性层结构:先按列方向切分线性层,再按行方向切分下一层。这样的设计可以将同步次数压缩为每两个多层感知机(MLP)层只需同步一次,从而最大程度减少通信计算开销。
数学直觉:
以将权重矩阵 W₁ 沿列方向在两张 GPU 上进行切分为例:

每张 GPU 都可以独立计算自己的部分输出(无需通信):

这样计算出的隐藏层激活为:

由于每张 GPU 都拥有所需的全部必要的输入数据,因此这一阶段不需要通信。 接下来是将权重矩阵 W₂沿行方向切分:

每张 GPU 会计算出自己的部分结果:

最终输出需要进行一次 all-reduce 求和操作,也就是说,必须在设备之间进行一次同步:

这一列切-行切的布局方式可以应用到整个 Transformer block 中,从而将每个 Transformer block 中的同步操作次数减少到仅两次(见图 13 和图 14)。
自注意力:各个头(head)是独立处理的,仅在输出投影(
o_proj)时进行同步;MLP:上投影(
w1,w3)按列切分,下投影(w2)按行切分,只有在下投影之后才执行同步操作。

图 13:Transformer 层的列优先(Colwise)→ 行优先(Rowwise)布局示意图,来自 PyTorch 文档中的示例;来源:https://pytorch.org/tutorials/intermediate/TP_tutorial.html

图 14:Transformer block 中常见的列优先(Colwise)→ 行优先(Rowwise)划分结构示意。
准确估算通信所带来的额外计算开销是非常复杂的。理论上,我们需要考虑以下两个因素:
消息传递时延:通常在 3-5 微秒之间,具体取决于硬件;
数据传输时间:取决于互联带宽。
在理想场景中(使用现代 NVLink 连接),我们可以进行如下估算:

总计算开销控制在 8 或 9 微秒固然理想,但实际情况要复杂得多。在同步屏障(sync barrier)期间,计算图会被迫暂停。此时 GPU 会处于空闲状态,等待同步完成,这会带来一个几毫秒的固定计算开销。这种额外的“成本”是我们无法充分利用所有 GPU 上可用内存带宽的主要原因之一。准确建模这一计算开销相当具有挑战性。正如我们将在接下来的部分中展示的那样,理论性能与实际性能之间可能存在较大差距,因此需要通过实测来进行系统建模,从而获得更准确的结果。
16
批处理:实现经济效益的关键
如前所述,在逐词元生成阶段,我们主要受内存受限——也就是说,我们每秒能生成多少词元,主要取决于 GPU 从全局内存中加载模型权重的速度。每生成一个词元,都需要加载完整的模型。
为了优化推理成本,有一个显而易见的提升方法:运行更大的 batch。批处理本身就是一种天然的优化策略,我们只需加载一次模型权重,却可以在多个输入上同时进行推理(即在同一时间服务多个用户)。
增大 batch 规模可以线性提升计算利用率——虽然乘法运算量会增至原来的 k 倍,但所需内存带宽仅略微增加(仅用于加载 KV 缓存),因此这是提升计算强度的简便方法,尤其适用于我们原本受内存限制严重的算法(使其减少内存受限的影响)。由于 KV 缓存新增的内存开销远小于模型本身所需内存,其带来的额外负担很小,却能线性增加生成的词元数量:当 batch 扩大至 2 倍时,生成的词元量也翻倍;当 batch 扩大至 16 倍时,生成的词元量将提升 16 倍。
这也是本文的核心观点,也是我们最希望你能从中理解的关键直觉:随着 batch 规模的扩大,我们可以有效“摊薄”从高带宽内存(HBM)加载模型所耗费的时间——换句话说,模型加载成本可以在更多的客户请求之间进行分摊,从而实现规模经济、降低每个请求的单位成本。想要成功经营具有盈利能力的 LLM 推理服务,关键在于拥有足够的需求、持续执行大 batch 推理。如果无法支持大 batch 处理,单位词元的成本将迅速飙升,最终导致运营无法盈利。
*不过也需要注意,这种优化方式也有其极限。当我们使用非常长的序列或非常大的 batch 时(我们将在实验中看到),KV 缓存所占用的内存将逐步超过模型本身的内存占用(见图 15)。一旦出现这种情况,从全局内存加载数据的总时间中,加载模型的成本就会变得越来越微不足道。
“幸运”的是,这种情况本身也受限于硬件——也就是 GPU 节点的总内存限制。以 H100 为例,8 张卡的总内存上限为 8 × 80GB = 640GB。而当我们以最大上下文长度运行 Llama,batch 为 8 时,就已经几乎触碰到了这个限制。

图 15:KV 缓存扩展——不同 batch 规模的对比。注意 KV 缓存如何随 batch 规模呈线性增长。
17
吞吐量:理论 vs 实践
在经历了所有这些理论介绍之后,我们来尝试整合目前为止所学的内容,估算 LLM 的吞吐量。我们将会:
基于 GPU 的规格参数,构建一个理论性能模型;
将其与 Llama 3.3 70B 在 4 张 H100 显卡上的实际吞吐量进行对比;
解释理论性能与实际性能之间的差异。
生成一个回答所需的总时间由两部分组成:预填充时间和解码时间乘以解码词元数。生成的词元越多,预填充阶段所占的比例就越小。预填充时间主要受计算限制,而逐词元生成时间主要受内存限制。
由于预填充是高度计算受限的,我们可以通过将预填充期间的浮点运算总数除以所有 GPU 的有效 FLOPS 总和,再加上跨 GPU 通信的额外时延来估算时间。
解码时间主要受内存限制,但随着 batch 规模的扩大,计算部分会变得越来越重要。我们将计算两者,并取其中更主要的那个因素作为估算依据。此外,在这一阶段也会消耗一小部分通信时间。
这个简化的建模脚本正是基于以上的分析思路设计的。它以模型大小和结构为输入,结合硬件性能参数,来估算在特定硬件条件下应当可以达到的吞吐量表现。

我们用来估算吞吐量的简单脚本。
对于一个 Llama 3.3 70B 模型,输入为 2035 个词元,输出为 300 个词元时,我们可得到如下估算结果:

图 16:基于第一性原理估算的吞吐量。我们可以观察到前面所讨论的现象:随 batch 处理规模的扩大, KV 缓存所需加载的额外内存增多,而单个请求的处理速度则随之下降。
我们先来看一下不同 batch 规模下的模型性能估算。正如之前推导的那样,batch 规模是影响词元经济性的最关键指标。可以看到,吞吐量几乎随着 batch 规模线性增长(见图16)。这是你从这篇文章中应该获得的最重要的信息。LLM 推理是内存受限的,意味着我们希望将加载模型权重到内存的成本在尽可能多的请求之间分摊,良好的词元经济性的关键在于以较大的 batch 规模运行模型。当 KV 缓存大小接近模型大小时,总吞吐量的增长会逐渐减缓。
虽然总吞吐量随着 batch 规模扩大而提高,但每个请求的处理速度却在下降,且随着 batch 规模的扩大,KV 缓存内存占用增加而导致的速度下降趋势也加剧。在 batch 规模非常大的情况下,单次请求的体验会显著变差。这意味着即使我们能支持更大的 batch 规模,比如 DeepSeek 在 2025 年 2 月经历的庞大需求场景,我们也可能不愿意跑更大的 batch,这会导致每个用户的 词元生成速度会变得很慢。一般来说,OpenRouter 上你观察到的响应速度波动(见图17)很大程度上可以归因于当前的需求压力,即动态变化的 batch 规模。
这也是 batch API 便宜得多的原因之一。在对速度没有极高要求的场景下,LLM 服务提供商可以运行超大 batch,借助规模经济效应来压低成本——虽然每个请求的处理速度会比较慢,但整体利润却更高。当然,其中还有很多细节,比如不同并行策略的影响(比如流水并行的跨设备通信计算开销更小),但这些内容超出了本文的讨论范围。我们这里只是想通过一个现实例子说明:batch 规模对单个词元生成成本的影响是非常真实和巨大的。
现在我们来对比一下理论模型的估算结果与真实的 LLM 推理性能。我们使用 vLLM(一个流行的 LLM 部署框架)在 4 张通过 NVLink 互联的 H100 显卡上运行了 Llama 3.3 70B 模型。结果却有些令人失望。

图 18:我们在 Llama 3.3 70B(TP=4)上针对不同 batch 规模运行的基准测试结果。请注意,我们保持输入词元和输出词元数量固定。为了避免模型过早停止,我们使用了随机权重,并仅向模型中添加了 max_Tokens参数。

图 19:模型预测与实际情况对比。虽然趋势形状大致相似,但由于现实中的各种限制,具体数值存在差异。
虽然整体呈现出类似 S 形的趋势,但实际数值却有很大差异。在小 batch 规模下,我们达到了理论估算性能的大约 60%;而随着 batch 扩大,这一比例下降到约 40%。这种差异是从哪里来的呢?

图 20:随着 batch 规模的增加,理论吞吐量与实际测得吞吐量之间的差距也在不断扩大。
这正是 GPU 优化的核心难题——在实际操作中,准确估算 GPU 程序的实时(wall-time)性能是非常困难的。导致理论值与实际观测结果偏差的因素很多,层层叠加,让情况变得更加模糊。以下是一些很可能造成这一偏差的因素:
我们在模型中假设内存和算力都达到了 100% 利用率。然而,理论峰值性能指标(如 TFLOPS 和内存带宽)在实际中从未完全达成。由于以下原因,GPU 通常只能实现其理论计算能力的 50% 到 70%:
Kernel 启动计算开销和同步成本
内存访问模式无法与缓存架构完美对齐
执行线程束分歧以及其他 GPU 特有的低效现象
指令混合不利于充分利用所有 GPU 运算单元
……以及许多其他因素
如前文所述,我们假设跨设备通信带来的计算开销非常小,实际情况并非如此。实践中还存在很多其他因素,可能会增加额外时延,例如:
跨 GPU 通信时必须同步 CUDA 计算图
同步屏障机制导致所有 GPU 必须等待最慢的设备完成计算
内部缓冲区和管理开销
尤其在 batch 规模较大时,KV 缓存分散存储于 VRAM 的随机页中,导致潜在的非合并内存访问模式
以及一些在此不再赘述的其他因素
为简化 FLOPs 计算,我们假设了一种非常基础的注意力机制实现;但实际上,大家都会使用 Flash Attention 一类的优化算法。要准确估算其中涉及的计算时间和 FLOPs 是极其复杂且难以掌握的,超出了本文的讨论范围。
此外,还有 LLM 推理引擎实现中的额外计算开销,如分页注意力机制;
再加上使用 Python、PyTorch 和 vLLM 框架本身所引入的额外计算开销。
我们尝试在扩展模拟模型中对上述部分因素进行估算和涵盖,具体细节可在代码中查看:https://github.com/tugot17/llm-inference-economics-from-first-principles。但简要来说:我们假设计算和内存的利用率下降,引入了通信带来的额外时延,并考虑了诸如 batch 规模增大时内存额外开销呈指数增长等因素。

图 21:更新后的模型与实际表现对比。通过在模型中加入估算的额外计算开销,两条曲线现在更加接近。此次测试使用了 2000 个输入词元和 300 个输出词元。
虽然远非完美,但这种方法确实具有一定的实用性。它能较好地推广到其他规模的模型——例如在单张 GPU(TP1)上运行 Llama 3.1 8B 时同样适用。

图 22:我们的估算在其他规模模型上同样表现良好。以 Llama 3.1 8B 为例(输入 2000 词元/输出 300 词元),可见理论预估线与实际性能线基本吻合。
然而,当尝试使用不同的 batch 规模时,差异更加明显,说明该评估模型距离完美还有很大距离。例如,我们尝试估算长上下文模型的吞吐量表现,输入为 16000 词元,输出为 1000 词元。由于内存消耗过大,我们将 batch 规模限制为 8。在这种情况下,评估模型未能正确预测最终吞吐量,表明我们的评估模型远非完美。


图 23:遗憾的是,对于不同的输入/输出配置(本例为 16000 词元输入,2000 词元输出),评估模型的吞吐量预测准确度有所下降—— Llama 3.3 70B 的偏差尤为明显,而 Llama 3.1 8B 的误差相对较小。
我们希望通过本文让读者认识到:准确预测模型吞吐量的难度很大。同时,这也是理解 LLM 推理的关键要点之一。要准确预测吞吐量,需要进行一系列非常详细的性能分析步骤,例如:分析不同模型规模、batch 规模和提示长度组合下的内存访问模式;深入研究(分页)注意力机制的具体实现细节;批处理调度的实现细节;评估不同形状对计算和内存利用率的影响;以及进行数十个不同的实验。我们认为,要在不同设置下做到准确估计难度极大,甚至在实际中可能无法实现。如果你想要准确结果,最靠谱的方法还是直接测量真实的运行表现。
18
从词元到美元——经济性估算众所周知,各大 LLM 服务提供商都采用基于词元的计价模式:每百万输入词元和输出词元都有特定价格。有些服务商对输入输出词元采用统一定价,有些则区分定价。
我们目前的认知可总结如下:
预填充时间与序列长度呈二次方关系。随着输入规模增大,其在总请求处理时间中的占比将显著提升。
单个词元的生成时间随上下文长度线性增长。KV 缓存占全局内存数据读取量(含模型参数)的比重将逐渐增大。
由于生成单个词元的时间可以近似等效为从全局内存加载一次模型权重的开销,该时间与生成词元数量呈线性增长。
显然,根据上述分析可知:确定输入词元的合理市场价格绝非易事。输入增长会以二次方关系增加预填充成本,但在标准用例中,预填充仅占 GPU 处理请求总时间的较小部分。最终,根据 batch 规模、上下文长度与模型规模的比例关系,这些因素将共同影响系统吞吐量。

图 24:OpenRouter 平台上 Llama 3.3 70B 模型的输入与输出词元市场价格(https://openrouter.ai/meta-llama/llama-3.3-70b-instruct)
针对所有可能的输入输出配置给出一个通用的成本比例估算极其复杂,但对于具体的输入输出配置,成本估算则相对简单许多。我们只需:
测量实际执行时间
假设输入词元与输出词元成本之间存在固定比例
γ(例如取γ = 0.3)。选择这个特定γ值并无深层原因,只是需要设定某个基准值。通过求解以下方程计算单位词元成本
β:

举例来说,根据前文提到的某个实验实测数据:当输入 2035 个词元、输出 300 个词元、batch 规模为 16 时,运行时间为 8.96 秒。我们可以这样计算:

这相当于每百万输出词元成本约 1.72 美元,每百万输入词元成本约 0.51 美元。
基于前文实验数据,我们将相同计算方法应用于不同 batch 规模。如图所示,随着 batch 规模增大,价格出现了显著下降——读者应注意验证:该降幅与扩大 batch 规模带来的总吞吐量提升直接成正比。

表 1:不同 batch 规模下的每百万词元成本估算(输入 2035 词元/输出 300 词元)。根据本段所述方法进行定价估算。
显然,上述数据仅是针对单组输入输出词元配置的单一实验结果。若改变输入输出词元比例,结果将大不相同。要获得更真实的成本模型,可采用蒙特卡洛模拟方法:收集不同输入输出配置的多组数据点,逐例计算定价,剔除异常值(如外部因素导致的随机延迟),最终以样本中位数的平均值作为定价基准。
但该方法仍存在强假设局限。例如,我们只基准测试了“矩形”形状的输入——batch 中的所有元素输入词元数和输出词元数相同。我们没有将预填充阶段与解码阶段混合——所有元素形状相同,我们会同时提交整个 batch;预计预填充时间大致相同,随后仅执行解码阶段。这是一个强假设,现实中不一定成立。我们还硬编码了 γ 值,这对于我们将要服务的场景来说不一定公平合理,也不一定是最优解。
关于定价模型的讨论,我们先到此为止,希望在未来的文章中能深入探讨更复杂的定价策略。实际上有多种定价策略可供选择;另一个有趣的角度是,估算使推理过程实现盈利所需的最小用户数量。
幸运的是,最终可以很容易验证你是否盈利。只需将从用户输入和输出词元计费中获得的收益相加,再与租用 GPU 一小时的费用进行比较,看看收益是否超过成本即可。
19
结语
我们真诚希望本文能成为你构建 LLM 推理经济学精准认知的基石——我们以 Llama 3.3 70B 为范例,完整拆解了其运行机制。我们从最基础的模型参数讲起:解析 700 亿参数的本质含义及其内存占用规律,继而阐释计算性能与内存带宽的核心概念,厘清计算受限与内存受限的区别,并讲解了 FLOP 的概念,以及矩阵乘法中包含多少 FLOPs。
随后我们构建了两个关键阶段的认知框架:预填充阶段与逐词元生成阶段。通过逐层剖析前向传播的 FLOPs 分布,揭示预填充阶段何以成为计算受限任务,然后对比解析逐词元阶段的特性差异。引入 KV 缓存机制后,我们重走前向传播流程,演示该阶段如何通过 KV 缓存将计算需求降低 S 倍 ,从而转化为内存受限操作。随着上下文长度的增加,KV 缓存占内存读取时间的比重将持续攀升——我们通过数据可视化来清晰呈现这一演变规律。此外还简述了多 GPU 并行化策略带来的额外时延成本。
在此基础上,我们引入批处理这一核心概念。正因为内存受限,跑更大的 batch 能显著提升运营经济性——这正是全文最具实践价值的结论,也是我们希望读者铭记的关键洞见。最后,我们从第一性原理出发,建立了简化吞吐量模型,与 vLLM 实际运行 Llama 3.3 70B 的实测数据进行对比:既展示了理论预测与现实表现的差距,也解析了这些额外计算开销的来源。理论模型的显著偏差恰恰揭示了,仅靠经验法则预测实际性能将面临巨大挑战。
最后,我们讨论了在输入词元和输出词元之间建立定价机制及其公平定价比所面临的挑战。我们提出了一个简化的成本模型,尽管它并不完全准确,但能帮助你构建一个简单的启发式定价策略来为输入和输出词元定价。
读者应当认识到,使用多于最低需求数量的 GPU 实际上对推理的成本效益具有显著优势。更多的 GPU 能通过更高效的缓存机制提升性能,从而降低每个词元的单位成本。随着 GPU 数量的增加,相同的模型权重在每张卡上的内存占比会相对减少,从而腾出更多空间用于存放 KV 缓存,并支持更大的 batch 规模。由于吞吐量几乎随 batch 规模线性增长,这将直接带来更好的经济效益。此外,每增加一张 GPU,也为系统贡献了额外的内存带宽,这对于内存受限的逐词元生成阶段尤为重要,这也能进一步提升词元生成速度。
在评估用于 LLM 推理的硬件时,读者需要明白,内存容量并不是唯一重要的指标——内存带宽同样关键,甚至更为重要。由于逐词元生成阶段主要是内存受限,评估硬件时一定要关注的问题是:“内存带宽有多快?”这一点直接决定了模型的运行速度。例如,NVIDIA L40S GPU 虽然配备了 48GB 的显存,但其内存带宽仅为 864 GB/s(相比之下,H100 卡的带宽为 3350 GB/s),这导致推理速度非常缓慢。类似地,Apple 的 Mac Studio(搭载 M3 Ultra)虽然拥有高达 512GB 的统一内存,但其内存带宽仅为 819 GB/s(见图 25),尽管其内存容量巨大,但它在 LLM 推理方面的能力却因此受到限制。

图 25:Mac Studio 与 NVIDIA GPU 的内存性能对比。尽管 Mac 在参数上拥有较大的内存容量,但其内存速度远低于 NVIDIA GPU,这使得它在 LLM 推理任务中明显不具优势。
读者还应意识到,在边缘设备上运行模型,其每个词元的成本始终相对较高。当模型在消费级终端设备上运行时,batch 规模始终为 1,无法通过多个用户共享模型加载成本来实现规模经济。用户需独自承担设备和能耗的全部开销。再加上边缘设备通常在硬件性能和内存速度方面并不理想,这将使运行成本更加高昂,例如包含电费和硬件折旧等。
上述模型仅是冰山一角,我们并未涉及所有可能的优化方法,例如投机模型(speculation models)、硬件相关优化或量化技术等。本文的目标是帮助你建立关于 LLM 推理的一些基本直觉。我们希望你理解为什么推理过程分为两个阶段、为何一个阶段是计算受限、另一个阶段是内存受限,并对输入词元数、输出词元数与请求处理时间之间的关系形成一定的直觉认知。
如需复现相关实验,请参阅:https://github.com/tugot17/llm-inference-economics-from-first-principles
其他人都在看

让超级产品开发者实现“Token自由”
邀好友用SiliconCloud,狂送2000万Token/人
即刻体验DeepSeek R1
cloud.siliconflow.cn
扫码加入用户交流群

 738


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


