数据预处理之定量特征二值化与定性特征哑变量编码

【机器学习-09】特征工程 特征工程是机器学习模型构建的初步工作,但它的重要性却贯穿整个模型生命周期。在进行特征工程时,我们需要充分利用数据科学的知识和技巧,结合具体的应用场景和业务需求,来制定出最合适的特征提取和转换策略。只有这样,我们才能为机器学习模型提供最有价值的输入,从而使其发挥出最大的潜力。总之,特征工程是机器学习中的一项关键任务,它需要我们用心去探索、去实践、去创新。只有不断地优化和完善特征工程的过程,我们才能构建出更加准确、更加可靠的机器学习模型,为实际应用带来更大的价值。 阅读详情

   1. 定量特征二值化   

   在数据挖掘领域,定量特征二值化的目的是为了对定量的特征进行“好与坏”的划分,以剔除冗余信息。举个例子,银行对5名客户的征信进行打分,分别为50,60,70,80,90。现在,我们不在乎一个人的征信多少分,只在乎他的征信好与坏(如大于90为好,低于90就不好);再比如学生成绩,大于60及格,小于60就不及格。这种“好与坏”、“及格与不及格”的关系可以转化为0-1变量,这就是二值化。变化方式如下所示:
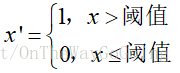
                         

from sklearn.preprocessing import Binarizer
#阈值设置为3,对x的每一个元素都进行二值化
Binarizer(threshold=3).fit_transform(x)      

         2. 定性特征哑编码

   

Verilator+VSCode实战:5分钟搞定Verilog语法检查与波形调试 本文详细介绍了如何将Verilator仿真器与VSCode编辑器高效集成,打造极速的Verilog开发工作流。通过环境配置、实时语法检查、一键仿真与波形生成等实战技巧,帮助IC设计工程师在几分钟内完成从代码编写到波形调试的全过程,大幅提升中小规模模块的验证效率。 阅读详情

相关推荐

三维重建之条纹投影结构光(三)——相位展开优化与多频外差实践

本文深入探讨了三维重建中条纹投影结构光技术的核心环节——相位展开优化。针对传统路径跟踪法存在的误差传播与路径依赖问题,重点解析了多频外差法的原理与优势,并通过详细的C++代码实践,展示了如何利用三频外差法实现鲁棒、高精度的相位展开,从而获得连续的绝对相位图,为后续三维点云生成奠定坚实基础。

weixin_29074295的博客 531

特征工程大满贯(一)

特征工程的流程以及详细步骤

xia_mi123的专栏 778

AES128加密算法开发(含源码)

本文详解了AES128加密算法的原理与C语言实现。AES128是当前广泛使用的对称加密标准,采用128位密钥和10轮变换,具有高安全性和高效性。文章从算法背景、核心概念(混淆与扩散)入手,详细解析了4×4状态矩阵表示、4个核心变换(字节替换、行移位、列混合、轮密钥加)以及密钥扩展过程。特别针对汽车电子应用场景,如ECU通信加密、车钥匙认证等,说明了AES128在资源受限环境中的优势。通过分步图解和原理剖析,帮助开发者深入理解这一加密标准的技术细节与实现方法。

汽车电子软件开发笔记 2918

特征工程——七大特征处理的方法

以下举例采用的数据集为sklearn中自带的数据,因此在此提前进行读取数据,具体代码如下: # 导入包 from sklearn.datasets import load_iris # 获得数据 iris = load_iris() iris.data 运行结果如下:(因为数据过大,因此在此处只进行部分展示) 1. 标准化 标准化是依照特征矩阵的列处理数据,即通过求标准分数的方法,将特征转换为标准正态分布,并和整体样本分布相关。每一个样本点都能对标准化产生影响。 标准化需要...

qq_51167531的博客 5847

WhatsApp协议算法

我想其实有很多人还不太了WhatsApp群控,简单来说,它和我们常使用的微信聊天软件是类似的,只不过它是基于通讯录的,操作起来比较简单便捷,所以现在有很多国家都喜欢用WhatsApp。一般情况下,筛号不会造成账号被封的情况,但是呢,如果筛号的频率太快,就会被系统限制筛号能力,不再返回筛号结果,所以,筛号数量和速度一定要控制好。前天逛街突然灵光一现,为什么不试试多路访问呢,简单来说就是信道复用技术,马上跑回家,调取接口,接入通道,导入已经转换成协议的账号,成功登录!

2403_87755661的博客 1943

UFS逻辑单元管理

介绍UFS 逻辑单元管理和配置

m0_51720747的博客 1947

特征工程

文章目录1.特征工程2.数据预处理2.1 无量纲化2.2 对定量特征二值化2.3 对定性特征哑编码2.4 缺失值计算2.5 数据变换3.特征选择3.1 Filter3.2 Wrapper3.3 Embedded4 降维4.1 主成分分析法(PCA)4.2 线性判别分析法(LDA) 1.特征工程 数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已 sklearn中的IRIS(鸢尾花)...

倩mys的博客 544

从CAD到Web:高效转换STEP/IGES模型为GLB格式的实践指南

本文详细介绍了如何将工业设计中的STEP/IGES模型高效转换为Web友好的GLB格式。通过PythonOCC和gltf-pipeline等工具链,实现从CAD到Web的无缝转换,大幅提升模型加载速度和展示效果。文章包含实战案例、优化技巧和常见问题解决方案,帮助开发者快速掌握3D模型转换技术。

weixin_29072299的博客 507

数据预处理(三)数据变换

文章目录数据变换一、特征二值化二、特征归一化(一)、总和标准化(二)、标准差标准化(三)、极大值标准化(四)、极差标准化(区间放缩法,0-1标准化)三、连续特征变换四、定性特征哑编码:One-hot编码 数据变换 数据变换即对数据进行规范化处理,以便于后续的信息挖掘。常见的数据变换包括:特征二值化、特征归一化、连续特征变化,定性特征哑编码等。 一、特征二值化 特征二值化的核心在于设定一个阈值,将特...

Dream come ture~ 2万+

操作系统 | 知识梳理 | 复习(上)

操作系统复习

知识库搭建ing 3476

【python数据挖掘课程】二十八.基于LDA和pyLDAvis的主题挖掘及可视化分析

这是《Python数据挖掘课程》系列文章,前面很多文章都讲解了数据挖掘、机器学习,这篇文章主要讲解LDA和pyLDAvis算法,同时讲解如何读取CSV文本内容进行主题挖掘及可视化展示。文章比较基础,希望对你有所帮助,提供些思路,也是自己教学的内容。推荐大家购买作者新书《Python网络数据爬取及分析从入门到精通(分析篇)》,如果文章中存在错误或不足之处,还请海涵。 目录: 一.显示结果及安装 二.LDA主题挖掘 三.pyLDAvis可视化分析 四.小结

杨秀璋的专栏 1万+

Python数据预处理-数据标准化(归一化)及数据特征转换

一、数据标准化(归一化) 首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运算)。...

Trisyp的博客 2万+

直流无刷电机FOC控制算法 理论到实践 —— 实践

关于直流无刷电机FOC控制算法的理论章节,本人已经在前两章进行过详细说明,大家可以自行进行阅读,请务必了解过理论之后再来学习如何具体进行实现。直流无刷电机FOC控制算法 理论到实践 —— 理论(一)直流无刷电机FOC控制算法 理论到实践 —— 理论(二)本章节主要讨论采用MCU微控制器如何具体实现直流无刷电机的FOC控制。

爱出名的狗腿子 1万+

python机器学习之特征处理

☀️前面我们讲述了对数据建模之前需要对数据进行数据探索,探索完之后应该干些啥?没错,接下来就是特征工程!对数据探索感兴趣的同学可以查看下面的文章????: python机器学习之特征工程: python机器学习之数据探索. ????今天我们要学习的内容是特征工程,特征工程的好坏决定了机器学习的上限!特征工程是从原始数据提取特征的过程,这些特征可以很好地描述数据,并利用特征建立的模型在未知数据上的性能表现达到最优,特征工程主要包括特征使用、特征获取、特征处理、特征选择和特征监控。 类 功能 说明

柳小葱的博客 2355

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

【机器学习之特征工程】数据预处理、特征选择、降维及不平衡处理

什么是特征工程?特征工程解决了什么问题?为什么特征工程对机器学习那么重要?怎么做好特征工程?带着这些问题,我们来看本文的内容。首先,以我的理解回答以上的问题,好让读者有个初步印象,后面,我将通过详细讲解和代码(Sklearn实现)带来直观的感受。特征工程(Feature Engineering)是将原始的数据转换为更好的表达问题本质特征的过程,使得这些特征运用到模型中能提高对不可见的数据的模型预测精度。目的是分解或和并数据,以便更好地表达问题的本质,提高模型的准确度。

qq_43018832的博客 7763

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

使用sklearn - 特征工程

特征处理是特征工程的核心,sklearn提供了较为完整的特征处理方法! 本文中使用sklearn中的IRIS数据集来对特征处理功能进行说明。IRIS包含4个特征(Sepal.Length(花萼长度)、Sepal.Width(花萼宽度)、Petal.Length(花瓣长度)、Petal.Width(花瓣宽度)),特征值都为正浮点数,单位为厘米。目标值为鸢尾花的分类(Iris Setosa(山鸢尾)...

令狐公子的博客 530

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

dataframe数据标准化处理_Python数据预处理——数据标准化(归一化)及数据特征转换...

一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运...

weixin_33249666的博客 3387

python 分类算法的数据要归一化嘛_Python数据预处理——数据标准化(归一化)及数据特征转换...

1. 极值法(区间缩放法)线性比例变换法:正向指标:y = (x)/(max),即新数据=(原数据)/(最大值)。负向指标:y = (min)/(x),即新数据=(最小值)/(原数据)。极差变换法:正向指标:y = (x- min)/(max - min),即新数据=(原数据-最小值)/(最大值-最小值)。 负向指标:y = (max - x)/(max - min),即新数据=(最大值-原数据)...

weixin_35733495的博客 1162

python实现归一化去噪_Python数据预处理——数据标准化(归一化)及数据特征转换...

一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运算)。它是...

weixin_39930557的博客 1319

【机器学习竞赛+笔记干货】工业蒸汽量预测:特征工程篇(三)

映射函数直接将不重要的特征删除,不过这样会造成特征信息的丢失,不利于模型精度。数据分析以抓住主要影响因子为主,变量越少越有利于分析。特征选择常用于统计分析模型中,以及超高维数据分析或者建模预处理中,例如基因序列建模。

U202113837的博客 789

python数据获取及预处理_Python数据预处理——数据标准化(归一化)及数据特征转换...

原标题:Python数据预处理——数据标准化(归一化)及数据特征转换一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可...

weixin_39733812的博客 241

python数据标准差化_Python数据预处理——数据标准化(归一化)及数据特征转换...

一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运算)。它是...

weixin_39746652的博客 1364

最大最小标准化 数值_Python数据预处理——数据标准化(归一化)及数据特征转换...

一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运...

weixin_36269396的博客 5747

python数据平滑处理_Python数据预处理——数据标准化(归一化)及数据特征转换...

一、数据标准化(归一化)首先,数据标准化处理主要包括数据同趋化处理(中心化处理)和无量纲化处理。同趋化处理主要解决不同性质数据问题,对不同性质指标直接加总不能正确反映不同作用力的综合结果,须先考虑改变逆指标数据性质,使所有指标对测评方案的作用力同趋化,再加总才能得出正确结果。无量纲化处理主要为了消除不同指标量纲的影响,解决数据的可比性,防止原始特征中量纲差异影响距离运算(比如欧氏距离的运...

weixin_39927144的博客 1212

使用 sklearn 的特征工程

使用 sklearn 的特征工程的方法,包括:数据预处理、特征处理、特征选择、降维等

airhaohan 的博客 877

一般数据挖掘流程

1.业务需求 2.数据分析 3.数据处理 4.模型搭建 5.模型评估 1.业务需求 业务背景 业务目标 业务问题关键点(痛点) 数据口径与维度 目标产出内容 2.数据分析 基本分析方法:数据分布、数据对比、数据象限、数据相关性、数据辨别分析、数据结构化拆分等; 统计基本信息:最大最小值、中位数、分位数、均值等; 基本统计检验:T检验、F检验、卡方检验、Z检验、非参检验。 单个特征可视化: 对单个特征以及目标特征的各个取值情况做计数,绘制分布图(离散变量:条形图;连续变量:概率分

afk110的博客 1107
上一篇: 数据预处理之数据无量纲化(标准化/归一化)
小方哥哥
博客等级 码龄10年 47粉丝 4原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值