企业舆情监控实战:基于MEDIACRAWLER的解决方案

从0到1构建企业级Python舆情监控系统:爬虫、存储与分析全链路实践 爬虫层:分布式+反反爬是保障数据采集稳定性的核心,增量爬取可大幅降低资源消耗;存储层:分层存储(Redis+MongoDB+MySQL)兼顾性能与灵活性,索引设计是查询效率的关键;分析层:基础算法(TF-IDF、SnowNLP)满足大部分企业需求,自定义词典可显著提升分析准确率。企业级Python舆情监控系统核心是“采集-存储-分析”全链路设计,需兼顾高可用、可扩展、高性能三大原则; 阅读详情

快速体验

  1. 打开 InsCode(快马)平台 https://www.inscode.net
  2. 输入框内输入如下内容:
构建一个企业舆情监控系统,能够同时爬取20个主流新闻网站和社交媒体平台。系统需要实现:1) 关键词监控(可配置多个关键词组合);2) 情感分析(正面/负面/中性);3) 热点话题识别;4) 自动生成日报;5) 紧急预警功能(当发现负面报道时发送邮件通知)。要求前端展示仪表盘,后端使用Flask框架,数据存储使用Elasticsearch以便全文检索。请使用DeepSeek模型生成完整解决方案。
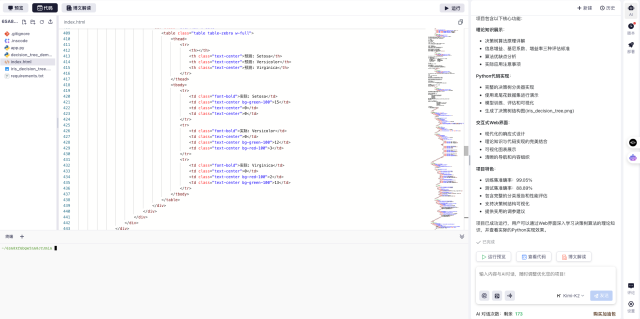
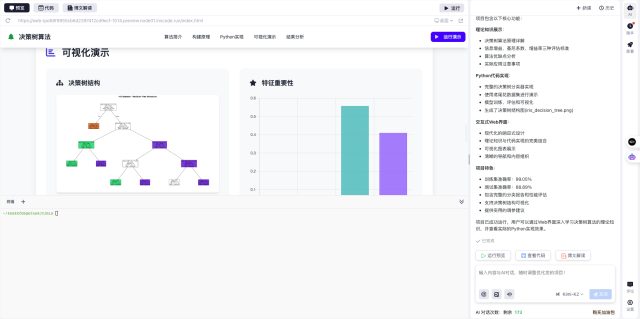
  1. 点击'项目生成'按钮,等待项目生成完整后预览效果

示例图片

今天想和大家分享一个企业舆情监控系统的实战案例。这个项目最初是为了帮一家电商公司解决竞品追踪和负面舆情预警的需求,经过几轮迭代,现在已经发展成一个功能完善的企业级解决方案。
示例图片

  1. 系统架构设计 整个系统采用前后端分离架构。前端用Vue.js构建可视化仪表盘,后端用Flask提供API服务,数据存储选择了Elasticsearch,主要考虑到它对全文检索的支持非常好。爬虫部分用Scrapy框架实现,可以同时抓取20多个主流媒体平台。

  2. 核心功能实现

  3. 关键词监控:支持多关键词组合配置,比如"品牌名+质量问题"这样的组合查询
  4. 情感分析:基于预训练模型对抓取内容进行情感打分(正面/负面/中性)
  5. 热点识别:通过TF-IDF算法提取高频词,结合时间维度分析话题热度
  6. 日报生成:每天8点自动汇总前24小时的关键数据
  7. 预警机制:当检测到负面内容超过阈值时,立即触发邮件通知

  8. 技术难点突破 最大的挑战是处理不同网站的反爬机制。我们最终采用的方案是:

  9. 动态User-Agent轮换
  10. 请求频率智能控制
  11. 结合Selenium处理动态加载内容
  12. 使用代理IP池

  13. 数据处理流程 抓取到的数据会经过以下处理环节:

  14. 去重清洗
  15. 正文提取(去除广告等噪音)
  16. 情感分析
  17. 关键词标记
  18. 存入Elasticsearch索引

示例图片

  1. 实际应用效果 系统上线后,客户反馈:
  2. 负面舆情响应时间从平均6小时缩短到30分钟内
  3. 竞品动态监控效率提升80%
  4. 日报生成节省了2个人力/天
  5. 通过热点分析发现了3个潜在市场机会

  6. 优化方向 未来计划加入:

  7. 多语言支持
  8. 舆情传播路径分析
  9. 自动化报告定制功能
  10. 移动端预警推送

这个项目让我深刻体会到,一个好的舆情系统不仅要技术过硬,更要理解业务需求。比如最初我们只做了负面预警,后来客户提出需要竞品对比功能,这就需要在数据建模时考虑更多维度。

示例图片

整个开发过程中,InsCode(快马)平台帮了大忙。它的在线编辑器可以直接调试爬虫脚本,部署功能更是省去了配置环境的麻烦。最让我惊喜的是AI辅助功能,遇到技术问题时能快速得到解决方案建议。对于需要快速验证想法的项目,这种一站式开发体验真的很高效。

快速体验

  1. 打开 InsCode(快马)平台 https://www.inscode.net
  2. 输入框内输入如下内容:
构建一个企业舆情监控系统,能够同时爬取20个主流新闻网站和社交媒体平台。系统需要实现:1) 关键词监控(可配置多个关键词组合);2) 情感分析(正面/负面/中性);3) 热点话题识别;4) 自动生成日报;5) 紧急预警功能(当发现负面报道时发送邮件通知)。要求前端展示仪表盘,后端使用Flask框架,数据存储使用Elasticsearch以便全文检索。请使用DeepSeek模型生成完整解决方案。
  1. 点击'项目生成'按钮,等待项目生成完整后预览效果
SGLang:结构化生成语言推理框架深度解读 SGLang是由斯坦福大学和加州大学伯克利分校联合提出的高性能大语言模型推理框架,针对复杂多轮对话、结构化输出等场景优化。其核心创新包括: RadixAttention机制:通过基数树数据结构实现跨请求的KV Cache自动复用,避免重复计算共享前缀 跳跃前瞻解码:对格式化输出中的固定模板部分直接填充,仅采样变量槽位,提升3-5倍生成速度 约束解码引擎:通过正则表达式和JSON Schema保证输出严格符合预定义格式 声明式DSL:提供类Python的编程接口简化复杂推理流程开发 相比传统框架,SGLang 阅读详情

相关推荐

Gem5模拟器,详解官网教程Event-driven programming(五)

Gem5模拟器,详解官网教程Event-driven programming、时间调度、如何自定义SimObject

qq_46675545的博客 2040

舆情监测系统选型与技术落地:Infoseek 字节探索全栈架构解析与实战

2026 年的舆情监测行业,已进入 “算法对抗” 的时代,传统的 “关键词匹配 + 文本分析” 工具已完全无法满足企业需求,技术选型的核心是考察系统的 “多模态采集能力、意图级研判能力、合规化处置能力、场景化适配能力”。Infoseek 字节探索通过 “数据采集 - 智能分析 - 合规处置 - 数据应用” 的全栈技术架构,基于 DeepSeek 大模型实现了舆情监测全链路的技术升级,解决了传统工具 “抓不全、分析不准、处置慢、不合规” 的核心痛点。

weixin_64776994的博客 741

Windows 10/11 零基础配置 SillyTavern 连接 Claude API 完整指南(含 Node.js 环境搭建)

本文提供Windows 10/11系统下零基础配置SillyTavern连接Claude API的完整教程,涵盖Node.js环境搭建、SillyTavern初始化及API连接配置等关键步骤。通过详细的操作指南和实用技巧,帮助用户快速搭建AI聊天界面并优化对话体验,实现与Claude AI的高效交互。

weixin_30642561的博客 134

【毕业设计】基于python的新媒体网络舆情数据爬取与分析python基于大数据分析的社交媒体舆情监测与分析(源码+文档+远程调试,全bao定制等)

【毕业设计】基于python的新媒体网络舆情数据爬取与分析python基于大数据分析的社交媒体舆情监测与分析(源码+文档+远程调试,全bao定制等)

程序猿的博客 896

5个实战必备的多模态情感分析数据集(附下载链接与避坑指南)

本文精选了5个实战必备的多模态情感分析数据集,包括CMU-MOSEI、CH-SIMS、UR-FUNNY、MUStARD和IEMOCAP,并提供了详细的下载链接与避坑指南。文章重点介绍了如何高效获取、预处理这些数据集,并自然整合了多模态情感分析的核心热词,旨在帮助研究者和开发者快速启动项目,规避常见陷阱,聚焦模型创新。

yolo5detector的博客 280

MacBook用户必看:用Homebrew一键搞定frp内网穿透(含阿里云配置模板)

本文为MacBook用户提供基于Homebrew的frp内网穿透实战指南,详细介绍了从环境准备到阿里云服务器配置的全过程。通过Homebrew一键安装frp客户端,结合阿里云配置模板,实现高效稳定的内网穿透,适用于远程开发、IoT设备调试等多种场景。

weixin_28692817的博客 321

Infoseek 舆情系统技术架构深度解析:基于 AI 大模型的全链路智能舆情解决方案

Infoseek 字节探索舆情系统通过 “分布式采集 + AI 大模型 + 全链路闭环” 的技术架构,彻底解决了传统舆情系统 “监测不全、研判不准、处置低效” 的核心痛点。其开放的 API 与 SDK 支持灵活的二次开发,适配不同行业的定制化需求,技术团队可基于本文提供的教程快速集成与落地,实现从 “被动应对舆情” 到 “主动管理舆情” 的转型。

weixin_64776994的博客 1199

MPC模型预测控制实战:从理论到代码实现(Python示例)

本文详细介绍了MPC模型预测控制的实战应用,从理论到Python代码实现。通过构建系统模型、预测方程、优化问题及约束处理,展示了如何实现一个完整的MPC控制器。文章还提供了水箱液位控制的应用案例,帮助读者掌握MPC在工业控制中的实际应用。

weixin_42653691的博客 460

【实时舆情预警系统开发】:基于Python+Redis+Flask的高效架构设计

构建高效舆情监控Python系统,实现实时预警与分析。适用于社交媒体、新闻平台等场景,结合Redis缓存与Flask接口,提升响应速度。支持关键词过滤、情感分析与数据可视化,助力企业快速应对舆论风险,值得收藏。

CodeNexus的博客 741

BACnet协议栈基本对象BI、BO、AI、AO、AV以及device和File对象介绍

BACnet协议栈基本对象BI、BO、AI、AO、AV以及device和File对象介绍

shufawangzhang的博客 3988

系统安全性评估 (SSA) 详细解析

系统安全性评估(SSA)是一种自下而上的验证过程,目的是确保系统设计中的每个功能、子系统、硬件和软件的实现,符合早期通过 FHA 和 PSSA 设定的安全性需求。它通过对已实现的系统进行系统性综合评价,检验各项设计和安装是否符合预期的安全性目标,最终支持飞机的适航认证。飞行控制系统是飞机安全性设计的核心子系统之一,负责控制飞机的姿态和方向。为了确保飞行控制系统能够在各种飞行条件下保持安全运行,SSA 被用于验证该系统的设计是否满足 FHA 中设定的安全性目标。

qq_41854911的博客 1651

Mediacrawler实战:构建企业舆情监控系统

数据去重很关键:不同平台经常会出现内容雷同的报道,需要设计智能去重算法,我们最终采用标题相似度+正文指纹的方式,准确率达到92%情感分析需要定制:通用情感词典在专业领域效果不佳,我们通过标注5000条行业语料重新训练了分析模型性能优化技巧:将热点数据存入Redis缓存,使管理面板的加载速度从8秒降到1秒内权限管理不可忽视:系统设置了严格的权限分级,普通员工只能查看公开报告,敏感数据需要总监级以上权限。

YellowSun24的博客 451

harbor x509: certificate signed by unknown authority【20251222】

本教程通过「合并证书链(服务器端)+ 预置根 CA(客户端)」彻底解决了自签名证书的 x509 错误,同时集成了 Trivy 漏洞扫描,实现了 Harbor 从搭建到实用的全流程。证书链合并是服务器端的关键,确保客户端获取完整信任路径;客户端需同时配置「系统信任库 + Docker 信任目录」,避免 Docker 独立信任机制导致的问题;所有 IP 需保持一致(Harbor 配置、证书绑定、客户端访问),是避免错误的基础。

老韩的Linux云计算架构师进阶之路 681

如何高效使用MediaCrawler:5个实战场景完整指南

MediaCrawler是一款功能强大的多平台自媒体数据采集工具,专门针对小红书、抖音、快手、B站、微博、贴吧、知乎等主流社交平台的公开信息抓取需求设计。这款专业的数据采集框架能够高效采集笔记内容、视频信息、用户评论和互动数据,为市场调研、内容分析和竞品监控提供可靠的数据支持。 ## 项目定位与价值主张 MediaCrawler作为专业的自媒体数据采集器,采用基于Playwright浏览器自动

gitblog_01110的博客 466

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

MediaCrawler终极指南:15分钟搭建全平台媒体数据采集系统

MediaCrawler是一款开源的多平台媒体数据采集工具,能够一站式采集小红书、抖音、快手、B站、微博五大平台的视频、图片、评论、点赞等数据。作为技术探索者,笔者在实际部署中发现,这款工具通过模块化设计和智能反爬机制,让普通用户也能轻松构建专业级数据采集系统。 ## 🚀 快速入门:零代码5步启动数据采集 对于新手用户来说,最关心的就是如何快速上手。MediaCrawler的设计理念就是"零

gitblog_01089的博客 729

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

MediaCrawler企业级实战指南:构建自动化多平台数据采集管道

在当今数据驱动的商业环境中,社交媒体数据已成为企业决策、市场分析和用户洞察的核心资源。MediaCrawler作为一款开源的多平台数据采集工具,通过创新的浏览器自动化技术,为开发者提供了一套免逆向加密、高可配置的企业级数据采集解决方案。本文将从技术架构、实战配置到性能优化,全方位解析如何利用MediaCrawler构建稳定可靠的数据采集管道。 ## 技术架构深度解析 MediaCrawler采

gitblog_00487的博客 505

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

MediaCrawler实战指南:5步构建企业级社交数据采集系统

在数据驱动决策的时代,获取高质量的社交媒体数据已成为市场分析、用户研究和竞争情报的关键。然而,面对各大平台日益严格的反爬机制,传统爬虫工具往往力不从心。MediaCrawler作为一款开源的多平台数据采集工具,巧妙解决了这一痛点,让开发者能够轻松获取小红书、抖音、快手、B站、微博等主流社交平台的结构化数据。 ## 核心优势:为什么选择MediaCrawler? MediaCrawler采用创新

gitblog_00941的博客 445

如何高效搭建企业级社交媒体数据采集系统:MediaCrawler实战指南

MediaCrawler是一个功能强大的开源爬虫项目,专门用于自动化抓取小红书、抖音、快手、B站、微博等主流社交平台的数据。这款社交媒体数据抓取工具为数据分析师、研究人员和开发者提供了完整的多平台爬虫解决方案,通过Playwright浏览器自动化和智能代理IP管理,实现了高效稳定的数据采集。 ## 社交媒体数据采集的核心挑战与解决方案 在构建社交媒体数据采集系统时,开发者和数据分析师面临三大核

gitblog_00870的博客 742

MediaCrawler终极指南:5分钟构建企业级社交媒体数据采集系统

在数据驱动的时代,**社交媒体数据采集**已成为市场洞察和业务决策的关键。然而,面对各大平台的**反爬虫技术**和**数据加密**,传统爬虫开发陷入困境。MediaCrawler通过创新的技术方案,让开发者能够快速构建**多平台数据采集**系统,无需逆向复杂的加密算法。 ## 🔥 行业痛点:为什么传统爬虫方案已失效? ### 传统爬虫面临的三大挑战 | 挑战类型 | 传统方案 | 面临问题

gitblog_00202的博客 392

MediaCrawler技术深度解析:企业级多平台数据采集框架与实战应用

在当今数据驱动的互联网时代,新媒体平台数据采集已成为市场分析、舆情监控、内容研究等领域的核心技术需求。然而,面对小红书、抖音、B站等主流平台复杂的反爬机制和动态加密技术,传统爬虫方案往往陷入技术瓶颈。MediaCrawler作为一款开源的多平台数据采集框架,通过创新的"浏览器搭桥"技术,为开发者提供了企业级的数据采集解决方案,实现了对五大主流社交平台的全面覆盖和高效采集。 ## 核心架构解析:模

gitblog_00908的博客 1053

7大自媒体平台数据采集实战指南:用MediaCrawler轻松获取小红书、抖音、B站等社交媒体数据

你是否曾为收集社交媒体数据而烦恼?面对小红书、抖音、B站等平台的海量内容,手动收集数据既耗时又低效。MediaCrawler正是为解决这一痛点而生——这是一款功能强大的开源自媒体数据采集工具,能够帮助数据分析师、内容运营人员和开发者轻松获取七大主流社交平台的公开信息,为市场调研、竞品分析和内容策略提供可靠的数据支撑。 ## 数据采集的三大核心挑战与解决方案 ### 挑战一:多平台数据格式不统一

gitblog_00288的博客 535

终极自媒体数据采集指南:用MediaCrawler轻松获取7大平台公开数据

你是否经常需要从各大自媒体平台收集数据却苦于技术门槛太高?面对小红书、抖音、B站等平台的复杂反爬机制,传统爬虫工具往往难以应对。MediaCrawler正是为解决这一痛点而生——这是一款功能强大的多平台自媒体数据采集工具,能够轻松获取小红书、抖音、快手、B站、微博、贴吧、知乎等7大主流平台的公开信息。 ## 为什么你需要MediaCrawler? ### 传统数据收集的三大痛点 1. **技

gitblog_00879的博客 390

MediaCrawler:5大社交平台数据采集终极指南(2024企业级实战)

**MediaCrawler** 是一款功能强大的多平台社交媒体数据采集工具,专为市场分析师、内容运营者和研究人员设计,能够高效采集小红书、抖音、快手、B站、微博五大主流平台的内容数据。这个开源项目通过智能化的反爬策略和灵活的数据存储方案,帮助企业用户突破数据孤岛,实现跨平台数据整合与分析。 ## 为什么企业需要多平台数据采集?🤔 在当今数字化营销时代,品牌和企业在多个社交平台同时运营已成为

gitblog_01005的博客 827

5分钟解锁MediaCrawler:轻松采集五大主流社交平台数据

你是否曾经为了获取小红书、抖音、B站等平台的数据而苦恼?手动复制粘贴效率低下,而专业的爬虫工具又太过复杂难学?MediaCrawler正是为解决这一痛点而生的Python爬虫框架,它让你无需深入复杂的JavaScript逆向工程,就能轻松采集五大主流社交媒体的完整数据。 ## 🎯 为什么你需要MediaCrawler? 在当今数据驱动的时代,社交媒体数据已成为市场分析、内容创作、学术研究等领

gitblog_01014的博客 948

如何快速掌握MediaCrawler:自媒体数据采集的终极实战指南

在当今内容为王的数字时代,获取高质量的自媒体数据已成为市场分析、竞品研究和内容创作的关键环节。MediaCrawler作为一款开源的多平台数据采集工具,为技术爱好者和内容从业者提供了一套完整的数据采集解决方案。这个强大的爬虫工具支持小红书、抖音、快手、B站、微博、贴吧、知乎七大主流平台,能够高效采集笔记内容、视频信息、用户评论和互动数据,为各类数据分析项目提供可靠的数据支持。 ## 为什么选择M

gitblog_00842的博客 342

MediaCrawler终极指南:一站式搞定主流媒体平台数据采集

MediaCrawler是一款功能强大的一站式媒体数据采集工具,支持小红书、抖音、快手、B站、微博、百度贴吧和知乎等主流平台的内容与评论爬取。无论是市场调研、数据分析还是个人学习,这款工具都能帮助你轻松获取所需的媒体数据。 ## 🚀 核心功能亮点 MediaCrawler Pro版本带来了多项高级特性,让数据采集变得更加高效和稳定。其核心优势包括断点续爬功能,确保在网络中断或程序意外停止后能

gitblog_00029的博客 1405
上一篇: AI如何简化内网穿透配置?快马平台一键生成方案
下一篇: 企业级解决方案:搭建内部Postman版本仓库
ObsidianRaven13
博客等级 码龄2年 620粉丝 4094原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

ObsidianRaven13

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值