双塔异构神经网络:互补特征融合的实战探索

双塔模型(Two-Tower Model)推荐系统实践 双塔模型是一种高效的深度学习架构,广泛应用于推荐系统、搜索排序和语义匹配等场景。该模型由用户塔和物品塔两个独立神经网络组成,分别处理对应特征后通过相似度计算得出匹配分数。模型支持Pointwise、Pairwise和Listwise三种训练方法,具有高效检索、灵活部署等优势,但也存在特征交叉不足的局限性。Rust语言凭借高性能特性,适合实现双塔模型的核心计算逻辑。改进方向包括引入多塔结构、强化负采样策略等,以提升模型在细粒度特征捕捉和大规模应用中的表现。 阅读详情

双塔异构神经网络:互补特征融合的实战探索

在深度学习模型设计中,经常面临一个核心矛盾:模型复杂度与泛化能力的平衡。单一架构往往难以同时捕捉数据的不同模式——深层网络擅长提取抽象语义,而带有正则化的网络更关注鲁棒性特征。本文介绍一种双塔异构融合架构,通过两个结构差异显著的MLP分别提取特征,再通过交互层进行融合。

一、模型架构总览
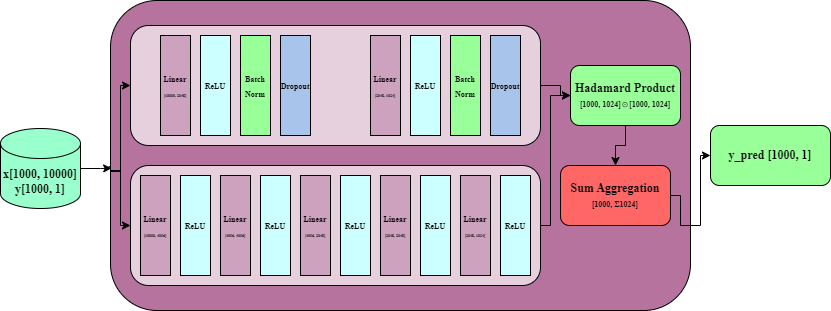
请添加图片描述

我们的模型包含三个核心组件:

  1. Tower A (MLP1):带正则化的浅层网络 —— “稳健派”
  2. Tower B (MLP2):无正则化的深层网络 —— “表达派”
  3. 融合层:逐元素相乘 + 全局池化 —— “交互层”
class FusionModel(nn.Module):
    def __init__(self, tower1, tower2):
        super().__init__()
        self.tower1 = tower1  # 正则化塔
        self.tower2 = tower2  # 深度塔
    
    def forward(self, x):
        left_feat = self.tower1(x)   # [B, 1024] 稳健特征
        right_feat = self.tower2(x)  # [B, 1024] 深度特征
        fused = left_feat * right_feat  # 特征交互
        return fused.sum(dim=1, keepdim=True)  # 压缩为预测值

二、双塔设计的差异化策略

2.1 Tower A:正则化浅层网络 (MLP1)

self.fc1 = nn.Linear(10000, 2048)
self.bn1 = nn.BatchNorm1d(2048)
self.dp1 = nn.Dropout(0.1)
# ... 第二层同理

设计哲学:

  • BatchNorm:稳定隐藏层分布,加速收敛,提供轻微正则化
  • Dropout(0.1):防止过拟合,强制网络学习冗余表示
  • 瓶颈结构:10000 → 2048 → 1024,通过逐层降维压缩信息

适用场景:处理高维稀疏特征(如万维 one-hot 特征),抑制噪声干扰。

2.2 Tower B:深度无正则化网络 (MLP2)

self.fc1 = nn.Linear(10000, 4096)
# ... 连续5层全连接,无外置正则化

设计哲学:

  • 深度优势:5层堆叠具有更强的非线性表达能力,可学习复杂高阶特征组合
  • 宽维度:4096维隐藏层保留更多信息容量,避免早期信息瓶颈
  • 无Dropout/BN:保留原始梯度流,适合数据量充足、噪声较小的场景

关键观察: deeper network here acts as a “feature factory”, generating rich hierarchical representations without the smoothing effect of normalization.

三、融合策略:Hadamard积 + 全局求和

不同于常见的特征拼接(concatenation)或注意力机制,本模型采用逐元素相乘(Hadamard Product):

fused = left_feat * right_feat  # [batch, 1024]
output = fused.sum(dim=1, keepdim=True)  # [batch, 1]

为什么选择逐元素相乘?

  1. 特征交互:模拟逻辑"与"操作,只有当两个塔对某个维度都激活时,该特征才会被保留

    • 例如: Tower A 检测到"关键词A存在" + Tower B 检测到"上下文B匹配" → 强相关信号
  2. 维度对齐压力:强制两个塔学习语义对齐的表示空间。如果 Tower A 的第i维表示"情感极性",Tower B 的第i维也倾向学习互补的情感特征。

  3. 计算高效:相比双线性池化或注意力机制,O(n)复杂度适合实时推理。

求和池化的作用

将1024维交互特征压缩为标量,相当于可学习的加权投票机制:
output=∑i=11024(w1i⋅x)×(w2i⋅x) \text{output} = \sum_{i=1}^{1024} (w_{1i} \cdot x) \times (w_{2i} \cdot x) output=i=1∑1024​(w1i​⋅x)×(w2i​⋅x)

这等价于一个二阶特征交互的简化形式,类似Factorization Machines的核心思想。

四、应用场景与扩展

这种架构特别适合以下场景:

  1. 多视角特征学习

    • Tower 1 处理手工特征(统计特征,需要BN稳定)
    • Tower 2 处理原始嵌入(深度学习特征,需要深度提取)
  2. 知识蒸馏 precursor

    • 先分别训练两个教师模型,再用融合层学习集成策略
  3. 多任务学习的骨干网络

    • 在 fused 层后添加多个投影头,分别处理不同任务

进阶融合技巧

若简单逐元素相乘效果不佳,可尝试:

# 门控融合(Gating Mechanism)
gate = torch.sigmoid(self.gate_layer(torch.cat([left, right], dim=1)))
fused = gate * left + (1 - gate) * right

# 双线性交互
fused = torch.bmm(left.unsqueeze(2), right.unsqueeze(1)).view(batch, -1)

五、总结

本文的双塔架构通过结构异构性实现了特征提取的互补:

  • MLP1 提供稳定、鲁棒的基准特征(Regularized Backbone)
  • MLP2 提供丰富、复杂的高阶特征(Expressive Backbone)
  • Hadamard融合实现选择性注意(Selective Attention)

这种"宽+深"、"正则+原始"的组合策略,在实践中往往比单一路径的模型具有更好的泛化性能,尤其适合特征维度高且模式复杂的二分类任务(如CTR预测、欺诈检测等)。


大模型深度学习之双塔模型 双塔模型(Two-Tower Model)是一种在推荐系统、信息检索和自然语言处理等领域广泛应用的深度学习架构。其核心思想是通过两个独立的神经网络(用户塔和物品塔)分别处理用户和物品的特征,并在共享的语义空间中通过相似度计算实现匹配或召回任务。本文从该模型的各个维度开始,对模型做通俗易懂的说明。让您轻松理解这一在推荐系统、信息检索和自然语言处理等领域广泛应用的深度在这里插入图片描述学习架构。一、双塔模型初印象:就像搭积木想象一下,您正在玩搭积木的游戏。 阅读详情

相关推荐

稀疏向量检索:双塔模型 和 稠密向量检索:单塔模型

在推理阶段(即检索阶段),给定一个用户,可以通过用户塔得到其向量表示,然后与所有物品向量(由物品塔预先计算得到并存储)计算相似度,从而快速找出与该用户最相关的物品,完成检索任务。虽然单塔模型没有像双塔模型那样明确分离用户和物品的处理,但由于其共享权重的特性,能够在一定程度上捕获用户和物品之间的共性,有时能带来更好的表示学习效果。在训练阶段,双塔模型通过最大化用户向量与对应正样本物品向量的内积(或相似度度量),同时最小化用户向量与负样本物品向量的内积,来学习有效的用户和物品表征。

wangqiaowq的博客 2166

【推荐算法】DSSM双塔模型:Deep Structured Semantic Models for Web Search using Clickthrough Data

DSSM,全称Deep Structured Semantic Model,就是我们通常所说的双塔模型,是微软公司提出的一种基于深度网络的语义模型,其核心思想是将query和doc映射到到共同维度的语义空间中,通过最大化query和doc语义向量之间的余弦相似度,从而训练得到隐含语义模型,达到检索的目的。 DSSM有很广泛的应用,比如:搜索引擎检索,广告相关性,问答系统,机器翻译等。

长相忆兮长相忆的专栏 6921

【深度学习技术系列】推荐系统-双塔模型基本原理与实践

双塔模型经典又简单,就是NLP领域的 query 和 document,推荐领域的 user 和 item,多模态检索领域的图像和文字等,都可以用双塔表示,分别把两个领域的特征编码成一个向量,然后向量相似度进行召回。较早使用双塔模型的是DSSM模型。将文本编码成对应低维向量,然后通过优化向量点积估值,得到合适的query和文档向量。线上通过query和文档的相似度进行文档的召回。推荐系统中使用的双塔模型结构如下:真实的推荐领域的大规模推荐系统,通常有百万到上亿的item和user。

小田的专栏 7268

【王树森推荐系统公开课】笔记06(双塔模型:模型和训练)

用户塔、物品塔各输出一个向量。两个向量的余弦相似度作为兴趣的预估值。三种训练方式:Pointwise:每次用一个用户、一个物品(可正可负Pairwise:每次用一个用户、一个正样本、一个负样本。Listwise:每次用一个用户、一个正样本、多个负样本。

qq_52342142的博客 1677

餐厅评分预测实战案例 从结构化特征到回归建模落地

餐厅评分预测看似只是一个回归题,实际对应的是本地生活平台中非常典型的商户质量评估问题。SF DST 这道 Kaggle 竞赛围绕 TripAdvisor 餐厅评分展开,核心价值不在复杂模型本身,而在于如何把零散的商家属性、位置、品类和评论线索整理成可用于预测的稳定特征。

Mr数据杨 49

通过深度异构特征融合实现高效的视听说话人识别

通过深度异构特征融合实现高效的视听说话人识别

一文看懂推荐系统:召回06:双塔模型——模型结构、训练方法,召回模型是后期融合特征,排序模型是前期融合特征

(1)找工作投简历的话,你要将招聘单位的岗位需求和你的研究方向和工作内容对应起来,这样才能契合公司招聘需求,否则它直接把简历给你挂了 (2)你到底是要进公司做推荐系统方向?还是纯cv方向?还是NLP方向?还是语音方向?还是深度学习机器学习技术中台?还是硬件?还是前端开发?后端开发?测试开发?产品?人力?行政?这些你不可能啥都会,你需要找准一个方向,自己有积累,才能去投递,否则面试官跟你聊什么呢? (3)今日推荐系统学习经验:三种训练方法的本质都是让用户和正样本物品的余弦相似度大,而用户跟负样本的余弦相似度小

weixin_46838716的博客 1万+

大华事件检测智能服务器,大华股份:高速公路智能事件检测 解决方案

1方案背景随着我国基础设施建设的飞速发展,公路尤其是高速公路的总里程数年年攀升。交通运输部统计数据显示,截止2017年底全国公路总里程477.35万公里,其中高速公路13.65万公里,位居世界第一。高速公路的运营和管理作为全国交通管理的重要组成部分日益受到严峻挑战,交通拥堵和事故频发已成为高速公路上非常突出的问题。抛洒物、行人、车辆不规则行驶等事件是导致以上结果的重要原因。基于视频分析的高速公路智...

weixin_39523887的博客 1822

什么是双塔模型?

本文介绍了双塔模型的基本概念,并使用随机构建的数据集搭建了一个Torch简易版本的双塔模型。

学习与分享人工智能技术 3479

【实验】Linux下完全卸载oracle单实例(亲身体验完整版)

停止oracle数据库服务 停止监听 卸载数据库实例 因为自己懒得再弄dbca图形化界面啥的,直接采用dbca静默删除数据库实例,命令如下 dbca -silent -deleteDatabase -sourcedb orclhq -sid orcl -sysDBAUserName orcl -sysDBAPassword zte [oracle@slave ~]$ dbca -silent ...

萝卜吃鱼914的博客 1945

深度学习&故障诊断初学者 - 学习路线

针对初学者,一头雾水,不知如何学习,本文给出了一个学习路线 Python学习 - 打好编程基础 https://www.bilibili.com/video/BV1vA411b7Rn?spm_id_from=333.337.search-card.all.click B站免费课程 学到P49 建议时长 2周 深度学习理论 - 浅浅理解神经网络 https://www.bilibili.com/video/BV1FT4y1E74V?p=41 建议时长 2周...............

m0_47410750的博客 6万+

多智能体协作感知入门到精通:ICLR顶会SiMO论文全拆解,看这篇就够了!

协作感知整合多智能体视角,以增强感知范围并克服遮挡问题。虽然现有多模态方法利用互补传感器提升性能,但它们极易失效——尤其是在关键传感器如激光雷达(LiDAR)无法使用时。根本原因是特征融合导致单模态特征与下游模块之间的语义不匹配。本文首次在协作感知领域探讨了这一挑战,提出了单模态可作多模态协作感知(SiMO)。通过采用所提议的长度自适应多模融合(LAMMA),SiMO 可以在模态失败时自适应处理剩余的模态特征,同时保持语义空间的一致性。此外,借助创新的“预训练-对齐-融合-研发”培训策略,SiMO 解决了模

weixin_58753619的博客 387

若依(ruoyivue)实现文档在线查看

1、Kkfileview部署 第一步:从kkfileview官方发行版本下载安装包,安装包下载路径: https://gitee.com/kekingcn/file-online-preview/releases, 第二步:解压kkFileView-x.x.x文件(Windows用.zip包,Linux/MacOS用.tar.gz包) 第三步:打开解压后文件夹的bin目录,运行startup脚本(Windows下以管理员身份运行startup.bat,Linux以root用户运行startup.sh) 第四

weixin_46953697的博客 9679

【机器学习】---异构数据融合

异构数据融合在机器学习中具有广泛的应用前景,但其复杂性也带来了许多挑战。通过采用合适的融合策略和算法,结合对实际问题的深刻理解,可以充分发挥异构数据的潜力,提高模型的预测性能。未来,随着深度学习和分布式计算技术的不断进步,异构数据融合必将在更多的领域中得到应用和推广。

2301_80863610的博客 7067

F280049C Buffered Digital-to-Analog Converter (DAC)

使用DAC模块很简单,只需要配置参考电压,并写入DACVALS寄存器一个数字值即可。参考电压可配置为外部参考VDAC和内部参考电压1.65V和2.5V,并结合增益作为DAC模块最终的参考电压DACREF。举个例子,配置参考电压为内部参考电压1.65V,增益设置为2,则参考电压DACREF=3.3V,若向DACVALS写入数字值2048,则输出的DAC模块的输出带电压DACOUT=DACVALS×DACREF4096=1.65VDACOUT=

xht2403267701的博客 2367

SORT算法在遮挡下总跟丢?深入OC-SORT源码,拆解其三大创新点如何解决卡尔曼滤波的顽疾

本文深入解析OC-SORT算法如何通过三大创新点解决多目标跟踪中的卡尔曼滤波顽疾。OC-SORT引入在线平滑虚拟轨迹技术(OOS)、观测中心动量匹配机制(OCM)和基于最后观测的轨迹恢复(OCR),显著提升了遮挡场景下的跟踪性能。实验数据显示,相比传统SORT算法,OC-SORT在MOT17数据集上MOTA提升5.7%,遮挡恢复成功率提高64.2%,为Multi-Object Tracking领域带来突破性进展。

weixin_42547431的博客 238

多源异构数据融合的特征提取与学习算法研究

多源异构数据融合的特征提取与学习算法是一个重要的研究领域,它可以帮助我们有效地利用多源异构数据。特征级融合和决策级融合是常用的数据融合方法,而特征提取和学习算法是关键的步骤。未来的研究可以从以下几个方面展开:提出更有效的特征提取方法、设计更适应多源异构数据的学习算法、研究数据融合的理论和方法等。多源异构数据的学习算法是将特征提取和模型学习相结合,通过学习算法来挖掘数据中的潜在规律和关联。多源异构数据的特征提取是一个关键的步骤,它可以帮助我们从复杂的数据中提取出有用的信息。

qq_40427481的博客 3365

a股level2数据接口的最优委托信息

Level-1提供的数据并不可以知道委托了xxx手是有多少人下的,以及每个人下了多少的明细。通过Level-2的这个详细买卖盘数据,盘口上的单子到底是散户小打小闹,还是主力真刀实枪在干,都一览无余。交易类型:1-市价,2-限价,3-本方优先,10-撤单, 11-暂不清楚( 基金/ 债券有此值)除了提供逐笔成交记录这个信息外,还提供了最优委托信息,也就是盘口中前50笔订单的委托数量明细。那么Level-2盘口委托数据的速度更新是非常快的,大家可以通过。交易方向:0-未知,1-买入,2-卖出。

Qq_2037696191的博客 1166

【推荐算法】双塔模型介绍

【推荐算法】双塔模型介绍

u011590738的博客 1万+

某城商银行生产容器云平台详细设计方案分享及经验总结

AS3模式的CIS容器部署在K8S集群内,作为F5的控制器,CIS容器通过对K8S集群内Configmap资源进行监控,将Configmap资源中的内容转化为F5的配置,将配置推送给 F5 ,CIS容器还通过K8S标准的API接口完成业务发现和实时监听集群内Pod的变化,一旦Pod发生变化,相应的更新会及时推送给F5,并完成更新。容器技术发展非常迅速,现在应用大多以容器作为承载介质,前两年在容器云上承载的应用类型主要是Web类,随着容器云领域的不断发展,越来越多的应用类型将迁移至容器云,包括有状态应用。

qq_61890005的博客 854

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

深度学习模型——双塔模型(Two-Tower Model)详解

双塔模型是一种简单而高效的语义匹配模型,通过用户塔和物品塔的独立建模,以及匹配层的相似性计算,实现了用户和物品之间的高效推荐。本文从原理到代码实现,逐步拆解了双塔模型的核心逻辑和设计思想,使其易于理解和应用。

goTsHgo的博客 9163

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

集成学习与异构数据的融合:多模态数据处理

1.背景介绍 多模态数据处理是一种将多种类型的数据(如图像、文本、音频、视频等)融合并进行分析的方法。 集成学习是一种机器学习方法,它通过将多个模型或算法结合在一起来提高预测性能。 在这篇文章中,我们将讨论如何将这两种方法结合使用以处理异构数据。 1.1 异构数据的定义与特点 异构数据是指来自不同数据源、格式和类型的数据。 例如,社交网络数据可能包括用户的个人信息、文本消息、图片和视频等。 ...

AI天才研究院 3781

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

异构数据处理与融合的挑战与解决方案

1.背景介绍 1. 背景介绍 异构数据处理与融合是一种在不同数据源、格式和类型之间进行数据整合、清洗、转换和分析的技术。随着数据的增长和多样性,异构数据处理与融合成为了一种重要的技术手段,以解决数据整合、分析和应用的挑战。本文将从以下几个方面进行探讨: 异构数据处理与融合的核心概念与联

AI天才研究院 2105

多源异构数据的融合

多源数据融合就是将各种不同的数据信息进行综合,吸取不同数据源的特点然后从中提取出统一的,比单一数据更好、 更丰富的信息,达到1=1=3的效果。

m0_46772201的博客 1万+

中数据库存入的中文是问号_广告行业中那些趣事系列10:推荐系统中不得不说的DSSM双塔模型...

导读:本文是“数据拾光者”专栏的第十篇文章,这个系列将介绍在广告行业中自然语言处理和推荐系统实践。本文主要介绍了项目中用于商业兴趣建模的DSSM双塔模型。欢迎转载,转载请注明出处以及链接,更多关于自然语言处理、推荐系统优质内容请关注如下频道。知乎专栏:数据拾光者公众号:数据拾光者摘要:本篇主要介绍了项目中用于商业兴趣建模的DSSM双塔模型。作为推荐领域中大火的双塔模型,因为效果不错并且对工业界十分...

weixin_32473663的博客 360

文本匹配 (Text Matching)双塔(Siamese)的网络结构/线上业务的要求

随着深度学习的发展,模型参数的数量飞速增长。为了训练这些参数,需要更大的数据集来避免过拟合。然而,对于大部分NLP任务来说,构建大规模的标注数据集非常困难(成本过高),特别是对于句法和语义相关的任务。相比之下,大规模的未标注语料库的构建则相对容易。为了利用这些数据,我们可以先从其中学习到一个好的表示,再将这些表示应用到其他任务中。最近的研究表明,基于大规模未标注语料库的预训练模型(Pretrained Models, PTM) 在NLP任务上取得了很好的表现。 近年来,大量的研究表明基于大型语料库的预训练模

qq_15821487的博客 1142
上一篇: FTP SAMBA Web
下一篇: 从零手写Transformer:基于每一步shape变化拆解与PyTorch实现
Network_Engineer
博客等级 码龄4年 2047粉丝 85原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Network_Engineer

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

