搭建hadoop2.2.0 HDFS,HA / Federation 和 HA&Federation

hadoop-HA搭建 这个文档是本人搭建成功的步骤,能正常使用,里面配置了首先自己要步骤进行 立即下载
在虚拟机上安装Hadoop 2环境,版本使用Hadoop2.2.0。  Hadoop2 HDFS 的具有HA和Federation两种形式,配置上略有不同。把过程记录下来,待以后查阅。
  • 准备工作 

            下载

             http://mirrors.cnnic.cn/apache/hadoop/common/stable/hadoop-2.2.0.tar.gz

      操作系统

             ubuntu12.04

      虚拟机

            Vmware

      安装操作系统,  此步骤略

      本次测试安装四台虚拟机

 hostnameIP
1hw-0100192.168.1.100
2hw-0101192.168.1.101
3hw-0102192.168.1.102
4hw-0150192.168.1.150

       安装JAVA,此步骤略


  • 创建用户

    #useradd hadoop

    #passwd hadoop

    使用sudo操作。编辑/etc/sudoers编辑文件,在root ALL=(ALL)ALL行下添加hadoop ALL=(ALL)ALL 

  • 配置ssh免密码

      $ssh-keygen -t rsa

      $cat ~/.ssh/id_rsa.pub >>~/.ssh/authorized_keys

      ssh localhost   测试通过后,把authorized_keys拷贝到其他节点的~/.ssh目录即可


        准备工作完毕


配置HA

    先看一下简单的架构图


  • JAVA_HOME

       配置$HADOOP_HOME/etc/hadoop/hadoop-env.sh中JAVA_HOME

    ...

            export JAVA_HOME = [java_local_dir]

    ...

  • 配置core-site.xml,   slaves,   hdfs-site.xml

      slaves             

1
2
3
hw-0101
hw-0102
hw-0150


core-site.xml      

<configuration>
   <property>
      <name>fs.defaultFS</name>
      <value>hdfs://hadoop-cluster1</value>
   </property>
</configuration>

hdfs-site.xml
<configuration>

  <property>
      <name>dfs.nameservices</name>
     <value>hadoop-cluster1</value>
   </property>

   <property>
      <name>dfs.ha.namenodes.hadoop-cluster1</name>
      <value>nn1,nn2</value>
   </property>

   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster1.nn1</name>
      <value>hw-0100:9000</value>
   </property>
   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster1.nn2</name>
      <value>hw-0101:9000</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster1.nn1</name>
      <value>hw-0100:50070</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster1.nn2</name>
      <value>hw-0101:50070</value>
   </property>

   <property>
      <name>dfs.client.failover.proxy.provider.hadoop-cluster1</name>
      <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
   </property>

   <property>
      <name>dfs.namenode.name.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/name</value>
   </property>

   <property>
      <name>dfs.namenode.shared.edits.dir.hadoop-cluster1</name>
      <value>qjournal://hw-0101:8485;hw-0102:8485;hw-0150:8485/hadoop-cluster1</value>
   </property>

   <property>
      <name>dfs.datanode.data.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/data</value>
   </property>

   <property>
      <name>dfs.ha.automatic-failover.enabled</name>
      <value>false</value>
   </property>

   <property>
      <name>dfs.journalnode.edits.dir</name>
      <value>/home/hadoop/hadoop-hdfs3/hdfs/journal</value>
   </property>

</configuration>

把以上三个文件分别拷贝到所有节点的etc/hadoop/里。

  • 启动namenode, datanode(本文hadoop的命令均在$HADOOP_HOME目录下运行)

    配置HA,需要保证ActiveNN与StandByNN有相同的NameSpace ID,在format一台机器之后,让另外一台NN同步目录下的数据。

在hw-0100节点上执行:

#如果使用HQJM,需要先启动jouranlnode
$sbin/hadoop-daemons.sh start journalnode
$bin/hdfs namenode -format
$sbin/hadoop-daemon.sh start namenode

在hw-0101节点上执行:             

$bin/hdfs namenode -bootstrapStandby
$sbin/hadoop-daemon.sh start namenode


此时hw-0100,hw-0101均处于standby状态

切换hw-0100节点为Active状态

在hw-0100节点上执行:    

$bin/hdfs haadmin -transitionToActive nn1

启动所有datanode节点

$sbin/hadoop-daemons.sh start datanode
  • 验证

    访问http://192.168.1.100:50070查看监控页面

           访问HDFS,命令如下:

创建目录          

$bin/hadoop fs -mkdir /tmp

查看目录          

$bin/hadoop fs -ls /tmp


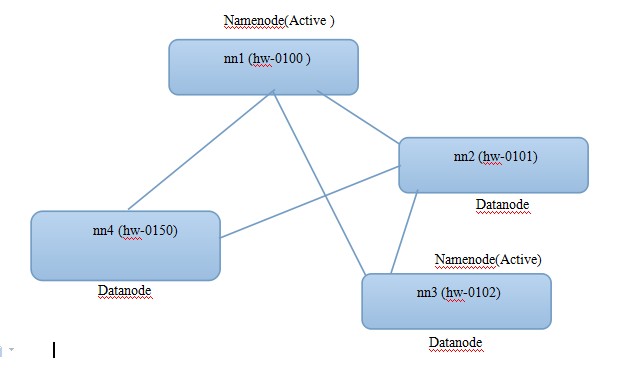
配置Federation

    先看看简单架构图
  • 配置core-site.xml,   slaves,   hdfs-site.xml

slaves  

1
2
3
hw-0101
hw-0102
hw-0150


core-site.xml      

<configuration>

   <property>
      <name>fs.defaultFS</name>
      <value>viewfs:///</value>
   </property>

   <property>
      <name>fs.viewfs.mounttable.default.link./tmp</name>
      <value>hdfs://hw-0100:9000/tmp</value>
   </property>

   <property>
      <name>fs.viewfs.mounttable.default.link./tmp1</name>
      <value>hdfs://hw-0102:9000/tmp2</value>
   </property>

</configuration>

hdfs-site.xml

<configuration>

   <property>
      <name>dfs.federation.nameservices</name>  
     <value>hadoop-cluster1,hadoop-cluster2</value>
   </property>
<!--cluster1-->
   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster1</name>
      <value>hw-0100:9000</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster1</name>
      <value>hw-0100:50070</value>
   </property>

<!--cluster1-->   
<!--cluster2-->
   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster2</name>
      <value>hw-0102:9000</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster2</name>
      <value>hw-0102:50070</value>
   </property>

<!--cluster2-->
   <property>
      <name>dfs.namenode.name.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/name</value>
   </property>

   <property>
      <name>dfs.datanode.data.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/data</value>
   </property>

</configuration>

把以上三个文件分别拷贝到所有节点的etc/hadoop/里。

  • 启动namenode, datanode(本文hadoop的命令均在$HADOOP_HOME目录下运行)

    配置Federation,需要在启动多个NameNode上format时,指定clusterid,从而保证2个NameService可以共享所有的DataNodes,否则两个NameService在format之后,生成的clusterid不一致,DataNode会随机注册到不同的NameNode上。


在hw-0100节点上执行:    

$bin/hdfs namenode -format –clusterId hadoop-cluster
$sbin/hadoop-daemon.sh start namenode

在hw-0102节点上执行:

$bin/hdfs namenode -format –clusterId hadoop-cluster
$sbin/hadoop-daemon.sh start namenode

启动所有datanode节点

$sbin/hadoop-daemons.sh start datanode
  • 验证

    访问http://192.168.1.100:50070查看监控页面

           访问HDFS,命令如下:

   查看目录          

$bin/hadoop fs -ls /
#可以查看到 /tmp  /tmp1的两个目录。


 HA&Federation

  先看看简单架构图


  • 配置core-site.xml,   slaves,   hdfs-site.xml

      slaves  

1
2
3
hw-0101
hw-0102
hw-0150
core-site.xml      
<configuration>

   <property>
      <name>fs.defaultFS</name>
      <value>viewfs:///</value>
   </property>

   <property>
      <name>fs.viewfs.mounttable.default.link./tmp</name>
      <value>hdfs://hadoop-cluster1/tmp</value>
   </property>

   <property>
      <name>fs.viewfs.mounttable.default.link./tmp1</name>
      <value>hdfs://hadoop-cluster2/tmp2</value>
   </property>

</configuration> 

hdfs-site.xml

<configuration>

   <property>
      <name>dfs.nameservices</name>
     <value>hadoop-cluster1,hadoop-cluster2</value>
   </property>

   <property>
      <name>dfs.ha.namenodes.hadoop-cluster1</name>
      <value>nn1,nn2</value>
   </property>

   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster1.nn1</name>
      <value>hw-0100:9000</value>
   </property>
   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster1.nn2</name>
      <value>hw-0101:9000</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster1.nn1</name>
      <value>hw-0100:50070</value>
   </property>
   <property>
      <name>dfs.namenode.http-address.hadoop-cluster1.nn2</name>
      <value>hw-0101:50070</value>
   </property>
   
      <property>
      <name>dfs.client.failover.proxy.provider.hadoop-cluster1</name>
      <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>
    
<!--cluster2-->
   <property>
      <name>dfs.ha.namenodes.hadoop-cluster2</name>
      <value>nn3,nn4</value>
   </property>

   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster2.nn3</name>
      <value>hw-0102:9000</value>
   </property>
   <property>
      <name>dfs.namenode.rpc-address.hadoop-cluster2.nn4</name>
      <value>hw-0150:9000</value>
   </property>

   <property>
      <name>dfs.namenode.http-address.hadoop-cluster2.nn3</name>
      <value>hw-0102:50070</value>
   </property>
   <property>
      <name>dfs.namenode.http-address.hadoop-cluster2.nn4</name>
      <value>hw-0150:50070</value>
   </property>
   
   <property>
      <name>dfs.client.failover.proxy.provider.hadoop-cluster2</name>
      <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>

<!--cluster2-->
   <property>
      <name>dfs.namenode.name.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/name</value>
   </property>

   <property>
      <name>dfs.namenode.shared.edits.dir.hadoop-cluster1.nn1</name>
      <value>qjournal://hw-0101:8485;hw-0102:8485;hw-0150:8485/hadoop-cluster1</value>
   </property>

   <property>
      <name>dfs.namenode.shared.edits.dir.hadoop-cluster1.nn2</name>
      <value>qjournal://hw-0101:8485;hw-0102:8485;hw-0150:8485/hadoop-cluster1</value>
   </property>

   <property>
      <name>dfs.namenode.shared.edits.dir.hadoop-cluster2.nn3</name>
      <value>qjournal://hw-0101:8485;hw-0102:8485;hw-0150:8485/hadoop-cluster2</value>
   </property>

   <property>
      <name>dfs.namenode.shared.edits.dir.hadoop-cluster2.nn4</name>
      <value>qjournal://hw-0101:8485;hw-0102:8485;hw-0150:8485/hadoop-cluster2</value>
   </property>

   <property>
      <name>dfs.datanode.data.dir</name>
      <value>file:///home/hadoop/hadoop-hdfs3/hdfs/data</value>
   </property>

   <property>
      <name>dfs.ha.automatic-failover.enabled</name>
      <value>false</value>
   </property>

   <property>
      <name>dfs.journalnode.edits.dir</name>
      <value>/home/hadoop/hadoop-hdfs3/hdfs/journal</value>
   </property>

</configuration>

把以上三个文件分别拷贝到所有节点的etc/hadoop/里。

  • 启动namenode, datanode(本文hadoop的命令均在$HADOOP_HOME目录下运行)

在hw-0100节点上执行:    

#如果使用HQJM,需要先启动jouranlnode
$sbin/hadoop-daemons.sh start journalnode

$bin/hdfs namenode -format –clusterId hadoop-cluster-new
$sbin/hadoop-daemon.sh start namenode

在hw-0101节点上执行:             

$bin/hdfs namenode -bootstrapStandby
$sbin/hadoop-daemon.sh start namenode

此时hw-0100,hw-0101均处于standby状态

切换hw-0100节点为Active状态

在hw-0100节点上执行:    

$bin/hdfs haadmin -ns hadoop-cluster1 -transitionToActive nn1  

在hw-0102节点上执行:    

$bin/hdfs namenode -format –clusterId hadoop-cluster-new
$sbin/hadoop-daemon.sh start namenode

在hw-0150节点上执行:             

$bin/hdfs namenode -bootstrapStandby
$sbin/hadoop-daemon.sh start namenode

此时hw-0102,hw-0150均处于standby状态

切换hw-0102节点为Active状态

在hw-0100节点上执行:    

$bin/hdfs haadmin -ns hadoop-cluster2 -transitionToActive nn3 

在hw-0100节点上,启动所有datanode节点

$sbin/hadoop-daemons.sh start datanode

  • 验证

    访问http://192.168.1.100:50070查看监控页面

           访问HDFS,命令如下:

查看目录          

$bin/hadoop fs -ls /
#显示在不同namenode中的目录 /tmp /tmp1


参考:

http://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-hdfs/Federation.html

http://www.binospace.com/index.php/hdfs-ha-quorum-journal-manager/


知识源于网络   转载请注明出处  http://www.cnblogs.com/nb591/p/3535662.html

数字政府政务服务AI大模型赋能智能体平台及AI场景应用规划方案(决策评审版).pptx 立即下载

相关推荐

T18_低空经济示范区十五五通感一体化低空智联网与飞行服务保障体系设计方案_生态合作版.pptx

T18_低空经济示范区十五五通感一体化低空智联网与飞行服务保障体系设计方案_生态合作版.pptx

Kubernetes(一)基本概念

1. Kubernete简介 Kubernetes 是 Google 团队发起并维护的基于 Docker 的开源容器集群管理系统,它不仅支持常见的云平台,而且支持内部数据中心。 建于 Docker 之上的 Kubernetes 可以构建一个容器的调度服务,其目的是让用户透过 Kubernetes 集群来进行云端容器集群的管理,而无需用户进行复杂的设置工作。系统会自动选取合适的工作节点来执行具体的容器集群调度处理工作。其核心概念是 Container Pod。一个 Pod 由一组工作于同一物理工作节点的容

傅红雪的专栏 7267

多目标粒子群算法求解综合能源系统最优容量配置研究(Matlab代码实现)

内容概要:本文研究了基于多目标粒子群算法(MOPSO)求解综合能源系统(IES)中最优容量配置的方法,并提供了完整的Matlab代码实现。研究旨在通过优化风电机组、光伏机组、燃气轮机、储能系统等多种能源设备的容量配置,实现系统在经济性、环保性和能源利用率等方面的多目标平衡。文中构建了综合能源系统容量配置的数学模型,明确了以最低综合成本、最小碳排放为核心的目标函数,以及能量供需平衡、设备出力能力等关键约束条件,并详细阐述了MOPSO算法的实现流程,包括种群初始化、非支配排序、拥挤距离计算和外部存档更新等核心机制。最后,通过Matlab平台的仿真实验验证了该方法的有效性,结果表明该算法能够生成分布均匀且具有良好多样性的Pareto最优解集,为决策者根据不同侧重点选择最终方案提供了科学依据。; 适合人群:具备一定电力系统、优化算法和Matlab编程基础的研究生、科研人员及工程技术人员。; 使用场景及目标:① 学习和掌握综合能源系统容量配置问题的建模方法;② 深入理解多目标粒子群算法(MOPSO)的核心原理及其在实际工程优化问题中的应用;③ 获取可直接运行和修改的Matlab代码,用于复现研究成果或进行二次开发。; 阅读建议:建议读者在阅读时,首先理解综合能源系统的背景和优化问题的数学建模过程,然后结合提供的Matlab代码,逐步跟踪算法的执行流程,重点关注目标函数和约束条件的代码实现,以及MOPSO算法中非支配排序和拥挤距离计算等核心模块。为了更好地掌握,可以尝试调整算例参数、增减优化目标或修改算法参数,观察结果的变化。

Kubernetes Federation整体架构解读(v1、v2版本)

       近期云原生圈中多云(Multi-Cloud)和混合云的概念受到了很多关注,通过IBM、Vmware这俩笔收购不难看出,云服务商正在相继开拓混合云市场。在IBM收购Redhat的声明中,俩家公司强调它们将联合推动基于kubernetes的混合云解决方案,并致力成为多云和混合云市场的领导者。VMware对Heptio的收购中也表示,将加强PKS与Heptio产品的合作,通过Kuberne...

JackXuF的专栏 6316

颠覆性创新的测量框架与跨领域实证分析

颠覆性创新作为科技发展的重要驱动力,其核心在于实现知识体系的范式转换。从技术原理看,这类创新通常具备知识替代、网络重构和跨领域渗透三大特征,通过引用网络分析和文本挖掘等方法可量化评估其影响力。在工程实践中,CD指数、DI指数等测量工具帮助研究者识别具有突破潜力的成果,而深度学习等新兴技术进一步提升了评估精度。当前AI、半导体等领域的热门技术发展表明,模块化架构和产业协同能有效促进颠覆性创新。面对全球范围内创新颠覆性下降的趋势,优化科研评价体系、构建跨学科协作网络成为关键应对策略。

weixin_29735807的博客 325

MUSIC算法翻车?Toeplitz矩阵重构如何解决DOA估计中的相干信源难题

本文深入探讨了MUSIC算法在相干信源DOA估计中失效的根本原因,并详细介绍了基于Toeplitz矩阵重构的协方差矩阵修复技术。该方法通过凸优化恢复协方差矩阵的理想结构,有效解决了信号子空间秩亏损问题,从而显著提升了MUSIC算法在相干和多径场景下的分辨精度与稳健性。

a2b3c4d5e的博客 250

详解hadoop之二:HDFS Federation(联邦)

  hdfs federation即hdfs的联邦,可以简单理解为多个hdfs集群聚合到一起,更准确的理解是有多个namenode节点的hdfs集群hadoop1.x的hdfs架构主要由namespace(命名空间)和Block Storage(块的存储)两层组成1.namespace由目录、文件、块组成。 支持创建、删除、修改、列举命名空间相关系统的操作2.Block Storageblock ...

fengxuezhiye的专栏 1万+

COMSOL仿真避坑指南:列管反应器模拟中多孔介质与化学反应设置的5个常见错误

本文详细解析了COMSOL仿真中列管反应器模拟的5个常见错误,包括多孔介质模型选择、化学反应接口配置、对流扩散方程处理、薄层热阻设置及网格独立性验证。特别针对多孔介质与化学反应设置的误区,提供了实用的判断标准和修正方法,帮助工程师避免计算偏差,提升仿真精度。

weixin_29597551的博客 325

集群联邦(Federation)

联邦 联合可以轻松管理多个群集。 它通过提供2个主要构件来实现: 跨群集同步资源:联邦可以使多个群集中的资源保持同步。 例如,可以确保多个群集中部署相同的程序。 跨群集发现:联邦提供了自动配置DNS服务器和负载均衡器与所有群集后端的功能。例如,您可以确保可以使用全局VIP或DNS记录来访问多个群集的后端。 高可用:通过在群集之间传播负载并自动配置DNS服务器和负载平衡器,联邦会将群集故障的...

qq_42747099的博客 4536

Mac用户必看:Parallels Desktop 18.1.1最新破解版安装与优化全攻略(附资源)

本文为Mac用户提供Parallels Desktop 18.1.1的详细安装与优化指南,涵盖虚拟化技术选型、专业级配置流程及性能调优技巧。重点解析Parallels Desktop在图形加速、系统资源调度方面的核心优势,并分享生产力增强技巧与典型应用场景实战方案,帮助用户最大化利用这一高效虚拟化工具。

weixin_29240343的博客 830

ADF4002分频器避坑指南:常见配置错误及解决方案

本文深入解析了ADF4002分频器在实战应用中的常见陷阱与解决方案。内容涵盖寄存器配置逻辑、硬件PCB布局要点、软件驱动时序细节及系统化调试方法,重点阐述了如何避免因配置错误导致芯片无法正常工作的问题,帮助工程师高效完成高精度频率合成系统设计。

weixin_29192141的博客 98

搭建hadoop2.2.0 HDFS,HA / Federation 和 HA&Federation

在虚拟机上安装Hadoop 2环境,版本使用Hadoop2.2.0。 Hadoop2 HDFS 的具有HA和Federation两种形式,配置上略有不同。以下把过程记录下来,留待以后查阅,也希望给人以便利。 准备工作 下载 http://mirrors.cnnic.cn/apache/hadoop/common/...

weixin_30533797的博客 83

TCP/IP工业通信C#极致实现:工业级TcpClient封装 + 粘包拆包彻底解决 + 高频采集专项优化(完整可投产)

在工业自动化、PLC通信、工业传感器/模块、产线高频数据采集等场景中,TCP/IP是绝对主流的通信方式,相比串口/485,具备传输速率高、距离无限制、布线简单、抗干扰强的优势。但工业TCP通信和普通桌面TCP通信有本质区别,工业场景的核心要求是:✔高可靠:7×24小时不间断运行,断网自动重连、异常自动恢复,绝不崩溃;✔无数据错误:彻底解决「粘包、拆包、半包」问题(工业通信第一大坑,90%的通信异常源于此);✔高频采集优化:支持级别的高频读写PLC/设备,无卡顿、无丢帧、CPU占用极低;✔。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 861

HDFS2的新特性:HA和Federation

一、HDFS的新特性HA (一)HDFS的HA机制         Hadoop 2.2.0 版本之前,NameNode是HDFS集群的单点故障点,每一个集群只有一个NameNode ,如果这个机器或者进程不可用,整个集群就无法使用,直到重启NameNode或者新重启一个NameNode节点 。 影响HDFS集群不可用主要包括以下两种情况。 (1)类似机器跌宕这样的意外情况将导致集群不可用

converoscar的博客 2943

C++ PCL点云处理实战专栏

工业级点云处理技术学习资源,涵盖电力、建筑、隧道等领域的实战案例。内容分为三阶段:代码原理(算法认知)、动态库(项目验证)和完整代码(定制开发)。

weixin_45196569的博客 1122

如何在 R 中执行 Kruskal-Wallis 检验

Kruskal-Wallis 检验用于确定三个或更多独立组的中位数之间是否存在统计学上的显着差异。它被认为是单向方差分析的非参数等效项。本教程介绍了如何在 R 中执行 Kruskal-Wallis 检验。示例:R 中的 Kruskal-Wallis 检验 假设研究人员想知道三种不同的肥料是否会导致不同水平的植物生长。他们随机选择 30 种不同的植物并将它们分成三组,每组 10 株,每组施用不同的肥料。在一个月结束时,他们测量每株植物的高度。使用以下步骤执行 Kruskal-Wallis 检验以确定三个组的中

Mrrunsen的博客 3801

HDFS Federation 联邦hdfs的实践与改进

HDFS Federation 为 HDFS 系统提供了 NameNode 横向扩容能力。然而作为一个已实现多年的解决方案,真正应用到已运行多年的大规模集群时依然存在不少的限制和问题。本文以实际应用场景出发,介绍了 HDFS Federation 在美团点评的实际应用经验。 一 背景 2015 年 10 月,经过一段时间的优化与改进,美团点评 HDFS 集群稳定性和性能有显著提升,保证了业务数...

每个人都是一道菜。。。 1050

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Hadoop可以连上8088,连不上50070,并且jps命令后并没有出现Namenode

可以连接到http://192.168.56.8:8088 ,但是连接不上http://192.168.56.8:50070。使用 jps命令后并没有出现Namenode。 解决办法: namenode 默认在/tmp下建立临时文件,但关机后,/tmp下文档自动删除,再次启动Master造成文件不匹配,所以namenode启动失败。 在core-site.xml中指定临时文件位置,然后

DaSen的博客 4286

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

Federation的使用场景

使用场景 扩展性 性能瓶颈 隔离问题 集群的可用性 扩展性 HDFS运行时将元数据存储在NameNode内存中,记录了每个文件对象内容(名称、权限、属组等)。NameNode内存使用量和文件个数相关,NameNode的内存的限制将制约文件存储数量。过大内存同时会导致以下问题: 启动花费的时间太长。 Namenode在Full GC时,对外部应用的响应会产生延迟,如果发生错误...

qq_28069577的博客 1246

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

hadoop HA+Federation(高可用联邦)搭建配置(一)

hadoop HA+Federation(高可用联邦)搭建配置(一) 标签(空格分隔): 未分类 介绍 hadoop 集群一共有4种部署模式,详见《hadoop 生态圈介绍》。 HA联邦模式解决了单纯HA模式的性能瓶颈(主要指Namenode、ResourceManager),将整个HA集群划分为两个以上的集群,不同的集群之间通过Federation进行连接,使得HA集群拥有了横向扩展...

anghiking20140716的博客 390

Federation 简介

  HDFS的局限性(HDFS只有一个active的namenode): 1. 在name中存储所有的元数据(metadata),因此单个namenode所能存储的对象(块+文件)数据受到namenode所在JVM的heap size的限制。 2. 整个HDFS文件系统的吞吐量受限于单个namenode的吞吐量 3. 无法隔离namespace   Federation HDFS ...

iteye_19838的博客 630

kubernetes federation 工作机制之资源对象同步

01 前言希望通过本文最简单的方式向熟悉k8s的人说明白其上的federation是干什么的,如何工作的。关于federation,比较官方的说法是:集群联邦可以让租户/企业根据需要扩展或伸缩所需要的集群;可以让租户/企业在跨地区甚至跨地域的多个集群上部署、调度、监测管理应用。通过集群联邦,租户/企业可以在指定集群上部署应用,可以拉通私有云和公有云建立混合云(hybrid cloud)。如在des...

mark's technic world 1736

Hadoop Federation + HA 搭建(二) -- hadoop Federation + HA

Hadoop Federation + HA 搭建(一) – 环境准备 一 . 搭建ZK的分布式环境(3台机器,如果ZK是StandAlone的模式,只需要一台机器) 1 . 解压Zookeeper包 解压到当前目录 [root@wpixel01 www]# tar -zxvf zookeeper-3.4.10 [root@wpixel01 www]# ll total 4488 -

Wpixel的博客 1031

kubernetes federation-v2 架构分析、安装部署与示例验证

一、引言 Federation (集群联邦)是 k8s 社区中重要的多云管理项目,实现了跨地区跨服务商管理多个 k8s 集群的功能。 它主要提供了如下两个模型: 跨集群同步资源:Federation能够让资源在多个集群中同步。 跨集群发现:Federation 能够在所有集群的后端自动配置 DNS 服务和负载均衡。 二、Federation v2 架构...

shida's blog 4035

HDFS Federation机制

前言在上一篇文章HDFS自定义小文件分析功能中,提到了NameNod内存空间使用过高的问题,紧接着提到了其中一个解决方案,就是HDFS Federation.说来也是挺奇怪的,HDFS的Federation机制其实在Hadoop很早的版本中就就有了,可是从日常使用上来看,了解和真正使用这个功能的人并不多.原因可能在于目前对于绝大多数用户的使用场景,一个NameNode或一对HA的NameNode方式

走在前往架构师的路上 1万+

hadoop(2)-HA/federation集群原理及搭建

hadoop HA高可用集群搭建 | hadoop federation集群搭建详细步骤

王小禾 1105
上一篇: Incompatible namespaceID for journal Storage Directory ...
下一篇: Hadoop 2.x中fsimage和edits合并实现
迷途小码
博客等级 码龄19年 71粉丝 95原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值