【人工智能项目】深度学习实现金融用户评论分类

人工智能(AI)与机器学习(ML):塑造未来的技术引擎 人工智能是一种模拟、延伸和扩展人类智能的理论、方法、技术及应用系统。它旨在让计算机能够像人类一样思考、学习,并能在各种环境下自主地做出决策。AI的发展经历了从最初的符号主义、连接主义到如今的深度学习等多个阶段,每一次的突破都极大地推动了科技的进步。尽管AI与ML技术取得了巨大的进步,但它们仍然面临着诸多挑战。首先,数据的获取和标注是一个巨大的问题。高质量的标注数据是机器学习模型训练的关键,但数据的获取和标注往往需要耗费大量的人力和时间。其次,模型的泛化能力也是一个需要解决的问题。 阅读详情

【人工智能项目】深度学习实现金融用户评论分类

在这里插入图片描述

任务说明

本数据集包含金融行业用户评论信息,其中有大量长文本,根据评论识别所属金融业务,具体类别如下:

0:消费贷款

1:抵押

2:信用卡

3:债务催收

4:信用报告

5:学生贷款

6:银行账户服务

7:短期小额贷款

8:汇款

9:预付卡

10:其他金融服务

认识数据

import pandas as pd

train_df = pd.read_csv("train.csv")
test_df = pd.read_csv("test.csv")
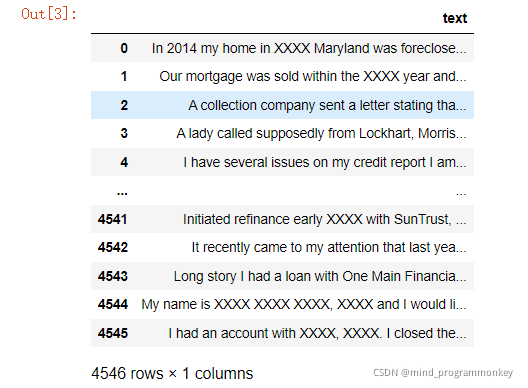
train_df
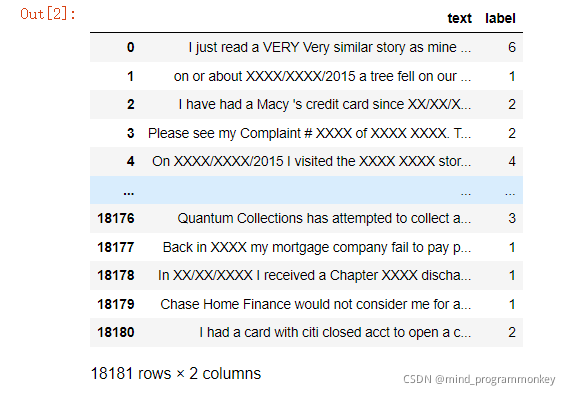
在这里插入图片描述

test_df

在这里插入图片描述

CatBoost分类

# 裸模86.9556,主要是认识一下俄罗斯很强大的学习模块Catboost
import pandas as pd
from catboost import CatBoostClassifier
import numpy as np


df1=pd.read_csv("./train.csv")
y = df1['label']
X_train = df1['text'].astype('str')
X_train=np.array(X_train)

df2=pd.read_csv("./test.csv")
X_test = df2['text'].astype('str')
X_test=np.array(X_test)


print(X_test.shape)

model = CatBoostClassifier(task_type='GPU')
model.fit(X_train, y,text_features=[0])
在这里插入图片描述

label=[]
for i in range(X_test.shape[0]):
    label.append(model.predict([X_test[i]])[0])
dataframe = pd.DataFrame({'index':range(X_test.shape[0]),'label':label})
dataframe.to_csv("submisson.csv",index=False,header=False,sep=',')

SimpleTransformer模型训练预测

import warnings
warnings.simplefilter('ignore')

import numpy as np

import pandas as pd

from simpletransformers.classification import ClassificationModel
train = pd.read_csv('./train.csv')
test = pd.read_csv('./test.csv')
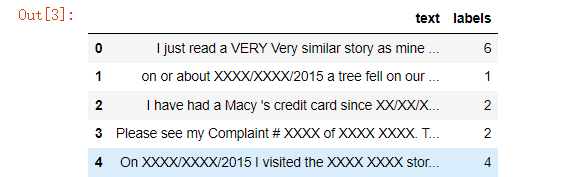
train.columns = ['text', 'labels']
train.head()
在这里插入图片描述

train_args={
    'sliding_window': True,
    'reprocess_input_data': True,
    'overwrite_output_dir': True,
    'logging_steps': 5,
    'stride': 0.6,
    'max_seq_length': 256,
    "fp16":False,
    'num_train_epochs': 5,
    "train_batch_size":1,
    "gradient_accumulation_steps":32
}
model = ClassificationModel('roberta', 'roberta-base', num_labels=11, args=train_args)
model.train_model(train)
在这里插入图片描述

predictions, _ = model.predict([row['text'] for _, row in test.iterrows()])
pd.DataFrame({'ID': test.index, 'labels': predictions}).to_csv('submission_roberta-large.csv', index=False, header=False)

小结

本次用机器学习的方法实现nlp相关的评论分类工作,那下次见!!!
在这里插入图片描述

人工智能与深度学习的应用案例解析及代码实现 深度学习基于深度神经网络(DNN),其核心在于通过多层非线性变换提取数据特征。卷积神经网络(CNN):专用于图像处理,通过卷积核提取局部特征。循环神经网络(RNN):处理序列数据,如文本和时间序列,依赖记忆单元保留上下文信息。生成对抗网络(GAN):生成高质量数据,应用于图像合成与增强。人工智能与深度学习的应用疆界仍在持续扩展,从基础理论创新到产业落地实践,技术突破与工程优化缺一不可。开发者需持续关注模型效率提升、数据质量治理、伦理合规等核心议题,推动AI技术向更智能、更可靠、更可持续的方向发展。 阅读详情

相关推荐

python编程人工智能小例子,python人工智能100例子

大家好,我是微学AI,本项目将围绕人工智能实战项目进行展开,紧密贴近生活,实战项目设计多个领域包括:金融、教育、医疗、地理、生物、人文、自然语言处理等;帮助各位读者结合机器学习与深度学习构建智能而且实用的人工智能简单系统,创建有影响力的AI应用,项目中提供项目原码,一步一步地运行每行代码,了解每行代码在做什么,由浅入深,不断地解决多领域的问题。希望大家阅读完这篇文章后大有收获,下面让小编带着大家一起了解一下。18.深度学习实战18(进阶版)-NLP的15项任务大融合系统,可实现市面上你能想到的NLP任务。

Aq1995的博客 1325

用户商品评论自动分类

商品评论自动分类                            实习阶段的任务是对商品评论信息进行自动分类,主要针对的是家用电器商品评论数据,现在实习要结束了,来总结一下实现这一任务的主要流程。 一语料库的准备 商品评论数据的主要特点: 1)评论一般较短,并且语言口语化,没有标准的语法规则,经常出现网络词汇 2)评论一般涉及商品的多个属性 针对这些特点,我将评论拆分成句子,然

Sweety_shiwei的专栏 2539

AI人工智能领域分类的实用价值

人工智能作为21世纪最具变革性的技术之一,已经渗透到我们生活的方方面面。然而,AI并非单一技术,而是由多个子领域组成的复杂体系。本文旨在系统性地梳理人工智能的主要分类,并深入分析各类AI技术的实用价值,帮助读者理解如何根据具体需求选择和应用合适的人工智能技术。本文范围涵盖人工智能的主要分支领域,包括但不限于机器学习、深度学习、计算机视觉、自然语言处理、专家系统等。我们将从技术原理、应用场景和实际价值三个维度进行分析。首先介绍AI分类的基本概念和体系然后深入分析各类AI技术的核心原理。

AI大模型应用之禅 671

python计算分类模型的评价指标

【代码】python计算分类模型的评价指标。

知识搬运者 5447

AI用户行为分析系统的实现案例

用户行为分析,人工智能,机器学习,深度学习,推荐系统,数据挖掘,自然语言处理 1. 背景介绍 在当今数据爆炸的时代,用户行为数据已成为企业获取洞察、优化产品和服务、提升用户体验的关键资源。传统的用户行为分析方法往往依赖于人工标注和规则匹配,效率低下且难以捕捉复杂的用户行为模式。而人工

AI架构师小马 1672

大众点评评论情感细粒度分类项目实战

情感分析,又称为意见挖掘或情绪AI,是一种利用自然语言处理技术、文本分析和计算语言学来识别、提取、量化和研究个体情绪状态和主观信息的方法。它旨在从文本数据中辨识出作者的情绪倾向,如正面、负面或中立。在开始对大众点评评论数据集进行获取之前,首先要对数据来源进行了解。数据源通常包括公开的数据集、API接口以及爬虫技术抓取。为了确保数据的真实性和多样性,我们可以选择多种方式获取数据。

weixin_42627459的博客 1381

深度学习的二分类问题(电影评论分类)

用神经网络解决基本的二分类问题。

XMTX4234的博客 2168

基于深度学习的中文文本情感分类

基于深度学习的情感分类和智能客服研究与实现。主要是酒店和书店的评论情感分析,可以判定积极和消极,对于消极评论,还可以判断其具体类别,比如物流不好或者服务差等等。内含项目源代码和开发文档。

深度学习实战案例:电影评论二分类

第一个深度学习实战案例:电影评论分类 公众号:机器学习杂货店作者:Peter编辑:Peter 大家好,我是Peter~ 这里是机器学习杂货店 Machine Learning Grocery~ 本文的案例讲解的是机器学习中一个重要问题:分类问题。 本文是《Python深度学习》一书中的实战案例:电影评论的二分类问题。 训练集和测试集 这是一个典型的二分类问题。使用的是IMDB数据集,训练集是25000条,测试也是25000条 In [1]: import pandas as pd import nu

尤尔小屋 2398

基于用户的深度学习可视化分类.pdf

基于用户的深度学习可视化分类.pdf

用户评论业务分类数据(长文本分类)

数据集为用户评论业务分类数据(包括了训练集和测试集),根据评论对所属业务进行分类,其中部分文本长度较长。

用户评论实体识别及情感分类

实体识别方法: 1.传统常见方法:CRF,HMM 2.深度学习方法:RNN下的LSTM 3.规则匹配:基于词典 1,2两种方法都是序列标注问题, eg "宝马的座椅比帕萨特更舒服",标注"宝(B)马(E)"      "宝马座椅比帕萨特更舒服",标注"宝(B)马(M)座(M)椅(E)" 情感分类: 1.常见分类器,如SVM,LR,MaxEnt,GBDT等 2.规则匹配

wx805541464的专栏 3609

FUEL算法解读(一)——框架解读,思维导图可以很清晰看懂算法启动框架,已更新完,图太大放不上来链接在文末

一图看懂FUEL算法节点框架!!!

weixin_43793717的博客 2786

人工智能实战项目(python)+多领域实战练手项目

人工智能实战项目目录 一、机器学习实战项目 1.机器学习实战1-四种算法对比对客户信用卡还款情况进行预测 2.机器学习实战2-聚类算法分析亚洲足球梯队 (待更新) ...(待更新) 二、深度学习实战项目 1.深度学习实战1-(keras框架)企业数据分析与预测 2.深度学习实战2-(keras框架)企业信用评级与预测 3.深度学习实战3-文本卷积神经网络(TextCNN)新闻文本分类 4.深度学习实战4-卷积神经网络(DenseNet)数学图形识别+题目模式识别 5.深度学习实战5-卷积神经 ...

微学AI的博客 2万+

2 利用ITK实现多帧Dicom读取,VTK实现数据显示

vtk中也有dicom读写类,但是只能完成单帧DICOM数据读取,这对于实际应用是非常不利的。而ITK可以实现dicom多帧读取,通常情况ITK与VTK也会结合使用(ITK处理,VTK显示),所以就一起学习下吧!

buerbuhuitou的博客 1565

卡尔曼滤波原理详解及系统模型建立(simulink)

卡尔曼滤波原理详解及系统模型建立(simulink) 卡尔曼滤波器 卡尔曼滤波器是在上个世界五六十年代的时候提出的,到今天已经有六十年左右的时间,但卡尔曼滤波算法不管在控制、制导、导航或者通讯方面对数据的预测能力依然处在一个不可撼动的位置上,但是很多人对于其算法内部的工作原理究竟是怎么运作的依然不理解,所以在工程上很多人都只是把卡尔曼滤波当成是一种“黑箱”预测算法,并不清楚内部原理。但实际上没有任...

weixin_43942325的博客 7万+

什么是人工智能?——AI的定义、发展历程与基本分类

人工智能(Artificial Intelligence,简称 AI)已成为当今科技领域的热门话题。从智能助手 Siri 到 ChatGPT,再到自动驾驶汽车,AI 正在深刻地改变我们的生活。那么,究竟什么是人工智能?它是如何发展的?又有哪些主要类别?本篇文章将带你从零认识 AI。

2万+

024、反激变换器的短路保护设计

本文详细探讨了反激变换器短路保护的设计要点与实践经验。作者通过实际案例分析了短路时反激拓扑的电流特性,指出初级峰值电流限制是最基础的保护手段,但需配合打嗝模式使用。文章重点剖析了打嗝模式设计的三个关键陷阱:频率设定、退出条件和软启动衔接。同时强调次级侧辅助保护、变压器参数优化、环路响应协调的重要性,并比较了自恢复与锁死方案的适用场景。最后提出实测验证的四个关键点和设计经验:不盲信芯片手册、保护电路独立设计、充分留有余量、进行破坏性测试。全文以工程实践为导向,为反激电源的可靠短路保护提供了系统性解决方案。

Jack010169的博客 244

人工智能中的文本分类:技术突破与实战指导

在本文中,我们全面探讨了文本分类技术的发展历程、基本原理、关键技术、深度学习的应用,以及从RNN到Transformer的技术演进。文章详细介绍了各种模型的原理和实战应用,旨在提供对文本分类技术深入理解的全面视角。

TechLead 2666

在 ABAP 世界把 SAML 2.0 玩明白:跨域 SSO 的通信模式、配置路径与落地实践

摘要 SAML 2.0是ABAP平台实现标准化SSO的推荐方案,提供Front-Channel(浏览器传递SAML报文)和Back-Channel(使用工件绑定通过SOAP兑换断言)两种通信方式。前者包括HTTP Redirect和POST绑定,后者通过Artifact绑定提升安全性。配置重点包括:激活ICF服务、使用SAML2事务码建立信任、设置用户标识映射、选择绑定方式(POST易调试、Artifact更安全)及配置安全策略(签名/加密)。典型流程包括SP-initiated和IdP-initiated

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 294

【YOLOv11多模态涨点改进】独家创新首发 | TGRS 2025 | 引入CDFIM跨模态差异特征交互模块,通过差异特征提取和融合增强机制,减少了冗余信息,显著提升了小目标的检测精度,高效涨点改进

🔥本文给大家介绍使用 CDFIM跨模态差异特征交互模块改进 YOLOv11多模态目标检测,通过有效的差异特征提取和增强,显著提升了小目标的检测精度,特别是在复杂背景和低对比度环境下。该模块通过残差加法和通道与空间注意力机制,增强了可见光与红外模态之间的互补特征交互,减少了冗余信息,提高了检测稳定性。尽管提升了特征交互,CDFIM 仍保持轻量化设计,计算开销和参数量较低,适合实时检测应用。总的来说,CDFIM 模块在保留原始模态信息的同时优化了特征融合,有效提高了 YOLO 在多模态目标检测中的鲁棒性和精度

Ai缝合怪、助力小伙伴高效发论文 132

五大项目,攻克AI算法核心应用:含NLP、推荐系统与金融风控|2025人工智能实训季

人工智能的学习,不能只停留在算法和代码,更要走进真实场景,解决实际问题。和鲸社区举办的,其中中阶部分包含,覆盖时间序列预测、结构化建模、文本情感分析、推荐系统和能源预测等方向。2025人工智能实训季 中阶赛题概览。

Rikki1013的博客 1402

YOLOv12改进策略【卷积层】| CVPR-2020 利用DynamicConv 动态卷积 结合A2C2f进行二次创新,提高精度

在大规模视觉预训练中,通常模型的性能受到数据、参数和FLOP三个关键因素的影响。一般来说,模型的参数数量越多,FLOP也越高,但在移动设备等对计算资源有限制的场景下,需要低FLOP的模型同时又希望模型能从大规模预训练中受益。传统的方法很难在增加参数的同时保持低FLOP,因此需要一种新的设计来解决这个问题,模块应运而生。

Limiiiing的博客 830
上一篇: 【人工智能项目】深度学习实现知乎文本摘要
下一篇: 【人工智能项目】深度学习实现10类猴子细粒度识别
mind_programmonkey
mind_programmonkey 领域专家: 算法与数据结构技术领域 领域专家: 算法与数据结构技术领域
博客等级 码龄9年 4435粉丝 1111原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

mind_programmonkey

你的鼓励是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值